关键词:同态加密推理 | FHE | 引擎全景 | 数据流 | 密文计算 | 明文预处理 | CKKS | 纯 C11 | 大模型推理
导读:这是一套同态加密推理引擎的完整数据流全景。整套系统被一条线劈成两个世界:明文侧(Python)负责权重导出、非线性函数逼近与明文参考值,密文侧(纯 C11)只读这些产物、在大模型的密文上把前向跑完。本篇讲清这条同态加密推理链路的分界线、各层职责,以及"哪一侧该信谁"。
项目仓库
Gitee 主仓:https://gitee.com/pei-xiaoguang/kestrel-llm
GitHub 镜像:https://github.com/m13253246268-ship-it/kestrel-llm
0. 一句话结论
整套系统被一条线劈成两个世界:
- 明文侧(Python):把模型权重、非线性函数的逼近系数、以及"正确答案"(明文参考)算出来,落成
.bin; - 密文侧(纯 C):只读这些
.bin,在密文上把前向跑完,产出密文。
分界线是两样东西:拟合系数与明文参考。 密文侧从不重新拟合任何东西,明文侧从不碰密文——这个切法让两侧可以独立验证。
1. 两个世界的产物对照
明文侧(tools/preproc/,Python) |
密文侧(src/core/ + 驱动,C) |
|
|---|---|---|
| 输入 | model.safetensors(约 4.26 GB) |
明文侧落下的 .bin + 密文 |
| 产出 | 权重、拟合系数、明文参考值、尺度表 | 密文(.ct)+ 日志 |
| 依赖 | numpy、safetensors |
仅 libc + libm |
| 是否可重跑 | 可,且产出逐字节可复现 | 可,且产出位级可复现(需固定线程数) |
| 怎么验 | 与分发物比对哈希 | verify_layer 独立解密复核 |
2. 明文侧:四个阶段,24 个脚本
tools/preproc/ 下是 24 个 Python 脚本,按职责分四组(完整执行顺序以 tools/preproc/README.md 的「执行顺序」一节为准):
① 导出
_export_weights.py:权重导出(tail/w0..w27/,每层 9 个文件)_embed4.py:lay0的明文输入——按 token id 从 embedding 表取 4 行(l0/embed4.bin,4×2048 float32,32768 B)
② 定路径
_silu_mode.py:逐层写出 8 字节的tail/silu{L}.bin,决定该层的 SiLU 走"直接拟合"还是"÷21 折叠"(本系列第 8 篇专门讲这个开关,它也是最危险的一个文件)
③ 生成参考值("正确答案")
_full_layers.py:L0..L25 的明文因果前向参考_tail_ref.py:链尾(L26..L27)参考- 以及
_ln_fit*.py/_m2c*/_refit_lnq.py等:LayerNorm 与倒数之类的分支参考
④ 拟合与定标
_sin_fit*.py/_cos_fit.py/_recip_fit.py/_attn_fit.py:把非线性函数(sin、cos、倒数、exp)拟合成多项式,直接生成 C 数组(例如EXP_Q[7]、RECIP_Q[9])_fold_fit.py/_fold_sim.py/_cfold_plan.py:折叠方案的设计与仿真_adap_scale.py:逐层尺度自适应(本系列第 9 篇)_silu_err.py/_logits_tol.py:误差与容差评估工具
一个反直觉的事实:这些脚本产出的数据包约 7 GB,但它不随仓库分发。任何人都能用同一个模型把整包重新生成出来——我们核对过生成物与分发物逐字节相同。
3. 密文侧:四层职责
┌──────────────────────────────────────────────┐
│ 驱动 t23_m3p.c (lay) / t23_chain.c (boot)     │  ← 一个"层"的业务逻辑
├──────────────────────────────────────────────┤
│ vllm_ckks.c    RNS-CKKS:编码/加密/加乘/       │  ← 密文语义
│                rescale/relin/rotate/modraise  │
├──────────────────────────────────────────────┤
│ vllm_ntt.c     负循环 NTT(多项式乘法)        │  ← 数学原语
│ vllm_tp.c      自研线程池(替换 OpenMP)       │  ← 并行原语
└──────────────────────────────────────────────┘
关键点:下层不知道上层在算什么。NTT 不知道自己在做 attention,CKKS 不知道自己在算 Transformer。这条分层让"位级可验证"成为可能——你可以单独证明 NTT 是对的(与教科书 O(n²) 位级对照),而不用先信任整个模型。
4. 一跳内部发生了什么
4.1 lay(层内前向)
layL: u(L-1)r112 → uL,一串同态算子的组合:QKV 投影、attention、FFN、以及需要密文化的非线性(SiLU、倒数、exp 等,全部用预先拟合好的多项式代替)。
4.2 boot(自举刷新)
bootL: uL → u(L)r112。驱动 t23_chain.c 的 [boot profile] 打印把整条流水线摊开了,实测的七段是:
modraise → coeff_to_slot → rotate_k → conj_extract
        → sin_fold_re / sin_fold_im → restore_merge → slot_to_coeff
| 段 | 作用 |
|---|---|
modraise |
用 Garner 扩展把模数链抬回满链(自举的起点) |
coeff_to_slot |
系数域 → 槽位域(Galois 旋转 + key-switch) |
rotate_k |
旋转 |
conj_extract |
共轭提取(分出实部/虚部) |
sin_fold_re/im |
对实部、虚部分别做 sin 折叠(EvalMod 核心) |
restore_merge |
还原并合并 |
slot_to_coeff |
槽位域 → 系数域 |
这七段的时间分布极不均匀——coeff_to_slot 与 slot_to_coeff 两段就占了约 80%。本系列第 15 篇给完整账本。
5. 交接:一跳的产物
一跳结束,落盘的东西很少:
| 产物 | 数量 / 规格 |
|---|---|
| 密文 | 8 枚(4 个 token 位置 × 2 个分量),u{L}r112_*.ct,单文件 ≈3.5 MB |
| 日志 | <stage>.out / <stage>.err |
| 元数据 + 哈希 | manifest.sha256(逐文件 SHA256,可自校验) |
这个包就是"接力棒"。 下一棒只需要三样:这个包、sk.bin(同一把私钥)、以及编译好的驱动。
6. 一张总图
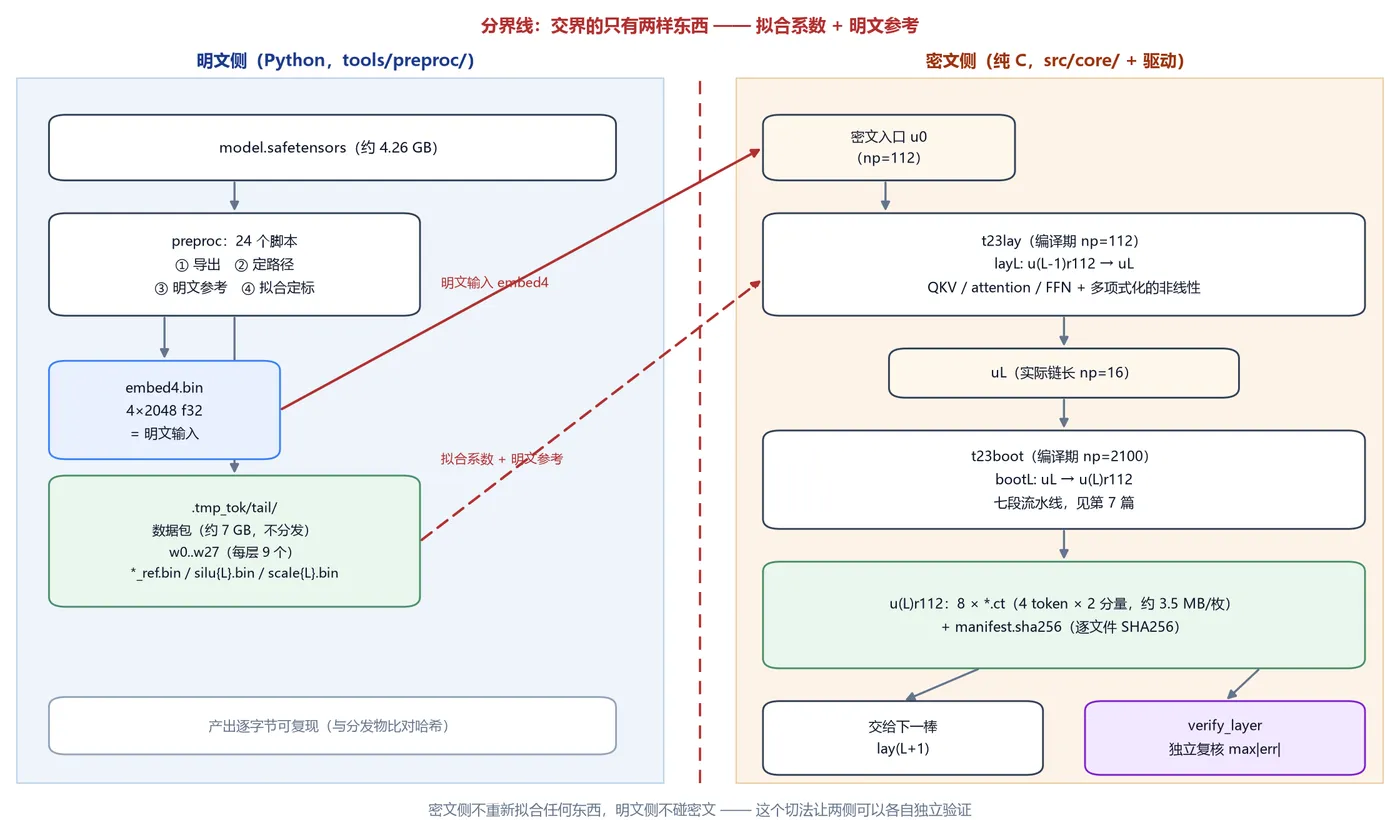
图 2-1 怎么读:左边是明文侧(Python),只产出拟合系数与明文参考;右边是密文侧(纯 C),只读这两样东西,从不重新拟合任何函数。中间那条红色虚线就是分界线——它同时是两边的接口,也是两边可以各自独立验证的原因。
矢量版
figs/fig02_dataflow.svg|Graphviz 源码figs/fig02_dataflow.dot(本机未装 Graphviz 时,图片由figs/make_figs.py生成)
下面是同一张图的纯文本版,便于在终端或纯文本环境里阅读:
model.safetensors ──┐
                    ├─[preproc]─→ .tmp_tok/tail/{w*,l*_ref,silu*.bin,scale*.bin}
                    │                     │
                    │                     ▼
                    │            [t23lay (np=112)]
   明文输入 embed4 ──→ 密文 u0 ──────────┘
                              │
                              ▼
                       [t23boot (np=2100)]  → u0r112
                              │
                              ▼
                  8 × u0r112_*.ct + manifest.sha256
                              │
                              ├─→ 交给下一棒(lay1)
                              └─→ [verify_layer] 独立复核 max|err|
7. 安全边界(务请读完)
本文所述参数为机制验证级(n=2048、112 素数内层链、2100 素数自举链),
远低于 HE 参数标准的 128-bit 水平,不得用于保护真实数据。
本文主张的是:系统结构与数据流的事实描述。
本文不主张:安全强度、性能优越性。
8. 这一篇的未解问题
- 明文侧与密文侧的耦合点还是太多。拟合系数(如
EXP_Q)是"密文侧的常量",但它的取值范围来自明文侧的统计——一旦换模型,这些常量全部要重算。我们希望把这条依赖显式化成一份"契约文件",目前还散在脚本里。 _silu_mode.py的逐层选择是固化调参结果,不是从模型推导出来的规则。它目前是一个硬编码的层号集合,这一点让"换模型自动适配"做不到。- 数据流图还缺一张真正的位级对照实验:同一条链在 x86-64 与 aarch64 上逐系数一致(我们已在层 0–4 验证),但"哪些步骤位级一致、哪些只是数值等价",我们只做了整链对照,没有分段归因。
下一篇我们下到最底层:手写 negacyclic NTT——为什么不用现成库,以及"怎么证明自己写对了"在密文计算里意味着什么。