背景
Agent 的 Token 花销里,有不少是冤枉钱。同一个项目跑过的坑,换一次任务又踩一遍;上次查清楚的信息,这次从头再查一轮。这些轮次本来不该发生,但每一步都在烧 Token。
业界主流的降本法是剪单次。工具返回太长就压,Headroom(headroomlabs-ai/headroom)压冗余结构,rtk(rtk-ai/rtk)过滤 shell 输出;历史太长就截,Claude Code 的 compaction、LangChain 的 trim_messages 做滑动窗口和摘要。每次交互少发一点,确实省钱。但这些手段对付的是单次调用的体积,管不了轮次本身该不该发生。
AgentSight 做的是后面这一层。先看清钱花在哪,再从轨迹里把经验攒下来,让不该发生的轮次别发生。跟剪单次互补,不冲突。
AgentSight 解决方案
AgentSight 是智能体操作系统 Agentic OS 的可观测性组件,部署在用户自己的机器上。按照当前版本的默认配置,轨迹数据在本机解析和落盘。
当前版本接入时不要求修改 Agent 代码。macOS 通过扫描本地 JSONL 会话文件生成轨迹,不需要 root。Linux 默认也使用不加载 eBPF 的本地会话采集模式;明确开启完整 eBPF 管线时,需要 root、Linux 5.8 以上内核和 BTF 等前置条件。产品文档还说明,Kubernetes 和 Docker 环境可以识别容器身份,目前适配 Claude Code、Codex CLI 和 Qwen Code。
下面是轨迹优化分析的整体架构:
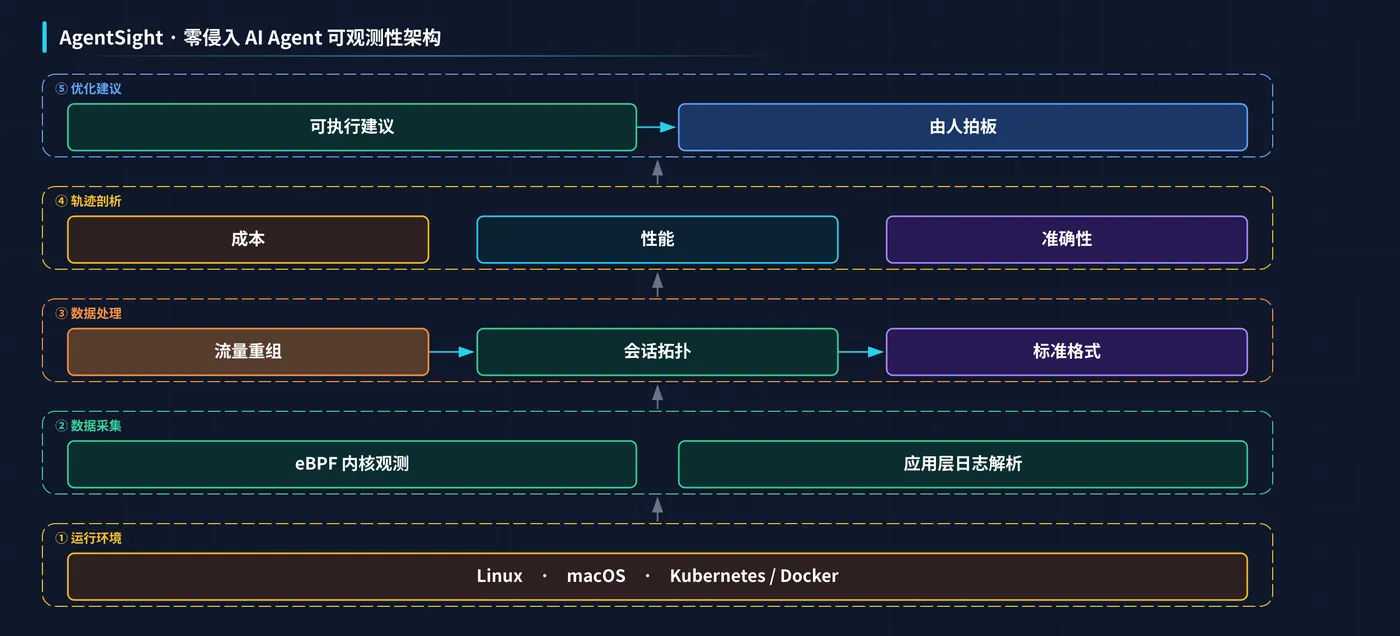
采集到的原始数据需要先做完整重组。完整 eBPF 模式会在内核侧获取流量,应用层同时解析日志,再把两路数据合在一起。HTTP/1.x、HTTP/2 和 SSE 中分散的请求与响应,会被还原成单次调用、会话轮次和完整会话。按当前产品说明,内置解析器覆盖 OpenAI、Anthropic、阿里云百炼以及 OpenAI 兼容端点,输出遵循 OpenTelemetry GenAI 语义约定与 ATIF v1.7 标准。轨迹内容包括提示词、模型输出、工具调用参数和结果,同时关联进程树、文件写入和网络行为。使用者因此可以对照着看,一次 LLM 调用触发了哪些系统动作,Agent 又根据什么信息进入下一步。
完成轨迹重组以后,AgentSight 会从成本、性能和准确性三个角度分析执行过程。成本分析会逐次拆解上下文窗口,用 Token 火焰图展示历史内容不断重放带来的放大效应,并识别重复调用、可压缩提示词和无效轮次。性能分析会把耗时拆成模型等待、工具执行和空闲间隙,帮助使用者找到真正拖慢任务的部分。准确性分析通过语义识别定位问题,将缺陷归因到 Skill、工具或上下文,也能发现多轮原地打转的情况。系统还提供 18 类会话中断检测和开箱即用的仪表盘,支持按时间、Agent 和会话继续查看。
分析完成后,报告会把建议定位到具体调用,并分别说明 Skill 定义、上下文组织和 Prompt 结构可以怎样调整。结果会保留下来,修改后可以重新运行同类任务,直接比较前后的数据。所有建议都以只读方式呈现,最终是否采用由使用者决定。
使用流程
实际操作分为三步。选中一条会话、发起分析、然后查看报告。下面用一条真实会话走完整个过程。
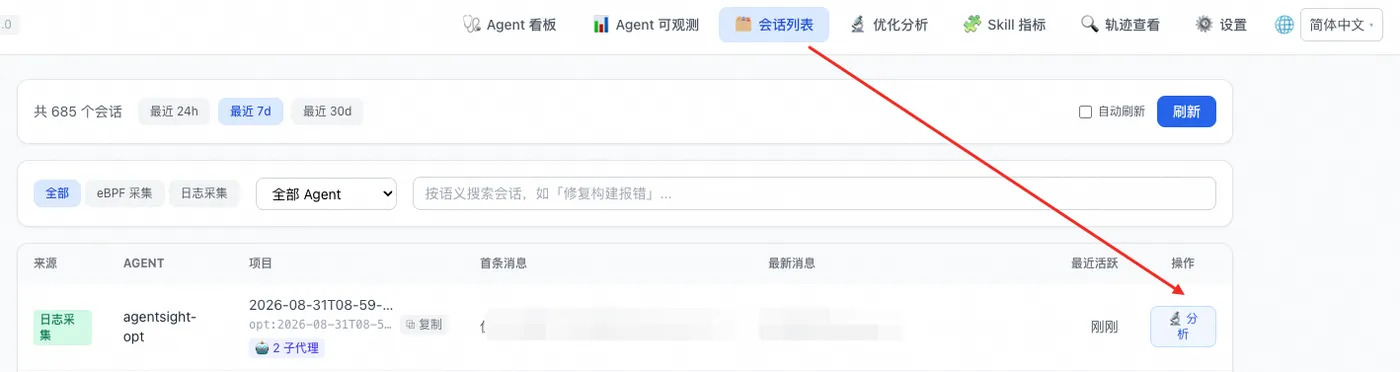
打开 Dashboard 的会话列表页,系统会按时间展示已经采集到的 Agent 会话。页面上方可以按采集来源和 Agent 类型筛选,也支持语义搜索。输入“修复构建报错”这样的自然语言,就能定位相关会话。找到目标以后,点击右侧的分析按钮,AgentSight 会启动专门的优化分析 Agent,从头检查这条会话。
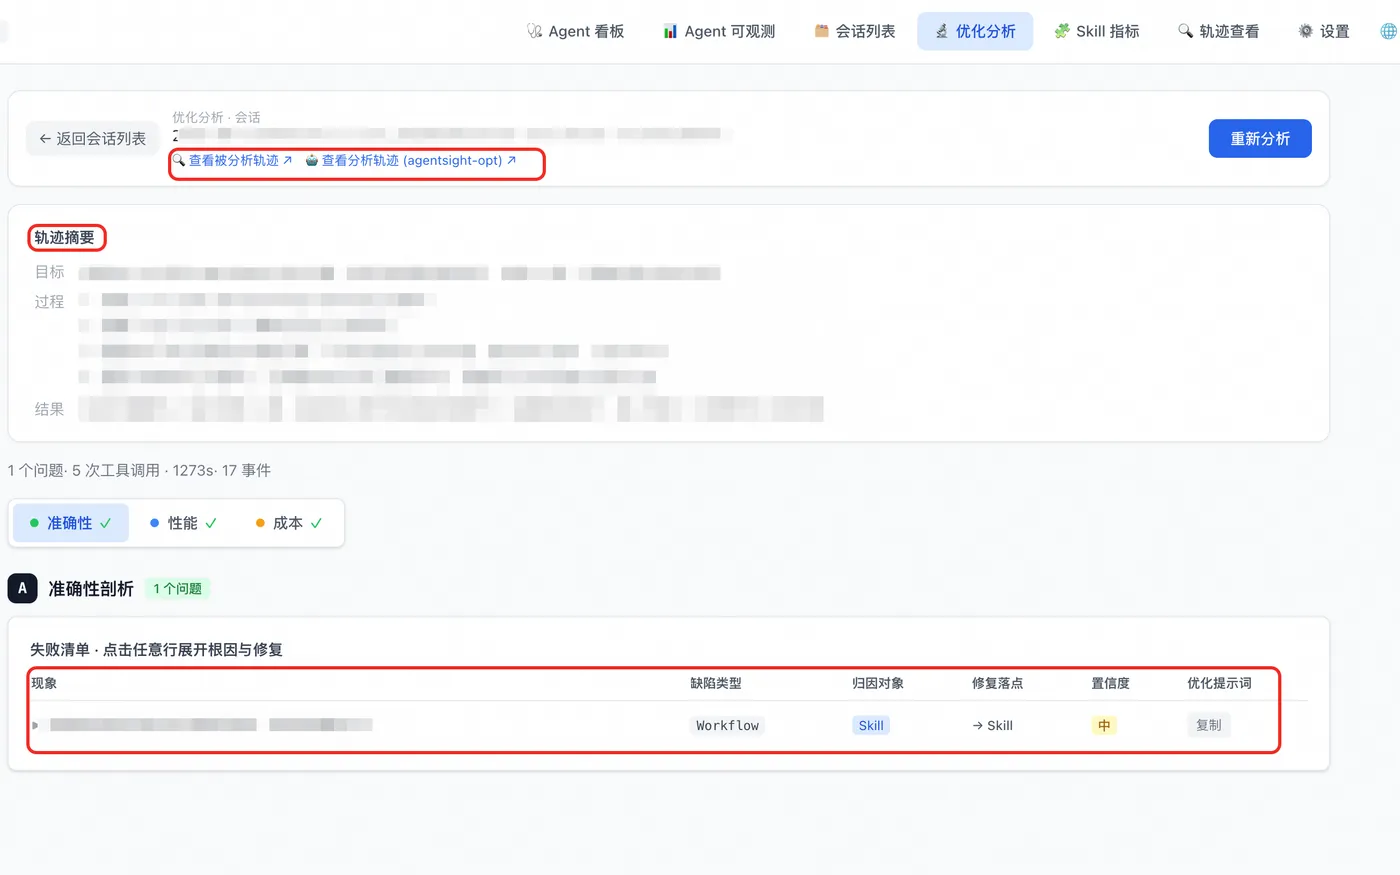
分析结束后进入报告页。页面顶部先显示轨迹摘要,用几句话交代这次会话做了什么、经过怎样、最后有没有完成。下面是基础统计,包括问题数、工具调用次数、总耗时和事件数。
准确性部分会把检测到的缺陷列成表格。每条记录包含现象描述、缺陷类型、归因对象、修复位置和置信度,其中缺陷类型包括 Workflow、Tool Error 和 Skill Gap。展开任意一条,就能看到完整的根因分析。右侧还提供可复制的优化提示词,可以直接用于修改 Skill 定义或 AGENTS.md。
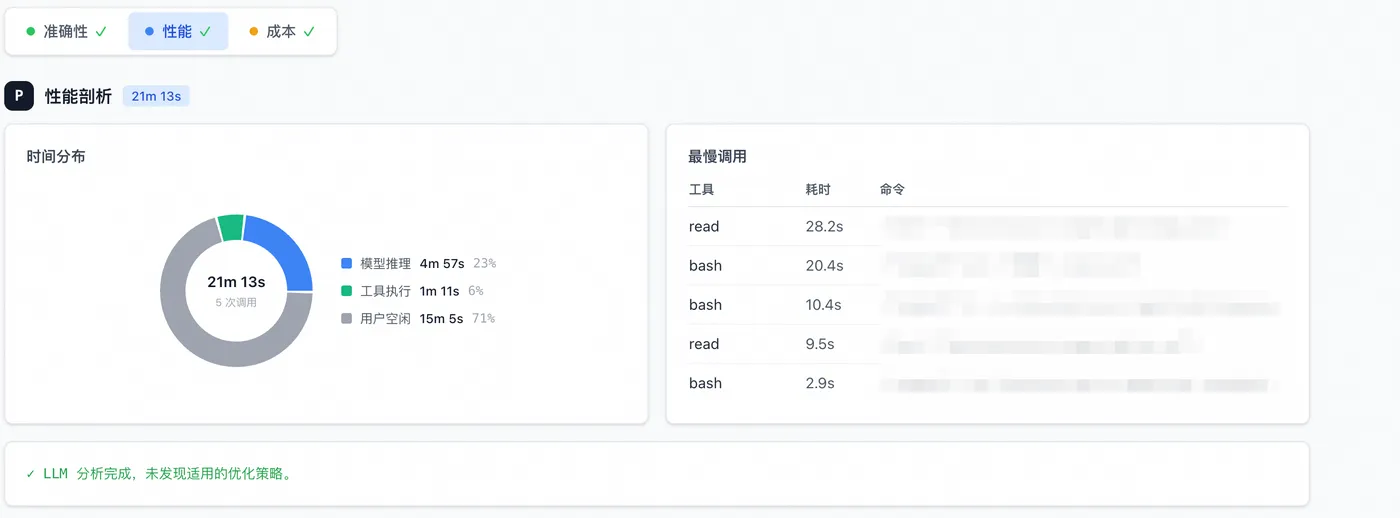
切到性能页,耗时会被拆成模型推理、工具执行和用户空闲。一张图可以看出各部分所占比例,右侧的“最慢调用”表则按耗时排序,列出拖慢任务的工具和对应命令。工具执行慢就检查工具,模型等待时间长就检查上下文或模型选择。用户空闲占比最高时,也能及时排除 Agent 本身的问题。
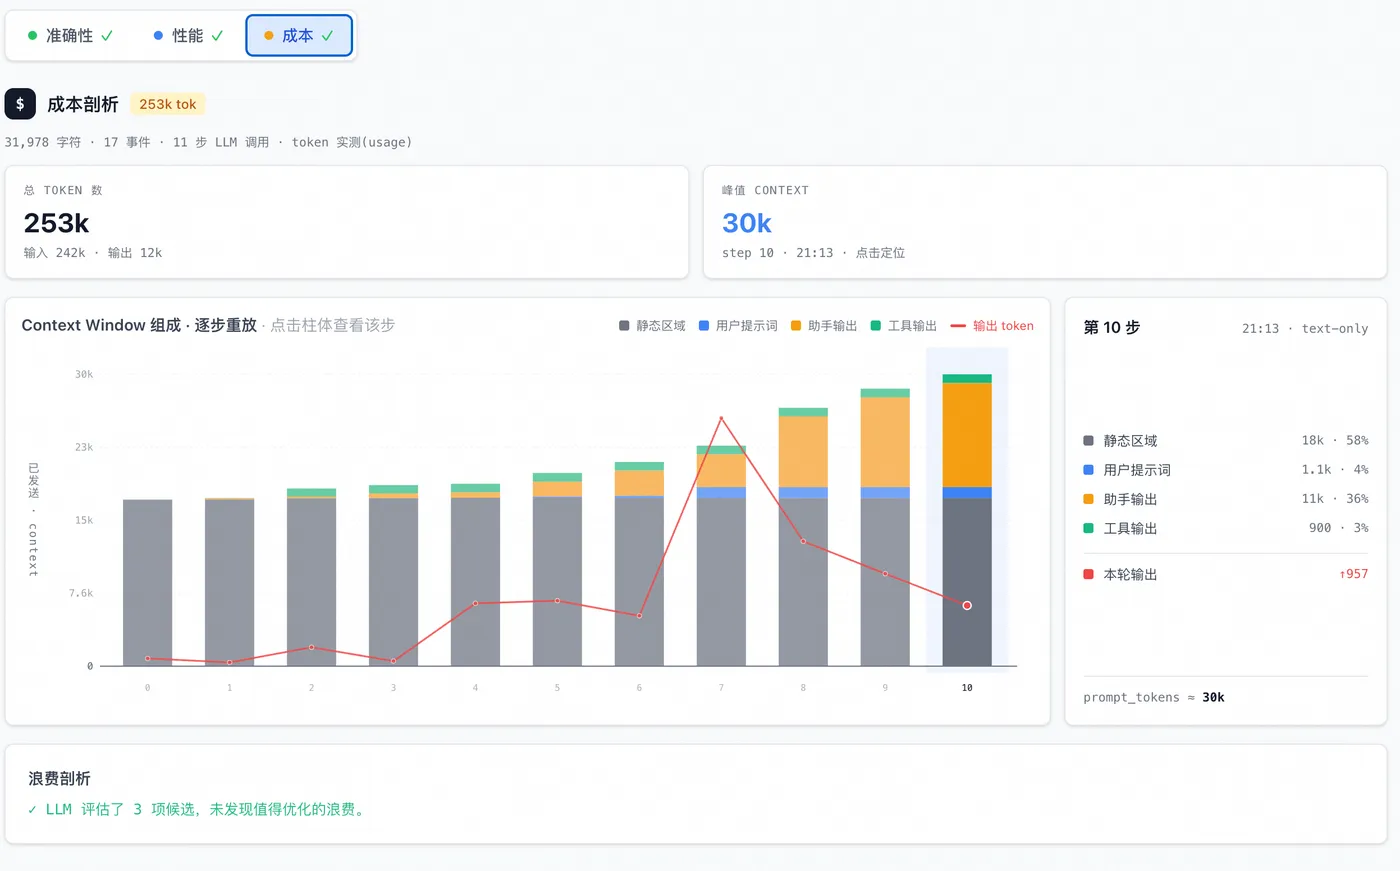
成本页展示总 Token 数和峰值 Context 大小。下方的堆叠柱状图会按步骤重放上下文窗口,并将它拆成静态区域、用户提示词、助手历史输出和工具返回。点击任意一步,可以看到精确的构成比例。红色折线记录每一步的输出 Token。某一步上下文突然增大,输出却没有推动任务,那里通常值得继续检查。页面底部的浪费分析会识别重复调用、可压缩提示词和无效轮次,并估算可以减少的 Token。
拿到报告以后,下一步要看问题落在哪里。准确性问题归因到 Skill,就修改 Skill 定义;性能瓶颈落在工具调用,就逐项处理最慢调用。成本分析若发现能够长期复用的项目经验,可以把它写进 AGENTS.md,让后续同类任务少走几轮。修改完成后再跑一次,前后差异会直接显示在 Dashboard 中。
案例分析
下面用一个真实案例说明“减轮次”怎么落到具体任务里。
场景来自 AgentSight 自身的前端开发。项目采用前后端混合架构,前端有两种访问方式::3004 对应独立的 Vite 开发服务器,:7396 展示嵌入 Rust 二进制的构建产物。Agent 改完前端代码以后,需要根据访问方式选择不同的验证流程。两个端口的差异,正是这次任务绕路的原因。
任务本身很小。Agent 只需要在 AgentSight 的会话列表页,为 AGENT 列旁边带子代理的会话增加一个数量徽章,改动集中在 AgentSessionsPage.tsx。
Agent 完成开发以后,去了 :7396 验证。页面没有显示最新改动,它随后排查缓存、构建产物和打包流程,来回试了好几轮。最后才确认,:7396 的前端被嵌入 Rust 二进制,必须执行 build:embed 和 cargo build 才会更新。切到 :3004 的开发服务器以后,徽章已经正常显示。
分析报告记录了这段弯路的成本。该次测试一共消耗 36K Token,包含 18 步 LLM 调用、21 次工具调用,总耗时 370 秒。Context Window 的堆叠柱状图从第 4 步开始明显增大,那里正是 Agent 沿错误方向排查的起点。峰值 Context 达到 3.4K。到第 17 步时,工具输出占上下文的 63%,其中很大一部分来自此前的截图和命令返回。
浪费分析把这个问题标记为高置信度的“可预知坑”,并给出一条可以直接执行的优化提示词。“前端开发验证优先使用 :3004 开发服务器。没有执行 build:embed 和 cargo build 时,不要在嵌入式前端 :7396 上验证改动。”
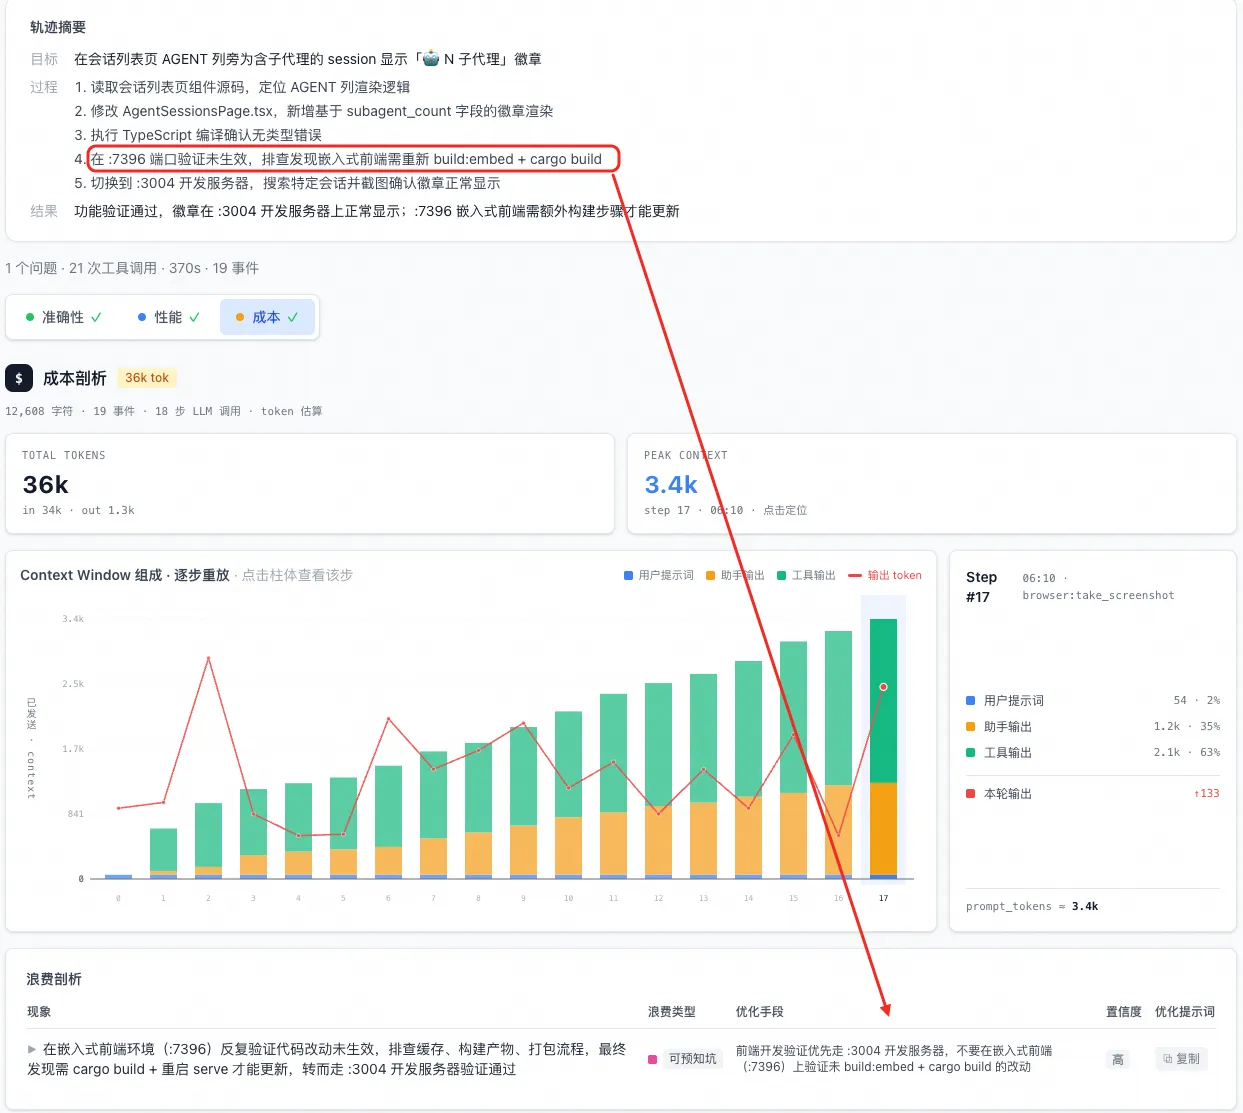
这条经验适合写进 AGENTS.md。同类前端任务以后还会发生,两个端口的差异又属于模型无法预先知道的项目知识。浪费分析给出的动作也足够明确,可以直接改变下一次的验证顺序。
经验规则应该写成具体动作。“注意前端验证环境”只能提醒 Agent 留意;“前端验证走 :3004,未重新构建时不要检查 :7396”已经告诉它下一步怎么做。后者更容易在任务中生效。
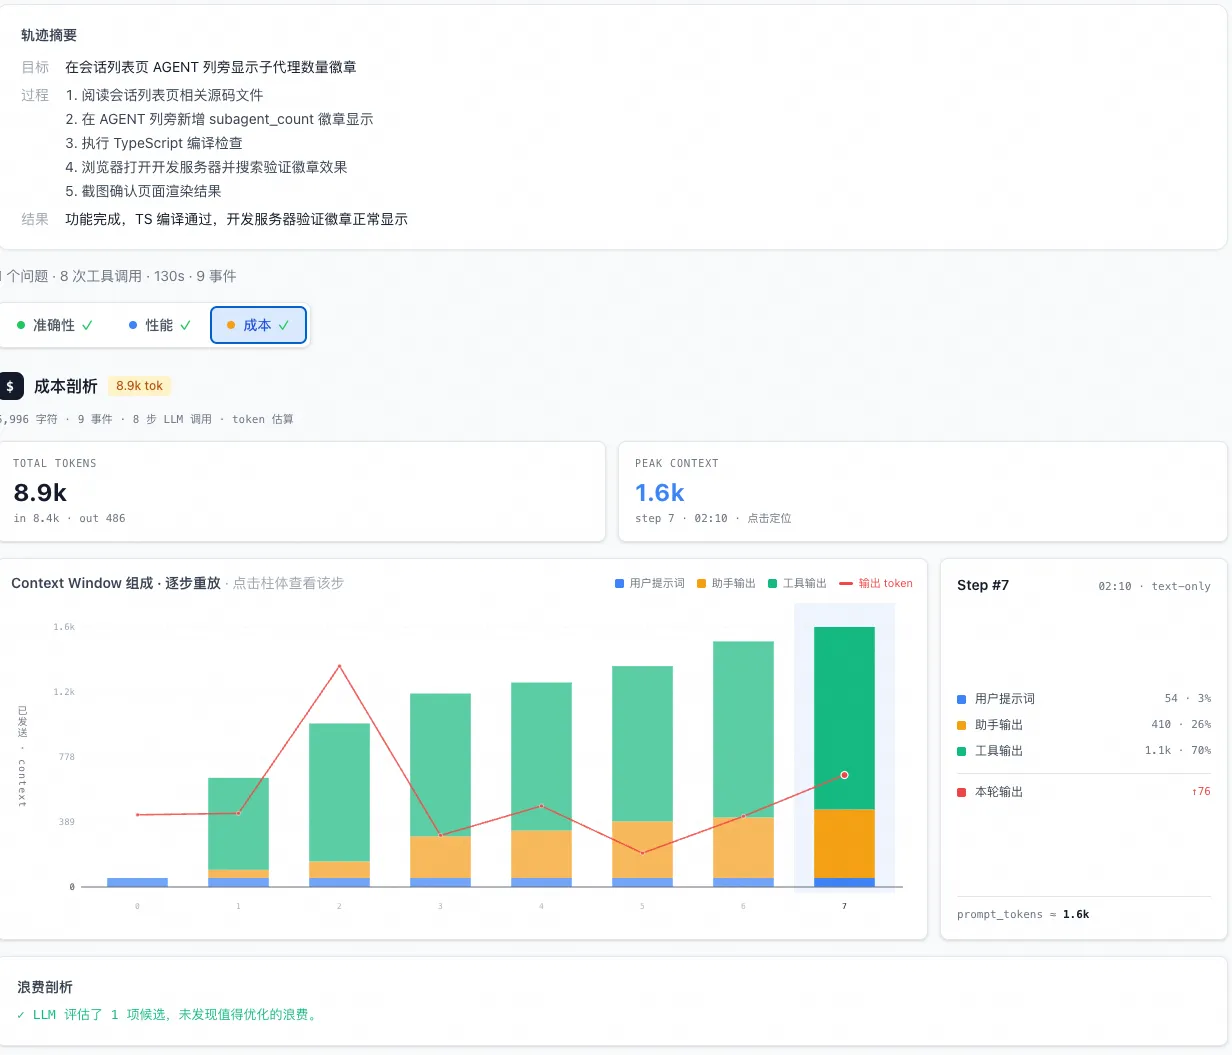
把规则写进 AGENTS.md 后,再运行一次相同任务。Agent 直接选择了正确的验证方式,轨迹摘要收敛为五个关键阶段,没有重复此前的排查过程。
该次复测中,总 Token 从 36K 降到 8.9K,减少约 75%;LLM 调用从 18 步降到 8 步,耗时从 370 秒降到 130 秒,峰值 Context 从 3.4K 降到 1.6K。柱状图中段没有再次出现异常增长,各步上下文保持平稳。浪费分析评估了一项候选,没有发现值得继续处理的问题。
写在最后
压缩工具返回、截断历史上下文,能够让每一步少消耗一些 Token。AgentSight 继续往前处理调用次数,先找出 Token 花在哪里,再把能够复用的经验留给后续任务,让已经知道的弯路少走几次。
这项工作可以持续重复。运行任务,查看报告,写下经验,再用同类任务复测。每增加一条有效规则,后续任务就多一条明确的行动依据。经验逐渐增加以后,Agent 重复犯错的机会会减少,Token 花销也会随之下降。
Agent 的能力越来越强,成本仍然需要单独管理。让它少犯重复错误,把计算资源留给新的问题,这就是“减轮次”带来的价值。
入群交流,欢迎加入 Agentic OS 交流群,群号:90400034325交流。
—— 完 ——