这两年,测试工程师接触的大模型,大多都在“写”:写用例、写脚本、写日志总结、写缺陷分析。
Kev 这类模型反过来。它不负责组织一段看起来很有道理的话,而是给你一份状态和几个固定问题,返回每个选项的概率。
比如一条测试执行记录,你可以问它:这个失败是不是环境波动?该归给前端、服务端还是测试数据?问题影响属于什么等级?它不会写一大段解释,直接给出结构化结果。
很多同学看到这里,第一反应是:那不就是一个“AI 判断器”吗?
是。但从测试的角度,更重要的第二反应应该是:既然它是一个判断器,那我要怎么测它?
这篇不聊怎么把它接进发布审批,更不教你拿一个 0.8 的概率直接替人做决定。我们只做一件事:把 Kev 当成一个本地 HTTP 服务,跑通并验证四类最基础、也最容易被忽略的测试。
你最后会得到一套能复用的最小测试资产:
- 一条真实的
state + questions请求; - 一组 API 契约断言;
- 一组“多问题会不会串、选项换序会不会翻”的行为测试;
- 一个能跟着模型版本、问题文案和温度参数一起回归的冻结样本集。
1. 先理解:它不是聊天接口,而是类型化决策接口
普通大模型接口返回的是文本。你要么让人读,要么再找一个模型读,很容易变成“模型评模型”。
Kev 的输入有两部分:
- 状态(state):一段模型需要读取的事实,可以是文本,也可以是结构化对象;
- 问题(questions):多个带类型的判断题。
它支持三类问题:
| 问题类型 | 适合测什么 | 你要断言什么 |
|---|---|---|
noul |
是否满足、是否异常、是否需要升级 | 返回的是 true 的概率,必须在 0~1 之间 |
choice |
故障归属、工单路由、缺陷类别 | 候选项集合不能丢,概率和应接近 1 |
score |
风险等级、严重程度、规则满足度 | 分数对应有序等级,不能把它当成天然的 1~5 分 |
这也是它和“让大模型评价一句话好不好”的根本区别:问题、选项和返回形状都可以被测试代码固定下来。官方接口约定就是把一份 state 和多道类型化问题送入 /v1/systemone,返回每个问题的概率结果。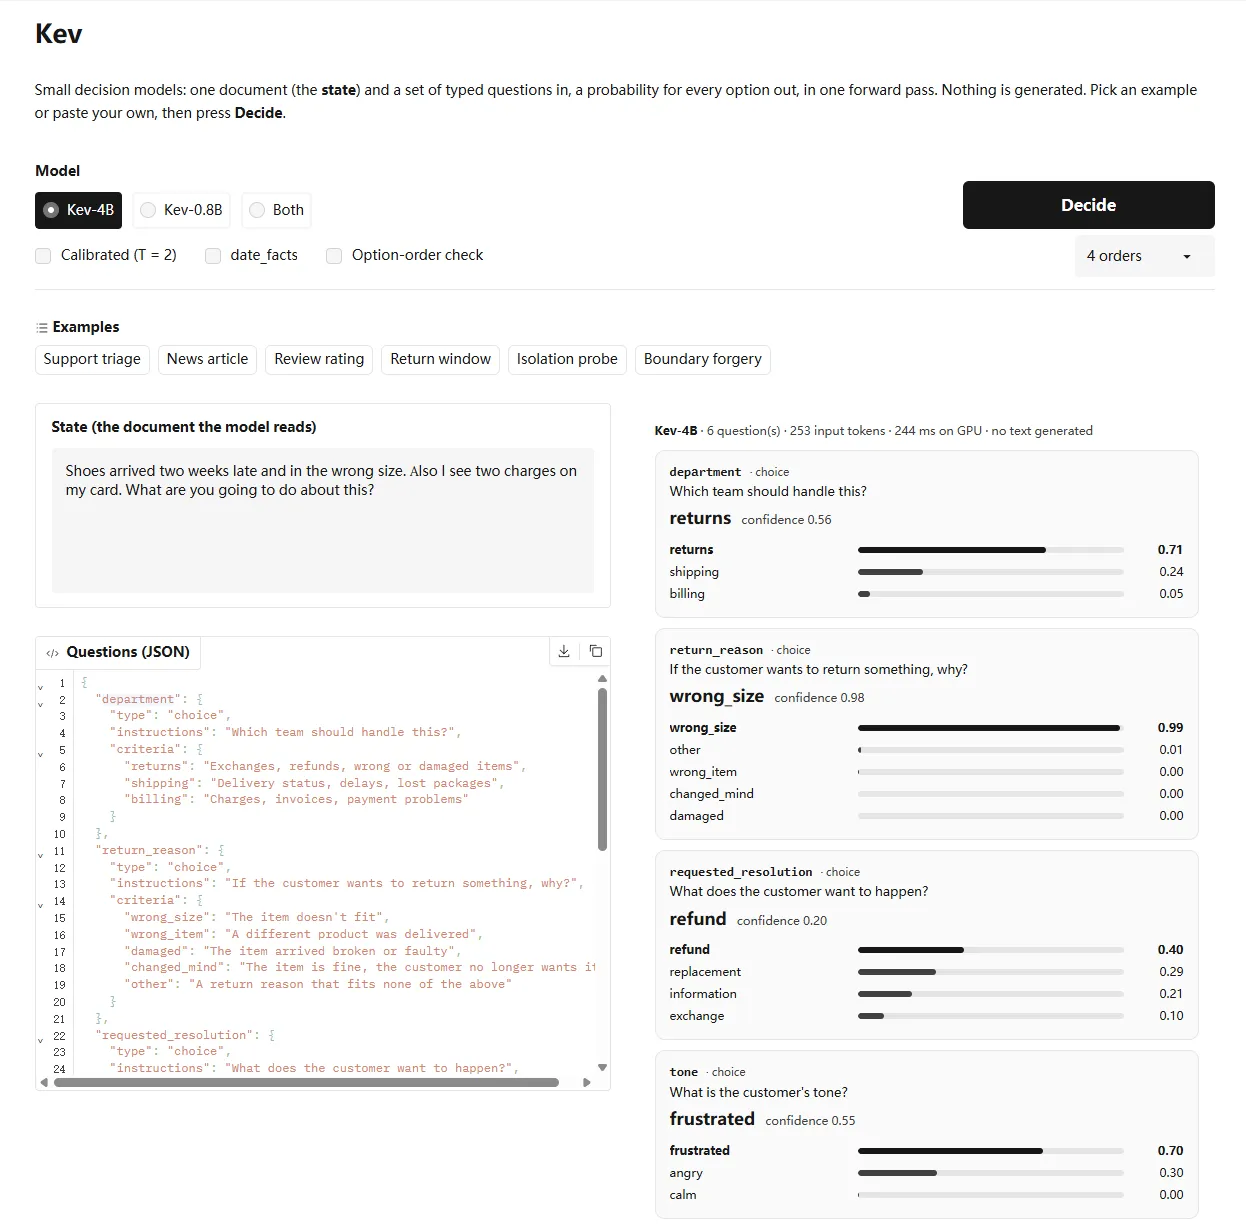
2. 第一步:先把本地服务跑起来
准备 Python 3.12 或 3.13,以及 uv。进入项目目录后执行:
git clone https://github.com/jaredpalmer/kev.git
cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8008
服务启动后,先别急着做微调。测试同学的第一件事应该是确认:服务能不能稳定返回、返回结构是否符合你后续要依赖的契约。
提醒一句:本地能启动,不等于生产可用。模型大小、设备、输入长度和并发都会影响耗时;这一步的目标只是建立一个可重复调用的被测对象。
3. 第二步:发出第一条“可测试”的决策请求
下面不用虚构一个完整业务故事,就取一条测试执行记录。重点不是模型给出的归属到底对不对,而是你从此拥有了一条可以重复跑、可以写断言的请求。
import httpx

BASE = "http://127.0.0.1:8008"

REQUEST = {

    "model": "kev-latest",
    "state": {

        "case": "订单取消后,库存没有在 30 秒内回补",
        "observed": "接口返回 200;库存查询仍为原值;重试后恢复",
        "facts": [
            "库存回补由异步消息触发",
            "压测环境消息积压 4 分钟",
            "该用例过去两周出现过 3 次"
        ]
    },
    "questions": {

        "is_flaky": {

            "type": "noul",
            "instructions": "根据现有事实,这次失败是否更像环境波动而非功能缺陷?"
        },
        "fault_owner": {

            "type": "choice",
            "instructions": "当前最该由哪个方向先排查?",
            "criteria": {

                "service": "服务逻辑或异步消费异常",
                "environment": "测试环境或基础设施异常",
                "test_data": "测试数据或前置条件异常"
            }
        },
        "impact_level": {

            "type": "score",
            "instructions": "按当前证据评估影响等级。",
            "criteria": ["可观察", "需要跟进", "需要立即处理"]
        }
    }
}

response = httpx.post(f"{BASE}/v1/systemone", json=REQUEST, timeout=120)
response.raise_for_status()
print(response.json()["answers"])
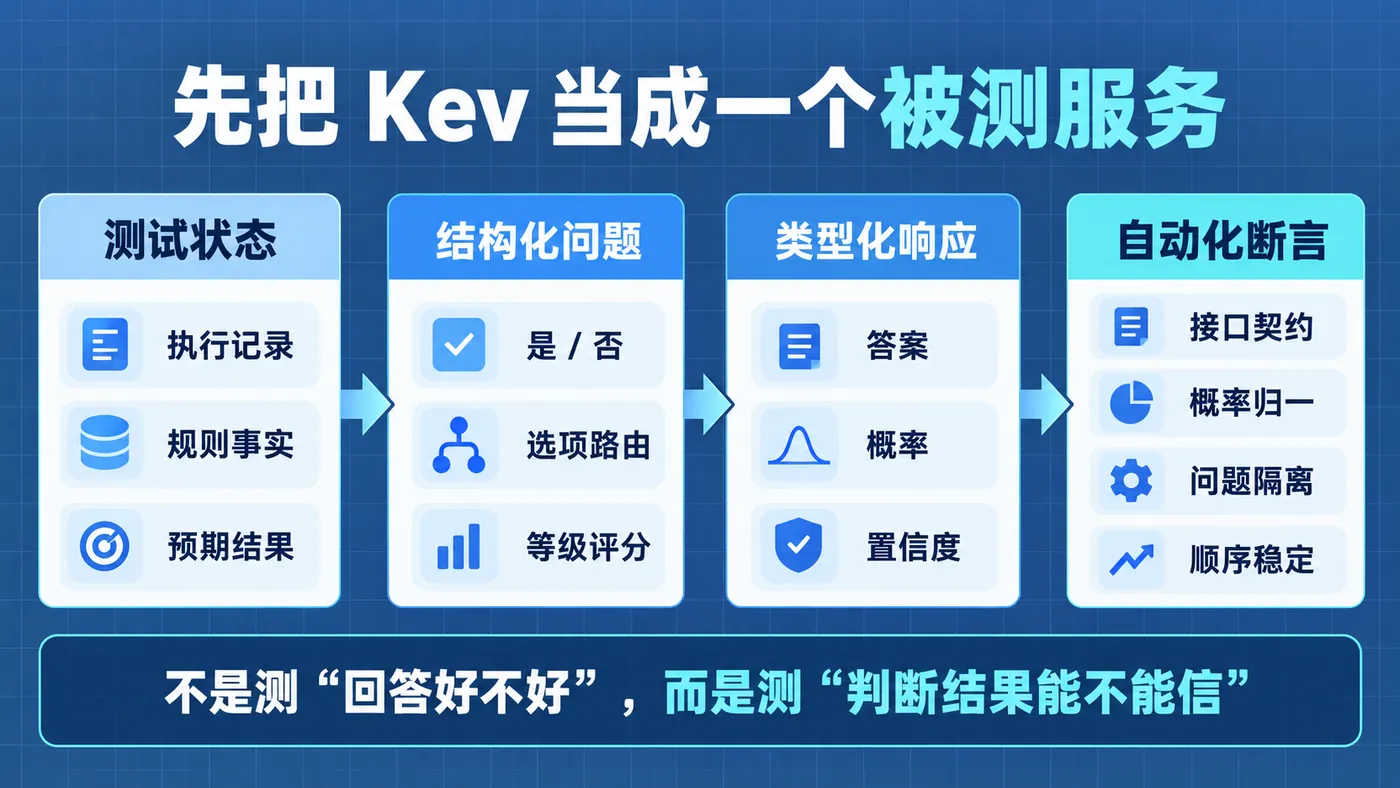
注意一个很容易犯的错误:不要把模型的首个答案当成预期结果。这里的预期结果首先应是协议预期,例如“choice 的候选项没有丢失”“概率分布可用”“score 有对应的等级图例”。语义正确性放到后面的人工标注样本里再验证。
4. 第三步:先写接口契约测试,别一上来只看 HTTP 200
很多 AI 服务的冒烟测试止步于 status_code == 200。对决策模型不够。
下面这组断言不关心本次到底判成“环境”还是“服务”,只检查响应是否仍满足你的依赖约定。它也应该是模型、SDK 或服务版本升级后的第一道回归。
import math
import httpx

def ask(path="/v1/systemone", body=REQUEST):
    resp = httpx.post(f"{BASE}{path}", json=body, timeout=120)
    assert resp.status_code == 200
    assert resp.headers.get("x-typesafe-request-id")
    return resp.json()

def test_decision_response_contract():
    result = ask()
    answers = result["answers"]

    # noul:服务承诺返回“true”的概率
    flaky = answers["is_flaky"]
    assert flaky["type"] == "noul"
    assert 0.0 <= flaky["noul"] <= 1.0

    # choice:候选项齐全、概率可归一、答案来自候选项
    owner = answers["fault_owner"]
    expected = set(REQUEST["questions"]["fault_owner"]["criteria"])
    assert owner["type"] == "choice"
    assert set(owner["probabilities"]) == expected
    assert math.isclose(sum(owner["probabilities"].values()), 1.0, abs_tol=0.03)
    assert owner["choice"] in expected
    assert 0.0 <= owner["confidence"] <= 1.0

    # score:不要只取一个数,等级映射也属于响应契约
    level = answers["impact_level"]
    assert level["type"] == "score"
    assert set(level["legend"]) == set(level["probabilities"])
这里有个测试思路值得记住:模型的答案允许变化,接口承诺不能随便变化。
例如你换了模型权重,fault_owner 从 environment 变成 service,这未必立刻是 Bug;但如果 probabilities 少了一个候选项、noul 被改成了自然语言、分数等级缺失,那后面依赖它的用例分流、报表和脚本都会坏。
5. 第四步:测“多题并发”有没有串题,也测选项顺序会不会影响答案
Kev 的一个核心卖点,是多个问题共享同一份状态,但各自隔离。对测试同学来说,这不是一句架构描述,而是一条可以直接写进自动化的行为要求。
项目服务提供了两个很适合教学和验收的辅助接口:
/v1/systemone/separate:把同一批问题拆成多个单独请求;/v1/systemone/permute:把一个choice问题的候选项多次换序。
先看隔离。相同状态下,“一问一请求”和“多问一请求”的核心选择不应该无缘无故翻转:
def test_batch_and_separate_are_consistent():
    batched = ask("/v1/systemone")
    separate = ask("/v1/systemone/separate")

    assert (
        batched["answers"]["fault_owner"]["choice"]
        == separate["answers"]["fault_owner"]["choice"]
    )
再测顺序稳定性。这个测试不是要求每次概率小数点后四位完全相同,而是为了抓住“只把选项顺序换了,第一名却翻了”的问题:
def test_choice_order_is_stable():
    body = {
   "request": REQUEST, "question": "fault_owner", "n_perm": 6}
    result = ask("/v1/systemone/permute", body)

    assert result["argmax_stable"], result["runs"]
如果这两个测试失败,先不要急着改阈值。先检查三件事:问题文案是否把多个意图塞到了一道单选题里;候选项是否重叠;你的状态是否缺了决定性的事实。模型“飘”有时确实存在,但更多时候是测试设计把一个不可判的问题伪装成了可判问题。
6. 第五步:概率能不能信,要靠校准测试,不靠直觉
最容易被误用的一句话是:“它给了 0.8,说明有 80% 把握。”
只有当你自己的数据上,模型打到 0.8 左右的样本,最终大约也有八成被人工确认时,这句话才成立。模型准确率高,不代表概率校准得好。
最小做法并不复杂:先准备 30~50 条已经人工裁决过的测试记录,覆盖四类样本:正常、边界、反例、未知。每条记录保留当时的状态、问题、正确选项和人工裁决日期。不要把事后排查结论塞回状态里,否则离线分数会虚高。
下面的 Brier 分数函数就能先跑起来。数值越小,代表预测概率与实际结果的差距越小;它不是唯一指标,却比只看“猜对了多少次”更适合检查概率有没有被高估。
def brier_score(labels: list[int], probs: list[float]) -> float:
    assert len(labels) == len(probs)
    return sum((label - prob) ** 2 for label, prob in zip(labels, probs)) / len(labels)

# labels:人工裁决,1 表示“确实是环境波动”
# probs:答案中 answers["is_flaky"]["noul"] 的概率
print(brier_score(labels, probs))
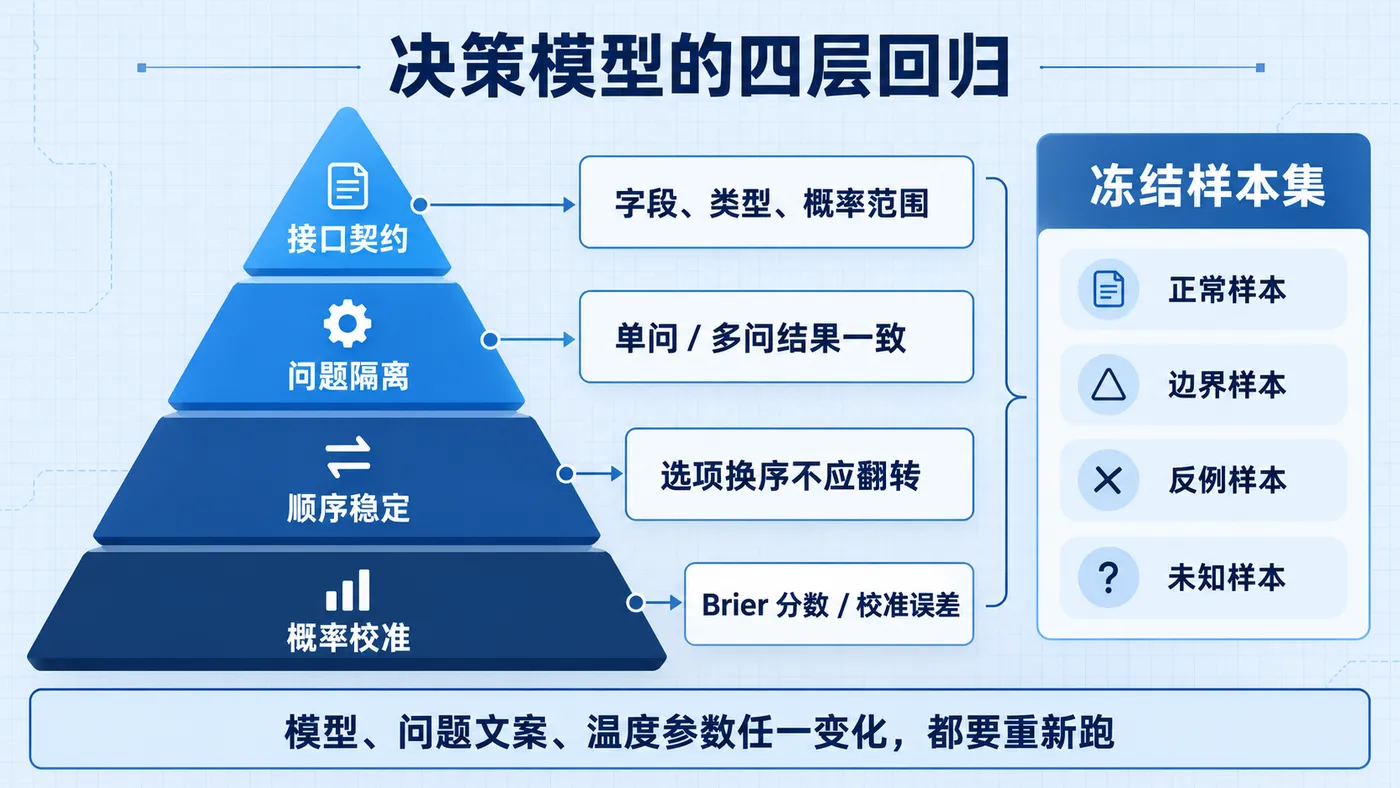
所谓“冻结”,不是把 Excel 锁起来不许更新,而是这一批样本一旦作为回归基线,就不能一边调模型一边拿它训练或反复改标注。模型版本、问题文案、候选项、温度参数任一个变化,都重新跑一遍。新样本可以持续补,但要和旧冻结集分开管理。
7. 微调是最后一步,不是第一步
Kev 支持基于自有 JSONL 继续训练,这确实是它的价值之一。但对测试团队而言,微调前至少要先完成两件事:
- 用冻结样本集证明:问题定义与标注口径本身是一致的;
- 用上面的四层回归证明:服务返回、问题隔离和概率行为没有基础性问题。
否则很容易出现一种假象:模型微调后“准确率提升了”,其实只是它记住了某位同学的标签习惯,或者你的评测样本已经被训练数据污染。
真正适合进入 JSONL 的,不是“这个缺陷很严重”这种散文式总结,而是可复核的记录:当时可见的状态、结构化问题、候选项、人工确认的标签、以及标签依据。这样你以后换模型、换团队成员,仍能解释这条样本为什么这么判。
8. 给测试工程师的最小检查清单
第一次接触这类模型,不需要先造一个庞大的 AI 测试平台。把下面六项跑通,就已经超过大多数“只看演示效果”的接入方式了:
- [ ] 本地接口能稳定返回类型化答案;
- [ ]
noul、choice、score都有契约断言; - [ ] 多问题和单问题请求的关键结论能对照;
- [ ] 候选项换序不会导致结果莫名翻转;
- [ ] 30~50 条人工样本能算出自己的概率质量;
- [ ] 模型、问题文案或温度参数变化后,会自动重跑冻结集。
Kev 的价值,不是让测试工程师从此相信模型替你判断,而是提供了一种更容易被测试的 AI 接口形态:问题固定、输出固定、概率可记录、行为可回归。
当你把它当作一个被测服务,而不是一个“会给建议的黑盒”,模型才真正开始进入测试工程能够掌控的范围。