补丁通过了,发布后第一个请求却失败
研发把一段 AI Coding 补丁交给测试:单测通过、静态检查通过、接口 Mock 也返回 200。合并后,模型服务在启动阶段报错,原因是补丁改了配置读取路径,测试里的假模型根本没有覆盖真实权重加载。
这种事故不稀奇。单元测试证明某个函数在替身对象上成立;真实服务还要经历依赖解析、模型加载、初始化、路由注册和第一个真实请求。AI 很擅长补齐局部代码,却不知道你们生产环境里那些没有写进函数签名的约束。NVIDIA 近期关于 SWE-Serve 的文章正讨论了这条缺口:有些补丁在没有真实服务验证时会被误判为通过。
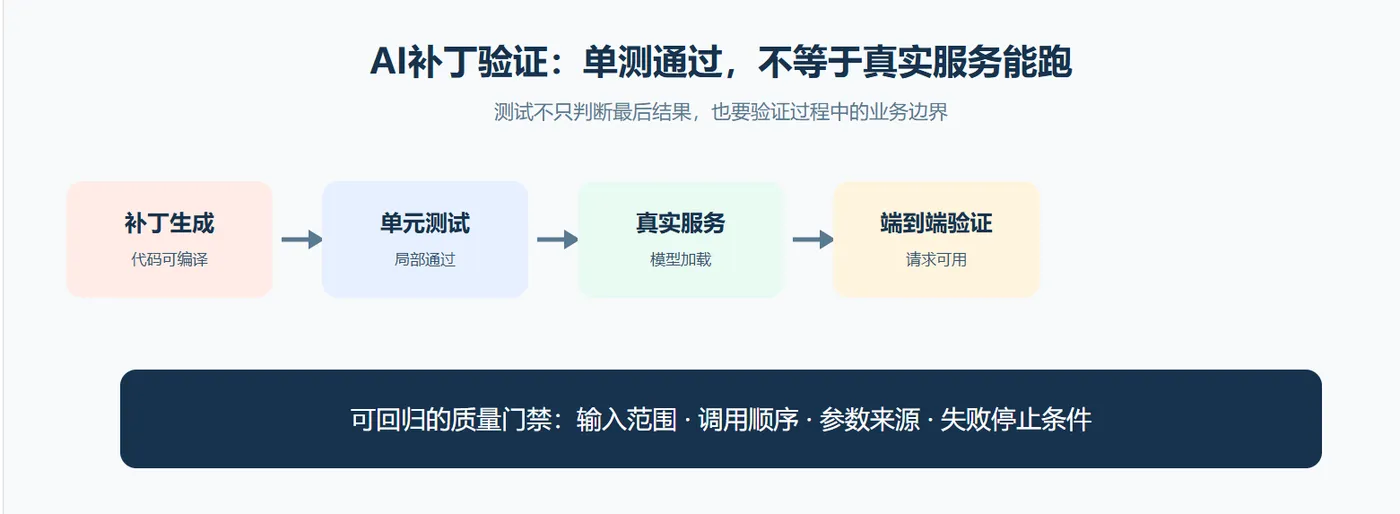
把验证分成四道门,别让单测替所有人背锅
第一道是单元测试:函数输入输出和异常分支;第二道是集成测试:配置、依赖和接口契约;第三道是服务冒烟:真实镜像启动、加载一个最小模型、发出健康检查;第四道是业务冒烟:用真实格式请求跑一次推理并检查响应语义。
前三道可以很快,第四道不必压满并发,但必须真的穿过模型服务。
最小真实服务断言长什么样
def test_model_service_smoke(client):
    health = client.get("/health")
    assert health.status_code == 200
    assert health.json()["model_loaded"] is True

    r = client.post("/infer", json={
   "text": "退货订单A-1042"})
    assert r.status_code == 200
    assert r.json()["label"] in {
   "refund", "unknown"}
    assert r.headers["x-model-version"]
重点不是把模型准确率塞进一次冒烟,而是验证“服务真的加载了应加载的版本、真的接住了真实协议、没有把异常吞成空成功”。如果生成补丁让 model_loaded 变成假值,或者请求走到了回退 Mock,这组断言就能暴露出来。
这里的 model_loaded 不能只表示进程端口打开。对于带向量库、模型权重或工具注册的服务,它至少应反映关键依赖已经完成初始化;对于订单类 Agent,还要检查请求确实走过鉴权和业务工具,而不是用 mock 结果短路。测试的目的不是要求 staging 和生产拥有同样规模,而是证明这份制品在真实边界上能完成一次有业务意义的调用。
这道门失败时,排查也有顺序:先看镜像中的模型或依赖版本是否与锁文件一致;再看启动配置、环境变量和密钥是否缺失;最后看输入序列化是否在真实网关前后发生变化。把失败归类,才能避免 AI 下次补丁又把同一类环境错误藏进绿色单测里。
把AI补丁变成可复盘的发布证据
真实服务验证也不代表把每个 PR 都推上生产。可以准备一个与生产契约一致、数据最小化的 staging:真实模型文件、真实解析器、真实鉴权中间件,但只放一条脱敏订单和一个只读工具。AI Coding 的补丁先在这里启动,再执行关键请求。这样既能发现环境差异,也不会把测试变成一次高风险发布。
测试报告要保留四类证据:补丁 commit、构建制品摘要、启动日志、关键请求的 Trace。遇到事故时能回答“代码改了什么、启动的是哪个制品、在哪条请求失败”,而不是只剩一句“AI 自己跑过测试”。这也是 AI Coding 时代测试工程师最有价值的把关能力。
每个 AI 生成的改动都记录:改了哪些文件、影响哪个启动路径、单测覆盖什么、真实服务跑了什么镜像和模型版本、第一条请求的 Trace 是什么。这样失败时不会只得到“AI写坏了”,而能定位是依赖、配置、权重、路由还是业务协议。
对测试工程师而言,这是把熟悉的冒烟测试迁移到 AI Coding 场景。以后最值钱的不是替 AI 多写几条断言,而是知道哪条真实链路必须让它亲自跑一遍。