
本文分享我们使用 阿里云 ChatOps Agent 处理云监控 ECS 磁盘告警的真实实践:我们登录阿里云控制台,在 阿里云控制台 ChatOps 对话框 中把告警信息发过去,Agent 辅助我们完成诊断、分级清理和效果验证,无需登录实例即可解除告警。
背景:告警处理还是人肉登录排查
磁盘使用率告警是运维工作中最高频的告警之一。传统的处理流程通常是:
- 收到云监控短信/钉钉告警;
- 登录告警实例;
- 执行
df -h、du -sh /*等命令逐级定位; - 判断哪些文件、镜像、日志可以清理;
- 执行清理命令;
- 再次验证磁盘使用率是否下降。
这个流程存在几个明显痛点:
- 重复劳动多:每台实例都要重复相同的排查命令。
- 依赖个人经验:判断"什么能删、什么不能删"需要熟悉业务。
- 排查效率差异大:新员工可能连
du -d 1 -h / | sort -h都要现查,不敢轻易操作;老员工凭经验知道常见"大户"是/var/log、/home/data/logs、Docker overlay2,但经验很难跨业务迁移。同样的告警,处理时间可能从 5 分钟到 30 分钟不等。 - 响应时间长:从告警发生到真正处理,往往要几分钟甚至更久。
- 缺乏审计记录:手工执行的命令和结果难以沉淀。
下图对比了传统人工排查与 阿里云 ChatOps Agent 自动化处理在效率、经验和审计方面的差异:
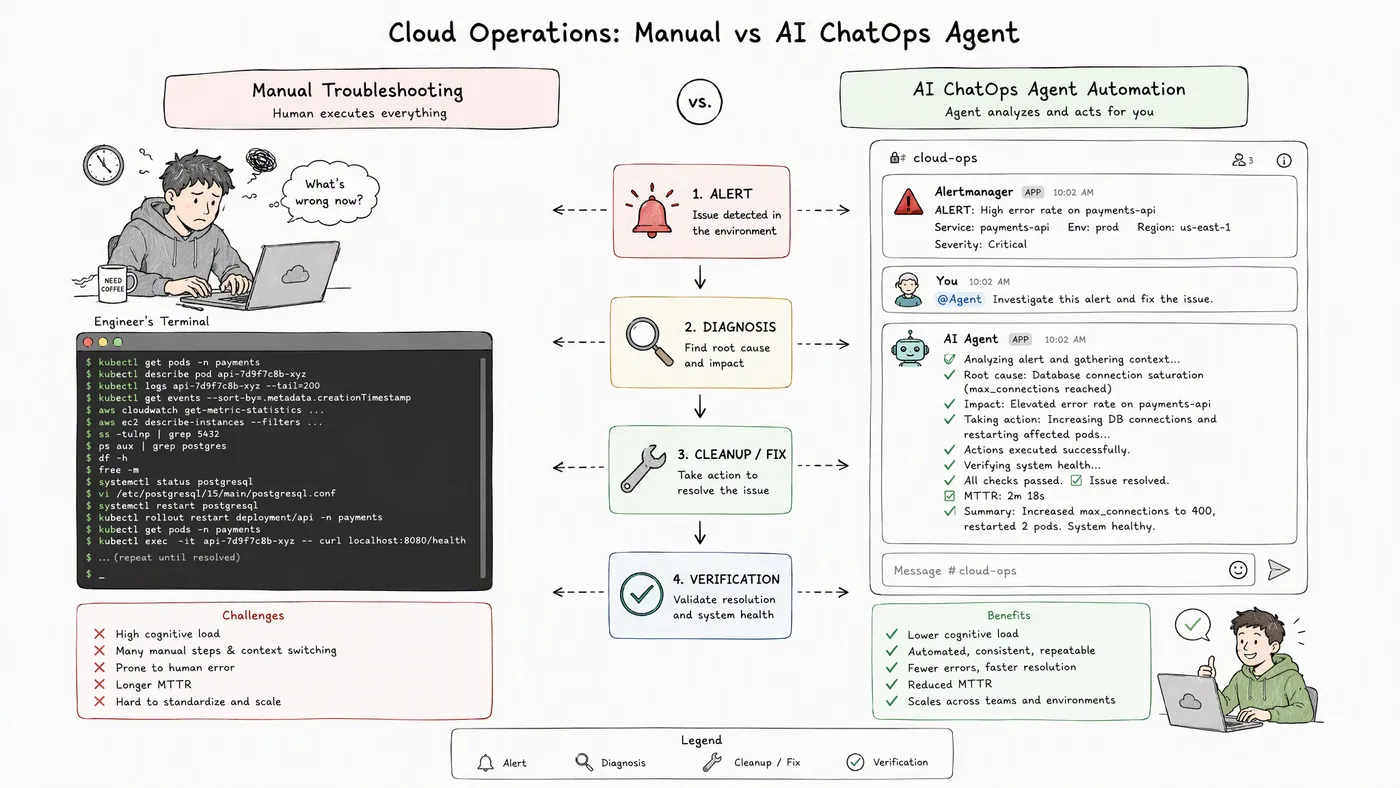
关键要点(结合上图逐项对照):
- 时间成本:人工排查平均需要 15-30 分钟,尤其在不熟悉环境时;Agent 从告警识别到生成方案通常只需 1-2 分钟。
- 经验依赖:人工处理高度依赖执行者的历史经验;Agent 通过 Skill 和记忆将经验沉淀为可复用的处理路径。
- 操作风险:人工操作可能误删关键文件;Agent 采用分级清理策略,并在高危操作前要求我们确认。
- 审计能力:手工命令分散在终端历史中,难以追溯;Agent 的每次工具调用和输出都记录在会话中,形成完整审计链路。
- 可扩展性:人工难以同时处理多起告警;Agent 可以并行响应多个会话,并将经验跨地域、跨业务线复用。
ChatOps 实践经验:做告警自愈时,建议从"有明确 SOP、风险可控"的场景切入(如磁盘清理、日志轮转、镜像清理),把高危操作保留给人工确认。这样既能快速看到 MTTR 下降的效果,又能在团队内建立对 ChatOps 的信任,再逐步扩展场景。
场景:我们的 ECS 实例磁盘使用率告警
某日,我们的业务系统中的一台 ECS 实例触发云监控告警:
| 告警项 | 内容 |
|---|---|
| 实例名称 | 某 OpenAPI 线上实例(已脱敏) |
| 实例 ID | i-xxxxxxxxxxxxxxxxx |
| 地域 | 西南 1(成都) |
| 告警规则 | 磁盘使用率 |
| 当前值 | 80.03%(>= 80%) |
| 设备 | /dev/vda1 |
| 应用分组 | 某线上业务分组(已脱敏) |
我们登录阿里云控制台,进入 阿里云控制台 ChatOps 对话框,把告警截图贴进去,并附上一句:"看看咋回事"。Agent 识别到这是一条 ECS 磁盘使用率告警,属于 "Disk Issues" 场景,随即自动加载对应的 ECS 诊断技能文档,并声明将按照规范流程执行。
实际处理中,我们只需要给出最简单的指令,Agent 就会按 Skill 里沉淀的排查流程自动执行后续步骤。
阿里云 ChatOps Agent 处理流程
1. 基础诊断
阿里云 ChatOps Agent 收到指令后,自动对实例执行基础诊断,按照 ECS 诊断 Skill 里沉淀的 SOP 完成以下排查:
- 实例状态与平台事件检查:调用 ECS OpenAPI 确认实例运行正常,无进行中系统事件,排除假性告警。
- 监控指标趋势确认:拉取
/dev/vda1过去 6 小时磁盘使用率曲线,确认是缓慢上涨到 80% 的渐进式告警。 - GuestOS 内部逐层分析:通过 Cloud Assistant 进入实例,执行
df -h、du -sh /*、docker system df、du -sh /var/log/*、du -sh /home/data/logs/*等命令,定位到 Docker 镜像、系统日志、应用日志是主要占用来源。 - 结果汇总与占用结构化:将诊断结果整理为结构化占用分析表,明确最大可回收空间来自 Docker 镜像。
| 目录/资源 | 占用大小 | 是否可回收 | 说明 |
|---|---|---|---|
| Docker 镜像 | 28.38G | 是 | 130 个镜像,大部分未被运行中容器引用 |
/var/log 旧备份与 journal |
约 3G | 是 | rpmdbdata 旧备份和过期 journal 日志 |
/home/data/logs 应用日志 |
约 2G | 是(可归档) | 应用历史日志 |
| 其他系统目录 | 约 12G | 否 | 系统文件和运行中容器 |
到这里,磁盘占用的构成已经清晰:Docker 镜像是最大的可回收空间,其次是系统日志和应用日志。Agent 基于这份分析再进入下一步的清理方案生成。远程命令执行的优势在于无需手动 SSH 登录,同时所有命令和输出都被记录在会话中,便于后续审计。
2. 生成分级清理方案
根据诊断结果,阿里云 ChatOps Agent 输出一份结构化的 ECS 磁盘告警诊断报告,并给出三级清理建议:
下图展示了三级清理策略的分层结构,以及每层对应的典型命令和风险等级:
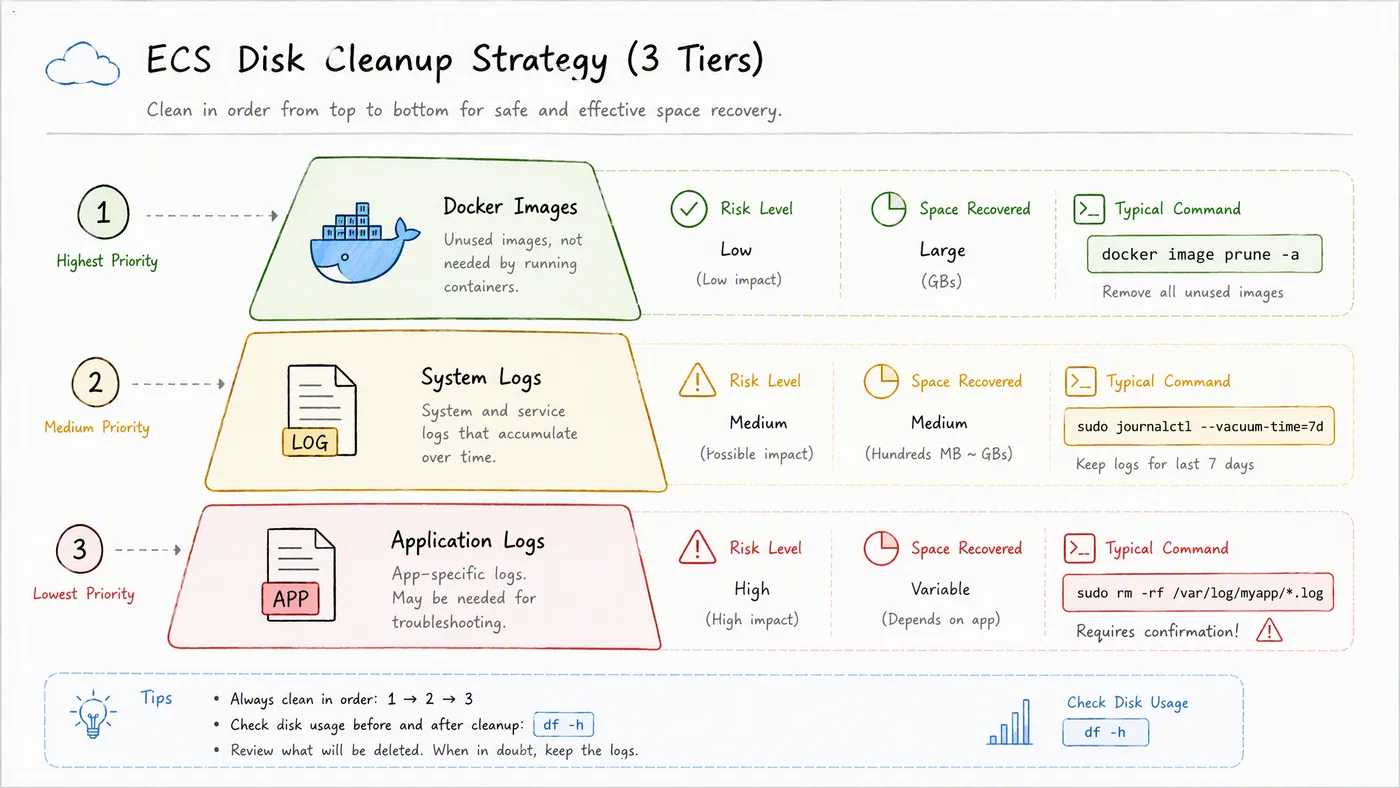
关键要点(结合上图逐项对照):
- 优先级 1:清理不使用的 Docker 镜像。典型命令为
docker image prune -a --force,可释放大量空间且不影响运行中的容器。风险最低,通常优先执行。 - 优先级 2:清理
/var/log日志文件。包括过期 journal 日志、旧 rpmdbdata 备份、lastlog截断等。风险中等,需要确认保留策略。 - 优先级 3:清理应用日志。路径如
/home/data/logs/,需根据业务实际情况清理或归档。风险最高,通常需要我们确认。
# 优先级 1:清理未使用镜像
docker image prune -a --force

# 优先级 2:清理系统日志
journalctl --vacuum-time=7d
truncate -s 0 /var/log/lastlog

# 优先级 3:应用日志(需按业务策略执行)
ls -lhS /home/data/logs/
这种分级策略非常重要:它把"释放空间"和"业务安全"平衡起来,优先清理低风险、高收益的目标(无用 Docker 镜像),再处理日志等需要业务判断的资源。
易踩坑点:docker image prune -a 会删除所有未被运行中容器引用的镜像。如果有重要但暂时未运行的镜像,请先用 docker images 确认后再操作。Agent 在执行前会通过 docker ps 和 docker images 交叉验证,降低误删风险。
3. 人工确认后执行清理
清理方案生成后,阿里云 ChatOps Agent 并未直接执行高危命令,而是等待我们点击"确认"。确认后,Agent 依次执行远程命令,并实时反馈执行结果。
4. 验证效果
清理完成后,阿里云 ChatOps Agent 再次检查磁盘使用率,并输出对比结果:
| 指标 | 清理前 | 清理后 | 变化 |
|---|---|---|---|
| 系统盘使用率 | 80%(45G/59G) | 34%(19G/59G) | ⬇️ 46% |
| Docker 镜像数 | 130 个 | 1 个 | -129 个 |
| Docker 镜像占用 | 28.38G | 3.88G | ⬇️ 24.5G |
| 可回收空间 | 28.12G | 0B | 已全部回收 |
最终,系统盘使用率从告警线 80% 降至 34%,共释放 24.5GB 空间,告警解除,且仅保留 1 个活跃容器使用的镜像,不影响业务运行。
阿里云 ChatOps Agent 在此场景中的关键能力
1. 基于记忆的经验复用
阿里云 ChatOps Agent 具备长短期记忆能力。当第一次成功处理完成都地域的磁盘告警后,Agent 会记住:"这类 ECS 磁盘满的常见问题首先是 Docker 镜像堆积,其次是 /var/log 日志,最后是应用日志"。
下一次再遇到其他地域(例如杭州、北京)的磁盘告警时,Agent 不会从零开始逐层排查,而是直接基于历史经验给出高概率的清理方案,大幅缩短诊断时间。
下图展示了记忆复用的完整链路:第一次完整诊断沉淀为经验,后续同类问题直接应用经验,跳过重复排查:
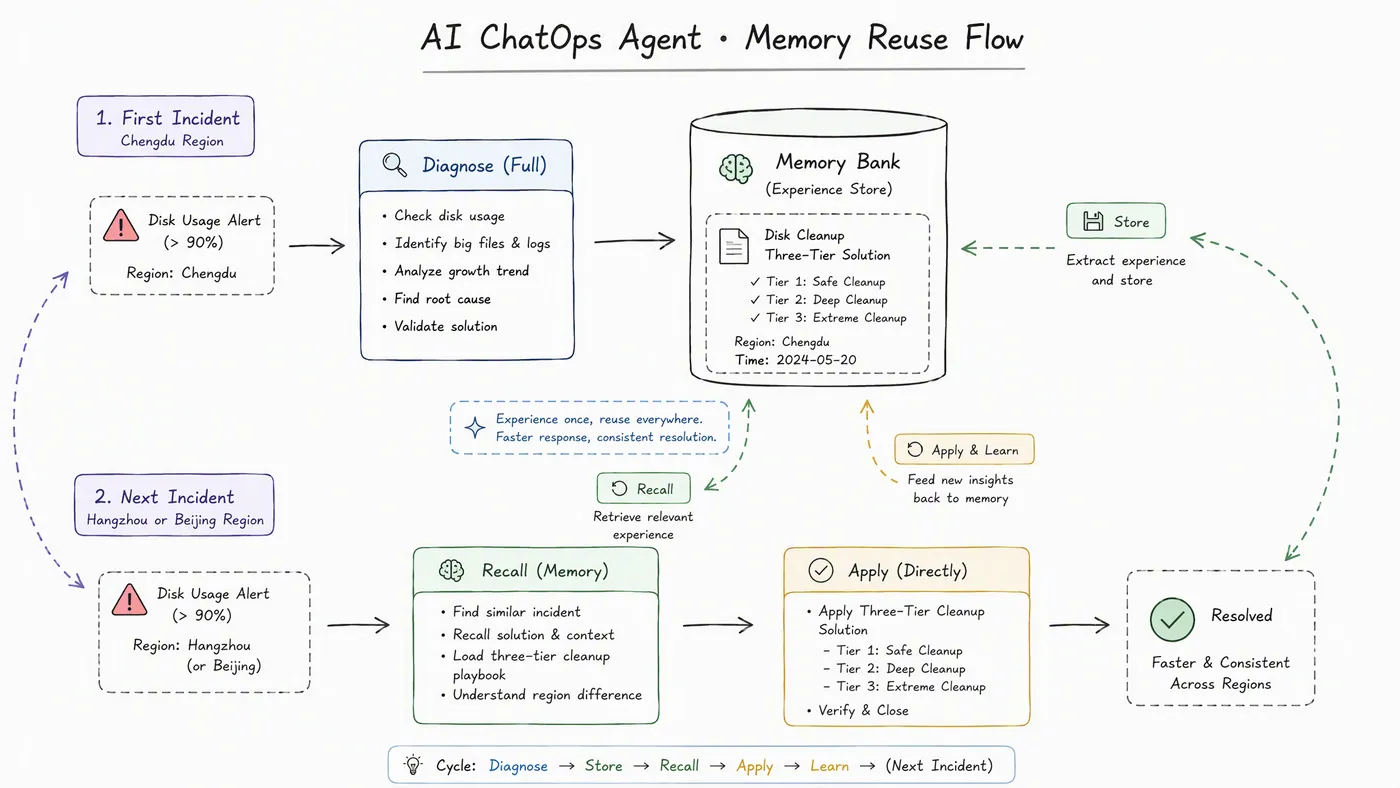
关键要点(结合上图逐项对照):
- 第一次处理:遇到成都地域磁盘告警,Agent 完整执行诊断、分级清理、效果验证,并提取关键模式:Docker 镜像堆积 >
/var/log日志 > 应用日志。 - 记忆沉淀:处理经验被存入记忆库,与 ECS 磁盘告警场景关联。记忆内容不仅包括命令,还包括优先级顺序、风险等级和验证方式。
- 后续触发:当杭州或北京地域出现同类告警时,Agent 从记忆库召回相关经验。
- 直接应用:Agent 优先推荐高概率方案,同时保留人工确认环节。如果环境有明显差异,Agent 会回到完整诊断模式。
ChatOps 实践经验:记忆复用是降低重复排查的关键。我们的做法是:第一次遇到某类告警时让 Agent 完整走一遍诊断流程,沉淀有效路径;后续同类告警直接基于记忆给出高概率方案。但要为 Agent 设置回退机制——当环境特征(地域、实例规格、业务类型)明显不同时,回到完整诊断,避免照搬旧经验。
2. 自然语言告警解析
我们无需记忆任何命令,直接在 阿里云控制台 ChatOps 对话框 中贴入告警截图或文本,Agent 即可理解告警类型、实例、地域、指标。
3. 结构化诊断与经验沉淀
除了记忆,阿里云 ChatOps Agent 还会加载对应产品的诊断 Skill 作为基础框架。但更重要的是,Agent 会把本次处理中验证有效的命令和策略沉淀下来,与历史记忆融合。这意味着新人遇到同类问题时,得到的不是冰冷的文档,而是经过实战验证的处理路径。
4. 远程命令安全执行
通过远程命令执行工具在目标实例上执行命令,无需手动登录机器。
5. 风险分级与人机协同
高危清理命令需要我们确认后才执行,既保证了自动化效率,又保留了安全边界。
6. 变更前后对比与验证
清理效果以表格形式量化呈现,方便我们确认告警是否真正解除。
推广价值:把 阿里云 ChatOps Agent 接入告警响应流水线
这次案例可以被推广为一套告警自愈的标准实践。下图展示了从云监控告警到告警解除的完整闭环:
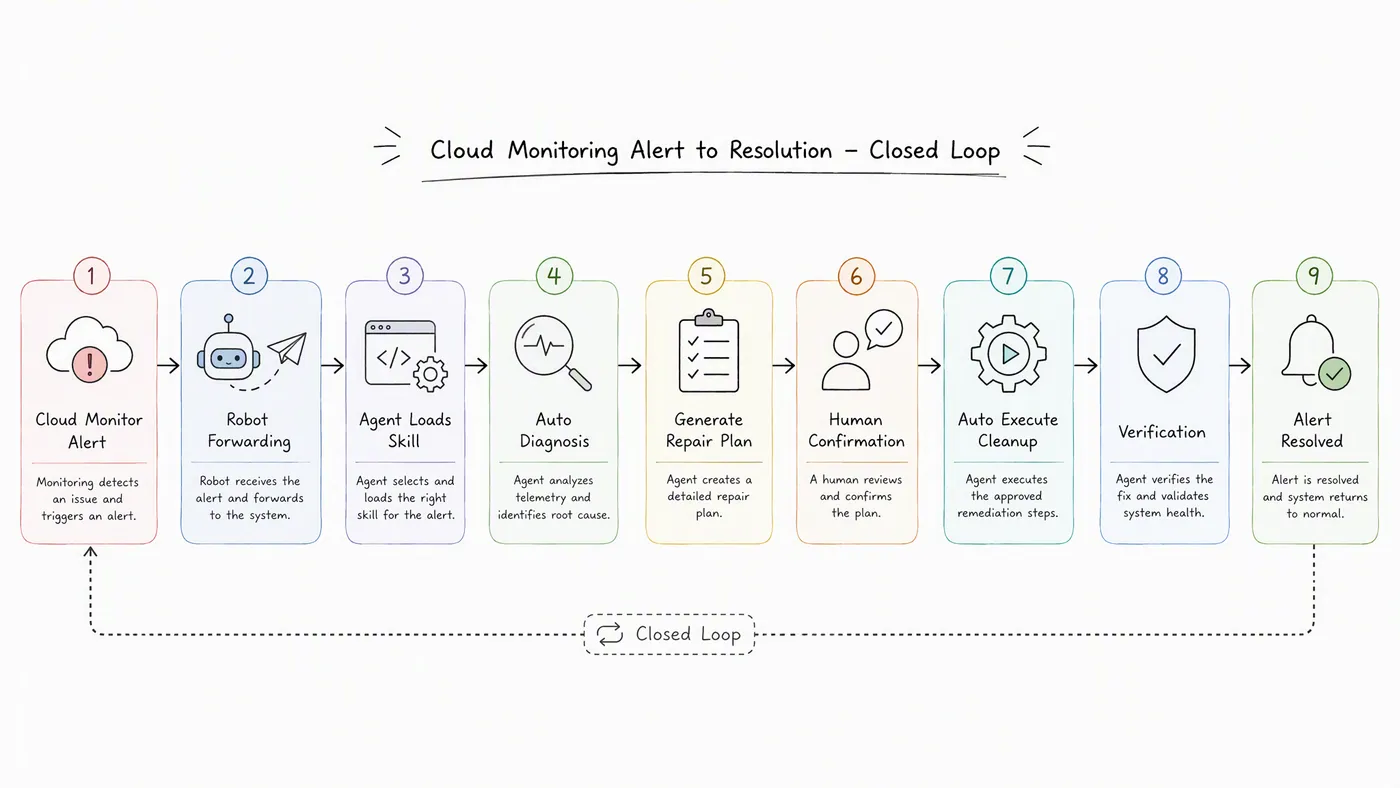
关键要点(结合上图逐项对照):
- 云监控告警:作为触发源,产生包含实例、指标、当前值、阈值等信息的结构化告警。
- 告警机器人转发:将告警信息自动转发到 阿里云 ChatOps Agent,无需人工复制粘贴。
- 识别场景并加载 Skill:Agent 根据告警内容判断场景类型,加载对应的诊断 Skill。
- 自动诊断:Agent 调用资源查询、远程命令执行等工具采集实例状态。
- 生成修复方案:基于 Skill 框架和历史记忆,生成分级清理方案。
- 人工确认:高危操作前等待我们确认,保留安全边界。
- 自动执行清理:确认后依次执行清理命令,并实时反馈结果。
- 验证效果:清理后重新检查磁盘使用率,确认告警解除。
- 告警解除:最终达到系统盘使用率低于阈值的状态。
对运维团队而言,推广这套模式的价值在于:
- 缩短告警 MTTR:从"收到告警 → 登录排查 → 手动清理"压缩为"告警自动派单 → Agent 基于历史经验直接修复"。
- 降低经验依赖:处理过的告警会沉淀在 阿里云 ChatOps Agent 记忆中,新员工无需背诵大量命令,也能得到经过验证的清理方案。
- 减少重复排查:同类问题第二次出现时,Agent 直接复用已有经验,不再从头分析。
- 沉淀审计记录:每一次告警处理的操作、结果、时间都被完整记录,便于复盘和合规审计。
适用场景与边界
阿里云 ChatOps Agent 告警自愈尤其适合以下场景:
- 磁盘使用率告警
- 日志目录膨胀
- Docker 镜像/容器堆积
- 临时文件未清理
- 其他有明确 SOP 的低风险运维操作
尤其适合以下人群:
- 运维新人:无需记忆大量命令,阿里云 ChatOps Agent 会基于历史记忆给出经过验证的处理方案。
- 多业务线团队:不同业务的日志路径、镜像策略不同,Agent 会分别记忆各业务线的有效处理路径。
- 值班/夜班场景:减少对人的经验依赖,降低疲劳状态下的误操作风险。
但以下情况仍需要人工介入:
- 清理目标涉及核心业务数据;
- 告警根因不明,可能是程序异常导致日志暴增;
- 需要应用层配合重启或配置变更;
- 涉及安全事件或入侵痕迹排查。
结语
阿里云 ChatOps Agent 正在从"对话式运维工具"演进为"告警响应 + 自动诊断 + 修复执行"的一体化 AIOps 入口。这次 ECS 磁盘告警自愈案例表明,对于高频、标准化、低风险的运维问题,Agent 已经能够以可量化、可审计、可复用的方式完成处理,让运维人员把精力投入到更复杂、更有价值的场景中。

