
先说结论
AI 工具类产品的工程难点不在模型层——模型能力是各家公开 API 调出来的——而在请求链路这层:额度怎么在并发下扣得准、高峰期请求怎么不雪崩、相同请求怎么不重复扣、生成内容怎么管住。这四件事决定了产品「用户多了会不会崩、账目乱不乱、会不会被下架」。这篇按额度计费、排队与缓存、内容审核流水线、账单核对四段拆实现要点。
一、额度计费:并发扣减与三本账分离
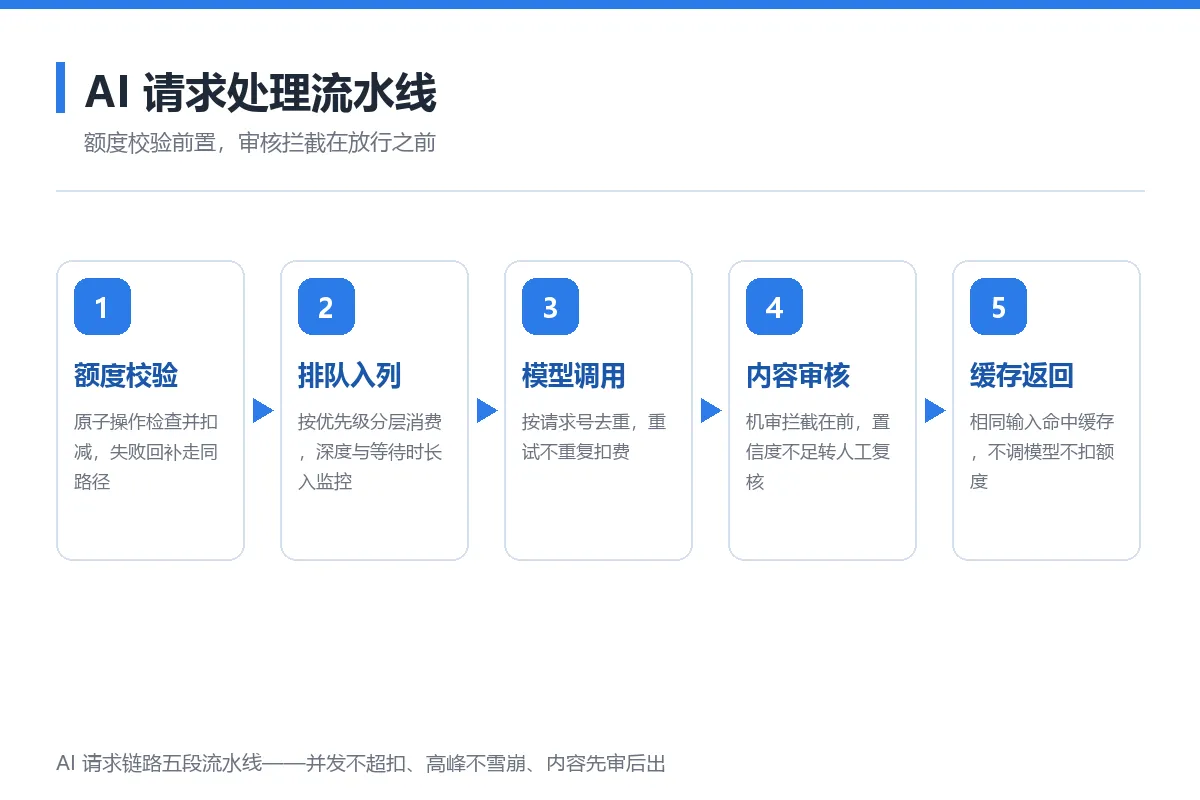
图 5:AI 请求链路五段流水线,额度校验前置于入队
额度体系的典型故障是并发超扣:两个请求同时读余额、都判断「还有额度」、都放行——账就扣穿了。工程解法:
- 原子扣减:额度余额放 Redis,用原子操作做「检查并扣减」,扣不动的请求直接拒绝并返回明确错误码;调用失败按规则回补,回补同样走原子路径防重复;
- 三本账分离:免费额度、会员套餐、单次购买是三类账本,扣减顺序做成可配置(先免费后会员或反之),每笔扣减记录「账户类型-扣减量-关联请求号」,可追溯到单次调用;
- 成本护栏:用户级每日调用上限 + 系统级总消耗熔断线,双层阈值;触发熔断只降级不崩溃——返回排队提示或缓存结果,不把错误抛给全部用户;
- 计量口径:按模型返回的实际消耗计量,不用「一次请求算一次」的粗口径——不同长度输入的消耗差几十倍,粗口径要么亏损要么用户觉得被多扣。
二、请求排队与结果缓存:削峰与幂等
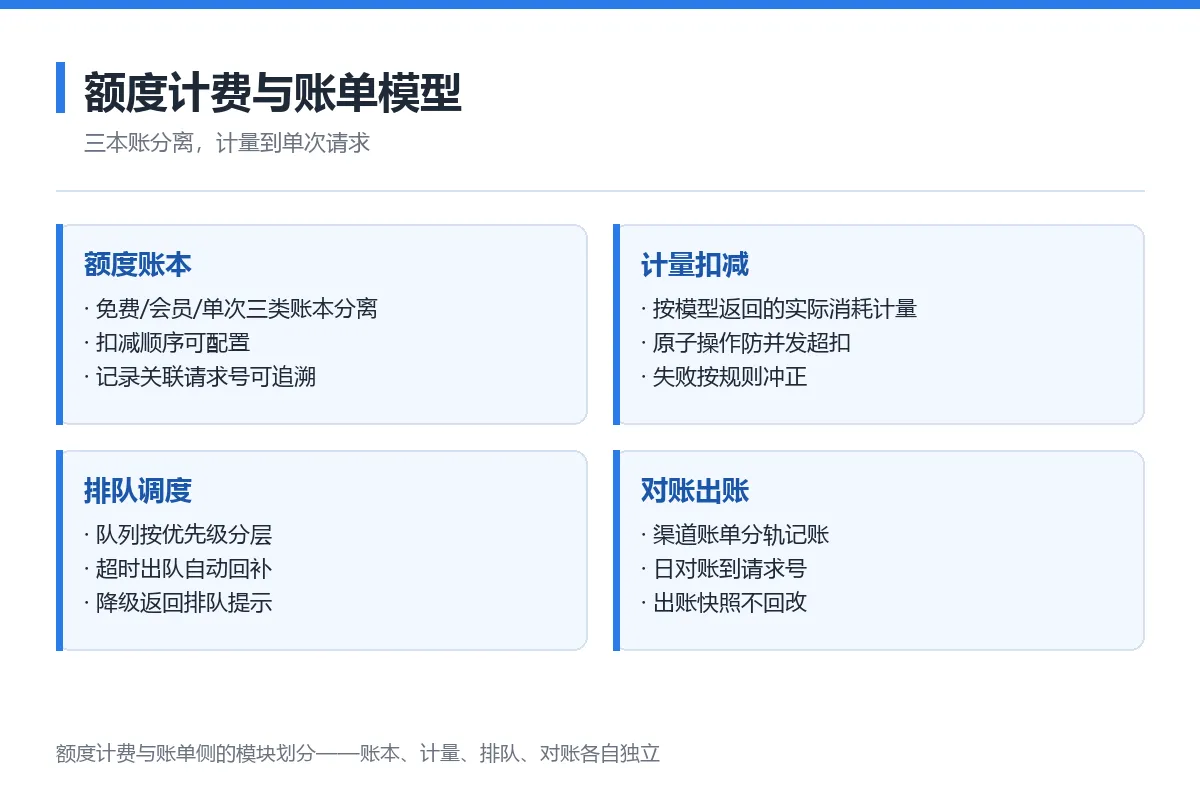
图 6:额度计费与账单侧的模块划分
模型接口的响应时长比普通业务接口长一个量级,直接同步等待会拖垮连接池:
- 排队削峰:请求入队(队列按优先级分层:付费会员 > 免费额度),工作池按下游接口的限流配额消费;队列深度与等待时长暴露到监控,超时请求出队并自动退款/回补额度;
- 结果缓存:相同输入(归一化后)命中缓存直接返回,不调模型、不扣额度——缓存键要做归一化(去空白、统一格式),否则命中率趋近于零;
- 幂等设计:客户端重试带同一请求号,服务端按请求号去重——重试不重复扣费是底线;扣减、调用、入账三步用「先记账后执行、失败冲正」的顺序,避免出现「扣了钱没结果」的无凭据状态;
- 降级路径:模型接口异常时返回排队提示或引导稍后重试,并把失败率、平均时长按模型/时段维度记录——这些指标就是容量与稳定性基线;适配层做成可替换接口,业务层不感知具体模型方。
三、生成内容先审后出流水线
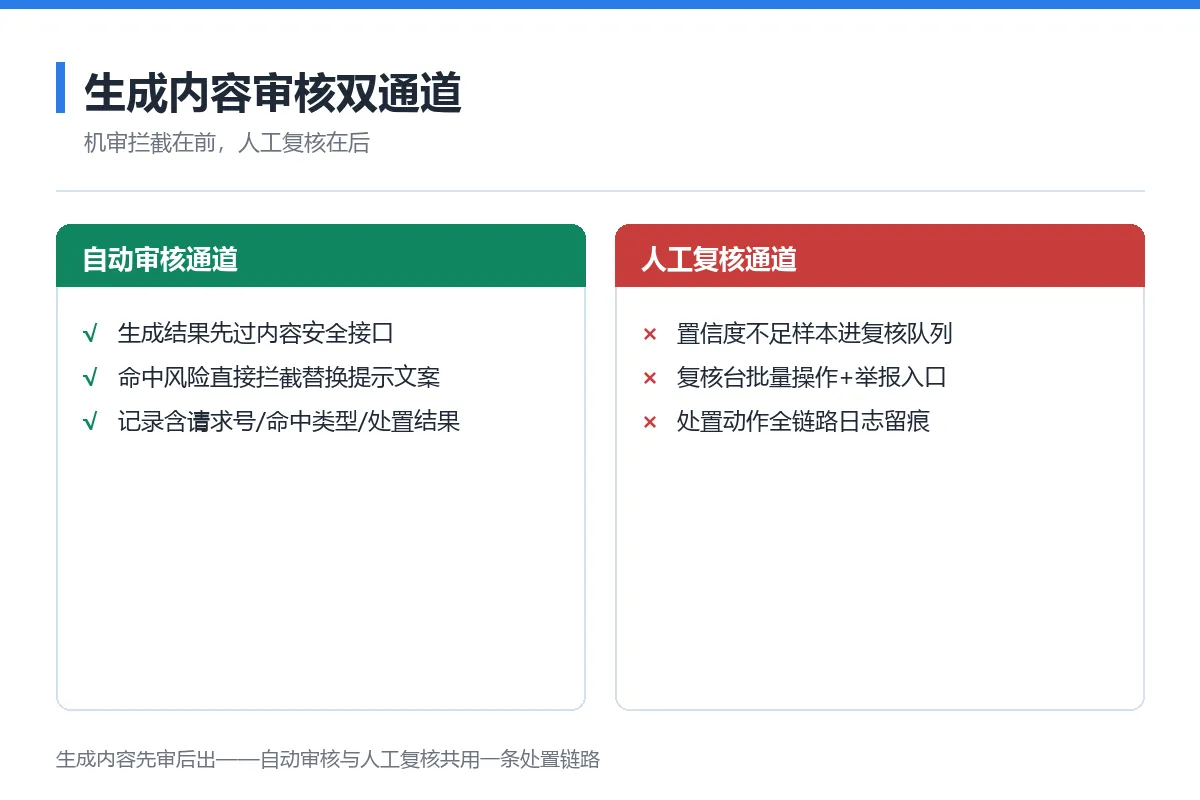
图 7:机审拦截在前、人工复核在后的双通道设计
面向公众的生成类工具,内容安全不是可选模块:
- 自动审核通道:生成结果先过内容安全接口(文本/图文按内容类型选择),命中风险的直接拦截并替换为提示文案,不放行到前端;审核记录含请求号、命中类型、处置结果,全量留痕;
- 人工复核通道:自动审核置信度不足的样本进复核队列,复核台支持批量操作与举报入口;用户举报与机审拦截共用一条处置链路,避免两套口径;
- 生成标识:AI 生成内容按平台规范添加标识,标识随内容存储而不是前端临时拼——转发、截图后标识仍在;
- 日志留痕:请求参数、模型版本、审核结果、处置动作全链路落日志,留存周期按监管与平台要求配置。这四件事在立项期进需求清单,上线后补的代价是重构审核链路。
四、账单核对:用量、收入、渠道三账勾兑
[配图位 · 表 1]技术模块划分表(模块/核心职责/关键约束)
图注:表 1:AI 工具类小程序后端的模块与约束速查
| 模块 | 核心职责 | 关键约束 |
|---|---|---|
| 额度账本 | 免费/会员/单次三类余额的原子扣减与回补 | 并发安全,可追溯到单次请求 |
| 请求队列 | 削峰、优先级消费、超时出队 | 深度与等待时长入监控 |
| 结果缓存 | 归一化命中、重复请求去重 | 缓存键归一化,幂等不重复扣 |
| 审核流水线 | 机审拦截 + 人工复核 + 标识 + 留痕 | 全量日志,处置链路单一 |
| 计量出账 | 按实际消耗计量、按渠道分账 | 渠道账单分轨,日对账 |
| 成本护栏 | 用户日上限 + 系统熔断 | 降级不崩溃,阈值可配置 |
出账侧的要点:模型消耗、用户收入、渠道结算三条数据线分开记——不同渠道的结算周期与分成口径不同(个人主体虚拟支付与 APP 内购的差异是典型场景),混在一条流水里月度对账必然对不平。对账粒度到「每笔请求 × 每个金额字段」,差异告警定位到请求号,运维拿到告警即可介入;出账单由定时任务生成,生成即快照,规则调整不回改历史账单。
小结
AI 工具类产品的工程质量取决于四套结构:额度账本的原子扣减让并发不超扣,排队与缓存让高峰不雪崩且重复请求不重复扣,先审后出流水线把内容风险拦在放行之前,三账分离的对账让每一笔都能核对到请求号。这四块在架构期定稳,换模型、调计费策略、扩渠道都是配置级变更;定不稳,任何一个高峰期或一次监管检查都会把问题放大。附图三张按请求流水线、模块划分、审核双通道分别给出结构参考。

