
导读:同样是 4 核 8G 的配置,别人的服务器跑得飞快,你的却动不动卡顿、超时、报错?作为专注 IDC 云服务器与机房运维的多多云,我们在处理工单时发现:90% 的 "配置不够" 其实是配置没调好。这篇文章不聊玄学,直接给 5 个最容易被忽略、却又最影响性能的调优细节,附验证命令和解决方案。
先看现象:你遇到的是哪一种 "慢"?
先别急着换配置、加钱升配。慢,要先分清慢在哪一层:
网页加载慢、接口超时 → 可能是负载、网络、连接层问题
高并发时偶发报错 → 可能是句柄、端口、内核参数问题
用了半天突然卡顿、然后自己恢复 → 可能是 Swap、IO 瓶颈
日志对不上、证书校验失败、任务调度错乱 → 可能是时间同步问题
把问题归类,才能对症下药。下面这张图是我们的标准排查顺序,先系统后网络、先资源后参数: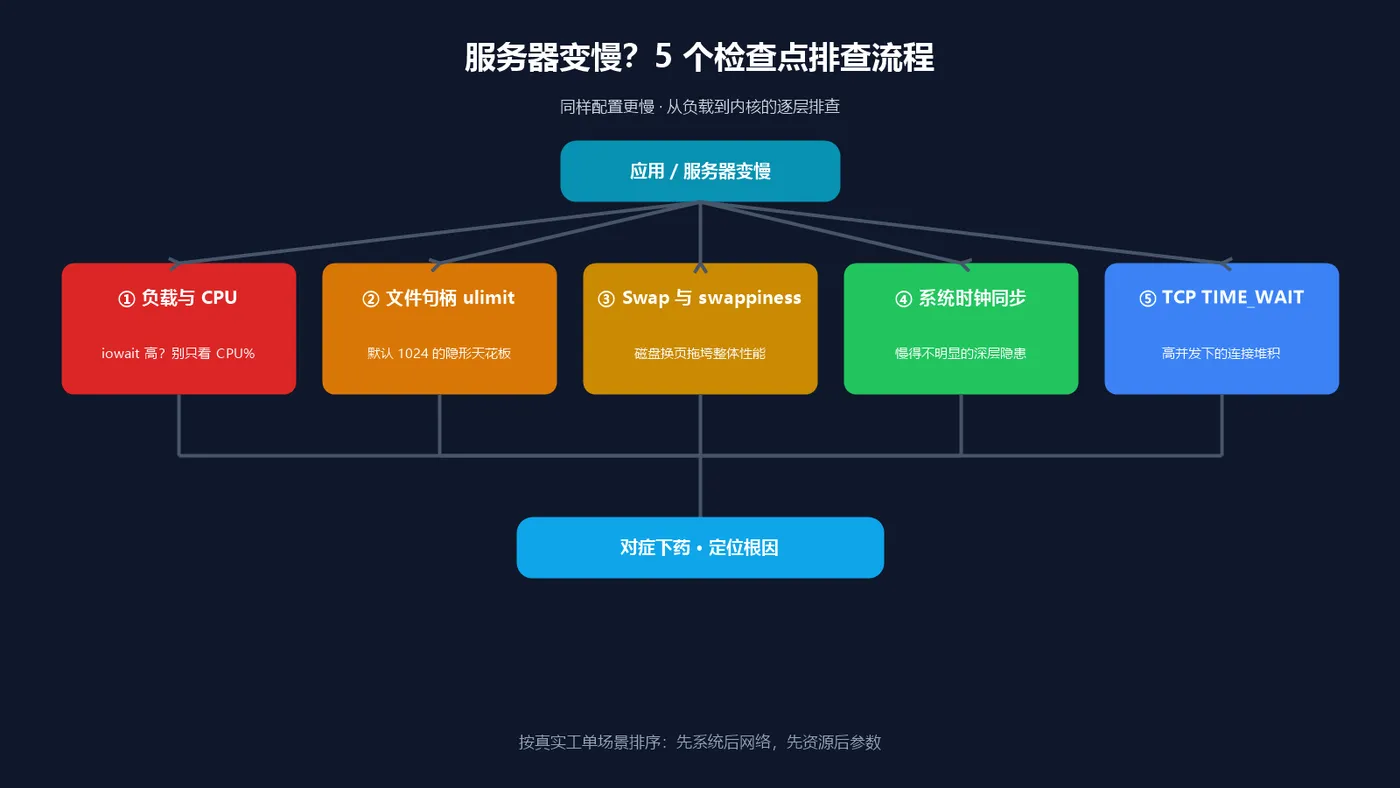
接下来按顺序讲透这 5 个细节。
细节一:Load Average 很高,但 CPU 很闲 —— 别被监控骗了
现象:top 一看 CPU 使用率才 20%,但 load average 飙到 3~4,网站依然卡成幻灯片。很多人一看 CPU 没满,就以为是带宽或者代码问题,方向完全错了。
根因:Load Average 统计的是 "运行队列中的进程 + 不可中断睡眠(D 状态)的进程" 数量。当进程在等待磁盘 IO(比如读文件、写日志、数据库刷盘)时,会进入 D 状态 —— 它们不占 CPU,但会撑高负载。所以 CPU 空闲 + Load 虚高,大概率是磁盘 IO 等待(iowait)在作怪。下面这张示意图,就是这类问题的典型曲线: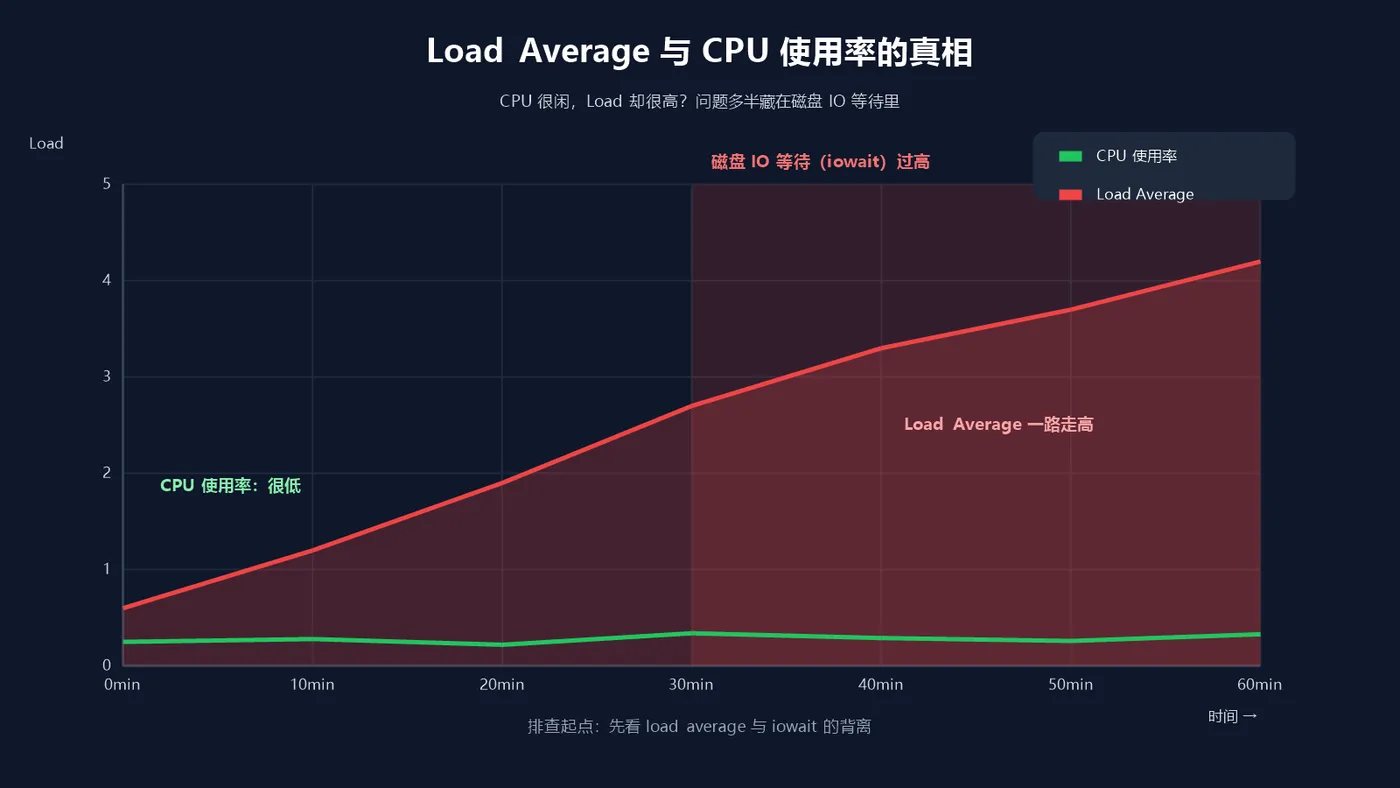
验证命令:
uptime                          # 看 1/5/15 分钟负载

vmstat 1 5                      # 重点看 wa 列(IO 等待占比)

iostat -x 1 3                   # 看 %util 和 await,判断磁盘是否饱和
调优方案:
确认是磁盘瓶颈后,先看业务侧:日志和应用数据分盘、上缓存(Redis)、优化慢查询
数据盘选型:云服务器同配置下,IO 型云盘和普通云盘性能差异巨大,IO 密集业务务必按需选盘
实在扛不住再谈升配 —— 但要升的是磁盘性能,而不是 CPU 核数
IDC 实战提示:多多云在机房运维中见过太多客户把 "IO 瓶颈" 误判成 "CPU 不够",白花冤枉钱升配 CPU。买服务器时先想清楚业务是 CPU 密集还是 IO 密集,这是同配置性能差距的第一大来源。
细节二:文件句柄上限 —— 高并发下的 "隐形天花板"
现象:接口平时正常,一到流量高峰就偶发报错 Too many open files,重启服务又好一阵,如此反复。排查代码半天找不到问题。
根因:Linux 里每个 TCP 连接都要占一个文件描述符(fd),而很多系统镜像的软限制默认只有 1024。几个并发的连接请求一上来,句柄瞬间打满,新连接直接失败。
验证命令:
ulimit -n                       # 查看当前进程的句柄上限

cat /proc/<进程PID>/limits      # 查看某个服务的实际限制

lsof -p <进程PID> | wc -l       # 统计该进程已打开的句柄数
调优方案(三步,缺一不可):
\# 1. 临时生效,当前会话

ulimit -n 65535

\# 2. 永久生效,写入 limits.conf

cat >> /etc/security/limits.conf <<'EOF'

\* soft nofile 65535

\* hard nofile 65535

EOF

\# 3. 用 systemd 管理的服务,必须单独加(limits.conf 对它无效)

\#    在服务的 .service 文件里加:

\#    LimitNOFILE=65535
IDC 实战提示:多多云做新机交付检查时发现,很多云厂商自带镜像模板里
nofile和nproc都偏保守。新机器到手的第一步就应该是改句柄上限,这条应该写进你的初始化脚本里,而不是等报错了再补。
细节三:Swap 与 swappiness —— 内存看着够用,为什么还是卡?
现象:free -h 一看内存还剩 2G,没满啊?但系统就是频繁卡顿,偶尔还伴随磁盘读写指示灯狂闪。
根因:Linux 有个参数叫 swappiness(默认 60,范围 0~100),数值越大,内核越 "积极" 地把不常用的内存页换到 Swap 里。问题在于:云服务器的 Swap 落在云盘上,读写速度比内存慢几个数量级。一旦触发换页,进程就要排队等磁盘,整个系统被拖垮。
验证命令:
free -h                         # 看 swap used 是否在增长

cat /proc/sys/vm/swappiness     # 看当前换页倾向值
调优方案:
\# 临时调整

sysctl -w vm.swappiness=10

\# 永久生效

echo "vm.swappiness = 10" >> /etc/sysctl.conf

sysctl -p
云服务器场景建议 swappiness 调到 10 左右(数据库等 IO 敏感业务甚至可以调 0 或直接禁用 Swap)。它不会让你内存 "变多",但能避免业务 IO 被换页挤占。
IDC 实战提示:内存不够的正解是加内存,不是依赖 Swap 硬扛。Swap 是 "保险",不是 "性能"。另外,云盘 IOPS 是共享预算,Swap 疯狂读写还会拖累同一块盘上的业务数据读写。
细节四:系统时钟同步 —— 慢得不明显,危害却深远
现象:日志时间对不上、HTTPS 证书校验偶发失败、数据库主从复制报错、定时任务 / 分布式调度错乱。表面看服务器 "不慢",但处处不对劲。
根因:在虚拟化环境下,虚拟机的时钟比物理机更容易漂移。如果系统没有启用 NTP/chrony 时间同步服务,漂移会越积越大,达到秒级甚至分钟级。而证书校验、主从复制、任务调度这些场景对时间偏差极其敏感 —— 一次偏差,就是一次失败重试,体感就是 "莫名其妙的慢"。
验证命令:
timedatectl                     # 查看时间同步状态(NTP synchronized 是否 active)

chronyc tracking                # 查看时钟偏差(Offset 应在毫秒级)

date                            # 顺手看一眼当前时间
调优方案:
\# 安装并启用 chrony(主流发行版推荐,替代老旧的 ntpdate)

yum install chrony -y   # 或 apt install chrony

systemctl enable --now chronyd

\# 配置国内可达的时间源(编辑 /etc/chrony.conf)

\# server ntp.aliyun.com iburst

\# server ntp.tencent.com iburst

\# server cn.pool.ntp.org iburst
IDC 实战提示:时间同步是多多云开新机的固定检查项。数据库、证书类、对账类业务尤其要盯紧 Offset——偏差超过 100ms 就该报警了。
细节五:TCP TIME_WAIT 堆积 —— 高并发短连接的 "连接灾难"
现象:高并发场景下,新连接建立失败或明显变慢,ss -s 一看,TIME_WAIT 状态的连接堆了几万个,本地端口被占满。
根因:HTTP 短连接一多,主动关闭的一方会进入 TIME_WAIT 状态,等待 2MSL(约 60 秒)才能彻底释放。而默认本地端口范围(ip_local_port_range,通常是 32768~60999)只有 2 万多个,连接堆积一多,端口耗尽,新连接就建不起来了。
验证命令:
ss -s                                 # 看 TIME\_WAIT 总数

ss -tan state time-wait | wc -l       # 精确统计

cat /proc/sys/net/ipv4/ip\_local\_port\_range
调优方案:
\# 内核参数优化(写入 /etc/sysctl.conf 后 sysctl -p 生效)

net.ipv4.tcp\_tw\_reuse = 1     # 复用 TIME\_WAIT 连接(仅对主动发起方有效)

net.ipv4.ip\_local\_port\_range = 1024 65535   # 扩大端口范围

net.ipv4.tcp\_fin\_timeout = 30
但更重要的还是架构层面:能长连接就长连接(连接池、Keep-Alive),让负载均衡层去扛短连接压力,源站专注业务。tcp_tw_reuse 只对主动发起连接的一端有效,服务端被动接收连接时它帮不上忙 —— 别指望一个参数解决所有问题。
IDC 实战提示:高防、负载均衡这类转发层设备本身也会产生大量 TIME_WAIT,排查时要分清连接堆积在转发层还是源站,对症下药。
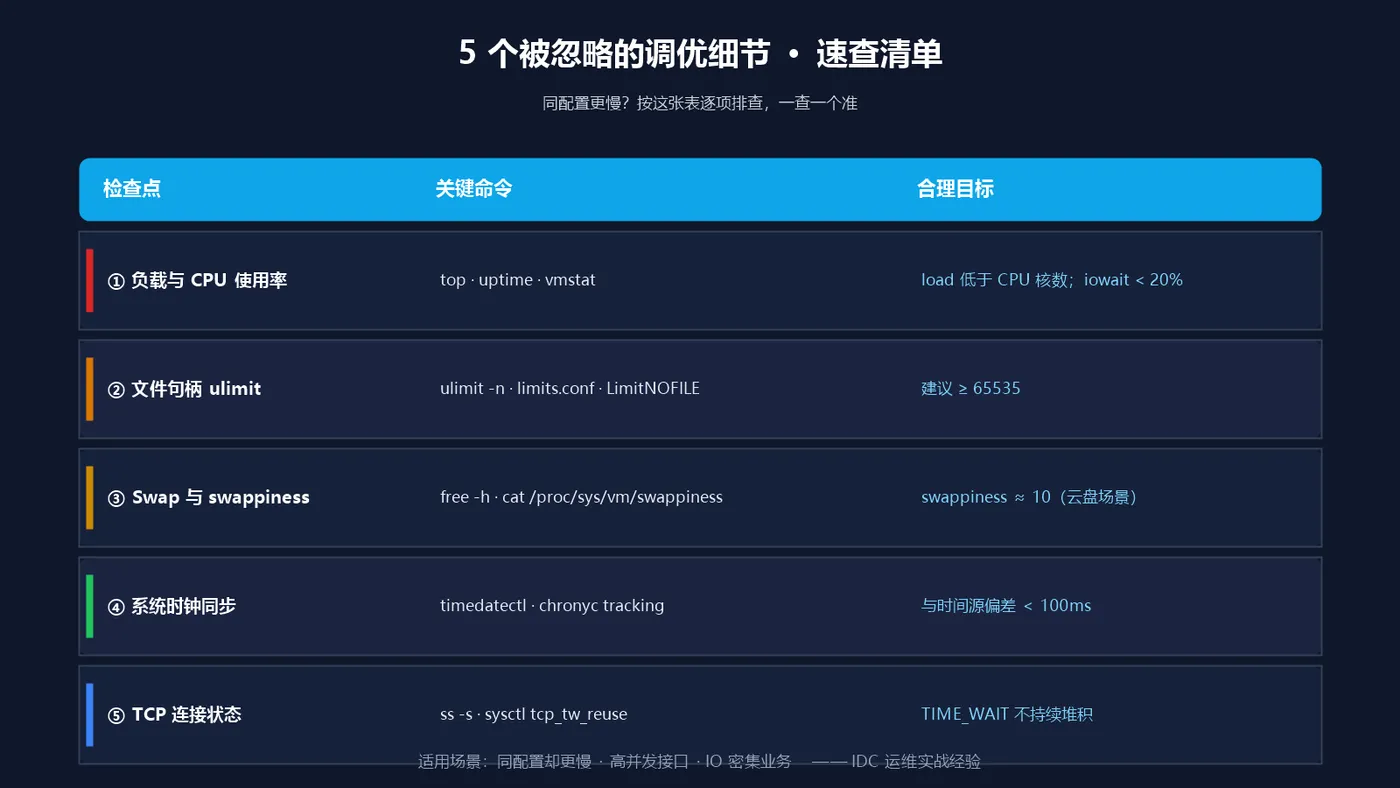
一张图带走:5 个检查点速查清单
最后说两句
同样的配置,性能差距往往不是硬件决定的,而是细节调没调决定的。这 5 个点按顺序过一遍,大部分 "莫名其妙的慢" 都能找到答案:
先看 Load 与 CPU 的背离 → 判断是不是磁盘 IO
再查句柄上限 → 排除高并发的隐形天花板
检查 Swap 与 swappiness → 防止磁盘换页拖后腿
确认时钟同步 → 别让时间偏差制造 "玄学故障"
最后看 TCP 连接状态 → 解决高并发下的连接堆积
调优前记得先备份配置、记录基线指标,改一项观察一项,别一口气全上。
如果你也遇到过 "同配置更慢" 的诡异问题,欢迎在评论区聊聊你的排查经历 —— 说不定下一篇文章的主角就是你的案例。想交流服务器选型与调优,也可以随时了解多多云的云服务器与机房运维服务。
本文由多多云发布。多多云专注 IDC 云服务器与机房运维服务,日常和服务器、网络、安全打交道,更多运维实战内容持续更新中。


