
别再往项目里叠 AOP 切面了——我把接口治理做成了一条可插拔的管道
一个切面,两条过滤器链,
pjp.proceed()有且仅有一次;限流、日志、指标、告警都是链上可插拔的过滤器。引入一个依赖,什么都不配就生效。
一、接口治理是怎么被我们做"散"的
先盘点一下一个"治理得还不错"的 Spring Boot 项目里通常有什么:
- 一个
ApiLogAspect:@Around包住所有 Controller,记日志、算耗时; - 想限流了,再加一个切面,或者引 Sentinel,方法上贴注解;
- 要上 Prometheus,又加一层 Micrometer 埋面;
- 慢方法告警,再叠一个切面或者干脆写在业务代码里。
这套东西能跑,但有几个每个人都被坑过的问题:
- 切面越叠越多,执行顺序靠猜。四个
@Around叠在同一个方法上,@Order数字谁记得住?出问题时没人说得清"限流和日志到底谁先执行"。 pjp.proceed()被调了 N 次。每一层切面都调一次,任何一层手滑多调一次或没抛回去,整条链的行为就变了。- 能力不可插拔。想临时关掉日志?改代码。想替换限流算法?改代码。治理能力和业务代码长在了一起。
- 指标互相污染。耗时统计的切面包在最外层时,被限流拒绝的请求也被算进了耗时分布——监控上看 P99 突然变高,其实只是限流生效了。
问题不在某个切面写得不好,而在架构:治理是一个横切关注点的集合,我们却把它做成了一个个孤立的切面。
Servlet 有 Filter 链,Spring Cloud Gateway 有 GatewayFilter,Dubbo 有 Filter 链——处理"请求进来,依次经过一组可插拔的处理单元"这件事,业界早已验证过答案:管道。我把同样的模式搬到了 Controller 治理上,做成了这个 Starter。
二、核心设计:一个切面 + 两条过滤器链
做法是只保留一个 AOP 切面作为唯一入口,切面内部把一次请求的完整生命周期拆成两条过滤器链:
Controller 请求
   │
前置链:信息采集(1) → 流量统计(100) → 限流判断(200) → 自定义
   │        │ 任一过滤器返回 false 即短路,业务方法不执行
业务方法(pjp.proceed() 有且仅有一次)
   │
后置链:耗时统计(400) → 日志记录(500) → 自定义
   │
响应
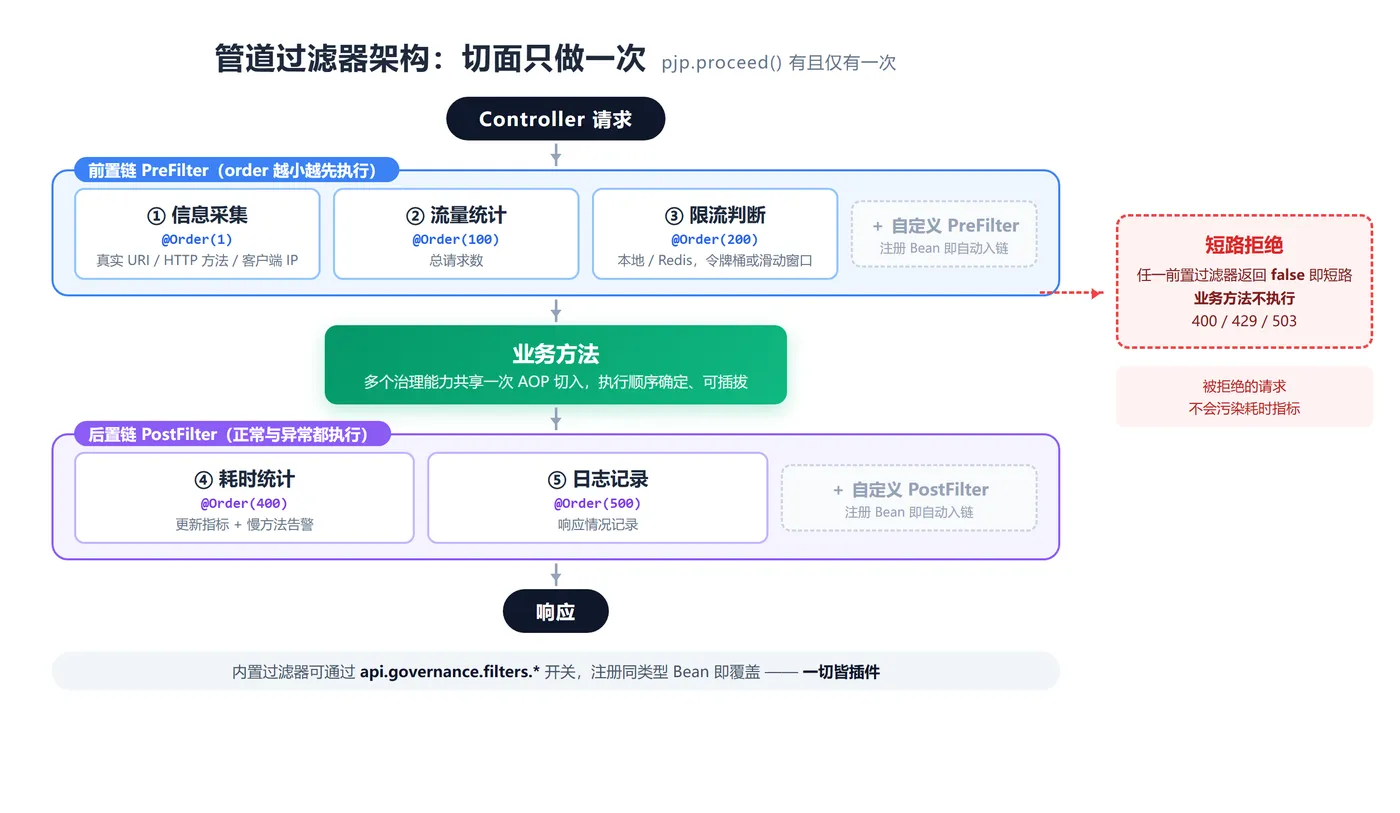
这个结构一次性回答了上面所有问题:
1. 顺序是结构决定的,不是猜的。 前置链按 @Order 从小到大,后置链同理。限流(200)在统计(100)之后、日志(500)在耗时(400)之后,每个位置写在代码里,不写在人的记忆里。
2. proceed() 有且仅有一次,在两条链之间。过滤器只做决策:返回 true 放行,返回 false 短路拒绝(可以自定义 400/429/503)。不存在"哪层切面忘了放行"这类事故面。
3. 一切皆插件。 实现一个 PreFilter / PostFilter 注册为 Bean 就自动入链:
@Component
@Order(300)
public class ParamCheckFilter implements PreFilter {

    @Override
    public boolean doFilter(FilterContext ctx) {

        if (ctx.getArgs() == null || ctx.getArgs().length == 0) {

            ctx.setRejectStatus(400);
            ctx.setRejectReason("参数缺失");
            return false;   // 短路:业务方法不会执行
        }
        return true;
    }
}
5 个内置过滤器也都能通过 api.governance.filters.* 单独开关,或注册同类型 Bean 覆盖。自定义过滤器还能直接拿到真实请求上下文:getRequestUri()(路径变量实际值)、getClientIp()(X-Forwarded-For → X-Real-IP → remoteAddr)。
4. 指标不被污染是结构的副产品。 耗时统计(400)在后置链上,只有真正执行了的请求才会走到这里——被限流拒绝的请求在(200)就短路了,Micrometer Timer 里天然没有它们。
需要说明:管道模式本身不是新东西,这个项目的价值不在于发明模式,而在于把模式落到方法级治理这个场景时,解决了它特有的一批问题。下面是最典型的两类。
三、30 秒上手
引入依赖:
<dependency>
    <groupId>io.github.biglv666</groupId>
    <artifactId>api-governance-spring-boot-starter</artifactId>
    <version>0.5.0</version>
</dependency>
写一个普通的 Controller,不加任何注解、不改任何代码:
@RestController
@RequestMapping("/api/users")
public class UserController {


    @GetMapping("/{id}")
    public User get(@PathVariable Long id) {

        return userService.findById(id);
    }
}
每个请求会自动输出:
[API] GET /api/users/{id} - com.x.UserController#get - 成功 - 耗时: 12ms
管理接口 GET /api-governance/metrics 已经能查到调用次数、成功率、慢方法明细。需要控制时,全项目只有三个注解:
@RateLimit(limit = 100)                 // 类级默认限流
@RateLimit(limit = 5, window = 60, key = "#request.username")  // 按参数独立配额
@NoLog                                  // 关日志,统计仍保留
@Skip                                   // 完全放行(健康检查之类)
下面聊管道里最有意思的那个过滤器:限流。
四、分布式限流过滤器:三个文档不会告诉你的坑
本地限流没什么好讲的,ConcurrentHashMap + 惰性过期就够。有意思的是 Redis 分布式限流,我踩了三个坑。
坑一:窗口判定不能用客户端时间
滑动窗口最直觉的实现:Lua 脚本里用 ARGV 传入应用服务器的时间戳,ZREMRANGEBYSCORE 清理窗口外的 member,再 ZCARD 计数。
问题在于多实例时钟漂移:A 机器快 200ms,B 机器慢 200ms,同一时刻两台机器对"当前时间"的判断差了 400ms,窗口边界上的计数就不准了——而分布式限流恰恰是为了多实例一致才存在的,用客户端时间等于自废武功。
正确做法是在 Lua 脚本里用 TIME 命令取 Redis 服务器时间,窗口判定和令牌补充都基于它。但 TIME 是非确定性命令,Redis 4.x 及之前的逐字复制模式下,主从复制的是整段脚本而不是效果,从库重放时会产生不同的结果。
所以脚本开头必须显式调用:
redis.replicate_commands()  -- 切换为效果复制,Redis 3.2~4.x 可用
local t = redis.call('TIME')
local now = t[1] + t[2] / 1000000
Redis 5+ 默认就是效果复制,这个调用幂等无害。这一行,很多 Redisson 之外的手写限流实现都漏了。
坑二:同毫秒并发,ZSET 的 member 会互相覆盖
滑动窗口用 Sorted Set 计数时,member 得保证唯一。我最开始用「毫秒时间戳 + 线程 ID」,结果写测试时发现计数偏松——同一毫秒内、线程池复用导致的同线程两次请求,member 完全相同,后一次 ZADD 把前一次覆盖了。换成 UUID 才彻底消除。
坑三:Redis 挂了,限流过滤器该放行还是拒绝?
这是管道上最典型的一个"决策类过滤器"该回答的问题,没有标准答案,但必须显式回答:
fail-open(放行):可用性优先,Redis 故障时退化为不限流,但业务不受影响;fail-close(拒绝):配额优先,Redis 故障时全部返回 503——注意是 503 而不是 429,429 语义是"你请求太快",503 语义是"我这边限流组件故障",运维看监控能一眼区分,而不是把系统故障误判成用户刷接口。
无论哪种策略,故障都会触发 RATE_LIMITER_FAILURE 告警(可以直接推钉钉群)。
五、SpEL 按参数限流:好用,但有个安全边界你必须知道
@RateLimit(key = "#id") 一个注解就能按参数值独立配额:
@GetMapping("/users/{id}")
@RateLimit(limit = 10, key = "#id")
public User get(@PathVariable Long id) {
    ... }
实现上用的是受限的 SimpleEvaluationContext:不允许类型引用、构造器调用和 Bean 引用,表达式解析失败自动回退接口级限流,只打 warn 不影响业务。这套防御是为了杜绝 SpEL 注入——StandardEvaluationContext 加上客户端可控输入,是可以直接打出 RCE 的。
但这里有一个更隐蔽的问题,值得单独说:当表达式结果由客户端可控输入派生时(用户名、IP、任意 ID),每个新取值都从满配额开始。攻击者只要遍历一万个不同的 id,就等于拥有一万个独立的 10 次配额。所以:
- 「按参数限流」的正确用途是租户间公平性(防止一个租户耗尽共享配额);
- 它不能作为防爆破等安全边界使用;
- 防爆破场景应该叠加接口级总配额,或者实现
RateLimitKeyResolverBean 组合 IP 等低基数维度。
另外高基数 key 还有内存风险,本机限流器的键数量上限(max-entries)就是为这个准备的,键超限会淘汰。
六、管道之外:可观测性这条"暗线"
管道负责决策,治理还差另一半:看得见。
- Micrometer 桥接:
api.governance.requests(Counter,outcome 分 success/error/reject)、api.governance.request.duration(Timer)、api.governance.apis.tracked(Gauge)。api标签是全限定类名#方法名,基数上限就是 Controller 方法数,不会标签膨胀,对接 Prometheus/Grafana 零配置。 - 告警:慢方法 / 限流拒绝 / 限流器故障 / 异步任务被拒四类事件,内置 Webhook 通知器基于 JDK HttpClient(零第三方依赖),钉钉支持加签(HMAC-SHA256)。同一个
(类型, apiKey)默认 10 秒内只发一次,防告警风暴把群刷爆。 - 内存指标防膨胀:每个 API 的最近记录是有界滑动窗口(条数 + 时长双上限),全局 API 数量 LRU 淘汰。内存型指标组件不做这个,运行久了就是一个 OOM 定时炸弹。
- 异步钩子(0.5.0):
@AsyncAction+@AsyncHandler可以给任意 Spring Bean 方法挂四阶段旁路任务(写日志、发通知之类),带启动期校验——Handler 引用了不存在的 action 直接启动失败,拼写错误不再静默失效。
七、写在最后
完整代码和文档(中文注释、升级指南、最小可运行示例工程都在):
👉 https://github.com/BIGLV666/api-governance-spring-boot-starter
Maven Central 可直接引入,坐标见上文。欢迎提 issue 和 PR。
最后留两个问题,评论区聊聊:
- 你项目里的治理能力(日志/限流/指标)现在是独立切面还是统一管道?叠过几个
@Around? - 你们线上的限流故障策略是 fail-open 还是 fail-close?有没有因为选错吃过亏?
下一篇计划把这条管道的扩展机制拆开讲:怎么写一个生产级的自定义过滤器(含 FilterContext 的完整能力清单和一个脱敏过滤器的完整实现),感兴趣的关注一下不迷路。


