一、前言
大模型应用在本地测试效果亮眼,上线之后频繁出现输出不稳定、幻觉增多、响应超时、调用成本持续走高;优化提示词、微调权重之后,不经意间引发旧场景能力退化;用户真实问题无法回流到模型迭代流程,优化工作全凭经验试错。
究其根本,绝大多数项目只搭建了基础模型服务,缺少一套标准化、可落地的评估与迭代闭环体系。优化动作零散、没有统一衡量标准,无法量化改动带来的收益与风险。完整的大模型迭代体系,需要串联四大核心模块:离线评测、在线观测、回归测试、人工反馈。四类机制相互打通,形成数据流转闭环,持续驱动模型可靠性、推理成本、响应时延以及业务核心指标同步优化。
二、体系整体架构设计
1. 核心设计目标
搭建评估迭代体系,首要明确四大优化目标,所有模块设计都围绕目标展开:
- 1. 可靠性:降低幻觉、拒绝率、格式错误、异常输出,保证输出稳定合规;
- 2. 响应速度:控制推理时延、并发吞吐,规避流量高峰服务雪崩;
- 3. 调用成本:管控Token消耗、GPU资源占用,平衡效果与算力开销;
- 4. 业务指标:贴合真实业务场景,如问答准确率、任务完成率、用户满意度。
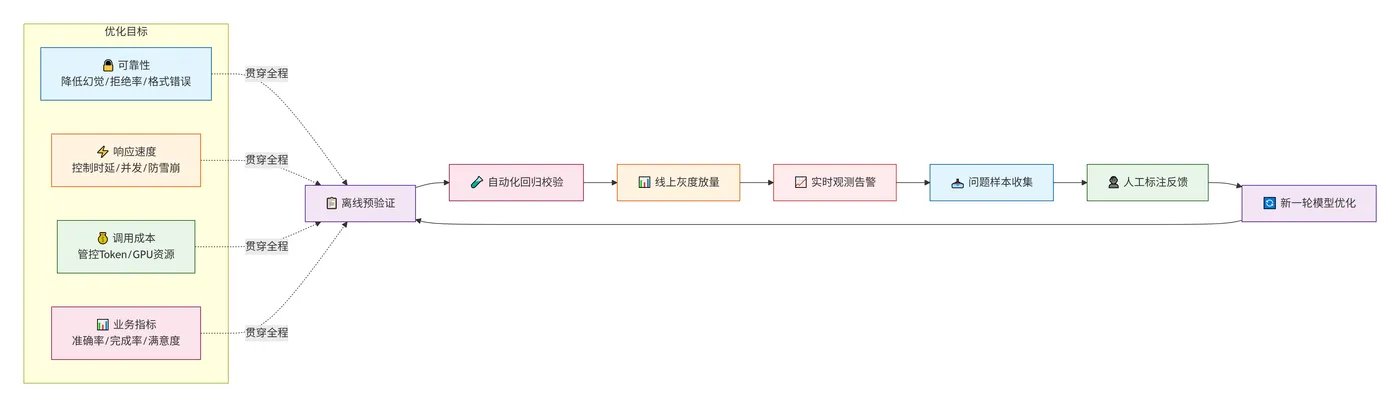
整个体系遵循 “离线预验证 → 自动化回归校验 → 线上灰度放量 → 实时观测告警 → 问题样本收集 → 人工标注反馈 → 新一轮模型优化” 的完整链路。不存在单次优化一步上线,所有改动都需要多层关卡验证。
2. 四大核心模块关系
- 离线评测:模型上线前的第一道关卡,用于版本初选、候选模型横向对比;
- 回归测试:模型/提示词/推理配置改动后,自动化验证原有能力不退化;
- 在线观测:线上真实流量数据采集、指标大盘、异常实时告警;
- 人工反馈闭环:线上坏例沉淀、人工标注、样本回流训练与评测集更新。
四大模块不是相互独立的工具,而是数据互通:
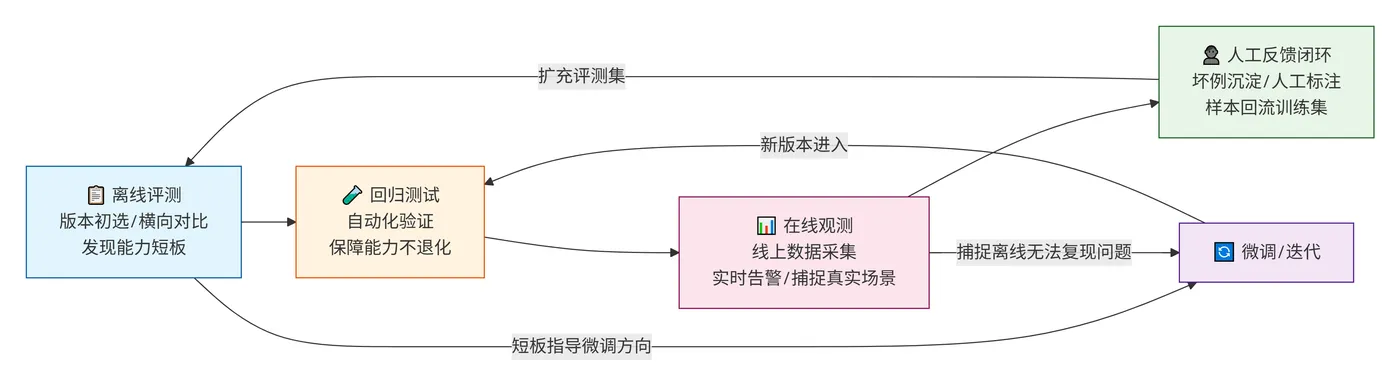
- 人工标注产生的样本自动扩充离线评测数据集;
- 离线评测发现的短板指导微调方向;
- 线上观测捕捉离线无法复现的真实场景问题;
- 回归测试保障每一轮迭代不会破坏已有能力。
3. 极简数据流分析
这是一个闭环迭代体系:线上采集坏例 → 人工标注 → 自动更新评测集与训练集 → 新版本离线评测 → 回归测试 → 灰度上线 → 持续观测。指标恶化自动回滚,合格则继续放量。
- 用户真实请求&响应 → 在线观测采集日志 → 自动筛选坏例 → 人工标注平台
- 标注样本入库 → 自动更新离线评测数据集 & 微调训练集
- 新模型/新Prompt版本 → 离线评测打分 → 自动化回归测试
- 评测达标 → 灰度上线 → 持续线上观测
- 线上指标恶化 → 触发回滚,迭代优化
核心价值:问题驱动迭代,数据闭环优化,实现持续提质降本增效。
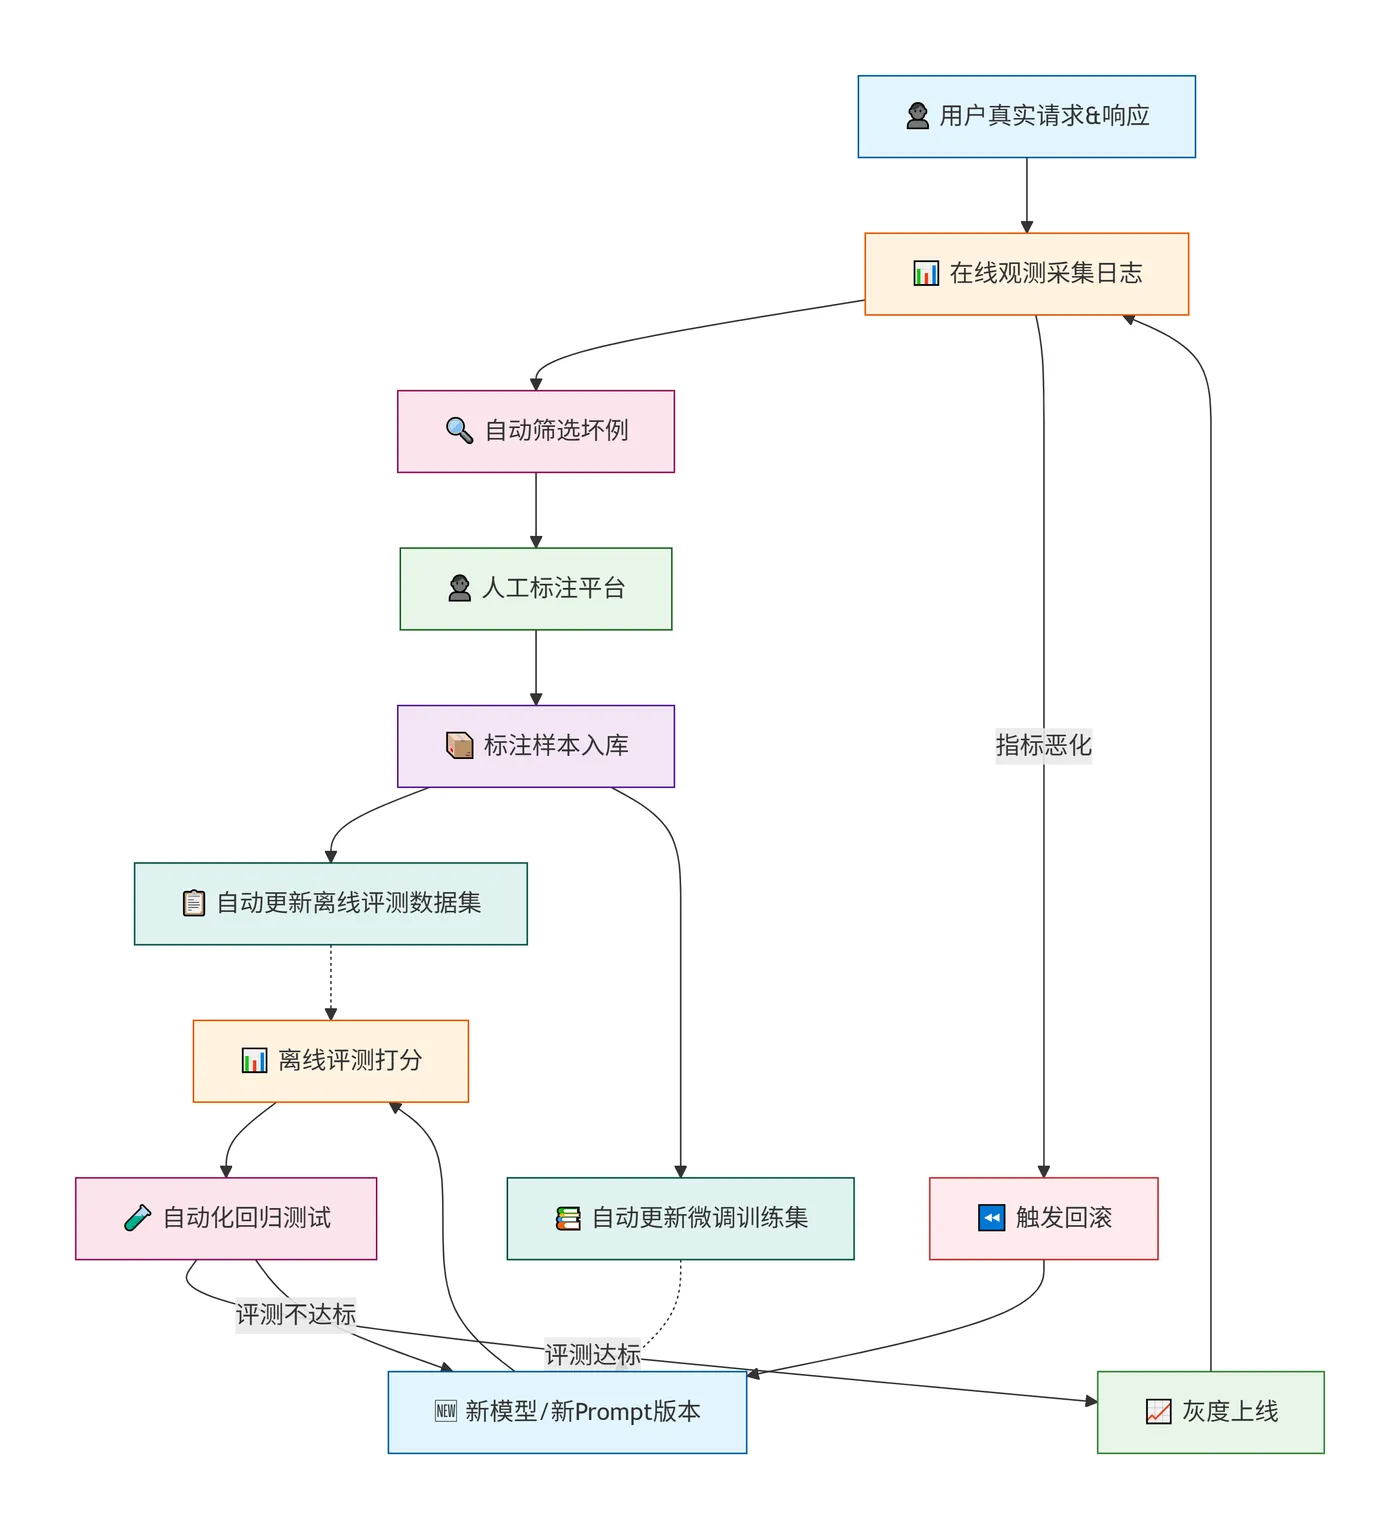
流程细节说明:
- 1. 线上采集 → 人工标注 → 数据集更新
- 用户请求与响应通过在线观测采集日志,自动筛选坏例后进入人工标注平台
- 标注样本入库后自动更新离线评测数据集和微调训练集,实现样本沉淀
- 2. 新版本 → 离线评测 → 灰度上线
- 新模型或新Prompt版本先进行离线评测打分,再通过自动化回归测试验证不退化
- 评测达标后灰度上线,持续在线观测
- 3. 异常回滚 → 迭代优化
- 线上指标恶化时自动触发回滚,回到迭代优化环节
- 形成完整闭环:发现问题 → 沉淀样本 → 迭代优化 → 验证上线 → 持续观测
4. 统一样本结构示例
该统一样本结构以 ModelSample 数据类为核心,统一承载用户输入、提示词、模型输出、标准答案、性能指标、场景版本元数据和人工评分等全链路信息,实现评测、线上日志与人工标注三端数据结构对齐,支撑模型持续迭代优化。
from dataclasses import dataclass from typing import Optional, Dict, List import time class ModelSample: """统一样本结构,打通评测、线上日志、人工标注""" sample_id: str query: str # 用户输入 prompt: str # 完整提示词 response: str # 模型输出 reference: Optional[str] # 标准答案(评测使用) metadata: Dict # 业务标签、场景、版本信息 latency: Optional[float] # 响应时延ms token_input: Optional[int] token_output: Optional[int] create_time: float = time.time() human_label: Optional[int] = None # 人工评分:1坏例,5优秀 class SampleStorage: def __init__(self): self.sample_list: List[ModelSample] = [] def add_sample(self, sample: ModelSample): self.sample_list.append(sample) def export_for_eval(self, path: str): """导出数据集用于离线评测""" import json output = [s.__dict__ for s in self.sample_list] with open(path, "w", encoding="utf-8") as f: json.dump(output, f, ensure_ascii=False, indent=2) # 使用示例 if __name__ == "__main__": storage = SampleStorage() print("=" * 55) print("统一样本结构演示:打通评测、日志、标注全流程") print("=" * 55) # 1. 构建一条完整样本 print("\n[1] 构建样本 => 包含输入、输出、标准答案、性能指标") sample = ModelSample( sample_id="s001", query="解释什么是大模型回归测试", prompt="你是技术专家,请简洁回答用户问题:{query}", response="大模型回归测试用于验证模型更新后原有能力不下降", reference="回归测试验证模型迭代后,历史场景效果不退化", metadata={"scene": "tech_qa", "model_version": "v1.2"}, latency=420.5, token_input=28, token_output=36 ) print(f" 样本ID : {sample.sample_id}") print(f" 场景 : {sample.metadata['scene']}") print(f" 模型版本: {sample.metadata['model_version']}") print(f" 耗时 : {sample.latency}ms") print(f" Token : 入={sample.token_input}, 出={sample.token_output}") print("-" * 40) # 2. 加入存储,模拟线上日志持续收集 print("\n[2] 入库 => 写入样本存储,累积评测数据集") storage.add_sample(sample) print(f" 当前样本数: {len(storage.sample_list)}") # 3. 再追加一条示例:模拟多场景多版本样本收集 sample2 = ModelSample( sample_id="s002", query="用三句话概括人工智能的发展历程", prompt="你是一个AI历史专家,请用三句话回答:{query}", response="AI从符号推理起步,经历神经网络复兴,如今进入大模型时代。", reference="人工智能经历了符号主义、连接主义到深度学习三个主要阶段。", metadata={"scene": "history_qa", "model_version": "v1.3"}, latency=315.2, token_input=22, token_output=30 ) storage.add_sample(sample2) print(f" 追加后样本数: {len(storage.sample_list)}") print("-" * 40) # 4. 模拟人工标注 print("\n[3] 人工标注 => 对样本评分(1坏例 ~ 5优秀)") sample.human_label = 4 sample2.human_label = 3 print(f" s001 人工评分: {sample.human_label}(良好)") print(f" s002 人工评分: {sample2.human_label}(一般)") print("-" * 40) # 5. 导出为离线评测数据集 print("\n[4] 导出 => 输出统一格式 JSON 评测数据集") storage.export_for_eval("eval_dataset.json") print(f" 已导出 2 条样本到 eval_dataset.json") print("-" * 40) # 6. 打印导出内容预览 import json print("\n[5] 导出文件预览:") with open("eval_dataset.json", "r", encoding="utf-8") as f: data = json.load(f) # 仅打印关键字段 for item in data: print(f" ┌─ {item['sample_id']} | 场景:{item['metadata']['scene']} | " f"版本:{item['metadata']['model_version']} | 评分:{item['human_label']}") print(f" ├─ Query : {item['query']}") print(f" ├─ 模型输出: {item['response']}") print(f" └─ 标准答案: {item['reference']}") print("\n" + "=" * 55) print("样本结构打通 评测日志标注 → 支撑持续迭代优化")

输出结果:
=======================================================
统一样本结构演示:打通评测、日志、标注全流程
=======================================================
[1] 构建样本 => 包含输入、输出、标准答案、性能指标
样本ID : s001
场景 : tech_qa
模型版本: v1.2
耗时 : 420.5ms
Token : 入=28, 出=36
----------------------------------------
[2] 入库 => 写入样本存储,累积评测数据集
当前样本数: 1
追加后样本数: 2
----------------------------------------
[3] 人工标注 => 对样本评分(1坏例 ~ 5优秀)
s001 人工评分: 4(良好)
s002 人工评分: 3(一般)
----------------------------------------
[4] 导出 => 输出统一格式 JSON 评测数据集
已导出 2 条样本到 eval_dataset.json
----------------------------------------
[5] 导出文件预览:
┌─ s001 | 场景:tech_qa | 版本:v1.2 | 评分:4
├─ Query : 解释什么是大模型回归测试
├─ 模型输出: 大模型回归测试用于验证模型更新后原有能力不下降
└─ 标准答案: 回归测试验证模型迭代后,历史场景效果不退化
┌─ s002 | 场景:history_qa | 版本:v1.3 | 评分:3
├─ Query : 用三句话概括人工智能的发展历程
├─ 模型输出: AI从符号推理起步,经历神经网络复兴,如今进入大模型时代。
└─ 标准答案: 人工智能经历了符号主义、连接主义到深度学习三个主要阶段。
=======================================================
样本结构打通 评测日志标注 → 支撑持续迭代优化
三、离线评测模块构建
1. 离线评测定位
离线评测是模型上线前的筛选器。在真实流量验证之前,利用标准化数据集批量测试候选模型、不同 Prompt 方案、不同推理参数(温度、TopP),量化对比效果、时延、Token开销。
离线评测解决核心问题:候选方案孰优孰劣?新版本相比旧版本基础能力是否提升?哪些场景模型持续薄弱?需要区分两类数据集:
- 通用评测集:常识、推理、写作等基础能力,用于基础能力摸底;
- 业务专属评测集:来自真实业务沉淀样本,优先级远高于通用集,直接反映业务效果。
2. 评测指标体系设计
指标分为三大类,自动量化打分:
效果指标:
- 准确率、匹配度、语义相似度;
- 幻觉检测得分、输出格式合规率;
- LLM-as-judge 大模型裁判打分。
性能指标:
- 平均推理时延、P95/P99 时延;
- 平均输入输出 Token 数量;
- 单样本推理算力开销。
稳定性指标:
- 相同输入多次输出一致性;
- 极端输入下异常输出占比。
3. 自动化评测执行流程
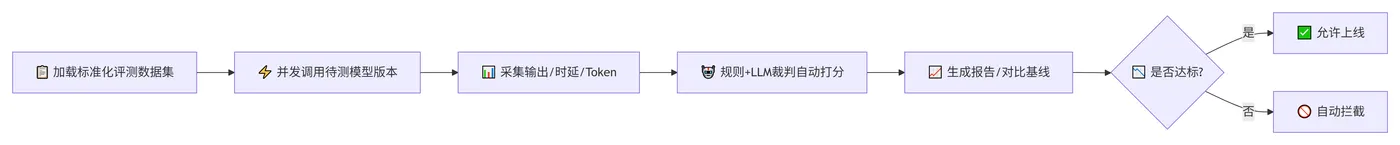
- 1. 加载标准化评测数据集;
- 2. 并发调用待测试模型版本;
- 3. 采集输出、时延、Token信息;
- 4. 使用规则 + LLM裁判自动打分;
- 5. 生成评测报告,对比基线版本;
- 6. 设置阈值,未达标自动拦截上线流程。
4. 离线评测应用实践
该示例实现了一套 LLM-as-Judge 自动化评测框架:用大模型充当评分裁判,对模型回答与标准答案进行 0~5 分质量打分,同时记录每条推理耗时,最终汇总平均得分与平均延迟,实现模型效果的批量离线评估与版本对比。
import time
from typing import List
import openai
# 配置模型客户端
client = openai.OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="dummy"
)
def llm_judge_score(query: str, pred: str, reference: str) -> float:
    """LLM-as-judge 自动打分,分数区间0~5"""
    judge_prompt = f"""
请对比模型回答和标准答案,评判回答质量,仅输出数字分数。
打分规则:
0:完全错误,严重幻觉
1:大部分错误
3:基本正确,但存在瑕疵
5:准确完整,贴合标准答案
用户问题:{query}
标准答案:{reference}
模型回答:{pred}
只输出0-5之间数字
"""
    resp = client.chat.completions.create(
        model="judge-model",
        messages=[{"role":"user","content":judge_prompt}],
        temperature=0
    )
    try:
        score = float(resp.choices[0].message.content.strip())
        return min(max(score,0),5)
    except:
        return 2.0
def run_offline_eval(dataset: List[ModelSample], model_version: str) -> dict:
    result_list = []
    for item in dataset:
        start = time.time()
        resp = client.chat.completions.create(
            model=model_version,
            messages=[{"role":"user","content":item.query}],
            temperature=0.1
        )
        latency = (time.time() - start)*1000
        pred = resp.choices[0].message.content
        score = llm_judge_score(item.query, pred, item.reference)
        result_list.append({
            "sample_id": item.sample_id,
            "score": score,
            "latency_ms": latency,
            "prediction": pred
        })
    # 汇总指标
    avg_score = sum(r["score"] for r in result_list)/len(result_list)
    avg_latency = sum(r["latency_ms"] for r in result_list)/len(result_list)
    return {
        "model_version": model_version,
        "sample_count": len(result_list),
        "avg_score": round(avg_score,2),
        "avg_latency_ms": round(avg_latency,2),
        "details": result_list
    }

5. 离线评测常见问题
- 评测数据集长期不更新,和线上真实用户问题脱节;
- 只看重效果得分,忽略时延与 Token 成本;
- LLM 裁判主观性太强,缺少人工抽样复核;
- 评测环境和线上推理环境配置不一致,指标无法对齐。
定期使用线上坏例扩充评测集;评测报告强制展示效果、成本、时延三类指标;每月抽样校验裁判打分准确性;离线环境复用线上推理参数。
四、自动化回归测试体系
1. 回归测试核心价值
离线评测偏向横向对比能力上限,回归测试侧重防止能力退化。 当团队修改Prompt、微调模型、切换推理框架、调整采样参数后,很容易出现:新场景效果变好,但历史高频业务场景效果下滑,这类问题称为 灾难性遗忘或能力退化。
回归测试本质:固定一套基准测试用例,每次变更后自动执行,对比基线指标,如果指标下跌超过阈值,阻断发布。
2. 回归用例分层设计
- 核心用例集(必测) 业务Top高频问题、高价值客户场景、合规敏感场景,数量控制在数百条,每次变更强制全量运行。
- 扩展用例集(抽样测) 中等频次场景,数量上千条,出于成本考虑采用随机抽样回归。
- 边界用例集 超长文本输入、模糊提问、对抗性输入、多轮复杂对话,专门验证鲁棒性。
3. 回归测试执行策略
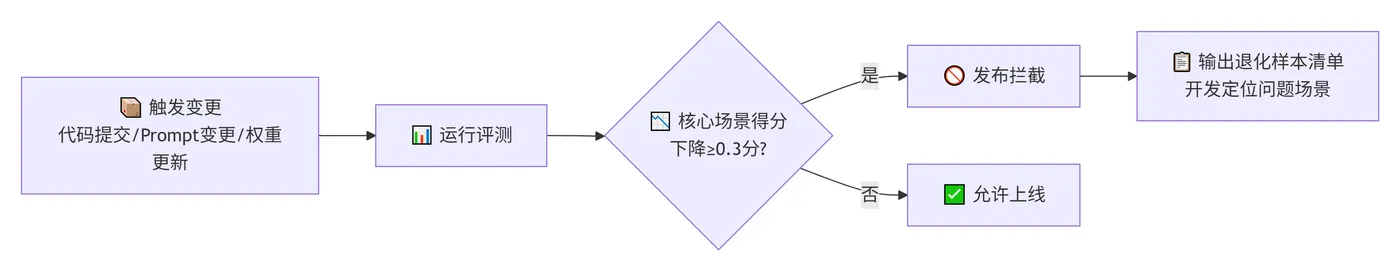
- 基线版本:当前线上稳定模型版本;
- 触发时机:代码提交、Prompt 版本变更、模型权重更新;
- 判定规则:核心场景平均得分下降超过阈值(例如 0.3 分),触发发布拦截;
- 输出产物:退化样本清单,开发人员可直接定位问题场景。
4. 回归校验实践示例
以下示例实现了一个模型版本回归校验函数:对比基线与新版本的平均得分,若分数下降超过阈值则阻断发布,否则允许灰度上线,保障模型迭代不出现能力退化。
def regression_check(baseline_report: dict, new_report: dict, threshold=0.3):
    """
    对比基线与新版本评测结果,判断是否出现退化
    return True 允许上线;False 存在能力退化
    """
    baseline_score = baseline_report["avg_score"]
    new_score = new_report["avg_score"]
    drop = baseline_score - new_score
    if drop > threshold:
        print(f"警告!效果下降{drop:.2f},超过阈值{threshold},阻断发布")
        return False
    print(f"指标下降{drop:.2f},通过回归校验,可以灰度上线")
    return True

回归测试不要盲目追求海量样本,样本质量远大于数量。我们曾出现收集上万条低质量样本,拉高评测成本却无法有效发现退化。优先沉淀线上持续出现的高频与坏例。同时回归流程接入 CI/CD 流水线,实现自动化卡点,杜绝人工跳过测试流程。
五、在线观测与实时监控
1. 离线评测天然局限
无论离线数据集多么完善,都无法完全模拟真实线上流量。 用户真实提问分布、多轮对话上下文、突发流量、超长输入、异常网络环境,都是离线很难完整复现的场景。很多模型缺陷,只有在真实流量下才会暴露。在线观测就是线上持续感知模型状态的眼睛。
2. 线上核心采集数据
每一次模型调用尽可能埋点记录:
- 请求信息:用户query、完整对话上下文、Prompt模板版本;
- 模型输出内容;
- 运行指标:推理时延P50/P95/P99、输入输出Token;
- 异常信息:超时、服务报错、输出截断;
- 用户反馈:点赞、点踩、人工投诉标记。
数据采集建议异步落盘,不要同步写入存储增加接口时延。
3. 指标大盘与告警规则
指标分为三大看板:
- 业务效果看板:点踩率、格式错误率、高频坏例趋势、各业务场景满意度。
- 性能看板:平均时延、P99 时延、QPS、队列堆积、超时请求占比。
- 成本看板:日均总 Token 量、单会话平均开销、不同模型版本资源消耗对比。
配置分级告警:
- 一级告警(紧急):超时率突增、服务错误率飙升,触发短信告警,考虑紧急回滚;
- 二级告警(关注):模型点踩率持续上涨、Token 成本持续上涨,安排人员排查。
4. 请求埋点代码示例
该示例实现了一套模型调用埋点日志系统:通过 RotatingFileHandler 配置轮转日志文件,在推理函数中自动记录请求内容、响应、耗时、模型版本及 Token 用量,便于线上调用链路追踪与成本核算。
import logging
from logging.handlers import RotatingFileHandler
import json
# 初始化异步日志
model_logger = logging.getLogger("model_runtime")
model_logger.setLevel(logging.INFO)
handler = RotatingFileHandler("model_request.log", maxBytes=1024*1024*10, backupCount=10, encoding="utf-8")
model_logger.addHandler(handler)
def log_model_request(req_info: dict):
    """模型调用埋点日志"""
    model_logger.info(json.dumps(req_info, ensure_ascii=False))
# 接口调用处使用
def model_infer(query: str):
    start = time.time()
    resp = client.chat.completions.create(model="online-v1.2", messages=[{"role":"user", "content":query}])
    latency = (time.time()-start)*1000
    log_model_request({
        "query": query,
        "response": resp.choices[0].message.content,
        "latency_ms": latency,
        "model_version": "online-v1.2",
        "input_tokens": resp.usage.prompt_tokens,
        "output_tokens": resp.usage.completion_tokens
    })
    return resp

日志数据做好采样策略。高并发场景下,全量存储所有请求存储成本极高,可以设置:正常流量按比例采样,标记为坏例、超时、用户负反馈的请求全量保存,兼顾成本与问题排查能力。
六、人工反馈闭环建设
1. 反馈闭环核心意义
离线数据、线上日志只能发现现象,无法精准判定 “模型输出到底好不好”。用户简单的点踩,缺少原因标注。想要持续迭代模型,必须建立从线上坏例 → 人工标注 → 样本入库 → 模型优化的完整闭环。通过实践发现,出现项目迭代停滞的核心原因:坏例散落在日志里,没有人系统性整理标注,优化缺少高质量训练样本。
2. 坏例自动筛选机制
依靠规则 + 简单模型,自动从海量日志筛选待人工审核样本,减少人工工作量:
- 1. 用户主动点踩、投诉样本;
- 2. 输出格式持续不符合约定JSON结构;
- 3. LLM预检测存在幻觉、逻辑冲突的回答;
- 4. 业务高频场景下响应时延异常偏高;
- 5. 多次输出不一致的对话样本。
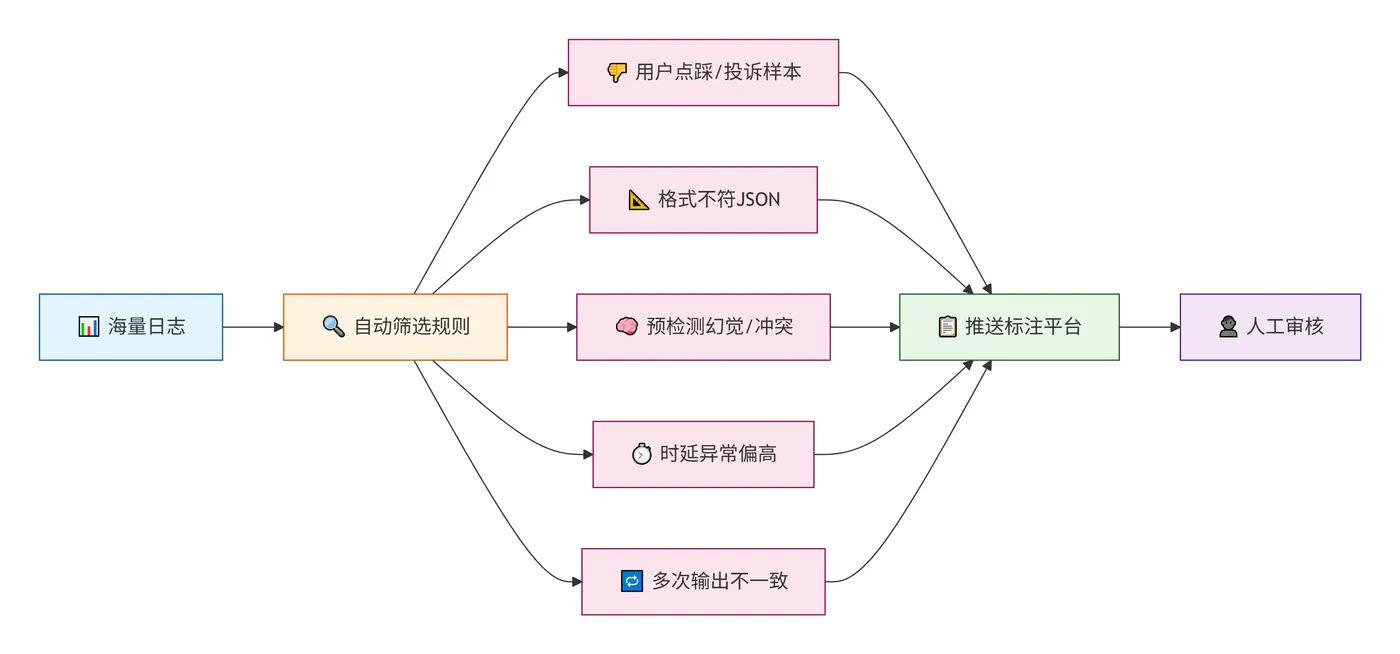
筛选后的样本推送标注平台,标注人员不需要浏览全部日志。
3. 标注规范设计
简化标注任务,降低标注成本,设置基础标签:
- 质量标签:优秀 / 合格 / 较差 / 严重幻觉;
- 问题分类:幻觉、逻辑错误、答非所问、格式错误、内容冗长;
- 可选产出:参考标准答案。
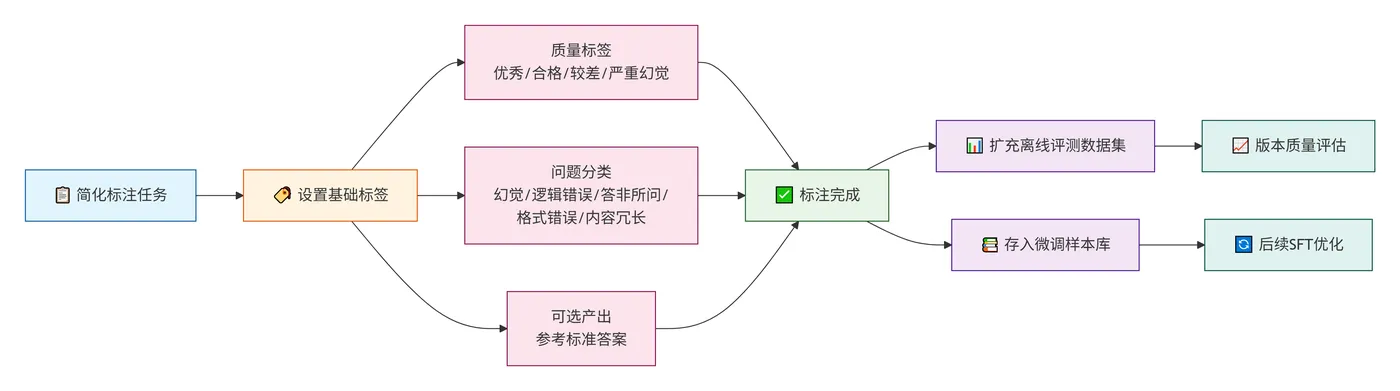
标注完成后样本自动流向两处: ① 扩充离线评测数据集; ② 存入微调样本库,用于后续SFT优化。
4. 闭环流转流程
通过“线上采集坏例→人工标注→分流至评测集与微调集→模型训练→评测验证",形成持续优化的闭环迭代流程。

流程说明:
- 数据采集 → 标注 → 样本入库
- 线上流量日志:采集线上真实请求与响应数据
- 自动筛选坏例:基于规则+简单模型从海量日志中筛选待标注样本
- 人工标注平台:标注人员完成标注打标签
- 结构化入库:标注完成的样本结构化存储
- 数据分发 → 双路输出
- 定时同步至离线评测集:扩充评测数据集,用于版本质量验证
- 筛选高质量样本用于微调:精选正负样本进入微调训练库
- 新版本验证闭环
- 新模型训练完成后,进入离线评测 + 回归测试通道
- 评测通过后方可进入上线流程
5. 反馈管道实践示例
该示例实现了一个模型反馈闭环管道:自动筛选用户负反馈、输出过短等异常case,将疑似 bad case 送入人工标注,标注完成后导出为评测集,形成"线上反馈→人工修正→评测集沉淀"的持续优化闭环。
class FeedbackPipeline:
    def __init__(self):
        self.candidate_bad_cases = []
        self.labeled_samples = []
    def auto_filter_bad_case(self, log_item: dict) -> bool:
        """自动判断是否送入人工标注"""
        # 用户负反馈
        if log_item.get("user_dislike"):
            return True
        # 输出长度异常
        if len(log_item.get("response","")) < 10:
            return True
        return False
    def add_labeled_sample(self, sample: ModelSample):
        self.labeled_samples.append(sample)
        self.export_to_eval_set()
    def export_to_eval_set(self):
        storage = SampleStorage()
        for s in self.labeled_samples:
            storage.add_sample(s)
        storage.export_for_eval("business_eval_set.json")

七、全链路协同流程
1. 完整迭代标准流程
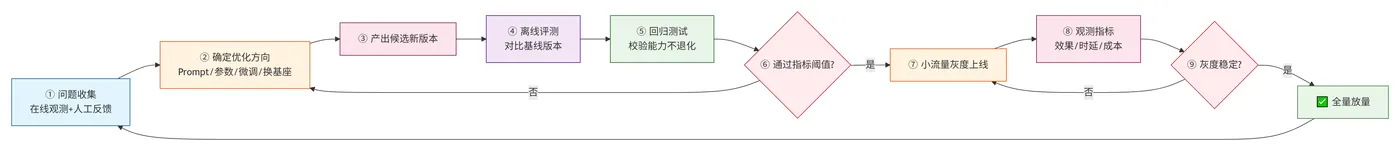
- 1. 通过在线观测、人工反馈收集模型现存问题;
- 2. 梳理问题,确定优化方向:Prompt优化、参数调整、微调、切换基座;
- 3. 产出候选新版本;
- 4. 执行离线评测,横向对比基线版本;
- 5. 运行自动化回归测试,校验无能力退化;
- 6. 通过指标阈值后,小流量灰度上线;
- 7. 灰度阶段持续观测线上指标:效果、时延、成本;
- 8. 灰度指标稳定,逐步全量放量;
- 9. 全量运行持续收集坏例,开启下一轮优化循环。
2. 多目标平衡策略
优化工作经常面临冲突:
- 想要输出更详细,Token开销上升、响应变慢;
- 降低模型温度减少随机性,同时创造力下降;
- 使用更大尺寸模型效果提升,但推理成本暴涨。
评估体系不能只看单一指标,需要建立综合评分机制。可以根据业务权重配置加权分数,例如业务效果权重0.6,时延权重0.2,成本权重0.2,辅助团队做取舍决策。
八、总结
其实大模型落地难点不一定是模型能力不足,但我们根据真实生产经验总结:模型能力只是基础,持续稳定迭代的体系才是长期竞争力。只专注训练、调Prompt,缺少评估验证手段,优化如同盲人摸象。离线评测帮助我们在上线前筛选方案;回归测试守住底线,避免优化带来副作用;在线观测打通真实流量,看见离线无法复现的问题;人工反馈闭环持续供给高质量样本,让模型越用越强。
整个链路组件也是个循序渐进的过程,初期可以先实现基础日志采集 + 简易离线脚本评测,再逐步接入自动化回归、搭建标注流程。循序渐进完善工具链,持续对齐可靠性、响应速度、算力成本与业务指标,大模型业务才能长久稳定运行。