JeecgBoot AI专题研究 | TypeSafe AI System One Model深度解析:Choice/Noul/Score与Agent判断层实战
这两天如果你刷技术圈的社交媒体,大概率会撞见"Jev"这个名字。有人说被它"霸榜"了,有人晒出用它改造 Codex、BrowserUse 之后速度暴涨的截图,GitHub 上一个相关开源项目几天内就破万星。
但如果你顺着这个热度去找"Jev 排行榜",会发现根本找不到——它压根不在 Chatbot Arena、SWE-bench 这类主流榜单里。这就是很多人第一次接触 Jev 时的困惑:它到底是什么?为什么这么火,却又"查无此榜"?
真正的"榜"其实是这张图。TypeSafe 官方拿 Jev 和一票主流大模型做了结构化输出错误率、工具调用错误率的横向对比,Jev 两项都是 0%,而对照组里的 Opus 5、Fable 5.1、Sonnet 5、Haiku 4.5、Gemini 3.x、Astra、Sol 这些型号,错误率从零点几个百分点到 45.5% 不等:
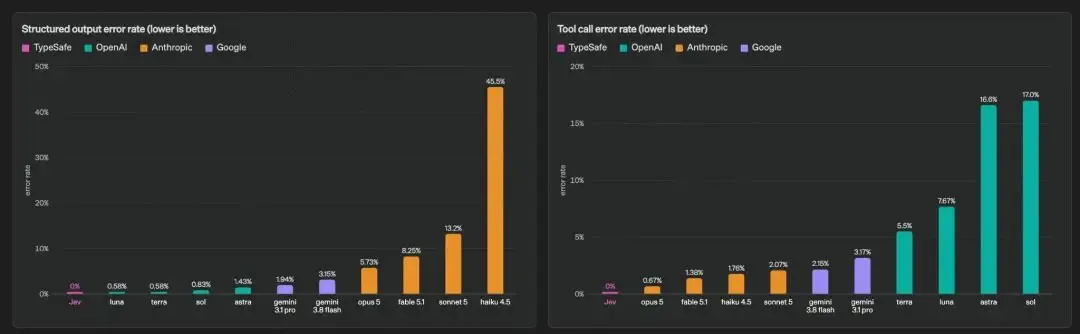
这才是"霸榜"这个说法的真正出处——它霸的不是对话质量榜,而是"给定封闭选项时会不会答错"这类判断题的准确率榜。理解了这一点,再看 Jev 到底是什么,就顺理成章了。
答案其实很简单:Jev 从一开始就没打算和 GPT、Claude、Kimi 这些生成式大模型抢同一个赛道。它是 TypeSafe AI 这家创业公司在 2026 年 9 月推出的第一款"System One Model",官方给它的定位是——不写一个字,专门做判断。
先搞清楚一件事:Jev 解决的是哪类问题
理解一个新东西,最好先搞清楚它想解决什么问题,而不是先看参数表。
过去两年,大模型的进化路线基本只有一条:让模型能推理、能调用工具、能连续完成长程任务。哪怕是最新的 Reasoning Model,核心机制也没变——基于上下文一个 Token 接一个 Token 地往后生成,只是生成的"草稿纸"变多了。
但软件系统里还藏着大量另一类任务:不需要复杂推理,只需要一个快速、明确的判断。一封客诉邮件,是不是退款请求?该转给哪个部门?一段客服对话,用户情绪有多激动?这些问题人类几乎是"看一眼就知道",但写成代码就很难办——正常的 if...else 处理不了自然语言的语义,硬要判断就得请一个通用大模型帮忙生成一段话,再从里面解析结果。
这套流程能跑通,但代价不小:又慢又贵。原因也很直接——大模型无论要回答的问题多简单,都得老老实实把答案"写"出来,一个 Token 一个 Token 生成,哪怕最终你只想要个 "是/否"。
TypeSafe 盯上的正是这个缝隙:软件里有没有可能存在一种模型,专门负责"语义判断"这一件事,快到可以被当成一个 if 语句来用?
从"系统一/系统二"理解 Jev 的定位
TypeSafe 把这套思路的理论依据,直接搬到了诺贝尔经济学奖得主丹尼尔·卡尼曼那本《思考,快与慢》里。书中把人类思维粗分为两套系统:System 1 是近乎本能的快速判断,比如一眼看出对方脸色不对;System 2 则是需要停下来仔细权衡的慢思考,比如做一道复杂应用题。
放在过去两年的大模型行业里看,几乎所有的注意力都押在了 System 2 这一侧——各家都在拼推理链更长、工具调用更准、Agent 任务完成率更高。TypeSafe 反过来问了一个问题:软件里所有需要 AI 参与的任务,真的都值得让模型停下来认真推理吗?
显然不是。判断一句客诉是不是退款请求,不需要模型写几千个 Token 的思考过程,人类几乎是瞬间反应。TypeSafe 索性把这块被行业忽略的 System 1 单独拎出来做成了一个模型——这也是 Jev 官方自称 System One Model 的由来。
顺带一提,"Jev"这个名字来自经济学家 William Stanley Jevons,他提出过著名的"杰文斯悖论"(Jevons Paradox):一项资源变得更高效、更便宜之后,人类对它的总消耗量未必减少,反而可能因为门槛降低而暴涨。TypeSafe 的赌注是:如果一次语义判断便宜到可以忽略不计、速度只要几十到几百毫秒,那么软件里原本一个普通的 if 判断,很可能会被大量替换成一次 AI 判断——需求不会减少,只会被重新释放出来。
和普通 LLM 的本质区别:不是"更小",而是"不生成"
很多人第一反应会把 Jev 理解成"又一个更便宜、更快的小模型",这个理解并不准确。
今天常见的小模型,哪怕再快再便宜,底层逻辑仍然是 LLM 式的自回归生成——接到输入后依然要一个 Token 接一个 Token 往后写,哪怕最终只是要判断一封邮件属于投诉还是退款,也得先把答案"写"出来。即便开启了 JSON mode 或 structured output,本质也只是"先自由生成,再用格式约束兜底"。
Jev 走的是完全不同的路子:它放弃了自由文本生成。开发者需要在请求里预先定义好问题和所有可能的输出类型,模型只能在这个封闭集合内做决定,不会输出集合之外的任何东西——这也是官方所谓"零幻觉"的准确含义。这里有个容易踩的理解误区必须说清楚:类型安全不等于事实正确。Jev 保证的是不会返回类型定义之外的乱七八糟的东西,但它依然可能在合法选项里选错——概率和置信度,就是特意留给下游程序做风险判断的信号,而不是"绝对正确"的保证。
三个判断原语:Choice / Noul / Score
Jev 对外暴露的接口被收敛成三种原语,分别对应三类最常见的判断场景:
| 原语 | 作用 | 输出形式 | 典型场景 |
|---|---|---|---|
| Choice | 从给定候选项中选一个 | 选中项 + 完整概率分布 + 置信度 | 工单路由到账单/技术/销售团队 |
| Noul | 判断一个命题是否成立 | 0~1 之间的"是"概率 | 判断"这封邮件是否需要立即处理" |
| Score | 按自定义有序量表打分 | 量表上的具体档位 | 从"平静"到"非常愤怒"评估客户情绪 |
三个原语都可以共享同一份上下文状态(state),一次并行完成多个判断——比如同一条客服消息,可以在一次请求里同时完成"该转哪个部门"(Choice)、"是否紧急"(Noul)、"情绪评分"(Score)三件事。这种并行能力,对路由分发、内容分类、垃圾过滤、质量检查、RAG 片段筛选这类高频重复的场景特别有吸引力。
真实性能和价格:便宜到可以当 if 用
TypeSafe 公布的数据支撑了"把判断当 if 语句用"这个说法的底气。按 2026 年 9 月 19 日的官方文档,jev-latest 指向 Jev 1.13:
- 响应延迟约 100 毫秒
- 输入价格每百万 Token 0.042 美元,输出不计费
- 上下文上限 64k Token
- 官方直连限额:每秒 25 万 Token、每分钟 1200 次请求
官方给出的成本估算很直观:一个约 300 Token 的客服工单,跑 10 万次判断,总成本大约只要 1.26 美元。对一个每天要处理几百万条客服消息、每条都要判断类型/紧急度/归属部门的电商平台来说,这个价格意味着"每一条消息判断五六次"这种以前想都不敢想的用法,突然变得可以随便用了。
需要提醒的是:这些数字更新很快,真正上生产之前务必回官方文档核实,经过阈值标定的工作流最好锁定具体模型版本号,避免模型静默升级导致判断行为漂移。
实战案例一:给 Codex 装上"判断层",减少推理反复横跳
Jev 真正出圈,很大程度上是因为它被用来加速 Codex 这类 Agent 编程/computer use 工具。
思路是这样的:Codex 在执行 computer use 任务时,经常要在一堆候选动作里做封闭式判断——该点哪个按钮、走哪个分支、调用哪个工具。这类判断本质上和"客服工单该转哪个部门"是一回事,完全可以从主模型手里剥离出来,交给 Jev 做"操作判断层":先把页面状态转成文本或结构化数据,再用 Choice 在候选动作里选一个,主模型只负责规划、生成和最终校验。
好处是显而易见的:减少了大模型反复推理封闭判断带来的延迟和 Token 消耗。
上手流程也不复杂,官方给出了四步:
# 第一步:加入 waitlist 申请 early access(社区反馈最快当天到一两天收到邀请,非官方 SLA)

# 第二步:给 Codex 项目安装官方 Skill
npx skills add typesafe-ai/skills --skill typesafe-ai
# 按提示选择 Codex;默认项目级安装,全局安装加 -g

# 第三步:在 TypeSafe Console 创建 API Key,写入环境变量
export TYPESAFE_API_KEY=your_key_here
# 第四步:新开一个 Codex 会话,直接描述需求
use the TypeSafe skill. Build a minimal Python demo that routes a
customer-support ticket with Choice, checks urgency with Noul, and
scores frustration with Score. Read TYPESAFE_API_KEY from the
environment, print all answers and confidence values, and add a
fallback for low-confidence results.
这里有两个容易被忽视的细节,实际接入前建议留意:
第一,Skill 只是给 Codex 补充了 Jev 的 API 说明和设计方法,不会把 Codex 的主模型替换成 Jev,两者是协作关系而非替代关系。
第二,安全上要按常规密钥管理来,不要把 TYPESAFE_API_KEY 直接粘贴进 prompt、代码或 Git 历史;同时因为输入内容会发送给 TypeSafe 的 API,接入前最好过一遍对方的隐私条款和 DPA,尤其是涉及客户敏感信息的判断场景。
实战案例二:BrowserUse + Jev,把浏览器自动化干到"秒开"
如果说 Codex 的例子还偏工程侧,那么开源项目 UltraFast(结合 Browser Use 与 Jev)给出的是更直观的速度对比。
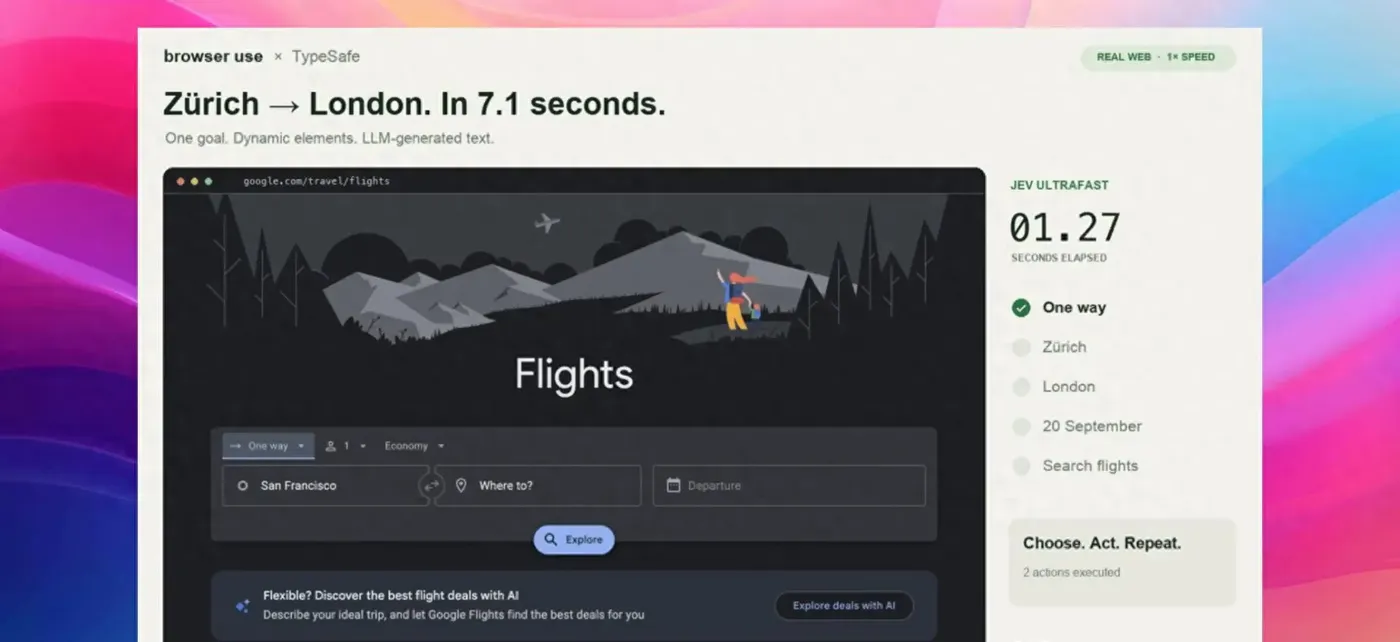
这个项目的思路和 Codex 场景一脉相承:把页面上所有可交互的按钮、输入框列成一份带编号的清单,交给 Jev 用一次 Choice 请求同时回答"该点哪个""下一步该做什么",决策和动手之间几乎没有等待——不再需要像传统浏览器自动化那样反复截图、反复调用大模型逐步推理。
社区反馈的几个数字很直观:浏览器调用次数从原来的 1000 多次直接砍到 100 出头;查一次苏黎世到伦敦的航班 7 秒钟出结果;打开一个百科词条不到 3 秒;酒店搜索筛选不到 2 秒。项目演示页面给出的实测时间是 7.1 秒完成"苏黎世飞伦敦"这个目标,中间涉及动态页面元素和大模型生成文本两个变量:
配置也很轻量:clone 仓库、跑 uv sync、填上 Jev 和一个主力 LLM 的 Key(DeepSeek、Kimi、千问、GLM 都兼容),整个项目只有 6 个文件,用的是本机 Chrome 内核。这也印证了 Jev 的定位——它不是要取代主力生成模型,而是给任何一个主力模型配一个"闪电判断层"。项目上线仅几天,GitHub 星标就破万:
冷静看待热度:这些局限和夸张说法要留意
一个新工具火起来的时候,最容易出现的问题就是把边界案例的战绩当成普遍规律。Jev 官方自己都提醒了几件事,值得原样搬出来:
- 它不生成文本,目前只接受文本或文本化的 JSON 输入,不适合需要写作、解释或开放推理的任务;
- 不擅长精确数学、计数、日期比较和多跳推理——这些恰恰是很多业务判断里容易被忽略的隐藏需求;
- 中文等 CJK 语言的准确率可能低于英语,上线前必须用自己的业务数据做评测,不能直接套用英文场景的结论;
- 官方宣称在自家 System One 工作流里最高约 193.6 倍更快、444.6 倍更便宜,但这组数字位于实际收益的高端区间,而且参考答案来自外部模型的平均预测,并非人工标注的真实基准——拿来当作普遍性承诺并不合适;
- 社交媒体上流传的"提速 10 倍"截图,大多来自单一样本的直观感受,没有对照组、没有样本量、也没有可复现代码,更适合当作"值得一试"的信号,而不是可以直接写进技术选型文档的结论。
这些提醒背后其实是一个更朴素的工程常识:任何"降本增效"的数字,离开具体工作流和评测方法论,都只是营销素材。
到底该不该用 Jev?一个实用判断标准
结合三篇信息源和 Jev 自身的设计定位,这里给一个相对可操作的判断方法:
如果一个任务满足"结果可以预先枚举、能用标注数据验证效果、并且在工作流里高频重复"这三个条件,Jev 值得拿自己的数据集测一测——工单路由、内容分类、风险预筛选、RAG 片段初筛、Agent 的下一步动作选择,都是典型场景。
反过来,如果任务需要写作、解释或者开放式推理,该交给生成式模型的还是交给生成式模型,硬塞给 Jev 只会撞上它"不擅长"的那几条边界。
更实际的落地建议是分层处理低、中、高置信度的判断结果:高置信度可以直接自动执行;中间区间补充信息或做二次确认;低置信度转人工或转交更强的 Reasoning Model 兜底。置信度阈值不应该拍脑袋定,必须用真实业务数据标定,且要跟着模型版本一起锁定,避免模型悄悄升级后阈值失效。
从更大的视角看,Jev 真正让人眼前一亮的地方,不是某个具体的倍数,而是它提出的分工思路:让主模型专心做规划和生成,把封闭、可评估的快速判断单独切出来做成一个轻量模型。如果这个思路被证明可行,软件里那些散落的语义判断——原本要么绕过 AI 硬写规则、要么砸一个昂贵的大模型请求解决——很可能真的会像杰文斯悖论预言的那样,被大量地、廉价地塞进每一个曾经的 if...else 里。
总结
Jev 这两天的"刷屏",本质上刷的不是传统意义上的模型能力排行榜,而是一种新的产品思路:把"语义判断"从生成式大模型里剥离出来,做成一个不写字、只给类型化概率决策的轻量模型,专门服务于软件工作流里那些高频、封闭、可验证的判断节点。它和 Codex、BrowserUse 这类 Agent 工具的组合已经证明了实际价值,但官方和社区披露的加速倍数、成本数据,都需要放回具体场景和自己的评测集里重新验证,而不是照单全收。判断要不要现在就上手,最好的办法不是看别人的截图,而是拿自己工作流里的延迟、Token 占用和真实数据集跑一遍。
本文为 JeecgBoot AI 专题研究系列文章。