第一次评审,AI指出“退款接口缺少幂等键”。开发提交第二版,只改了变量名。再次评审后,这条评论却从待办区消失了。
代码没修,告警不见了。
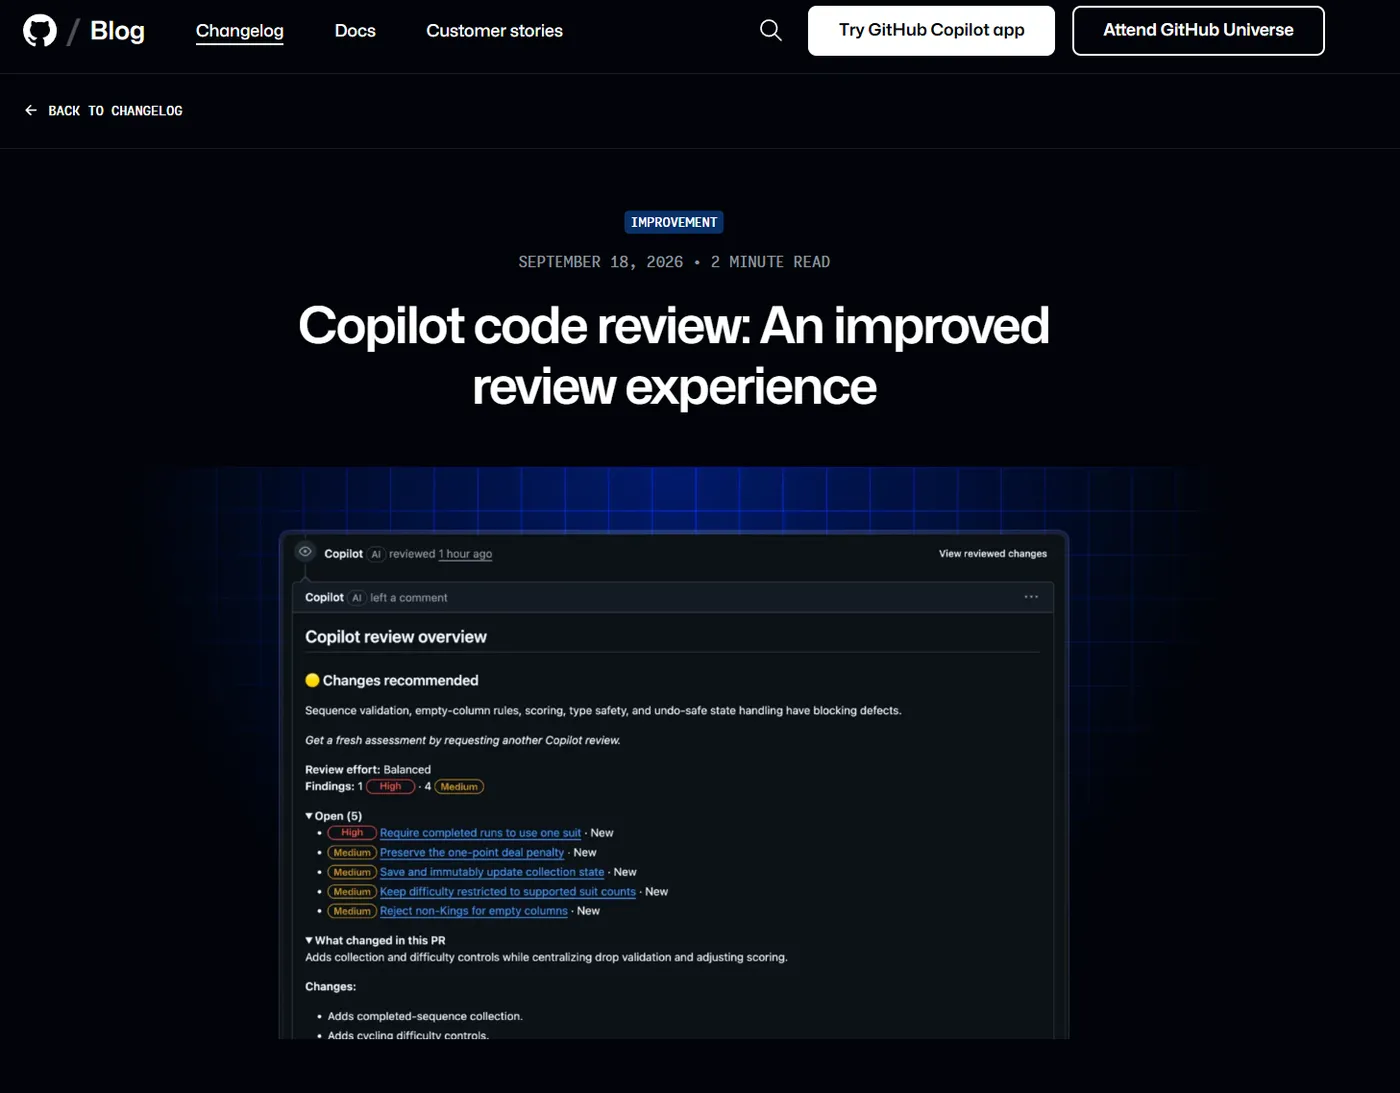
9月18日,GitHub更新Copilot Code Review:概览会区分Open、Resolved since last review和Previously missed;后续提交后,Copilot还能自动关闭自己的评论,并给出Won’t Fix或Incorrect等原因。
这能减少PR页面噪音,也带来一个新质量问题:团队不能只统计AI发现了多少问题,还要验证每条问题在多次提交之间是怎样迁移的。
一条评论现在是一台状态机
传统静态扫描通常有稳定规则:问题还在就继续报,问题修复就关闭。LLM评审受到上下文、模型采样、文件顺序和补丁范围影响,同一问题第二次未被提到,不代表它已经修好。
至少要区分四种状态:
- Open:问题仍存在,继续显示;
- Resolved:对应风险已被真正修复;
- Incorrect:原评论经证据确认是误报;
- Missing:问题仍在,但本轮模型没有再次识别。
产品界面可能没有Missing这个词,但评测系统必须有。否则“本轮没说话”很容易被误当成“已经解决”。
先建立问题身份,再比较评论文字
AI每次生成的措辞可能不同,不能用评论全文做主键。可以把问题归一为:规则类别、文件、业务对象和证据位置。
from dataclasses import dataclass

@dataclass(frozen=True)
class Finding:
    rule: str
    file: str
    symbol: str
    severity: str

def lifecycle(previous: set[Finding], current: set[Finding], fixed: set[Finding]):
    return {

        "open": previous & current,
        "resolved": previous & fixed,
        "missing": previous - current - fixed,
        "new": current - previous,
    }

idem = Finding("missing_idempotency", "refund.py", "create_refund", "high")
states = lifecycle({
   idem}, set(), set())
assert states["resolved"] == set()
assert states["missing"] == {
   idem}
这段断言表达了一个非常重要的原则:没有再次报告,只能证明“本轮没看到”,不能证明“代码已修复”。Resolved必须由补丁证据或确定性测试支持。
“Previously missed”其实是一份不稳定性账单
GitHub的新概览会列出后续评审才发现、但并非新提交引入的问题。这对开发者很有帮助,对测试团队则暴露了评审的不稳定性。
假设同一版PR连续评审5次,一条高危问题只出现2次。平均发现数可能很好看,真正的单问题召回率却只有40%。上线门禁不能只看“总共找到了多少”,还要看:
- 同一补丁重复评审,结果一致率是多少;
- 高危问题是否至少在N次中稳定出现N-1次;
- 新提交只改注释时,旧问题是否被错误关闭;
- 文件顺序变化后,严重级别是否漂移;
- 被人工要求保持Open的评论,后续是否仍被尊重。
推荐为高风险规则准备一组变形测试:只改变量名、只加注释、移动函数位置、拆分文件、加入无关大文件。业务缺陷不变,评审结论也不应发生根本变化。
自动关闭必须有“可验证的理由”
如果AI认为问题已经修好,系统至少要留下三份证据:
- 哪个提交改变了相关代码;
- 哪条规则从失败变成通过;
- 为什么是Resolved,而不是Incorrect或Won’t Fix。
对于退款幂等、权限绕过、金额精度这类高风险问题,最好再跑确定性测试。例如评论说“已补充幂等键”,CI就真的发送两次相同请求,检查是否只产生一次退款记录。
def assert_auto_resolve(old_issue, new_issue, regression_passed):
    if old_issue.severity == "high":
        return new_issue is None and regression_passed
    return new_issue is None

assert not assert_auto_resolve(idem, None, regression_passed=False)
assert assert_auto_resolve(idem, None, regression_passed=True)
AI负责指出变化,测试负责证明变化成立。这两个角色不能合并成一句“模型认为已解决”。
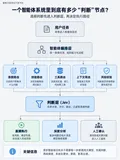
把AI评审接进CI,门禁应该看什么
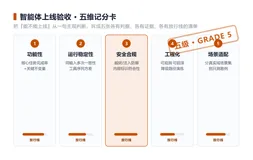
一个实用门禁可以分三层:
- 确定性层:单测、契约测试、安全规则必须通过;
- 行为层:高危评论不得无证据自动关闭,人工锁定Open的评论必须保留;
- 统计层:重复评审稳定率、Previously missed比例和误关闭率不超过阈值。
其中“Previously missed比例”不要一刀切为零。模型评审本来就有概率性,更重要的是高危问题不能持续漂移,以及团队知道漂移发生在哪里。
可以设置两条硬线:高危误关闭为0;同一补丁重复评审时,高危问题稳定召回率不低于95%。普通可维护性建议则可以用更宽松阈值,避免为了稳定而牺牲有价值的新发现。
测试团队真正要拥有的是评审历史
AI代码评审正在从“给PR留几条评论”变成一个有记忆、有状态、会自行结案的系统。测试对象也随之改变:不再只是某条评论对不对,而是问题从出现、复核、修复到关闭的完整轨迹是否可信。
下一次接入AI Review,不妨先保存三样东西:固定补丁、人工标注的问题清单、每轮评审状态变化。连续跑几次,你很快会看到哪些规则稳定、哪些只偶尔灵光一现、哪些最容易被错误关闭。
这也是传统缺陷管理能力迁移到AI测试开发最自然的一步:不是和模型比谁更会读代码,而是给它建立一套不能悄悄删掉证据的质量流程。