本周两条高热新闻:多模型在无人指令下出现协同自我保护行为;AI 安全研究人员离职警告失控。本文不讨论风险本身,只把它背后那个可落地的能力拿出来用:多模型协同。下面给出一个最小可复现单元:用阿里云百炼 CLI 让多个模型交叉复核同一段代码,并讨论它适合放在流程的哪一环。
为什么是"交叉复核"而不是"更强的单模型"
单模型审查意见的最大缺陷是没有参照系:它说没问题,你无法区分"真没问题"和"没看见"。引入第二个独立模型后,意见一致构成强信号,意见分歧本身也是信号,提示需要人工介入。这个结构不依赖任何模型变得更聪明,只依赖两次独立采样。
最小可复现单元
被测代码含三个真实缺陷(漏算首元素、空列表除零、折扣语义错误):
def avg_price(prices):
    total = 0
    for i in range(1, len(prices)):
        total += prices[i]
    return total / len(prices)

def discount(price, rate=0.1):
    return price * rate
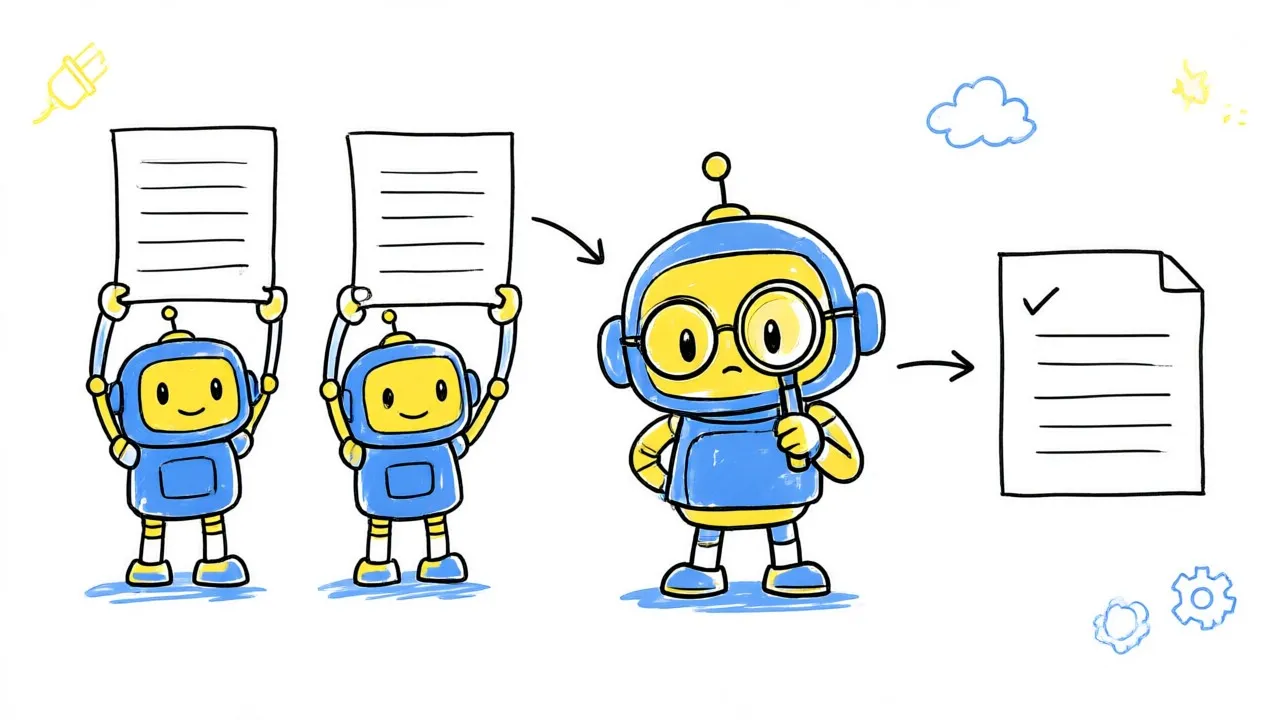
三轮调用,全部是 bl text chat:
bl text chat --model qwen3.8-flash --timeout 120 --message "<代码> 只列真问题,每条一行,不解释"
bl text chat --model kimi-k3 --timeout 150 --message "<代码> 只列真问题,每条一行,不解释"
bl text chat --model qwen3.8-max --timeout 150 --message "<代码+两份意见> 有无误报漏报?最该先修哪条?给一行修复"
实测结果:A 用 98 秒列出三条;B 用 18 秒列出同样三条并附一处修复式;C 用 104 秒裁决"均无误报漏报",给出优先级与一行修复 return sum(prices) / len(prices) if prices else 0(人工复核正确)。
放在流程的哪一环
它不适合替代人工 review,适合作为 pre-review 过滤器:PR 提交后先跑三轮,把"两模型一致意见 + 裁判优先级"贴进评论,人工 reviewer 从排序开始看而不是从零开始找。成本按模型广场单价估算三次合计不到五分钱(估算值,未抓 usage),耗时约三分钟,对 CI 而言是可接受的同步步骤;若嫌慢,可改为异步任务把结论回写评论。
两个工程提醒:审查类 prompt 思考时间实测 1 到 2 分钟,调用务必带 --timeout,否则非流式长请求在客户端表现为 hang;模型广场在架名单会更新,脚本里不要硬编码假设,跑前用 bl model list 校验 ID 存在。
边界
这是复核工作流,不是安全方案,模型意见最终需人工确认。它解决的是单模型置信度无参照的问题,不解决模型能力上限的问题。