
AI视频生成技术已经完成一轮重要迭代,行业已经告别只能产出数秒碎片化镜头的阶段,逐步进化到可以输出完整叙事片段的生产力时代。Wan3.0‑Video作为新一代一体化全能视频生成模型,依托百炼平台对外提供云端推理服务。该模型最标志性的突破就是原生支持单次生成最长30秒高清视频,并且实现办公文档直接输入生成视频的差异化能力,能够解析PDF、PPT、DOC、XLS、MD等多种格式文件,真正做到“万物皆可生视频”。
这套一体化模型统一兼容文生视频、图生视频、首尾帧控制生成视频、多素材参考生成、视频局部编辑、视频时长延展等多种创作模式。针对行业长期存在的人物形象崩坏、画面穿帮、音画错位等痛点做了大量专项优化,强化人物角色一致性、画面真实质感、音画同步表现,能够覆盖短视频内容创作、广告物料制作、教育课件输出、影视分镜预演、电商商品演示等多元化业务场景。
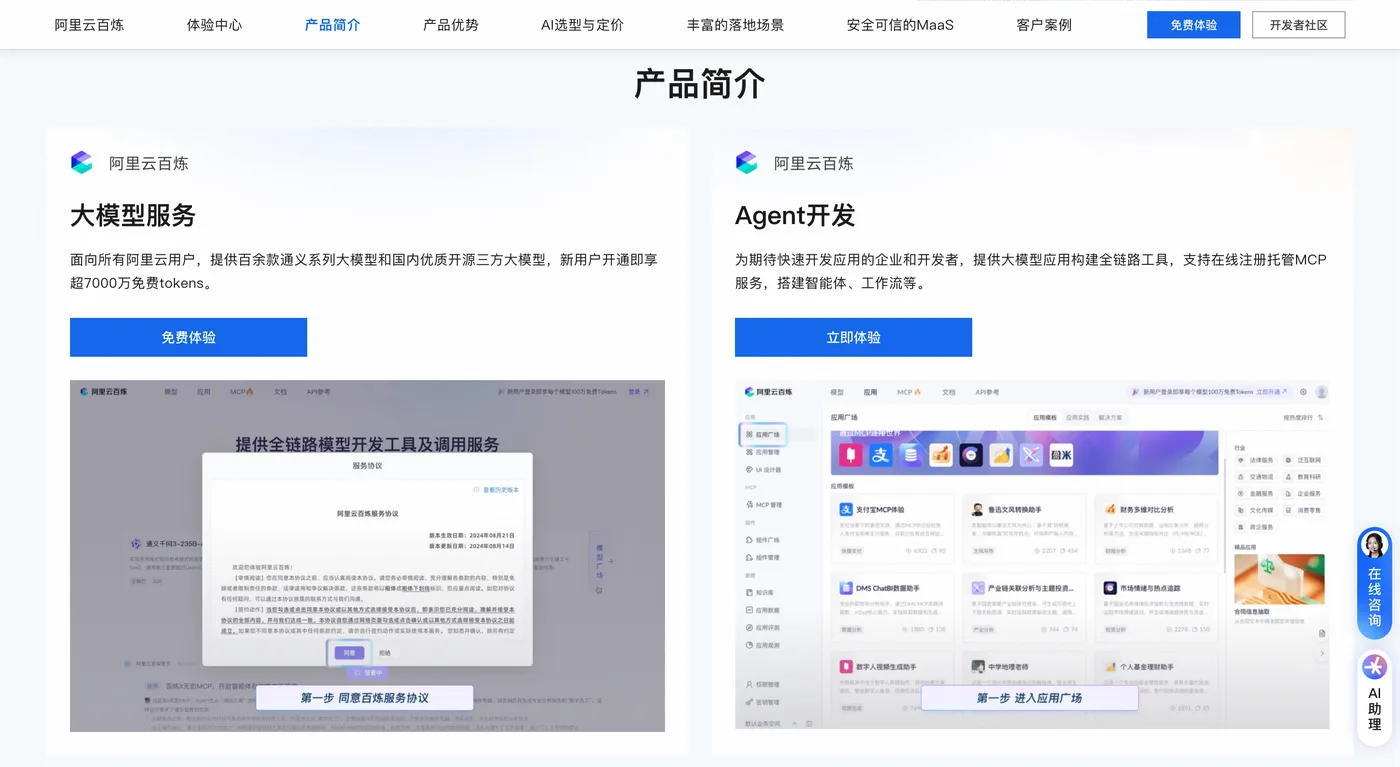
但很多初次接入视频生成能力的开发者,在实际开发中会遇到大量现实难题:单次生成时长短,无法承载完整故事叙事;人物角色在多镜头中频繁变形穿帮;仅支持图文输入,无法复用团队已有的PPT、业务报告等成熟文档素材;异步任务接口调用逻辑复杂,任务轮询逻辑难以编写;对计费规则理解模糊,上线之后出现成本超预期暴涨。本文围绕模型核心能力、输入输出规格、落地业务场景、计费体系、完整可运行curl与Python异步调用代码、参数调优技巧、模型能力边界、高频故障排查、生产环境最佳实践全方位展开讲解,帮助内容创作者与技术开发团队快速完成Wan3.0‑Video业务落地。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、Wan3.0‑Video核心能力总览
Wan3.0‑Video属于All‑in‑One一体化视频生成模型,开发者无需切换不同模型标识,调用同一个模型就可以覆盖绝大多数视频创作需求,大幅降低业务侧的模型维护成本。
1.原生30秒长叙事视频生成
市面上大量AI视频生成模型单段输出大多停留在5‑15秒,故事叙事刚刚建立就已经结束。Wan3.0‑Video原生支持单次最高30秒视频输出,输出分辨率包含480P、720P、1080P,帧率最高支持30fps,支持一镜到底、连续运镜、多段剧情连贯推进。配套智能时长推荐、视频延长能力,可以在已经生成的成片结尾继续延展剧情,不需要完整重新生成全部片段,有效拓展故事篇幅,同时节约算力消耗。
2.全能多模态输入,文档直出视频为核心差异化优势
除传统文本、图片、音频、视频素材之外,模型支持直接解析文档与公开网页链接。支持PDF、PPT、DOC、XLS、Markdown多种文件格式,单文件上限100MB,最大页数限制50页。业务人员直接上传一份产品介绍PPT或者内部培训课件,不需要手动拆解脚本、拆分镜头,模型自动提取章节标题、图表信息、核心观点,自动生成配套动态画面、字幕内容与背景音效,直接输出完整演示视频。
同时支持多素材混合参考,单次最多可以传入10张图片、5段视频、5条音频素材,融合多份参考素材的角色样貌、美术风格、道具细节、光影特征完成视频生成。
输入输出规格汇总:
| 类别 | 支持内容 |
|---|---|
| 输入模态 | 文本、图像、视频、音频、本地文档(PDF/PPT/DOC/XLS/MD)、网页链接 |
| 输出模态 | 带双声道音轨完整MP4视频,支持480P /720P /1080P |
3.像素级视觉一致性,缓解AI视频穿帮顽疾
Wan3.0‑Video针对角色、道具、场景、光影风格一致性做重点优化,实现像素级保持能力。在多镜头、长片段视频当中,能够稳定复刻参考图片当中的人物五官样貌、服装造型、道具细节,做到千人千面,降低行业普遍存在的人脸扭曲、人物样貌跨镜头突变、道具无故消失等穿帮问题。该能力不仅仅针对人物生效,UI界面、数据图表、建筑场景同样可以维持视觉特征稳定,对于IP角色系列短视频、系列广告物料的批量生产具备很高实用价值。
4.多维度视频编辑能力
模型能力不局限于从零生成完整视频,同时支持指令式编辑、参考式编辑。开发者不需要完整重跑全片生成任务,可以针对已经存在的视频修改局部背景、主体对象、光影色调;配套视频延长接口,可以在原有视频结尾接续生成后续剧情,节约创作时间与调用成本。
5.沉浸式音画同步视听输出
模型原生生成双声道音频,包含背景音乐、环境音效、人物人声,兼容多种方言音色;声音节奏、音乐旋律和画面动作自动匹配,缓解传统AI视频音画错位问题。输出得到的MP4视频可以直接交付业务使用,不需要后期单独配音处理。
6.影视级画面表现力
针对复杂打斗动作、细腻人物表演、真实物理运动逻辑完成专项优化,支持电影级运镜、光影构图,能够产出广告级、短剧分镜预演级别的画面效果。
重要说明:Wan3.0‑Video为SaaS云端推理服务,模型并未开源,不提供权重下载,不支持本地部署与本地微调,全部能力必须通过百炼API接口远程调用。
二、典型落地业务场景
- 泛娱乐短视频内容创作:剧情短片、节日祝福短视频、IP角色衍生内容、社交媒体宣传物料;动漫游戏角色动作预演,快速验证角色动态表现效果。
- 影视与广告制作辅助:脚本分镜可视化,输入文字分镜脚本直接输出参考视频;广告创意原型快速验证,结合品牌参考图生成宣传片样片;复刻指定光影运镜风格完成风格迁移。
- 电商营销业务:商品展示演示视频,上传产品图片自动生成产品动态展示短片;虚拟模特穿搭演示,生成模特转身、服饰细节展示类素材。
- 教育培训行业:培训课件视频快速制作,直接上传PPT教学文档生成授课演示视频;科学现象、历史事件可视化重现,输出课堂教学素材。
- 企业内容生产:产品介绍宣传片、内部培训短片,业务文档一键转为宣讲视频,降低企业传统宣传片拍摄制作的人力与时间成本。
三、计费规则与地域说明
Wan3.0‑Video按照生成成功的视频实际播放时长按秒计费,生成失败的任务不计费,不会产生扣费。服务国内主要部署在华北2(北京)地域,国际节点覆盖新加坡、东京、法兰克福、弗吉尼亚地域,不同地域调用单价存在差异。详情👉访问阿里云百炼大模型服务平台页面 了解。
华北2(北京)地域原价
| 分辨率 | 单价(元/秒) |
|---|---|
| 480P | 0.30 |
| 720P | 0.60 |
| 1080P | 1.20 |
新加坡地域原价
| 分辨率 | 单价(元/秒) |
|---|---|
| 480P | 0.37471 |
| 720P | 0.74942 |
| 1080P | 1.49884 |
计费举例:北京地域生成一段10秒1080P视频,费用等于10 × 1.2 = 12元;生成30秒1080P成片,原价36元。平台会不定期上线限时折扣活动,例如7折优惠,实际消耗账单以控制台展示为准。
同时提供wan3.0‑video‑prime优速版本,会优先调度算力资源,缩短任务排队等待时长,单价高于标准版,适合对生成时效敏感的业务。
关键注意事项:地域配置必须保持统一,API‑Key、请求接口、模型部署地域三者需要保持一致,跨地域直接调用会返回接口报错。
四、API接入实操,curl与Python完整异步代码
Wan3.0‑Video全部任务均为异步任务模式:第一步提交生成请求,获取task_id;第二步循环轮询查询任务状态;任务执行成功之后获取视频URL。不能使用同步方式阻塞等待结果返回。
调用前期准备:前往百炼控制台创建API‑Key,妥善保存密钥,优先使用环境变量注入密钥,禁止硬编码写入业务代码文件。
curl提交生成任务示例(文生视频)
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxx"

curl --location 'https://dashscope.aliyuncs.com/api/v1/services/aigc/video-generation/video-synthesis' \
-H 'X-DashScope-Async: enable' \
-H "Authorization: Bearer ${DASHSCOPE_API_KEY}" \
-H 'Content-Type: application/json' \
-d '{
"model":"wan3.0-video",
"input":{
"prompt":"城市黄昏街头,写实风格,行人缓缓走过街道,柔和落日光影,电影运镜,20秒连贯叙事镜头"
},
"parameters":{
"resolution":"720P",
"duration":20,
"ratio":"16:9",
"watermark":false
}
}'
提交接口成功会返回task_id,使用task_id轮询查询任务结果:
curl -X GET "https://dashscope.aliyuncs.com/api/v1/tasks/你的task_id" \
-H "Authorization: Bearer ${DASHSCOPE_API_KEY}"
Python完整异步调用示例,支持文档输入生成视频
先安装依赖库dashscope与python‑dotenv:
pip install dashscope python‑dotenv
import os
import time
import dashscope
from dotenv import load_dotenv
from dashscope import VideoSynthesis

load_dotenv()
dashscope.api_key = os.environ.get("DASHSCOPE_API_KEY")

def submit_video_task(prompt:str, media_list:list=None, duration:int=15, resolution:str="720P"):
    """提交Wan3.0‑Video异步生成任务"""
    rsp = VideoSynthesis.async_call(
        model="wan3.0-video",
        prompt=prompt,
        media=media_list,
        duration=duration,
        resolution=resolution,
        watermark=False
    )
    if rsp.status_code == 200:
        task_id = rsp.output.task_id
        print(f"任务提交成功 task_id:{task_id}")
        return task_id
    else:
        print(f"任务提交失败 code:{rsp.code}, message:{rsp.message}")
        return None

def wait_for_task_result(task_id:str, sleep_interval:int=8, max_wait:int=300):
    """轮询等待任务完成,最大等待300秒"""
    cost = 0
    while cost < max_wait:
        rsp = VideoSynthesis.fetch(task_id)
        if rsp.status_code == 200:
            task_status = rsp.output.task_status
            if task_status == "SUCCEEDED":
                return rsp
            elif task_status in ["FAILED","CANCELED"]:
                print(f"任务异常,状态:{task_status},信息:{rsp.message}")
                return rsp
        time.sleep(sleep_interval)
        cost += sleep_interval
    print("任务等待超时")
    return None

if __name__ == "__main__":
    # 示例1:普通文生视频
    taskid1 = submit_video_task(
        prompt="森林清晨,薄雾弥漫,阳光穿过树叶,小动物在林间活动,写实电影画面",
        duration=18,
        resolution="720P"
    )
    res1 = wait_for_task_result(taskid1)
    if res1 and res1.output and res1.output.video_url:
        print("生成视频地址:", res1.output.video_url)

    # 示例2:传入PPT文档,文档解析生成产品宣传视频
    media_input = [
        {

            "type":"file","url":"https://example.com/product_intro.pptx"
        }
    ]
    taskid2 = submit_video_task(
        prompt="基于这份PPT文档,生成简约科技风产品介绍宣传视频",
        media_list=media_input,
        duration=25,
        resolution="1080P"
    )
    res2 = wait_for_task_result(taskid2)
    if res2 and res2.output and res2.output.video_url:
        print("文档转视频输出地址:",res2.output.video_url)
参数说明:media数组用来传入图片、视频、音频、文档资源,资源必须为公网可访问HTTP链接;接口不支持直接上传本地二进制文件,需要预先把文件上传对象存储获取公网URL之后再传入接口。
五、关键参数调优与提示词编写建议
- duration时长:取值区间1‑30秒,视频设置时长越长,任务排队耗时越高,计费成本同步上涨,业务开发不要无脑直接设置30秒,优先使用业务实际需要的时长。
- resolution分辨率:480P适合快速样片测试,压缩调试成本;720P兼顾画质与成本,适合绝大多数中间版本;1080P用于正式对外交付成片。
- ratio画面比例:支持16:9、9:16、4:3、adaptive自适应。短视频平台业务优先9:16,宣传片、演示视频优先16:9。
- 参考素材使用技巧:做多参考生成任务,参考图片保证主体清晰;做角色复刻业务,优先传入正面五官清晰人像参考,有效提升人物跨镜头一致性。
- 文档输入提示词技巧:传入PPT/PDF文档的时候,prompt写明视频整体美术风格、色调、镜头运动要求,模型读取文档内容同时结合提示词完成画面创作。需要注意模型不会机械逐页把文档转为画面,提示词需要明确叙事方向。
- watermark水印:正式对外业务设置
false关闭水印;内部样片测试场景可以开启水印。
六、能力边界说明
- 模型为云端SaaS服务,不支持本地部署、私有化权重导出、本地微调;全部请求都需要调用百炼API接口。
- 文档输入仅解析公开可访问链接,单文件大小上限100MB,页数最大50页,超大文档业务需要提前做文档拆分。
- 虽然角色一致性经过专项优化,30秒超长片段依旧存在小概率局部穿帮现象,商业成片建议多次生成挑选最优版本。
- 不适合超高精度工业级仿真场景,更加适配创意内容、广告物料、培训课件、分镜预演业务。
- AI生成内容需要使用者自行开展内容合规审核,规避违规画面输出风险。
七、高频故障排查与生产环境最佳实践
故障1:提交任务返回401鉴权报错
核对API‑Key复制完整,不存在多余换行、空格;确认请求接口地域与密钥所属地域保持一致;确认账号已经开通该模型调用权限。
故障2:任务长时间处于PENDING排队状态
业务高峰期算力资源紧张,可以切换wan3.0‑video‑prime优速版本缩短排队时长;批量业务做好限流管控,不要短时间大批量提交任务,避免队列积压。
故障3:文档输入,生成视频没有体现文档内容
确认文档公网URL可以正常访问,文件大小、页数没有超过限制;prompt明确告知模型读取参考文档内容;优先使用页数较少的PPT/PDF验证链路是否正常。
故障4:人物角色画面变形、穿帮
增加多角度角色参考素材;适当缩短单段生成时长;提示词明确要求保持人物五官、服饰细节不发生改变。
故障5:调用计费账单和预估差距大
只有任务SUCCEEDED成功状态才会计费;FAILED失败任务不计费;前往控制台账单核对每一条成功任务的实际生成秒数。
生产环境落地最佳实践
- 业务分层测试:前期创意测试阶段优先480P/720P降低成本,创意方案确认完毕之后,再切换1080P生成正式成片。
- 做好任务队列管控:业务系统禁止无限制并发提交任务,设置合理并发上限;轮询task接口增加指数退避逻辑,不要高频循环轮询接口,避免触发限流。
- 资源预处理:文档、图片素材先上传对象存储获取公网HTTPS链接,再传入API;接口不支持直接上传本地二进制文件。
- 结果存储:接口返回的视频URL具备有效期,业务拿到视频资源之后立刻转存自有存储服务,防止链接过期丢失素材。
- 内容安全:接入业务配套内容安全检测流程,AI生成视频必须做合规审核。
- 区分标准版与Prime优速版:测试调试阶段使用标准版;对外交付、时效敏感业务选择Prime优速版本。
总结
Wan3.0‑Video把AI视频生成从碎片化短镜头工具升级为完整叙事生产力工具。原生30秒长时长生成、多素材全能参考、PDF/PPT等文档直转视频、像素级角色一致性、原生音画同步构成这套模型的核心竞争力,覆盖短视频创作、广告预演、电商物料、教育培训课件生成等众多业务场景。
开发者接入的时候需要牢牢记住:全部任务为异步模式,提交task_id之后轮询获取任务结果;所有参考素材必须使用公网可访问链接;分清不同分辨率、时长带来的计费差异;测试阶段优先较低分辨率验证创意,定稿之后再输出高清成片。同时认清模型本身的能力边界,商业业务必须对生成结果开展人工审核和内容合规校验。
借助curl、Python SDK就可以快速完成业务接入,不管是个人创作者做样片原型,还是企业搭建自动化视频物料生产链路,Wan3.0‑Video都可以作为高性价比的AI视频生成解决方案。




