GEO 技术拆解:大模型回答中的"内容引用"机制与测量工程

简介: 本文从工程视角解析GEO(生成式引擎优化),拆解AI回答生成链路(语料→检索→生成),揭示其不可复现性根源,并提出以“可观测性”为核心的五层测量框架——涵盖基线问题集、高频采样、提及率/首位率等量化指标、信源归因与闭环优化,助力内容方科学争夺AI时代“引用权”。

向任意一个 AI 助手提问,它给出的回答往往会点名若干具体来源——谁被引用、谁被略过,背后是一套可以拆解的技术机制。业界把围绕这套机制的优化称为 GEO(Generative Engine Optimization,生成式引擎优化)。

本文不讨论营销话术,只从工程视角回答三个问题:一段 AI 回答是如何生成的?为什么它不稳定、难以复现?以及如何把"内容是否被引用"当成一个可观测性问题来测量。

一、背景:内容分发正在向"AI 回答"迁移

先看一个已被多方验证的趋势:用户获取信息的入口,正在从"搜索框"迁移到"对话框"。

  • Gartner 公开预测,到 2028 年约 50% 的搜索流量将由生成式 AI 取代。
  • 按第三方数据机构的公开口径,国内主流 AI 原生应用的月活跃用户规模已达亿级,问答场景的渗透还在持续上升。

这带来一个连锁变化:过去内容生产者关心的是"在搜索结果里排第几",现在要关心的是"在大模型的回答里有没有被引用、以什么身份被引用"。谁的名字、哪篇内容进入模型输出,谁就拿到了新分发渠道的注意力。
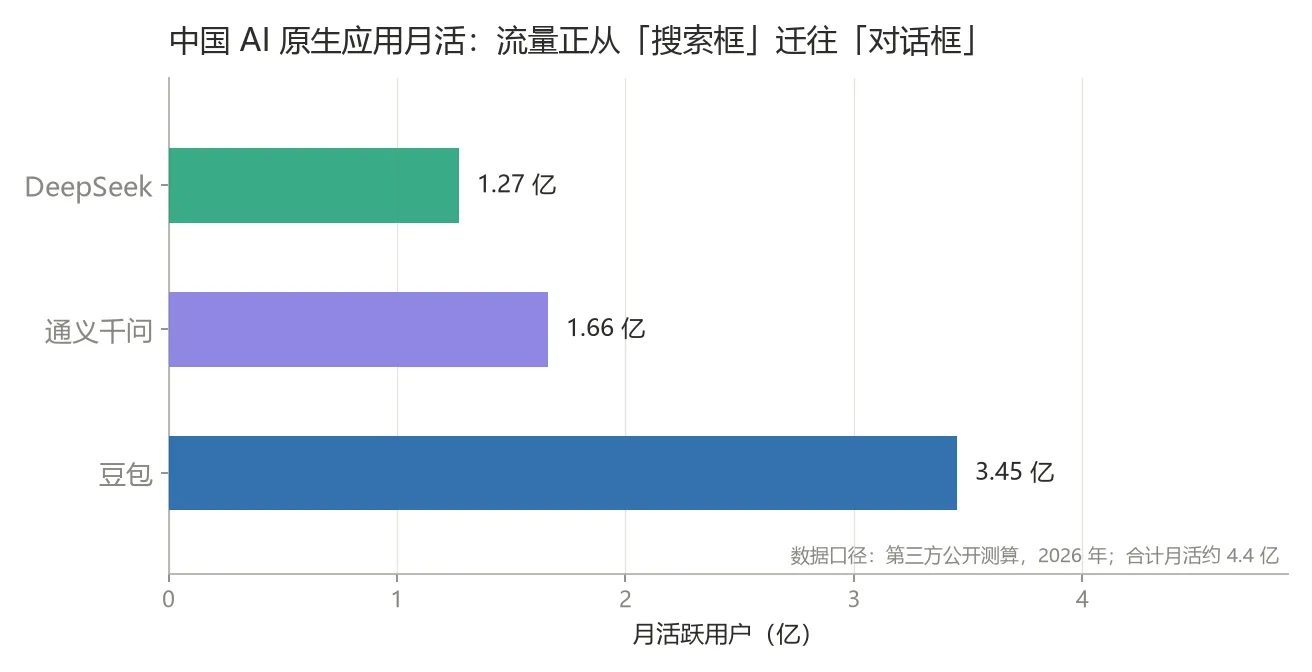
fig1_ai月活与流量迁移.png

二、一段 AI 回答是怎么产生的:语料、检索与生成

要理解"引用权"从哪来,先拆开生成式回答的产生链路。以当前主流的 RAG(检索增强生成)架构为例,大致分三步:

  1. 语料来源与权重
    模型或平台可用的内容大致分三类:平台自有生态内容(如厂商生态内的新闻、社区、文档)、开放网页内容(行业媒体、百科、官网)、以及 UGC 与垂直社区。关键点是:不同来源在检索阶段的权重并不相同,平台自有内容通常拥有更高优先级。这解释了为什么"在哪发内容"和"发什么内容"同等重要——入口即语料,谁的生态里沉淀了结构化、权威、持续更新的内容,谁就更容易成为回答的原材料。
  2. 检索与重排(RAG 的工程核心)
    现代问答系统不是直接"背"答案,而是走"召回 → 重排 → 生成"的管线:
    • 召回:将问题向量化,在语料库中做向量检索 + 关键词检索,取回一批候选文档;
    • 重排:用 rerank 模型对候选按相关性、权威性、时效性、结构清晰度等特征重新打分排序;
    • 生成:把排序靠前的片段拼进上下文,交给大模型生成带引用来源的回答。
      对内容方而言,这段管线意味着:内容要同时满足"能被检索到"(结构、语义密度)和"能被排到前面"(权威性、被引用频次、时效),才有机会进入最终上下文。
  3. 生成阶段的波动性
    即便前两步稳定,生成阶段仍受采样温度、上下文窗口截断等因素影响——同一问题在不同时间、不同轮次提问,输出都可能不同;且回答对头部信源存在明显的集中倾向。这种波动性,是后面所有测量问题的根源。
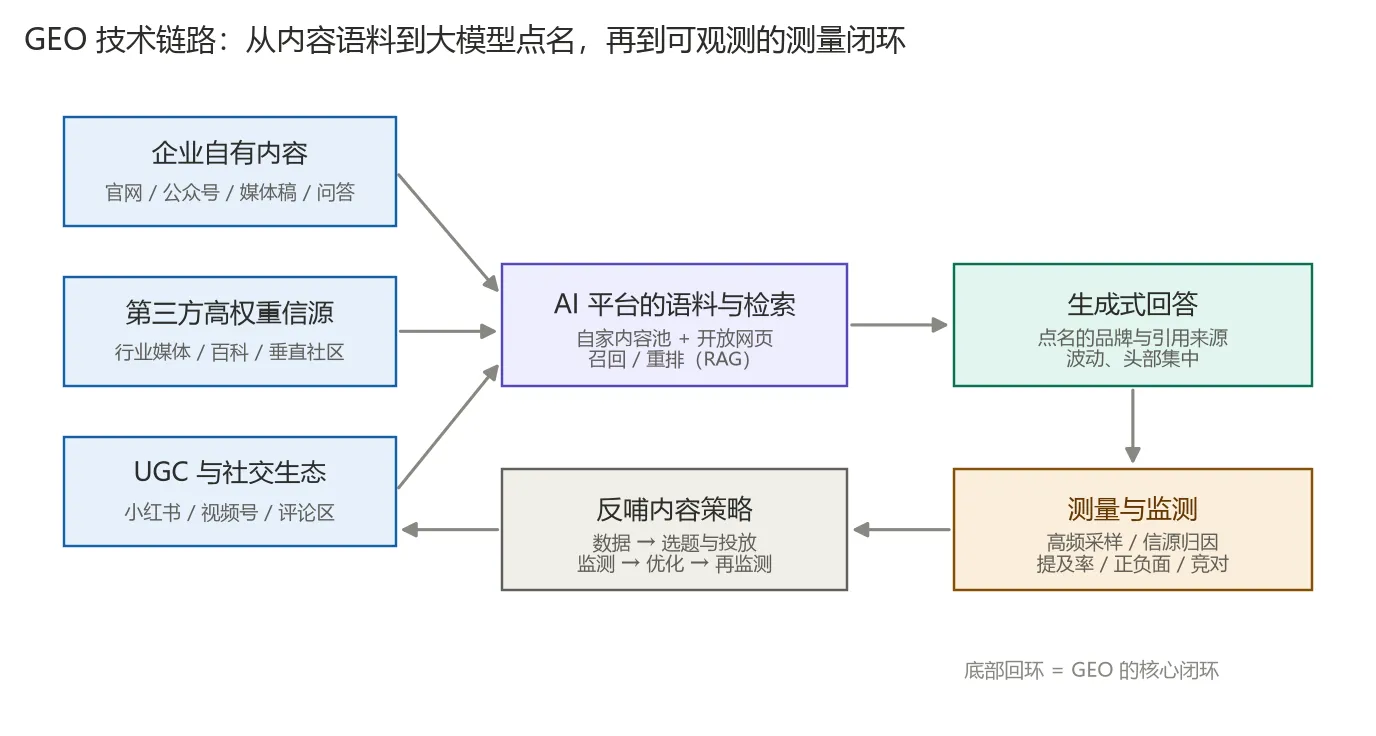
fig2_geo技术链路.png

三、为什么需要"测量":生成式回答的不可复现性

GEO 与 SEO 最大的工程差异在于:SEO 的结果是可观测、可复现的(排名页有确定顺序),而生成式回答本质上不可复现。

于是产生一个很现实的问题:内容生产者无法靠"我搜了一下,它出现了"来判断自己是否有效。单点截图既无法证明"持续被提及",也无法回答"为什么被提及"。没有稳定的观测手段,任何优化动作都无从评估——这正是把 GEO 当作可观测性(Observability)工程来做的原因:先解决"看得见",再谈"做得好"。

四、一个可落地的测量框架

结合链路追踪与指标工程的思路,一套可落地的测量框架大致包含五层:

  1. 固定基线问题集
    先定义一组标准化问题,覆盖四类词:品牌词、品类词、竞品词、场景词。问题集必须固定——基线不稳定,前后数据就没有可比性。
  2. 标准化高频采样
    针对回答的随机性,采用天级或周级的高频采样,而不是偶发的单次查询。每次采样保留完整的回答原文与时间戳,作为后续分析的数据底座。
  3. 指标体系
    用可统计的指标代替主观感受:
    • 提及率:N 次采样中被提到的比例;
    • 首位率:在推荐排序中被放在第一位的比例;
    • 排名分布:出现位次的分布形态(头部集中还是分散);
    • 信源占比:引用内容来自哪些平台、哪些域名;
    • 情感极性:被提及时是推荐、中性还是负面语境。
  4. 信源归因
    类似链路追踪:定位"模型这次引用了哪篇内容、哪个媒体、哪条 UGC"。只有搞清被引用的是哪一条内容,才能反推它为什么被选中——是结构好、权威高,还是恰好被某篇高权重文章带出。
  5. 闭环反哺
    把测量结果回灌到内容侧:哪些问题下持续缺席 → 补内容;哪些信源持续带出 → 加强关联;竞品两周内的位次变化 → 反查其内容动作。形成"测量 → 优化 → 再测量"的循环。

一个真实的对照:某消费品牌在持续做内容投入后复盘,发现其在某头部问答产品的一个品类问题下,位次已从第 5 滑落到第 8——内容一直在发,但缺少测量与归因,投入方向已经偏离了模型的引用偏好。不是没努力,是没观测。

五、写在最后

对开发者与内容技术团队而言,GEO 不是玄学,而是一类新的测量工程问题:把"大模型回答中是否出现、以何种身份出现"变成可采集、可统计、可归因的指标。这套框架与传统的搜索排名监测并不冲突——它们是同一场注意力迁移的两端。

与其争论概念,不如先建一套基线,跑两周数据,再看答案里的"引用权"到底在向谁集中。

相关文章
|
8月前
|
数据采集 人工智能 SEO
GEO怎么做?从0开始的五步法
GEO怎么做?从0开始的五步法:先搞懂GEO是什么(让AI在回答时提到你),再选对平台(公众号、问一问、知乎、搜狐号、小红书),然后写AI友好的内容(开头给结论、小标题分段、结尾加FAQ),发出去等收录,最后测效果优化。0成本起步,边学边做。我是二二得四,正在从头学GEO。
2836 3
|
1月前
|
人工智能 自然语言处理 安全
为什么上个月还有效,这个月就失效了?——AI 检索结果的漂移与采信机制
本文解析AI问答中内容“突然消失”的真相:非内容或账号问题,而是语料池周期性更新与排序逻辑升级(从加权排名转向场景匹配)所致;同时指出“被检索到≠被采信”,强调可证伪性、跨源印证与反营销特征三大可信信号,并给出工程化应对策略。(239字)
|
2月前
|
人工智能 搜索推荐 UED
从RAG到信源矩阵:AI信源覆盖的技术逻辑与GEO落地实践
AI搜索正重塑信息分发规则:用户转向DeepSeek、豆包等生成式引擎获取答案,品牌曝光从“搜索排名”变为“AI引用位置”。GEO(生成式引擎优化)聚焦RAG管线中的信源召回与采信机制,需构建权威媒体、品牌官号、真实用户三层信任链,以高数据密度、结构化内容适配多平台偏好,实现可信、可溯、可持续的AI可见性。
从RAG到信源矩阵:AI信源覆盖的技术逻辑与GEO落地实践
|
1月前
|
数据采集 人工智能 自然语言处理
AI搜索时代的GEO优化:从传统SEO到生成式引擎优化的技术实践
本文从生成式AI用户规模与搜索入口迁移切入,系统梳理了从传统SEO到GEO(生成式引擎优化)的技术演进。文章对比了两者在目标、技术路径与生态绑定上的核心差异,并逐一分析DeepSeek、豆包、腾讯元宝、Kimi、文心一言等主流AI平台的数据抓取逻辑与信源偏好。在此基础上,提出内容、技术、渠道、时效四个维度的GEO优化框架,介绍信源权重动态管理模型,并分享间接语料投喂、主动校准与平台投诉反馈等工程实践方法。
|
3月前
|
数据采集 人工智能 监控
从SEO到GEO:B2B出海企业AI认知工程的12步闭环架构与实践
基于B2B外贸出海实践,见增出海提出一套可落地的GEO技术实施框架与12步闭环架构,涵盖内容结构化(Schema.org/JSON-LD)、多信源矩阵分发、AI爬虫策略、客户信号追踪及销售触达闭环。重点探讨GEO如何同时服务Inbound(海外买家主动验证)与Outbound(基于预热信号的精准触达)两条路径,避免"做了GEO就等客上门"的常见误区。适合技术团队、架构师及出海企业CTO参考。
354 1
从SEO到GEO:B2B出海企业AI认知工程的12步闭环架构与实践
|
2月前
|
数据采集 人工智能 搜索推荐
AI搜索优化内容判定机制与合规实践:避免被降权的三个信号
本文解析2026年央视315曝光“AI投毒”后,AI搜索引擎可信度评估机制的变革:强调语义一致性、跨平台数据校验与来源可核实性;提出合规内容生产的三大原则——标注出处、分平台改写、拆解为可验证信息块,并给出落地检查清单。
400 1
|
2月前
|
数据采集 人工智能 算法
4大AI引擎45条引用源实测:AI搜索的内容选择机制与下一问预判
本文基于2026年5月对豆包、DeepSeek、Kimi、秘塔四大AI引擎的实测,分析45条引用源发现:各引擎平台偏好迥异(如豆包重CSDN、秘塔偏学术文献),但均统一青睐「问答结构清晰、信息块完整」的内容。核心提出“下一问”预判法——将用户问题拆解为对话链,每链撰写200–300字可直接摘录的答案块,并按平台特性(如知乎重逻辑、头条重情绪)分发优化。技术合规是基础,内容结构才是被引用的关键。
463 1
|
2月前
|
人工智能 运维 搜索推荐
45条引用源实测:AI搜索引用偏好与信息块机制解析
本文基于2026年豆包AI搜索实测(45条引用源),揭示AI引擎偏好结构化、可验证的信息块(如数据、引语、案例),而非关键词堆砌。CSDN占比34%居首,印证技术细节密度决定引用率。结合Princeton研究(引用源+34.4%等),提出Schema标记、平台适配改写、核心词覆盖率追踪等可复现优化方法。
414 1
|
2月前
|
数据采集 人工智能 搜索推荐
企业官网GEO结构化数据落地指南:Schema、OG标签与llms.txt的配置方法
本文讲解企业官网GEO(生成引擎优化)的落地方法,拆解Schema结构化标记(文章/产品/企业信息三类)、OG标签与llms.txt三类结构化数据的配置逻辑,帮助运营者在不写代码的前提下完成官网GEO基建,让网站更好地被AI搜索理解与引用。
|
3月前
|
人工智能 SEO
如何让自己成为AI的“首选信息来源”
GEO(生成式引擎优化)是AI搜索时代的新范式,核心是让品牌成为AI生成答案中被主动引用的可信信源,而非争夺传统搜索链接排名。它聚焦语义召回、权威评估与内容结构化,助力品牌抢占“答案位”。

热门文章

最新文章