Redis 与 MySQL 一致性实战:一次多发 317 张优惠券的故障链

简介: 一次优惠券超发事故揭示缓存与数据库一致性本质:Redis仅作读加速,最终裁决必须由MySQL事务+唯一约束保障。故障源于缓存删除失败+缺乏原子扣减条件,导致317张券超发。

Redis 与 MySQL 一致性实战:一次多发 317 张优惠券的故障链

10 万张限量优惠券在 10 点开抢。监控里 Redis 正常、MySQL 正常,接口成功率也没有突然掉到谷底,活动结束后却多出了 317 条领取记录。

事故复盘发现:最后一张券在数据库里扣减成功后,应用删除 Redis 库存键失败;随后一批请求继续从旧缓存读到“还有 84 张”。更致命的是,数据库写入没有把“库存仍大于 0”作为原子条件,只相信了缓存的预检结果。
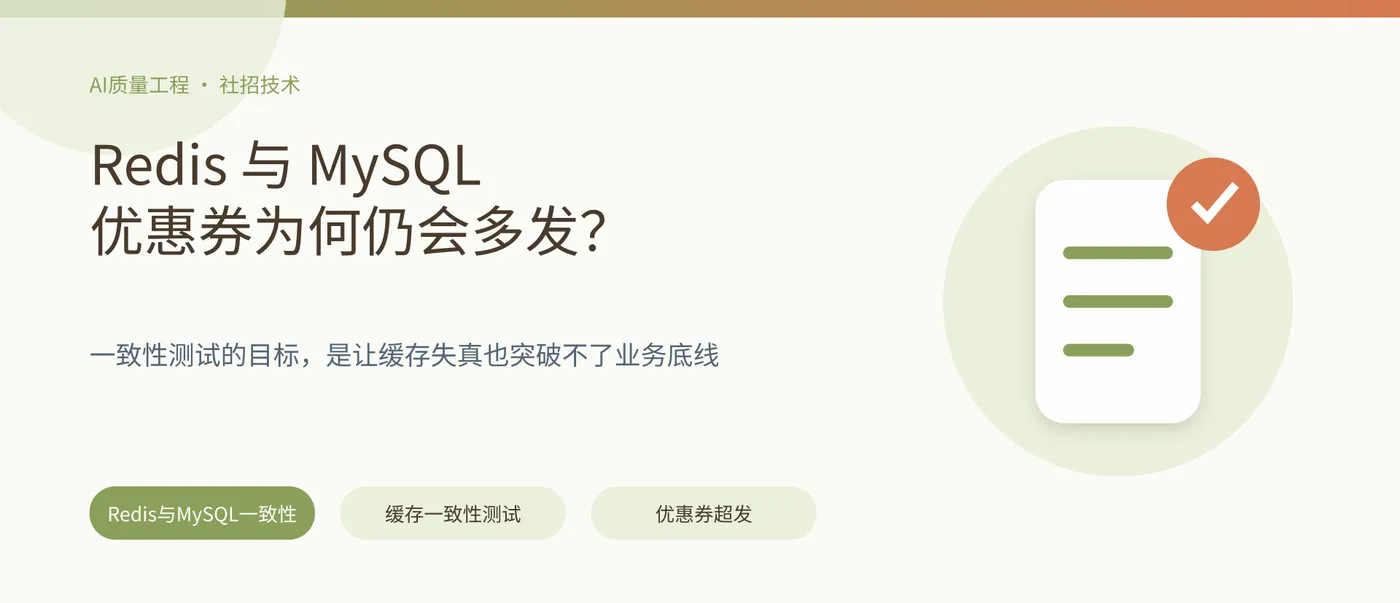
image.png

先改一个观念:Redis 不是稀缺资源的最终裁判

缓存适合加速读取和拦截明显无效请求,但限量券、库存、余额和名额一旦产生经济后果,最终裁决必须落在具备事务与唯一约束的存储中。

这意味着缓存短暂不一致可以接受,但不一致只能造成“页面显示还有、提交后告知已领完”,不能造成真实超发。测试目标不是幻想 Redis 与 MySQL 永远同一瞬间相等,而是验证任何故障窗口都无法穿透业务不变量。
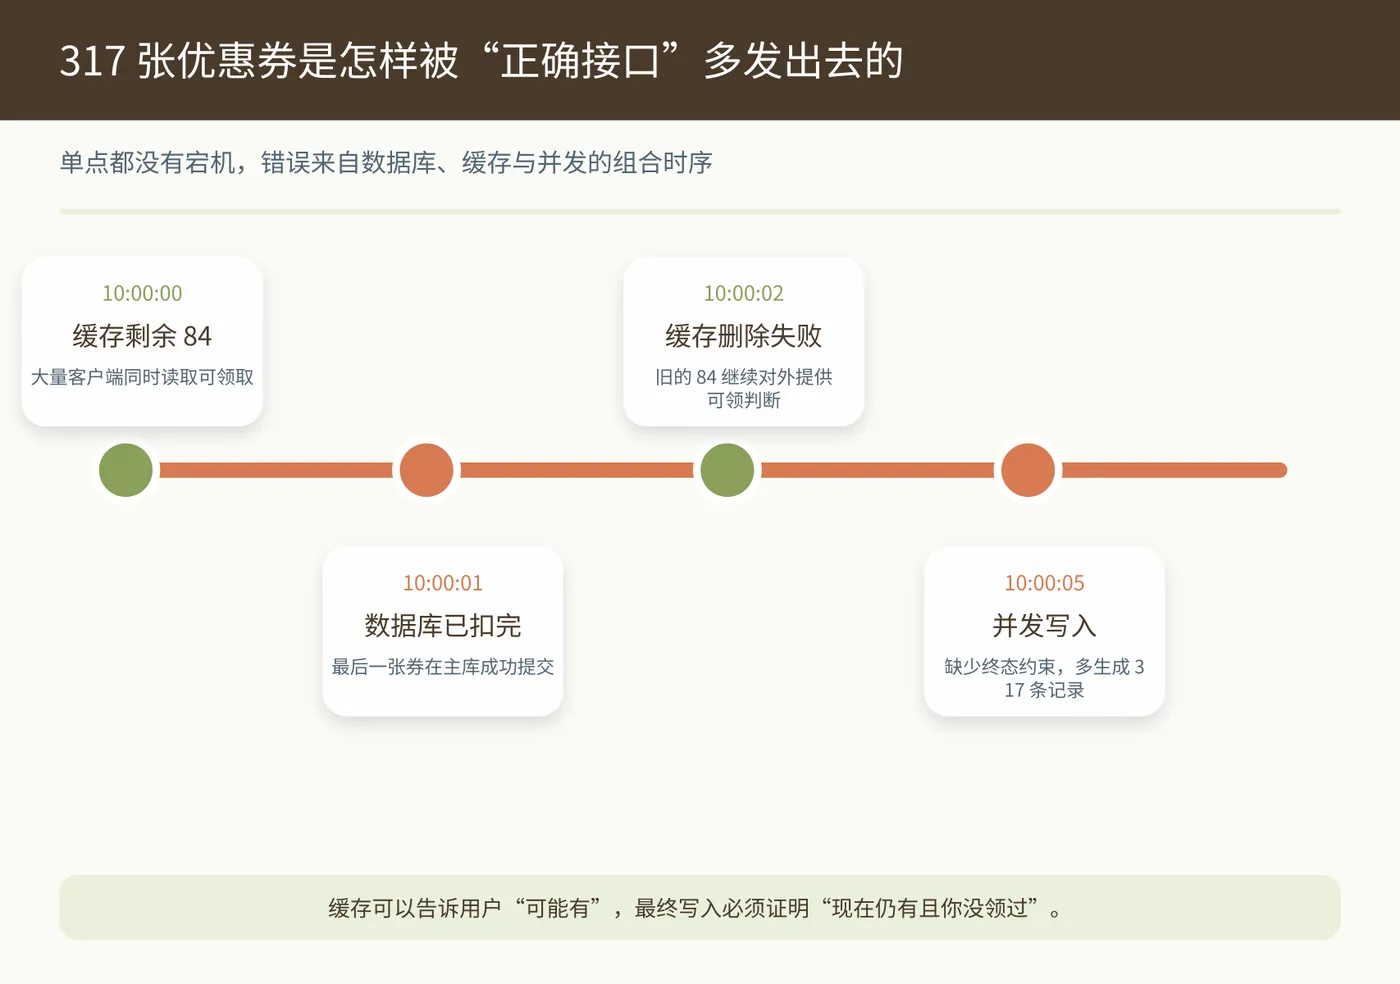
image.png

把两个不变量写进数据库,而不是写进注释

第一,同一用户在同一活动只能成功领取一次;第二,活动 remaining 不得小于 0。可以用唯一约束和条件更新共同保证:

CREATE UNIQUE INDEX uq_claim_campaign_user
ON coupon_claim(campaign_id, user_id);

BEGIN;

UPDATE coupon_campaign
SET remaining = remaining - 1,
    version = version + 1
WHERE campaign_id = :campaign_id
  AND status = 'ACTIVE'
  AND starts_at <= NOW()
  AND ends_at > NOW()
  AND remaining > 0;

-- 应用必须检查上一条 UPDATE 是否恰好影响 1 行
INSERT INTO coupon_claim(campaign_id, user_id, status)
VALUES (:campaign_id, :user_id, 'CLAIMED');

COMMIT;

真实实现中,若条件更新影响 0 行,应区分活动不存在、时间不合法、库存耗尽等结果;若唯一约束冲突,应返回“你已经领取”,并回滚本次库存扣减。两个动作必须在同一事务里。

数据库提交和缓存更新之间,故障一定会发生

最危险的窗口是:数据库已经提交,进程还没来得及删缓存就崩溃。把删缓存写在 try 的下一行,并不能让两者原子化。

一种可落地方案是在同一事务里写 Outbox 事件,后台工作器按事件刷新或删除缓存。即使进程重启,事件仍可重放。缓存值附带数据库版本,旧事件晚到时也不能覆盖新版本。

def apply_cache_event(cache, event):
    key = "coupon:" + str(event["campaign_id"])
    current = cache.get(key) or {
   "version": -1}
    if current["version"] >= event["version"]:
        return "ignored_old_event"
    cache.set(key, {
   
        "remaining": event["remaining"],
        "version": event["version"],
    }, ttl_seconds=30)
    return "applied"

TTL 是最后一道自愈手段,不是主要一致性方案。TTL 设得再短,也存在业务高峰中的错误窗口;设得太短还会造成大量回源,把数据库压垮。
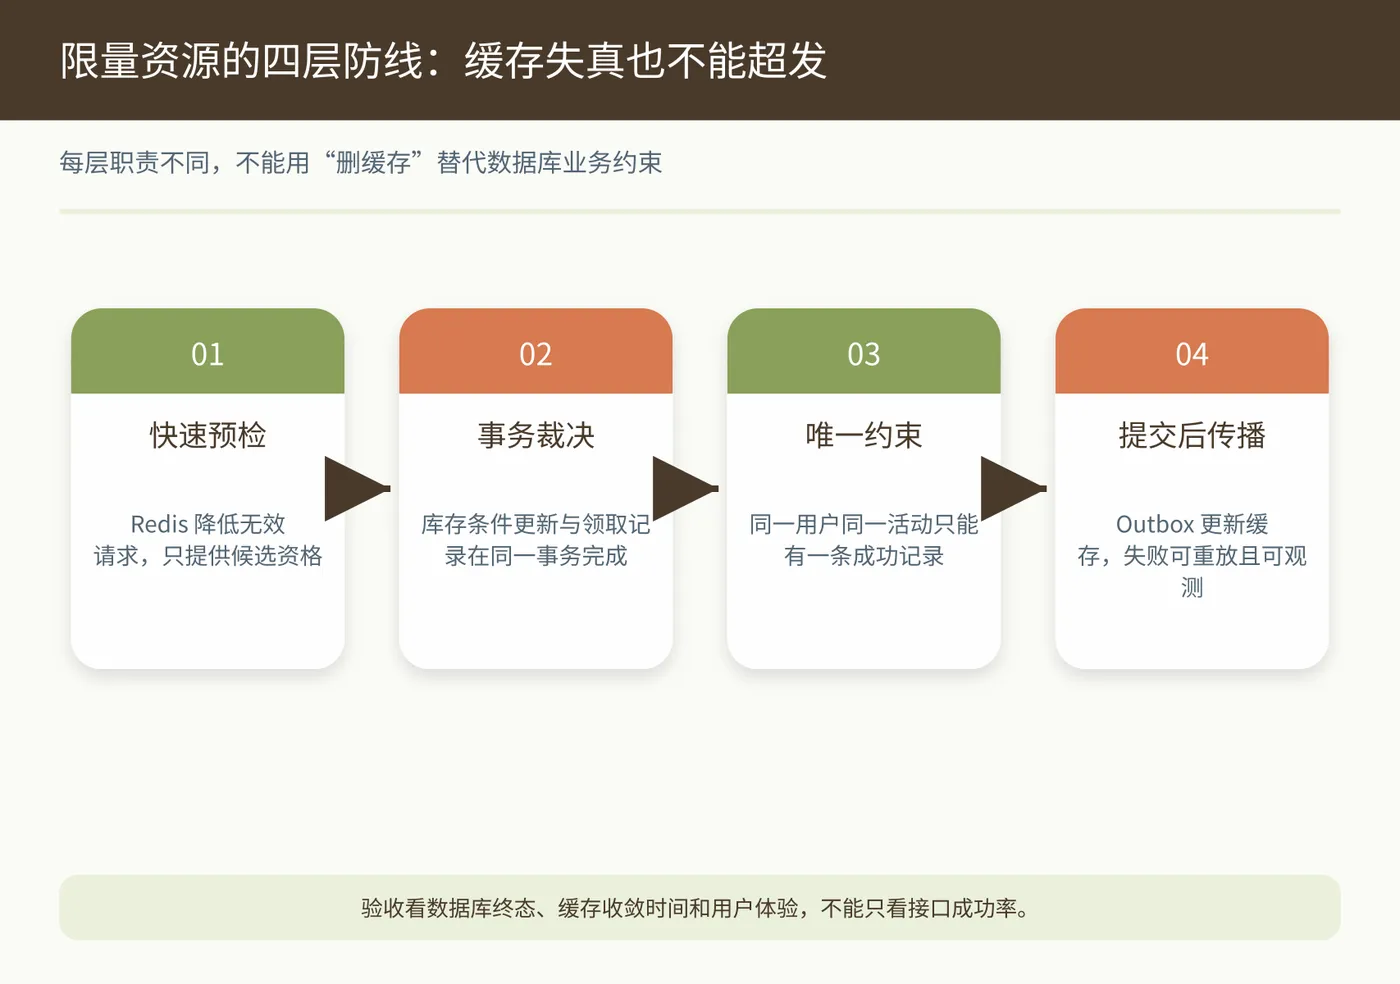
image.png

缓存一致性应该怎样测试

正常读写只是起点。至少要在四个位置注入故障:数据库提交前崩溃、提交后删缓存前崩溃、Outbox 已发送但确认丢失、旧缓存事件晚于新事件到达。再叠加 100 路同用户并发和 1000 路不同用户争抢最后 50 张券。

最终不要只数 HTTP 200,而要查询数据库终态:成功领取数不超过初始库存;remaining 不小于 0;同一用户最多一条成功记录;所有成功记录都能追溯到活动版本。缓存可以暂时落后,但应在约定时间内收敛。

def assert_campaign_invariants(repo, campaign_id, initial_stock):
    campaign = repo.get_campaign(campaign_id)
    claims = repo.successful_claims(campaign_id)
    users = [row.user_id for row in claims]

    assert 0 <= campaign.remaining <= initial_stock
    assert len(claims) + campaign.remaining == initial_stock
    assert len(users) == len(set(users))

监控也要从组件可用升级到业务一致

Redis 命中率和 MySQL QPS 都健康,不代表券没多发。生产上还要观察:缓存版本落后量、Outbox 最老积压时间、库存差值、唯一约束冲突率、提交后回写失败数。它们才能提前暴露一致性正在恶化。

Redis 与 MySQL 一致性真正要守住的,不是每次读取都完全相同,而是任何缓存旧值、消息重复和进程崩溃,都不能让稀缺资源的业务账失真。这才是缓存一致性测试的终点。
相关文章
|
22天前
|
SQL 人工智能 自然语言处理
长上下文代码评审的错觉:模型读完仓库,不等于读懂变更半径
本文揭示长上下文模型在代码评审中的认知盲区:读完仓库不等于读懂变更半径。枚举值修改引发多系统故障,暴露静态理解与真实影响间的鸿沟。提出四层影响图(静态依赖、运行调用、数据血缘、业务责任)和证据驱动的风险评估范式,强调测试工程师需从“写用例”转向“组织变更证据”。
长上下文代码评审的错觉:模型读完仓库,不等于读懂变更半径
|
22天前
|
缓存 JSON API
阿里云千问Qwen3.8‑Flash深度解析:多模态能力、订阅计费规则、API接入配置与生产落地完整教程
Qwen3.8‑Flash是千问系列主打高速、高性价比的原生多模态基座,百万Token上下文窗口,支持图文视频输入,具备不错的代码能力、中等复杂度Agent工具调用能力,延迟表现优秀,非常适合高并发线上业务、知识库问答、轻量智能体、图文解析、代码辅助开发场景。
406 1
|
22天前
|
缓存 API 开发者
阿里云qwen3.7-flash大模型介绍:模型能力、模型价格、免费额度与最新活动
Qwen3.7-Flash选型与接入参考指南:本文聚焦这款兼顾性能与成本的原生视觉语言轻量模型,覆盖其多模态理解、Agent执行等核心特性,全维度工程化能力矩阵,低至0.02元/百万Tokens的阶梯计费规则,100%剩余、2026年10月23日到期的百万级免费额度,以及百万级上下文、高并发限流参数,配套OpenAI兼容模式的Python深度思考流式调用示例,同步梳理夜间折扣、满减券等专属优惠,帮助开发者快速完成选型与低成本落地。
|
21天前
|
人工智能 运维 Oracle
落地之道丨FDE,大模型落地的最后一公里
AI 落地的核心不在模型层,而在模型之下的执行层。
|
21天前
|
存储 人工智能 JavaScript
阿里千问办公 QwenWork 怎么使用,新手入门操作步骤:写一份Q2项目报告输出Word文件
阿里千问办公QwenWork是一站式AI生产力平台,支持一句话完成数据分析、PPT生成、视频剪辑、网页搭建等复杂任务。通过多轮对话推进工作,集成网盘管理、扩展能力与网页发布功能,兼顾免费版与多档付费方案,助力个人及企业高效智能办公。阿里千问办公官网:https://t.aliyun.com/U/JNKJuO 阿里AI工作平台,一句话完成数据分析、PPT 生成、视频剪辑、网页搭建等复杂任务
|
21天前
|
人工智能 分布式计算 Serverless
EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)
Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。 以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。 本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。
182 0
|
22天前
|
人工智能 IDE 程序员
千问办公、Qoder Teams、Qoder CN完整选型指南:定位差异、模型能力、计费活动与落地场景详解
随着AI智能体产品快速迭代,市面上同时出现千问办公、Qoder CN、Qoder Teams三款极易混淆的产品,很多开发者、企业采购人员经常出现选型失误,误购产品之后发现能力不匹配业务诉求。三者虽然底层共享部分大模型基座,但产品定位、能力侧重点、账号体系、计费模式、面向人群完全不同。Qoder CN偏向个人开发者AI编程智能体;Qoder Teams是Qoder CN对应的企业团队版本,面向研发团队多人协同开发;千问办公定位通用企业办公智能体,面向非研发岗位,聚焦文档处理、数据整理、业务流程自动化。
237 0
|
12天前
|
JSON 人工智能 测试技术
别再给大模型输出写死期望值:Hypothesis + Pydantic + pytest 把非确定性回答测成一组『不变量』
本文揭示大模型测试中“固定值断言”的致命缺陷:因模型输出天然非确定(字段顺序、类型漂移、冗余文本等),`assert == 固定字典` 导致假红或漏检。提出用属性测试(Hypothesis + Pydantic)替代——聚焦守业务不变量(如金额非负、必填字段存在、不泄露提示),而非形态一致。解耦“输出长什么样”与“输出对不对”,让测试真正守住底线。
别再给大模型输出写死期望值:Hypothesis + Pydantic + pytest 把非确定性回答测成一组『不变量』
|
9天前
|
人工智能 数据挖掘 开发工具
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
RAG中检索易召回冗余内容,Jev作为决策层可精准筛选高相关Chunk,替代简单Top-K输入。它支持多维度判断(如版本、时效性),提升Context质量与LLM答案准确性,降低幻觉与Token成本。(239字)
RAG 不一定需要大模型重排:Jev 能不能做 Context Filtering?
|
10天前
|
SQL 人工智能 安全
Agent Harness 又要多一层?Jev 开始接管这些高频判断
本文探讨Agent架构新范式:LLM专注复杂推理,而高频判断(如Tool/Skill路由、上下文过滤、安全守门、执行复核)可交由轻量级“System One Model”(如Jev)高效处理。这将重塑Agent Harness设计,推动分层智能协作。
Agent Harness 又要多一层?Jev 开始接管这些高频判断

热门文章

最新文章