长上下文代码评审的错觉:模型读完仓库,不等于读懂变更半径

简介: 本文揭示长上下文模型在代码评审中的认知盲区:读完仓库不等于读懂变更半径。枚举值修改引发多系统故障,暴露静态理解与真实影响间的鸿沟。提出四层影响图(静态依赖、运行调用、数据血缘、业务责任)和证据驱动的风险评估范式,强调测试工程师需从“写用例”转向“组织变更证据”。

长上下文代码评审的错觉:模型读完仓库,不等于读懂变更半径

结算服务把状态枚举从 SUCCESS 改成 SETTLED,代码智能体一次读完仓库,修改了 14 个文件,补齐了单元测试,PR 评审也没有发现明显问题。

上线后,客服后台仍按 SUCCESS 查询,已结算订单显示成“处理中”;离线报表把新状态归入未知值,风控补偿任务重复触发。仓库里该改的代码大多改了,真正漏掉的是仓库之外的变更半径。

image.png

长上下文解决了阅读量,没有解决工程事实

模型上下文越来越长,确实能一次读取更多文件、接口和测试。但软件系统的真实关系并不全部写在同一个仓库:还有运行时调用、消息订阅、数据仓库 SQL、低代码报表、人工运营规则和历史兼容客户端。

“模型读完了”很容易制造一种评审错觉:因为它能解释每一段代码,人们就默认它理解整个系统。实际上,解释文件属于静态理解;判断某个枚举会影响哪些真实消费者,属于证据驱动的变更分析。
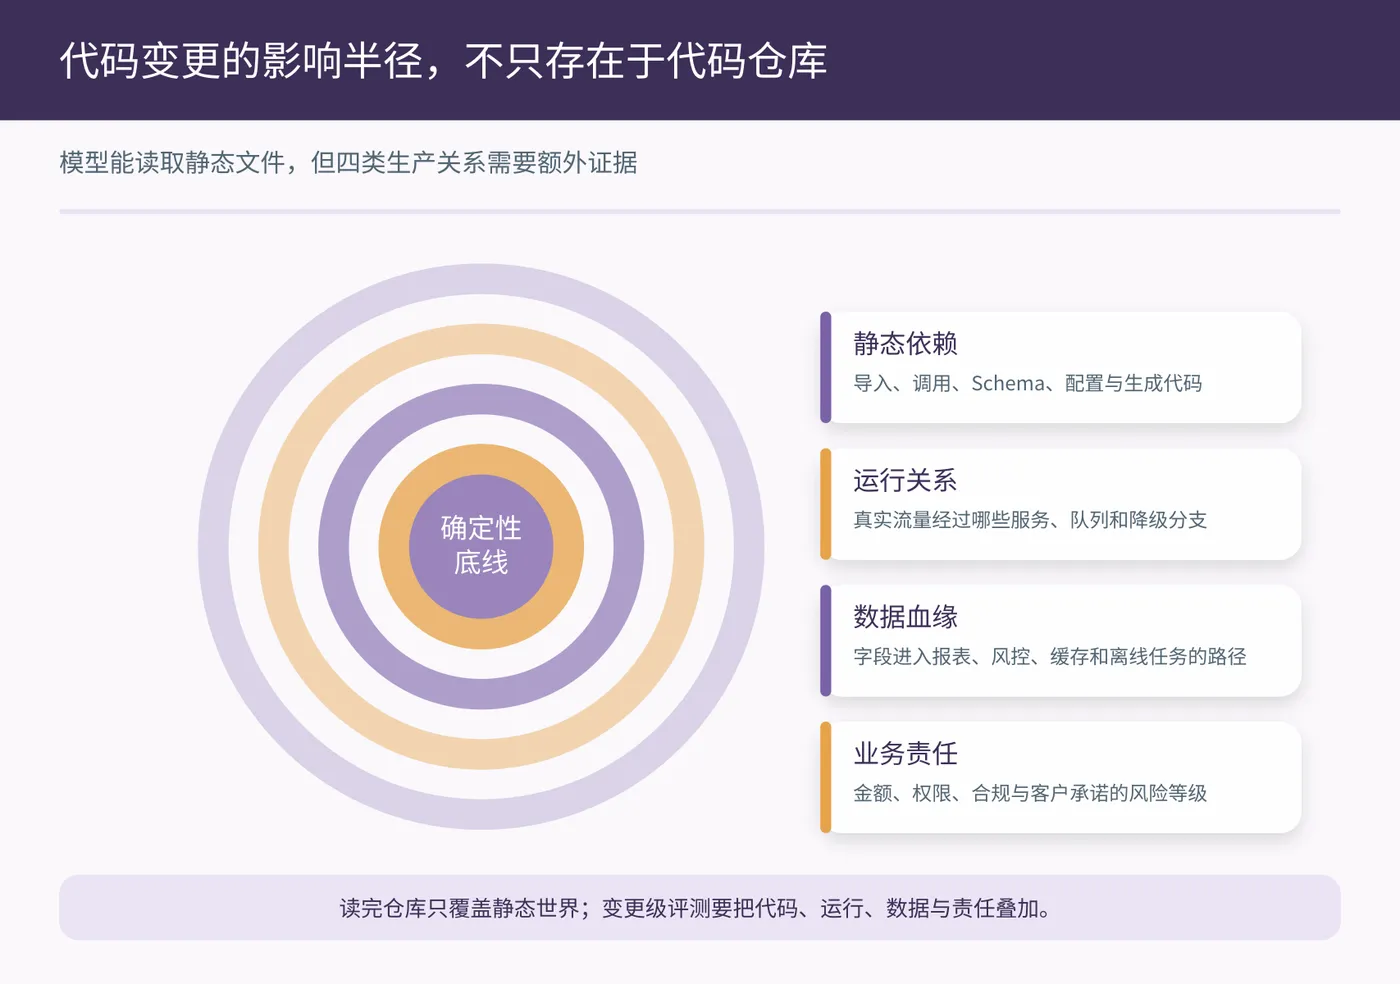
image.png

变更半径要由四种图叠加

第一层是静态依赖:符号调用、接口定义、Schema、配置和生成代码。第二层是运行关系:过去 14 天真实 Trace 中哪些服务走过这个分支。第三层是数据血缘:字段进入哪些主题、宽表、报表和离线任务。第四层是业务责任:它是否涉及金额、权限、客户承诺或不可逆动作。

可以先建立一个极简的风险排序器,不把全部希望寄托在模型的自然语言判断上:

from dataclasses import dataclass

@dataclass
class ImpactNode:
    name: str
    static_distance: int
    observed_calls: int
    data_consumers: int
    money_or_auth: bool
    recent_incidents: int

def impact_score(node: ImpactNode) -> float:
    proximity = 12 / max(node.static_distance, 1)
    runtime = min(node.observed_calls, 10000) ** 0.25
    lineage = node.data_consumers * 4
    critical = 25 if node.money_or_auth else 0
    history = min(node.recent_incidents, 3) * 8
    return proximity + runtime + lineage + critical + history

这个分数不是“智能预测”,而是把团队已经拥有的证据排成优先级。权重需要用历史事故校准;没有运行数据的节点不能当作零风险,应标记为“证据缺失”。

让模型生成用例之前,先给它一个影响清单

针对状态枚举变更,输入不应只有 diff。还要提供:下游消费者清单、过去真实状态序列、字段血缘、兼容窗口、P0 业务不变量和可用测试环境。让模型针对每个影响节点提出“风险假设—验证方式—需要的证据”,而不是直接吐出 200 条用例。

例如客服后台应验证新旧状态在兼容期内都能正确显示;报表应验证 SETTLED 计入已结算口径;补偿任务应验证未知状态不会默认重试;旧客户端应得到兼容映射或明确升级提示。

测试选择必须允许反证

如果系统声称某个消费者“不受影响”,应记录排除依据:它没有订阅该主题,还是 Trace 里没观察到调用?前者接近确定性证据,后者只是采样期内没看到,可信度不同。

可以把每个测试选择保存成结构化决策:

DECISION = {
   
    "change": "SettlementStatus.SUCCESS -> SETTLED",
    "consumer": "risk-compensation-job",
    "risk": "未知状态被当成失败并重复补偿",
    "evidence": ["consumer schema", "14-day trace", "incident-2026-041"],
    "test": "replay_success_and_settled_events",
    "oracle": "只产生一次补偿决策,最终账务不变",
    "owner": "risk-qa",
}
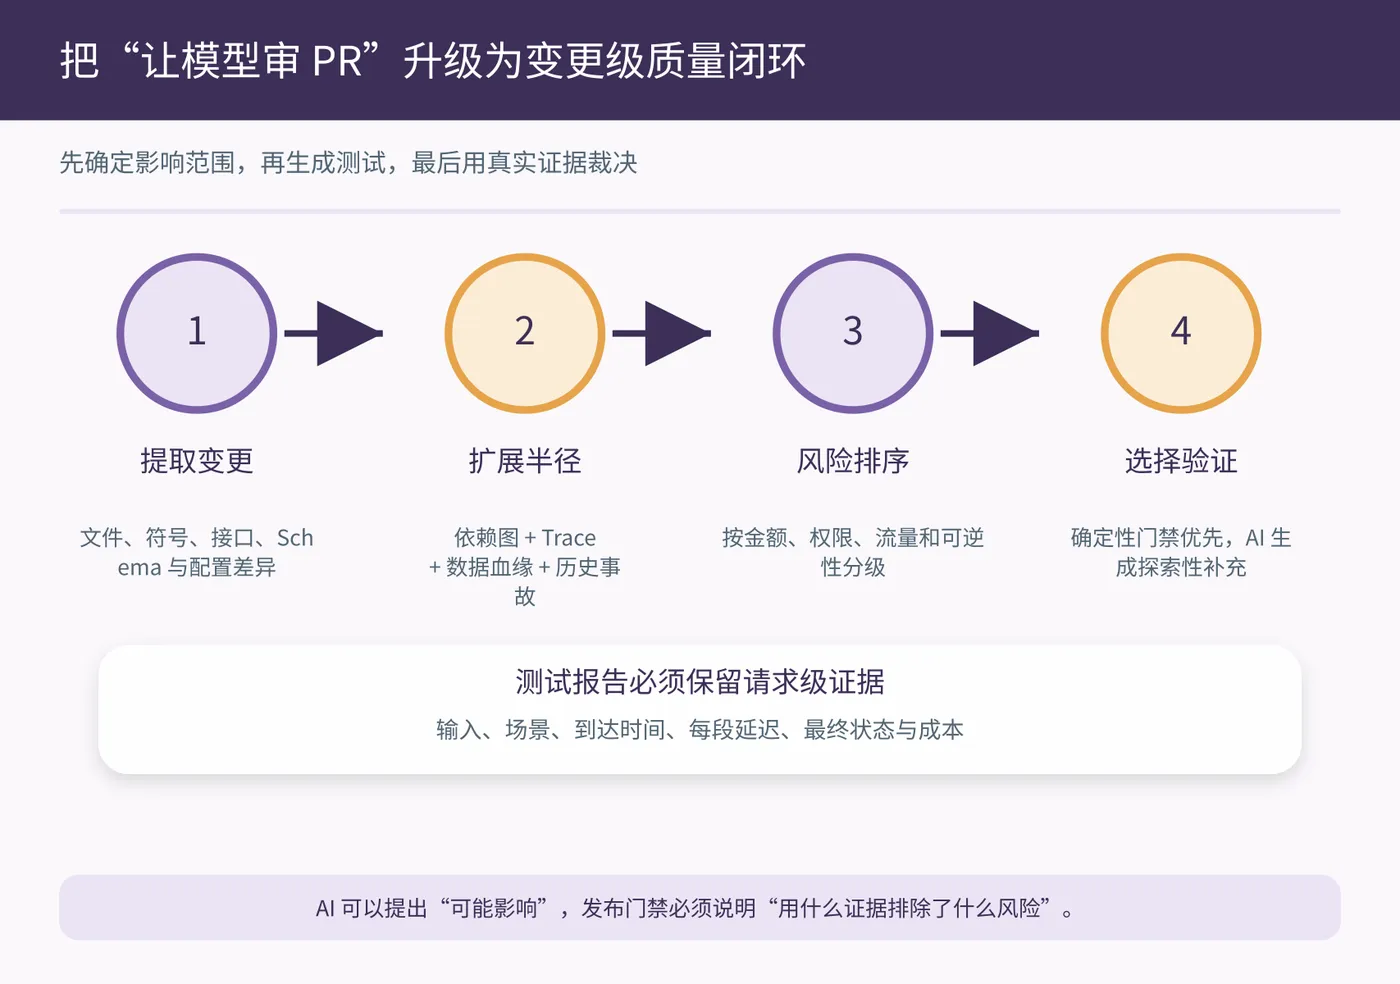
image.png

未来测试平台会从用例库转向“变更证据库”

当编码智能体能快速改几十个文件,测试团队的瓶颈不再是生成脚本,而是判断哪些风险值得验证、哪些证据足以放行。平台应围绕一次变更聚合 diff、依赖图、Trace、血缘、事故和测试结果,让人能回答:这次修改可能影响谁,哪些已经验证,哪些仍然未知。

模型在这里最适合做三件事:从多源证据提出候选影响,把事故语言映射到可执行验证,解释为什么某项风险需要人工决策。金额、权限、状态终态和副作用仍由确定性规则裁决。

测试工程师的新位置

长上下文不会让测试失去价值,反而会淘汰“以阅读文件数量为能力上限”的工作。测试开发要掌握代码依赖、可观测性、数据血缘、风险建模和自动化门禁,成为变更证据的组织者。

模型能读完整个仓库,是代码理解的起点;团队能证明一次变更的真实影响半径,才是发布决策的终点。在 AI 驱动研发里,后者会比生成更多用例更稀缺。

相关文章
|
1月前
|
数据采集 人工智能 搜索推荐
AI搜索优化内容判定机制与合规实践:避免被降权的三个信号
本文解析2026年央视315曝光“AI投毒”后,AI搜索引擎可信度评估机制的变革:强调语义一致性、跨平台数据校验与来源可核实性;提出合规内容生产的三大原则——标注出处、分平台改写、拆解为可验证信息块,并给出落地检查清单。
271 1
|
1月前
|
缓存 JSON API
阿里云千问Qwen3.8‑Flash深度解析:多模态能力、订阅计费规则、API接入配置与生产落地完整教程
Qwen3.8‑Flash是千问系列主打高速、高性价比的原生多模态基座,百万Token上下文窗口,支持图文视频输入,具备不错的代码能力、中等复杂度Agent工具调用能力,延迟表现优秀,非常适合高并发线上业务、知识库问答、轻量智能体、图文解析、代码辅助开发场景。
564 1
|
1月前
|
机器学习/深度学习 缓存 人工智能
Claude Fable 5.1 到底怎么样?扒完官方跑分和第三方榜单,说几句实话
Claude Fable 5.1 强在哪、贵不贵、值不值得换?这篇不跑实战,只把官方跑分、第三方榜单和定价对一遍,方便你选型时查
Claude Fable 5.1 到底怎么样?扒完官方跑分和第三方榜单,说几句实话
|
1月前
|
人工智能 运维 架构师
创新场景丨 人均代码产出提升 14.6%,亚信科技万人 AI Coding 跃迁之路
亚信科技深耕通信行业 30 余年,面临核心系统复杂、海量知识难以复用的挑战。通过引入 Qoder,将隐性专家经验转化为显性团队能力,构建 Agent 协同范式,实现近万名研发人员规模化 AI Coding 转型与效率提升。
|
1月前
|
存储 数据采集 算法
数据架构到底是什么?一篇讲清数据库、数仓、数据湖和数据中台
企业系统林立导致数据孤岛丛生:系统连不通、口径不统一、历史难追溯。本文深入解析数据架构本质——不是技术选型,而是构建“产生→采集→存储→加工→服务→应用”的全链路数据体系,并厘清数据库(记准业务)、数仓(统一分析)、数据湖(存原始多样数据)、数据中台(复用数据能力)的定位与协同关系。(239字)
|
1月前
|
人工智能 分布式计算 Serverless
EMR Serverless Daft 算子市场免费公测|10分钟极速实战(附视频教程)
Daft 算子市场公测来了!开箱即用的 AI 算子,覆盖 视频 / 图片 / 文本 / 音频 四大场景,搭配 Qwen3.7 大模型,零成本跑通 AI 数据处理全流程。 以训练一个能理解厨房操作的智能机器人为例,我们通常需要采集数千小时由人类佩戴摄像头拍摄的操作视频。然而,当这些视频被解码后,往往会膨胀为数亿张图像帧。更棘手的是,原始数据中充斥着静止画面、模糊镜头和无效空帧等海量“噪音”。如何从这些冗余信息中高效提取出高质量训练样本,已成为多模态技术发展的核心瓶颈。 本次实战将带您深入这一典型场景,借助 Daft 算子市场,一步步拆解并跑通从视频抽帧、数据清洗到高质量样本提取的完整链路。
246 0
|
1月前
|
存储 人工智能 JavaScript
阿里千问办公 QwenWork 怎么使用,新手入门操作步骤:写一份Q2项目报告输出Word文件
阿里千问办公QwenWork是一站式AI生产力平台,支持一句话完成数据分析、PPT生成、视频剪辑、网页搭建等复杂任务。通过多轮对话推进工作,集成网盘管理、扩展能力与网页发布功能,兼顾免费版与多档付费方案,助力个人及企业高效智能办公。阿里千问办公官网:https://t.aliyun.com/U/JNKJuO 阿里AI工作平台,一句话完成数据分析、PPT 生成、视频剪辑、网页搭建等复杂任务
|
1月前
|
人工智能 运维 Oracle
落地之道丨FDE,大模型落地的最后一公里
AI 落地的核心不在模型层,而在模型之下的执行层。
|
1月前
|
人工智能 IDE 程序员
千问办公、Qoder Teams、Qoder CN完整选型指南:定位差异、模型能力、计费活动与落地场景详解
随着AI智能体产品快速迭代,市面上同时出现千问办公、Qoder CN、Qoder Teams三款极易混淆的产品,很多开发者、企业采购人员经常出现选型失误,误购产品之后发现能力不匹配业务诉求。三者虽然底层共享部分大模型基座,但产品定位、能力侧重点、账号体系、计费模式、面向人群完全不同。Qoder CN偏向个人开发者AI编程智能体;Qoder Teams是Qoder CN对应的企业团队版本,面向研发团队多人协同开发;千问办公定位通用企业办公智能体,面向非研发岗位,聚焦文档处理、数据整理、业务流程自动化。
355 0
|
1月前
|
缓存 API 开发者
阿里云qwen3.7-flash大模型介绍:模型能力、模型价格、免费额度与最新活动
Qwen3.7-Flash选型与接入参考指南:本文聚焦这款兼顾性能与成本的原生视觉语言轻量模型,覆盖其多模态理解、Agent执行等核心特性,全维度工程化能力矩阵,低至0.02元/百万Tokens的阶梯计费规则,100%剩余、2026年10月23日到期的百万级免费额度,以及百万级上下文、高并发限流参数,配套OpenAI兼容模式的Python深度思考流式调用示例,同步梳理夜间折扣、满减券等专属优惠,帮助开发者快速完成选型与低成本落地。

热门文章

最新文章