Prompt engineering

简介: 本文介绍如何结合Markdown与XML优化提示词:Markdown用于结构化分节(如标题、列表),提升可读性;XML则通过标签及属性清晰界定内容边界与元数据。典型开发者消息含身份、指令、示例、上下文四部分,助力模型精准理解意图。(239字)

Message formatting with Markdown and XML
When writing developer and user messages, you can help the model understand logical boundaries of your prompt and context data using a combination of Markdown formatting and XML tags.

Markdown headers and lists can be helpful to mark distinct sections of a prompt, and to communicate hierarchy to the model. They can also potentially make your prompts more readable during development. XML tags can help delineate where one piece of content (like a supporting document used for reference) begins and ends. XML attributes can also be used to define metadata about content in the prompt that can be referenced by your instructions.

In general, a developer message will contain the following sections, usually in this order (though the exact optimal content and order may vary by which model you are using):

Identity: Describe the purpose, communication style, and high-level goals of the assistant.
Instructions: Provide guidance to the model on how to generate the response you want. What rules should it follow? What should the model do, and what should the model never do? This section could contain many subsections as relevant for your use case, like how the model should call custom functions.
Examples: Provide examples of possible inputs, along with the desired output from the model.
Context: Give the model any additional information it might need to generate a response, like private/proprietary data outside its training data, or any other data you know will be particularly relevant. This content is usually best positioned near the end of your prompt, as you may include different context for different generation requests.
目录
相关文章
|
23天前
|
人工智能 IDE API
阿里云Qoder CN服务平台完整功能解读:从本地IDE配置、终端CLI使用、云端部署到开放API全链路解读
软件研发工作包含需求拆解、代码编写、单元测试、故障排查、文档撰写、项目重构等大量重复性工作。传统开发模式下,开发者需要手动翻阅项目源码、查阅接口文档、调试报错堆栈,大型项目代码体量庞大,新人熟悉项目架构要耗费大量时间。普通代码补全工具只能完成单行片段生成,无法理解完整工程上下文,不能独立处理跨多文件的复杂开发任务。Qoder CN,前身是通义灵码,是面向软件研发全流程的AI智能体产品套件,不再局限于简单的代码片段补全,而是以编程Agent智能体为核心,覆盖本地桌面开发、终端命令行、云端托管运行、数字员工等多种形态,深度对接百炼平台Coding Plan、Token Plan订阅体系,支持Qwe
289 1
|
1月前
|
Oracle IDE Java
Java JDK下载、安装、配置、运行程序一篇搞定(2026实测)
本文详解JDK安装与配置全流程,涵盖JDK 8/11/17/21/25/26版本对比、LTS选型建议、Windows环境变量配置及首个Java程序编译运行,实操性强,零基础可快速上手。(239字)
|
1月前
|
机器学习/深度学习 人工智能 自然语言处理
2026测试人必备的"AI驯化"技能树:少了这个能力,简历直接被筛掉
2026年测试工程师正经历能力重构:从“写用例”迈向“驯化AI”。手工测试岗需求降47%,而懂AI Agent、Prompt工程、Skill封装、MCP协议与RAG知识工程的测试人才薪资高30%–50%,成大厂抢手对象。核心转变是——测试对象由确定性系统变为智能体,测试本质从“验功能”升级为“验能力”。
|
2月前
|
人工智能 弹性计算 API
Hermes Agent 安装接入阿里云百炼教程:按量 / Coding Plan/Token Plan 三种配置方案
Hermes Agent 是一款开源终端AI编程工具,支持按量计费、Coding Plan 或 Token Plan 团队版三种方式接入阿里云百炼大模型,具备自主规划、多工具调用与持续进化能力,开箱即用。阿里云Hermes官方部署教程:https://t.aliyun.com/U/EfvSK0
|
7天前
|
存储 人工智能 自然语言处理
阿里云千问办公 QwenWork详细介绍:产品核心能力、典型场景、价格及常见问题解答
阿里云千问办公(QwenWork)是通义实验室推出的AI原生办公平台,依托Qwen3.8大模型,支持自然语言生成PPT、Excel、网页、视频等;具备浏览器自动化、深度检索、钉钉/飞书集成、定时任务及多端协同能力,真正实现“对话即交付”。
334 2
|
2月前
|
人工智能
Qwen3.8抢先体验!正式版即将发布并开源!
千问Qwen3.8即将开源,参数达2.4T,进化速度以“天”计,实力媲美Fable 5。预览版Qwen3.8-Max已上线阿里Token Plan等平台,限时优惠:日间Credits低至1折,夜间更优,个人/团队版月付仅35元起!
4774 154
|
2月前
|
弹性计算 小程序 关系型数据库
一次真实录屏:我只说每月别超过 200 块,小程序后端就搭好了
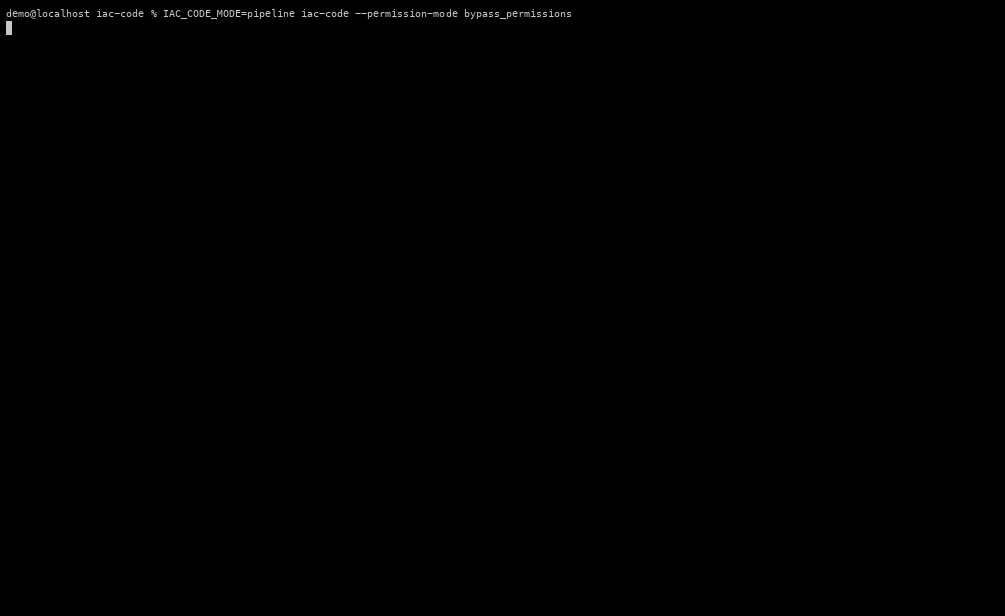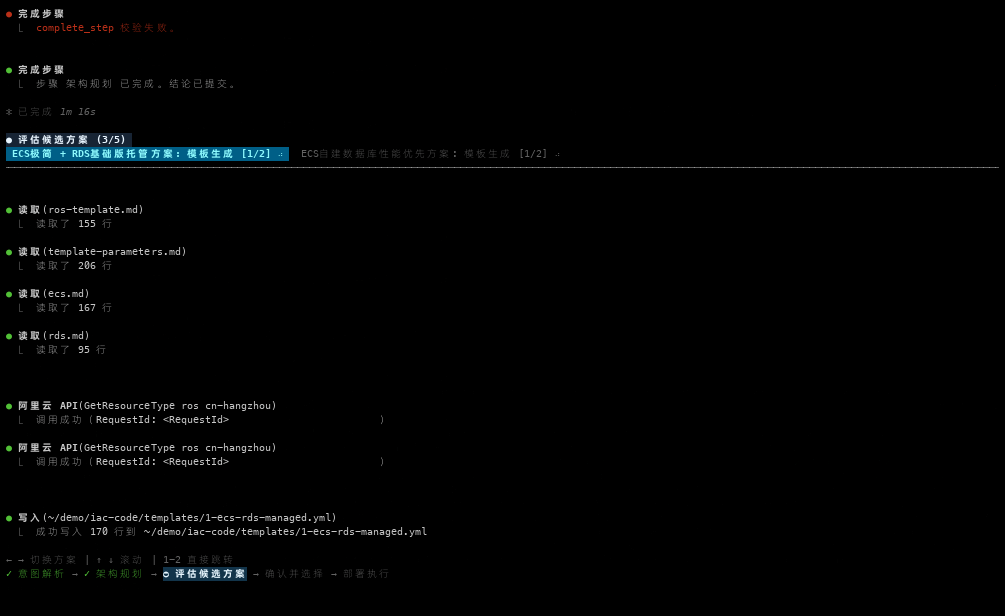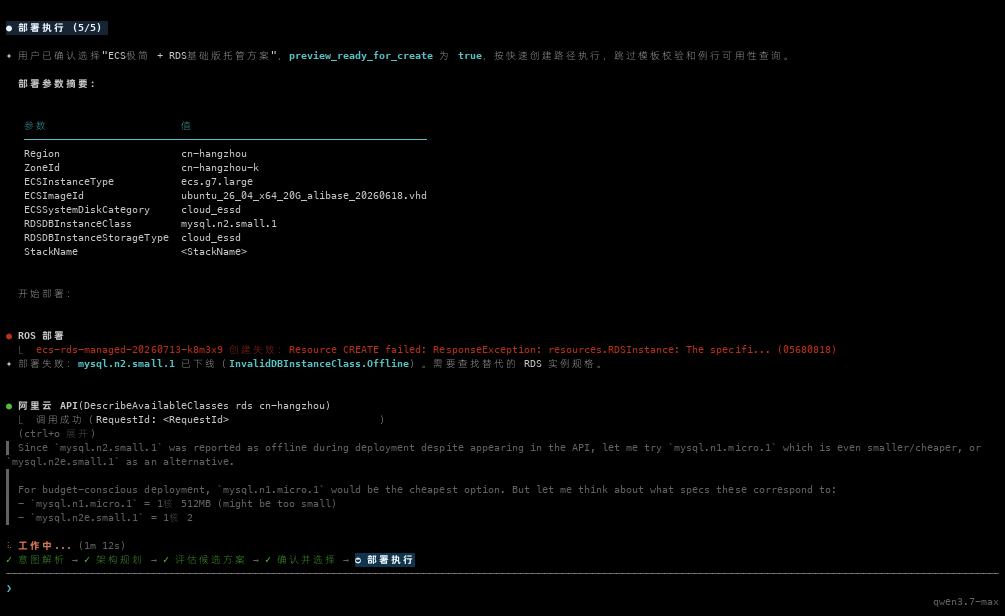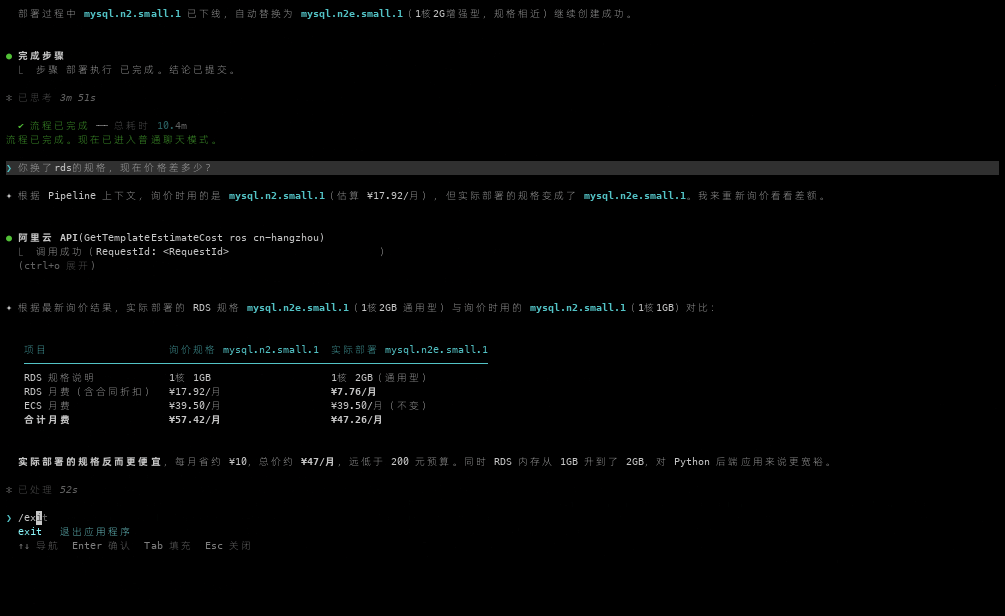
iac-code 通过自然语言交互,自动规划、创建并管理符合预算的小程序后端云资源。本文结合真实录屏,展示它如何准备多套方案、给出架构与费用、在创建前等待确认,并在 RDS 规格下线后自动处理、继续部署,大幅降低阿里云的使用门槛。
一次真实录屏:我只说每月别超过 200 块,小程序后端就搭好了
|
8天前
|
机器学习/深度学习 算法 前端开发
发动机故障诊断智能体(二):基础时序压缩与长短期记忆编码网络
在智能体完成气路多航段时序数据的采集与规整后,高维度的原始时序信号需要经过深度表征与降维处理,以消除高频测量噪声并提炼本质物理趋势。采用长短期记忆自编码器架构,在脱离人工标签监督的情况下,利用海量正常运行数据进行自监督重构训练,构建出能够压缩并表征发动机稳态工况与退化趋势的时序特征提取模型。
|
14天前
|
缓存 边缘计算 网络协议
AiWCLOUD:高防CDN,过移动屏蔽,免备案大陆节点不限内容技术选型避坑指南下
本文聚焦高防CDN选型与落地的关键技术细节,从性能基线、清洗机制、调度策略、CC防护、源站收敛、计费模型、灾备方案七大维度,提供可量化、可执行的评估清单,助力企业避开宣传陷阱,构建真正可靠的安全防线。(239字)
|
19天前
|
JSON 自然语言处理 前端开发
69][公共模块]Spring Boot 全局异常处理与参数校验实战(下):校验异常精细化处理与 WebFlux 适配
本文详解Spring Boot中校验异常的精细化处理,涵盖`MethodArgumentNotValidException`、`BindException`、`ConstraintViolationException`三大异常的统一提取与响应封装,并对比实现Servlet与WebFlux双环境适配,强调复用性、结构化错误输出及生产级最佳实践。(239字)
69 3