本文导读
Agent 犯一次错就补一条规则,看起来稳妥,最后却可能得到一份没人敢删、模型也难以判断优先级的项目档案。本文结合行间的维护经历,拆清 AGENTS.md 和 CLAUDE.md 应该留下什么、哪些内容应下沉到 Skill,以及怎样用真实行为验证规则是否有效。
这段时间维护「行间」,我干过一件很容易上瘾的事。
Agent 犯一次错,我就想补一条规则。
标题没有正确带到发布页,加一条。公众号预览的背景色被复制过去,再加一条。51CTO 正文图片上传失败,补一条。掘金草稿接口变了,继续补。每一条单独看都有理由,文件也确实越来越“完整”。
但规则写到一定程度后,新的问题来了。
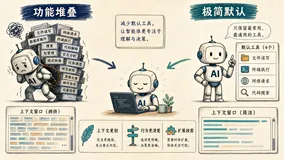
旧规则没有失效日期,相似要求散落在不同位置,有些描述的是业务目标,有些描述的是某次故障的临时补丁。Agent 每次开工都背着这一大包上下文,遇到冲突时还得猜哪一条更重要。
规则越多,Agent 反而越容易跑偏。
这听起来有点反直觉,但做过数据库参数治理的人应该很熟悉。参数不是越多越安全,默认值、会话级覆盖、实例级设置和历史遗留参数混在一起,最后往往没人敢确认当前到底哪一个生效。
AGENTS.md 和 CLAUDE.md 也会遇到同样的问题。
它们应该是 Agent 上岗前的交接单,不是项目档案馆。
先把边界讲清楚
CLAUDE.md 是 Claude Code 的持久项目指令,AGENTS.md 是 Codex 的项目指令。两者解决的是同一类需求:把那些无法只靠读代码可靠推断、又会反复影响任务结果的长期约定,提前交给 Agent。
但它们的加载方式并不完全相同。
根据 OpenAI 当前官方文档,Codex 启动时会构建一条指令链。它从项目根目录走到当前工作目录,每一层最多加载一个非空指令文件;同一层优先读取 AGENTS.override.md,否则读取 AGENTS.md。越靠近当前工作目录的规则越晚进入上下文,因此可以覆盖上层规则。默认合并大小达到 32 KiB 后就停止继续加入。
Claude Code 也支持不同层级的 CLAUDE.md,还可以通过 .claude/rules/ 把规则限定到特定路径。Anthropic 官方文档给出的原则很直接:指令越具体、越简洁,Claude 一致遵循的概率越高;多步骤流程或只对部分代码有效的内容,应该移到 Skill 或路径规则里。
所以,两种文件不能简单复制一份后改名。公共业务规则可以保持一致,但加载范围、覆盖方式和验证方法要按实际工具处理。
还有一个更重要的边界。
这些文件是指令,不是安全控制。
“禁止提交密钥”可以写在 AGENTS.md 里提醒 Agent,但真正的底线仍然应该由权限、密钥扫描、Hook、测试或 CI 拦住。“不要误删生产数据库”更不能只靠 Markdown 文件保证。
需要 Agent 理解和判断的,写进指令;绝对不能发生的,用程序兜底。
哪些内容应该留下
整理一份已经变长的 AGENTS.md,我现在会逐条问三个问题。
第一,这件事 Agent 能不能很快从项目里找到?
如果技术栈已经写在 package.json,测试命令就在 README,目录结构打开仓库一眼能看到,再抄进 AGENTS.md 只会制造第二份事实来源。半年后项目升级了,代码是新的,规则文件还是旧的,帮助就变成了误导。
值得留下的是隐性知识。
例如,行间的微信公众号只允许保存草稿,不能自动发布;其他平台通过发布助手直接发布;文章标题必须使用当前编辑页的标题,不能被历史发布任务覆盖;平台返回成功不等于文章已经公开,还要到官方列表回读确认。
这些约定散落在业务流程里,Agent 仅靠读一个组件很难完整推断,漏掉后代价又高。它们适合常驻。
第二,这条规则是不是大多数任务都需要?
只有掘金发布会用到的分类、标签和官方编辑器操作,不应该让每个前端样式任务都读取。只影响某个子目录的规则,就放到对应目录;只在发布任务中使用的长流程,就做成 Skill;大段背景资料放进独立文档,主规则只写什么时候去读它。
第三,三个月后它还成立吗?
“当前掘金草稿接口返回 err_no=2,暂时改走官方编辑器”属于一次具体故障的处理结果。真正长期有效的规则应该抽象成:平台接口失效时不得伪报成功,应保留官方草稿并返回可操作错误;没有稳定接口时优先使用平台允许的官方编辑流程。
前者会过期,后者才是长期约束。
删掉过期细节,不等于丢掉经验。关键是把一次故障里真正可复用的判断留下。
长流程为什么应该移到 Skill
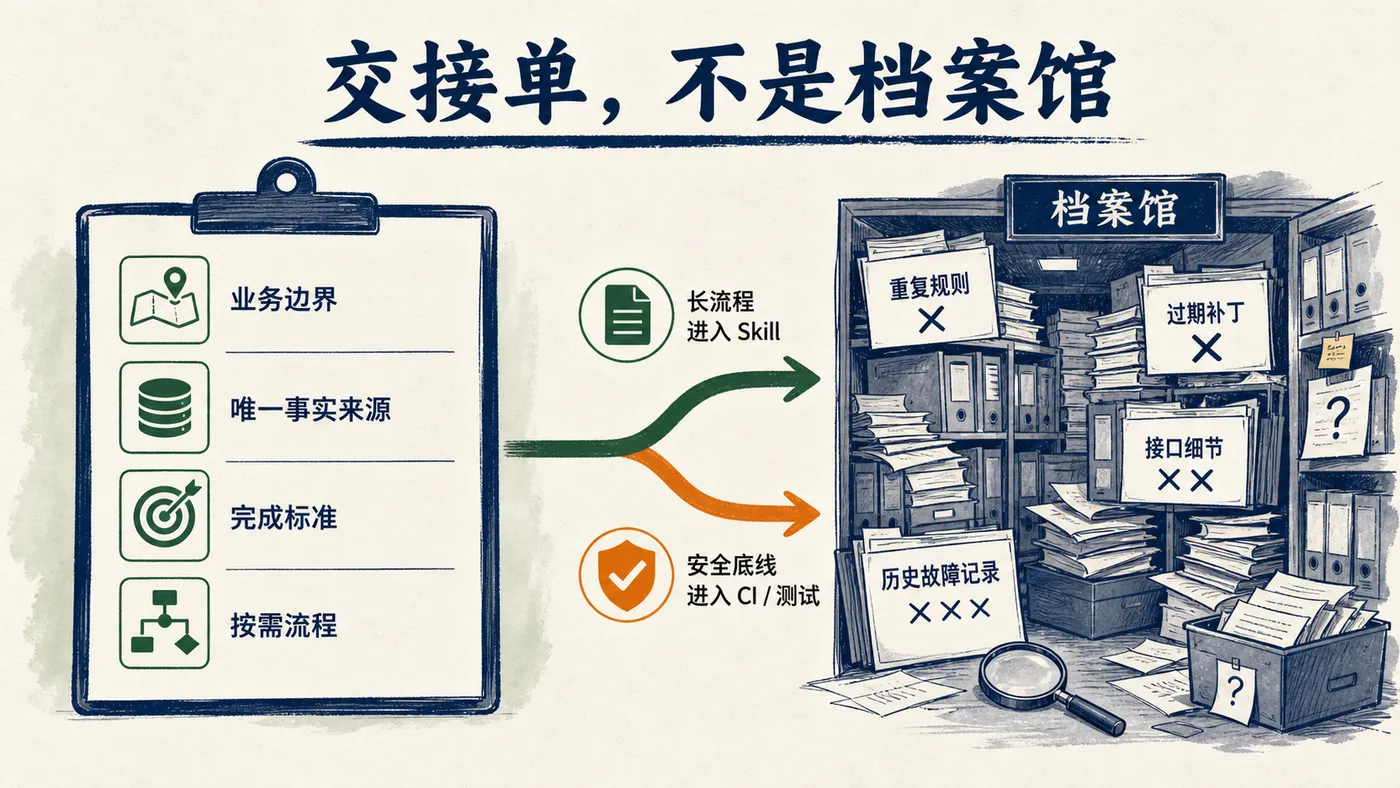
项目指令保留长期边界,长流程下沉到 Skill,安全底线交给 CI 和测试。
项目指令最容易膨胀的地方,是把完整操作手册全部塞进去。
以多平台发布为例,从文章母稿、图片准备、标题同步、账号检查,到逐个平台发布、回读、去重和错误恢复,流程很长,而且只在发布时使用。如果把所有细节都写进根目录 AGENTS.md,那么改一个按钮颜色,Agent 也要带着公众号和掘金的发布规则开工。
这就像让每个值班 DBA 上岗时,把所有数据库的升级手册、灾备手册和历史故障报告全部背一遍。
没必要。
根目录只需要留下路由规则:涉及多平台发布时,使用哪个 Skill;公众号只能存草稿;外部平台发布后必须回读验证;任何平台失败都不能把整批任务报告为成功。
真正的分平台步骤、接口字段和恢复流程放进 Skill,需要时再加载。
项目指令负责告诉 Agent 哪条路不能走,Skill 负责带它把某一类工作走完。
一份更实用的最小结构
AGENTS.md 不需要追求短到只有三行,但每一条都应该能改变行为,而且可以验证。
# 项目工作约定

## 业务边界

- 微信公众号只保存草稿,不自动发布。
- 其他平台只有在用户明确要求发布时才执行外部操作。

## 唯一事实来源

- 发布标题使用当前文章元数据,不从历史任务恢复旧标题。
- 平台状态以官方回读结果为准,本地缓存不能单独证明发布成功。

## 完成标准

- 修改发布适配器后,运行相关平台测试和生产构建。
- 平台失败时返回真实阶段和错误,不得记录为已发布。

## 按需流程

- 涉及文章写作与排版时,使用公众号文章 Skill。
- 涉及多平台分发时,读取发布工作流说明。
这份示例里没有项目技术栈、完整目录树,也没有每个平台的接口细节。不是因为它们不重要,而是它们有更合适的位置。
写完规则,别让 Agent 背一遍
很多人验证 AGENTS.md 是否生效,会问 Agent:“你读到了哪些规则?”
这只能证明它看见了文本,不能证明规则改变了行为。
更靠谱的办法是设计几个很小的真实任务。
让它修改一处文章标题,观察是否会覆盖历史任务中的旧标题;让它处理一个平台超时,观察是否会误记为发布成功;让它改一个只属于前端的样式,看看会不会无缘无故启动平台发布检查。
一次只触发一两条规则,问题才容易定位。
这和数据库变更验证一个道理。参数已经写进配置文件,不代表实例一定按你想的方式运行。最终要看行为和结果。
规则也需要做垃圾回收
一份长期指令文件不会真正写完。
项目在变,平台在变,Agent 的能力也在变。维护时不能只有新增,还要定期合并重复规则、删除过期补丁、处理层级冲突,再用真实任务验证留下来的内容。
OpenAI 对当前模型的提示建议也在强调精简:相同指令只写一次,删除重复说明,并用代表性任务重新评估。官方给出的内部评测结果显示,更精简的系统提示在部分编码 Agent 任务中同时降低了上下文和成本,效果反而更好。这个数字不能机械套到每个项目,但方向很明确。
AGENTS.md 不是写给未来考古的人看的。
它是今天这次任务开始前,Agent 必须带进现场的那张交接单。
交接单太少,容易漏事。交接单把整个档案室都抄进去,也一样会出问题。
真正要保留的,是代码里看不出来、会反复影响结果、长期成立,而且可以验证的那几条。
剩下的,该下沉就下沉,该做成 Skill 就做成 Skill,该交给 CI 的就别只写在 Markdown 里。
规则不是越多越专业。
能让 Agent 在关键位置少犯一次错,才算有用。
本文小结
一份好用的 AGENTS.md,不追求覆盖项目的全部知识,只保留代码里看不出来、会反复影响结果、长期成立而且能够验证的约定。局部规则放到对应目录,长流程下沉到 Skill,安全底线交给权限、测试和 CI;规则文件本身也要定期清理过期补丁。