IndexTTS · 哔哩哔哩开源的零样本语音合成模型
日语版的旁白,声音不是你了
你做科普视频,中文那期数据不错,想顺手出个日语版和西语版。稿子翻好了,卡在配音。
找母语配音员,一条报价几百块,还要等对方排期,改一个词就得重新约。你试了云端 TTS,能出日语,但只能从平台预设的几个音色里挑——观众听中文版认得你的声音,点开日语版换成一个陌生的播音腔,评论区第一条就是"这不是原来那个人吧"。而且文本要传到别人服务器、按字符计费,你改了三版稿子,就付了三次钱。
于是这件事就一直挂在"以后再说"里。
给它 15 秒你的录音
IndexTTS 是一个零样本语音合成模型:给它一段十几秒的参考音频,它就用这个音色把文本读出来——中文、英文、日语、西语、阿拉伯语都行,音色不跟着语言换。
它不需要你为自己的声音训练一个专属模型,参考音频当场生效。情感、语速、发音可以和音色分开控制:同一个声音,你能让它高兴地说、难过地说,或者慢一点说。
边界也说清楚:
- 它做:零样本声音克隆、中英日西阿五语种合成、情感与语速控制、拼音/CMU 音素/日语假名级别的发音校正、浏览器里点着用的 WebUI 和可脚本调用的 Python API
- 它不做:不做语音识别,也不是实时对话系统——它把文本变成音频文件,不负责听懂你说话;参考音频要你自己提供,它不自带音色库
- 授权边界:模型遵循哔哩哔哩模型使用许可协议(不是 Apache/MIT 这类宽松协议),商用前请自行核对条款;克隆他人声音必须取得本人授权
通过阿里云计算巢部署,几分钟开箱可用。模型权重在镜像构建阶段就预置好了,部署完不用再下几十 GB 的 checkpoint,也不用配 CUDA 和 Python 环境。
它解决了什么问题
| 你原来怎么干 | 代价 | 用它之后 |
|---|---|---|
| 找配音员录日语版 | 一条几百块,等排期,改词重约 | 上传自己的中文录音,直接生成日语版 |
| 用云端 TTS 的预设音色 | 各语言版本音色不统一,观众认不出 | 五个语种共用一个音色,是你自己的声音 |
| 自己录 | 要安静环境、要重录、嗓子和状态不稳定 | 一段干净的样音复用到所有内容 |
| 按字符计费 | 改一版付一次,改稿变成成本决策 | 跑在自己的 GPU 服务器上,改多少版都是那台机器的时间 |
| 本地装环境跑开源模型 | 装 CUDA、装 uv、拉几十 GB 权重,网络慢时半天下不完 | 模型预置在镜像里,部署完打开网页就能合成 |
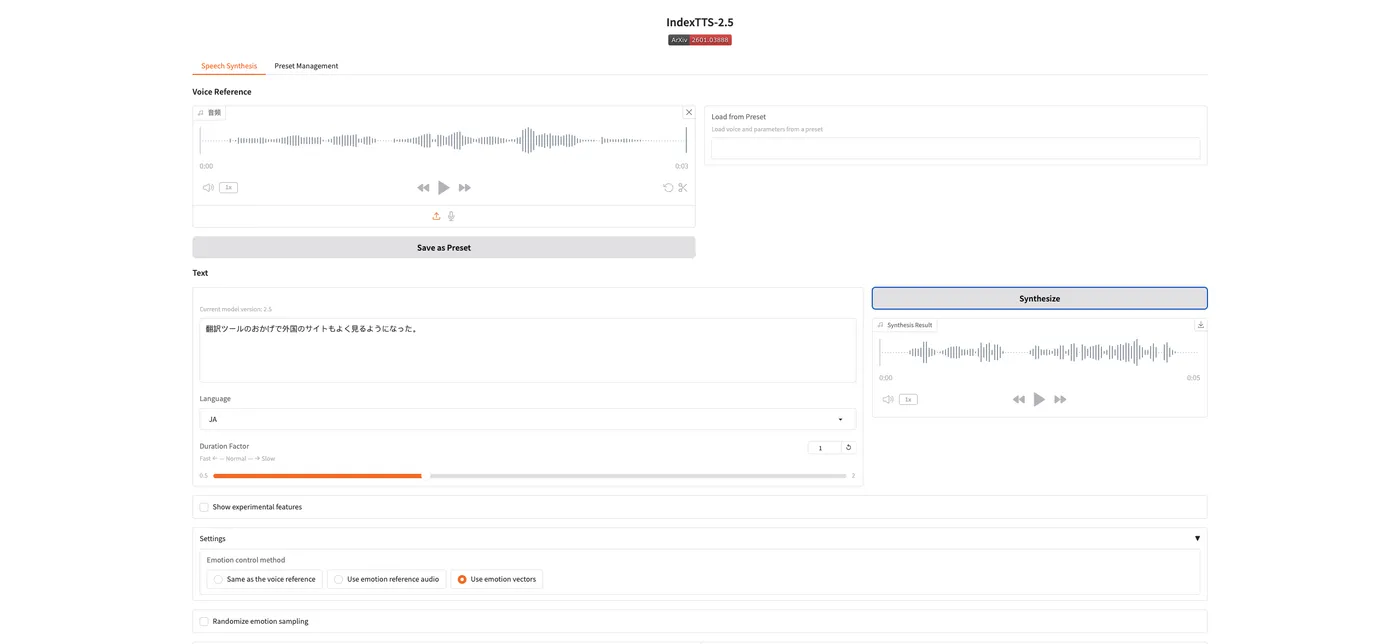
回到开头那期视频:你把之前录中文时的一段 15 秒干声传上去,日语稿贴进文本框,语言选 JA,点一下生成——旁白出来了,还是你的声音。西语版同样一遍。翻译改了个词,重新点一次就行。
而更深一层的变化是:配音从"一次性外购的成品"变成"随时能改的素材"。以前多语言版本得先算值不值得投入,所以你只在爆款上做;现在它不再是一笔要立项的支出,每期都能顺手出,稿子改了也不用心疼重录费——你的音色,第一次真正成了自己能支配的资产。
核心能力
一段样音,音色就归你了
对应上面最难的那步:让不同语言的版本听起来是同一个人。
- 零样本克隆 —— 不用为每个音色单独训练,5~15 秒清晰单人录音当场就能用
- 跨语种保持音色 —— 音色和语言解耦,中文样音可以拿去说日语、西语,不是换个语言就换个人
- 音色存成预设 —— 参考音频连同参数一起存下来,下次直接调用,不用每次重新上传找参数
情绪和快慢分开拨
同一段文本,你要的不只是"读出来",而是"这句该是什么语气"。
- 三种情绪给法 —— 跟着音色走、单独上传一段情绪参考音频,或者直接拉八个情绪滑块(开心/生气/难过/害怕/厌恶/低落/惊讶/平静)
- 从文本自动推情绪 —— 不想手调时,让它读懂句子本身的情绪
- 语速可调 —— 时长因子 0.5~2.0 倍,同一句话可以拉长也可以压紧
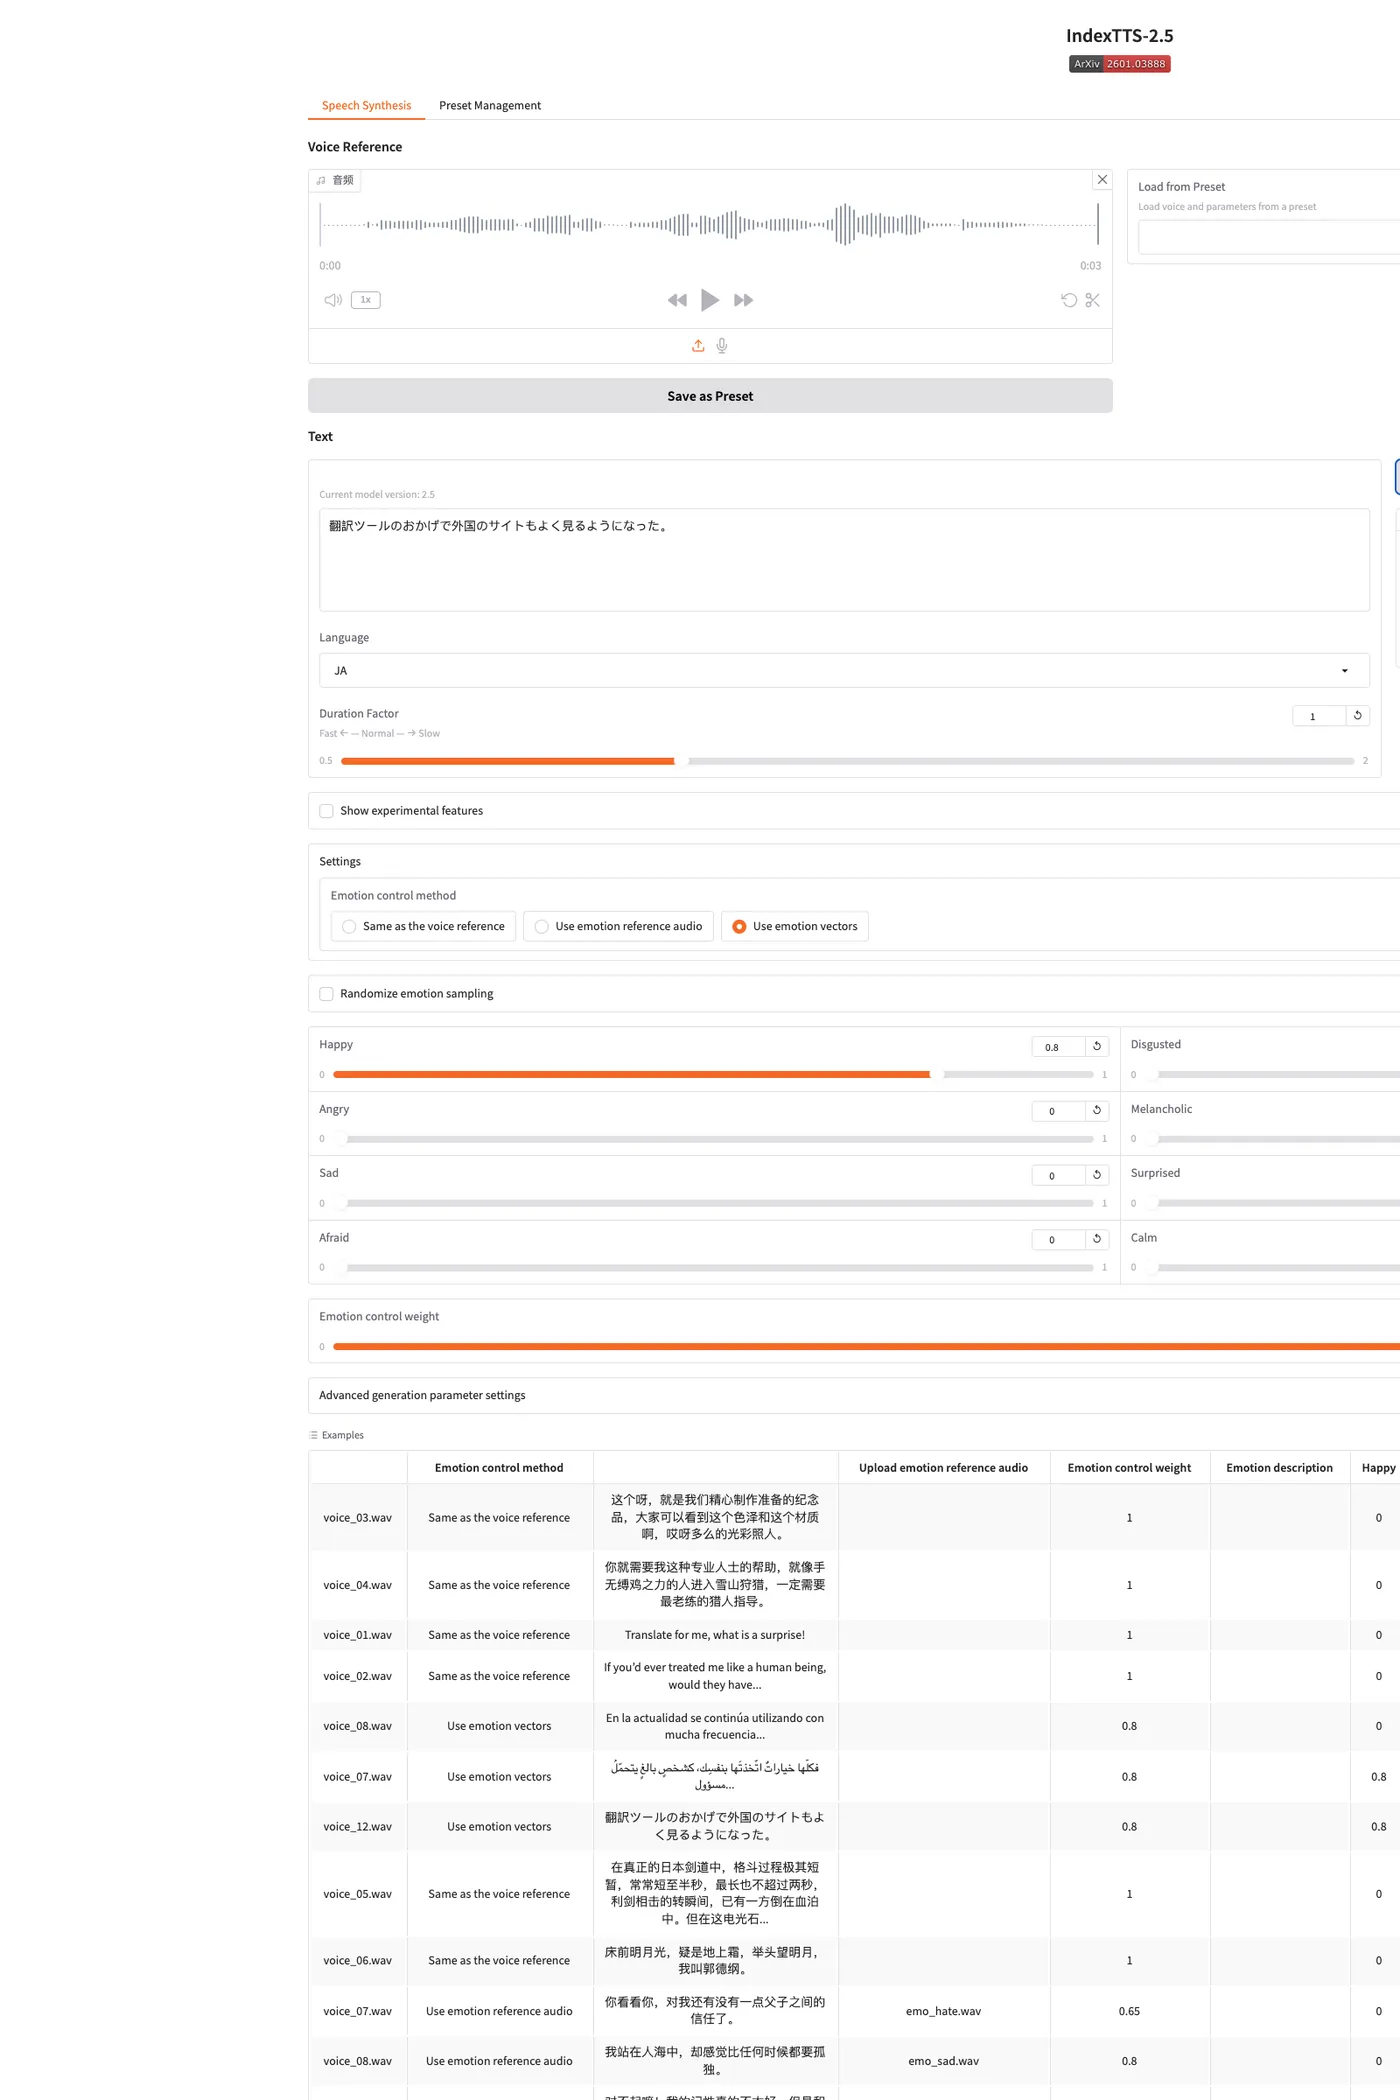
从点着用到接进流程
先在网页里试出满意的参数,再把它接到你的生产流程里。
- 网页里直接用 —— 上传、填字、生成、试听、下载,不写一行代码
- Python API 批量跑 —— 参数和网页里一一对应,试好之后可以批量处理一整季的文稿
谁最该用
| 用户类型 | 典型场景 | 用它拿到什么 |
|---|---|---|
| 做内容出海的创作者 | 中文视频要出日语、西语版本 | 各语言版本共用自己的音色,不用请配音员 |
| 有声书 / 播客制作者 | 长篇文稿配音,多角色不同情绪 | 一个音色配一个角色,情绪逐句调,改稿重生成 |
| 做课程和培训的团队 | 课件更新频繁,每次改动都要重录 | 音色固定下来,改哪段重新生成哪段 |
| 需要数据不外传的团队 | 文稿涉及未公开内容,不能传到第三方 | 模型和音频都在自己的 ECS 上,文本不出服务器 |
为什么在计算巢上跑
| 维度 | 自己搭 | 在计算巢上跑 |
|---|---|---|
| 环境 | 装 CUDA 12.8+、装 uv、uv sync --all-extras 拉齐依赖 |
一键部署,环境已经装好 |
| 模型权重 | 从 HuggingFace 或 ModelScope 拉几十 GB,国内还得换镜像源 | 权重预置在镜像里,部署完即可推理 |
| GPU | 自己找卡、装驱动、验 nvidia-smi |
部署时选 GPU 规格,驱动已就绪 |
| 访问 | 自己开端口、配安全组、想想怎么暴露 WebUI | 实例详情页直接给 WebUI 访问地址 |
| 地域 | —— | 杭州、上海、深圳、香港、新加坡 5 地可选 |
| 数据归属 | —— | 文稿、参考音频、生成结果都在你自己的 ECS 上 |
技术支持
- 官方仓库:github.com/index-tts/index-tts
- 模型下载:ModelScope IndexTeam / HuggingFace IndexTeam
- 问题反馈:GitHub Issues
🚀 立即体验
→ 一键部署 IndexTTS
部署完成后,在服务实例详情页的输出里点开 WebUI 地址。第一件该做的事:传一段自己十几秒的干声,随便打一句话试着生成一次——首次合成会加载模型,等一会儿是正常的。