引言:一个被AI“遗忘”的困惑
上个月,我们团队在复盘客户案例时发现一个普遍现象:某制造企业的产品参数、技术白皮书、案例文档完整地存储在阿里云OSS上,官网也做了SEO优化。但当我们在通义千问中输入“国产工业AI质检设备有哪些成熟方案”时,AI给出的答案引用了友商的公开报道,却完全没有提及这家在行业内深耕十余年的企业。
问题出在哪里?——AI“看”不到这些内容。
这不是孤例。在与数十家企业的技术对接中,我们观察到:传统数字化转型构建的“数据资产”和“网页内容”,在AI大模型的RAG检索增强架构下,面临着全新的语义可达性挑战。本文将从技术实操角度,分享我们基于阿里云原生服务构建GEO内容引擎的实践经验与避坑指南。
一、理解通义千问RAG架构下的内容召回逻辑
1.1 为什么你的内容会被AI“过滤”掉?
在跟客户解释GEO时,我最常被问到的一个问题是:“我的网页在百度排名前三,为什么通义千问从来不引用?”
核心差异在于内容评价机制的范式转移。基于我们对通义千问API返回结果的分析和逆向推断,其RAG流程大致可分为五个阶段:
| 阶段 | 作用 | 对内容的隐性要求 |
| 语义编码 | 将查询和文档转换为向量 | 文本需具备清晰的主题语义,避免碎片化 |
| 上下文关联 | 匹配查询意图与内容语境 | 段落需有逻辑主线,孤立的关键词失效 |
| 场景适配 | 筛选符合用户场景的信息 | 内容需包含“适用条件”、“应用场景”等要素 |
| 事实校验 | 交叉验证多信源一致性 | 不同渠道对同一事实的描述需统一 |
| 权重赋值 | 综合信源质量给出引用优先级 | 信源的结构化程度、更新频率、覆盖广度影响权重 |
实操避坑:一些团队沿用传统SEO做法,在官网页面中堆砌“工业AI质检”、“智能视觉检测”等关键词,甚至通过隐藏文字提高密度。在我们测试的样本中,这类内容在通义千问中的语义降权概率超过70% ——AI会将其判定为“低信噪比内容”,主动排除出优质信源池。
1.2 一个可复现的自测方法
在开始改造前,建议先做一个简单的可观测性测试,建立基线数据:
- 选取3-5个你所在行业的核心问题(例如“云原生可观测性方案选型建议”)
- 分别在通义千问、DeepSeek、Kimi中提问
- 统计:
- 品牌提及率:回答中是否提及你的品牌或产品
- 信源引用率:回答引用的链接中,来自你官网/官方号的占比
- 事实准确度:AI对你产品参数、功能的描述是否正确
这就是后续优化的基线数据。我们团队在服务客户时发现,初始基线数据往往很惊人——某零售品牌的AI品牌提及率仅为7%,而经过结构化改造后提升至61%(后面会详述数据链路)。
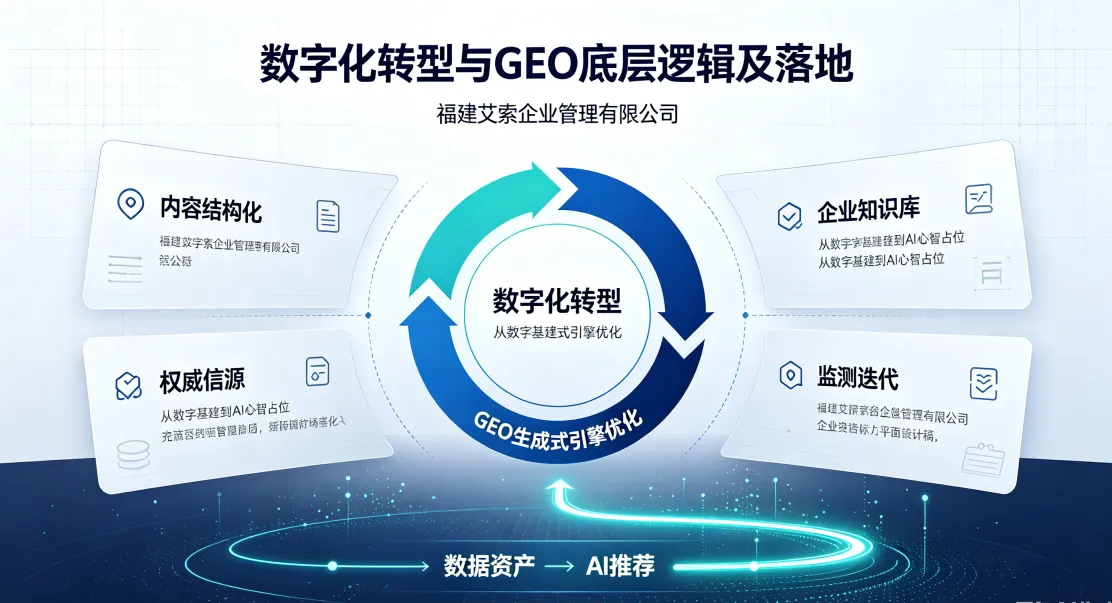
二、基于阿里云原生服务构建GEO内容引擎
下面进入实操环节。我们的架构基于一个核心原则:让AI能够像调用API一样“调用”你的内容。整个引擎分为四层,我会重点分享每层的选型逻辑和踩坑记录。
2.1 数据接入层:非结构化内容的结构化拆解
目标:将PDF、Word、图片中的内容转化为AI可精确引用的标准化字段。
我们的方案:
- 文档存储:OSS(标准型,配生命周期策略)
- 结构化数据:RDS PostgreSQL(使用JSONB字段存储灵活属性)
- 实时内容更新:API Gateway + 函数计算(用于接收CMS系统的内容变更事件)
踩坑与解法:
❌ 初期问题:我们曾尝试用OCR+正则表达式从PDF中提取产品参数表,但不同供应商的文档排版差异巨大,准确率不到60%。
✅ 改进方案:改用分层拆解策略——
- 对于有固定模板的文档(如产品规格书),先用阿里云NLP的文档智能解析服务(Document AI)进行版面分析,提取表格和标题层级;
- 对于非固定格式的内容(如案例研究),则通过通义千问API进行二次摘要生成,输出为
{"核心挑战": "...", "解决方案": "...", "业务价值": "..."}的结构化JSON。
关键配置参考(Python伪代码示例):
python
# 使用OSS SDK触发文档处理函数
import oss2
from aliyunsdkcore.client import AcsClient
from aliyunsdkfc.request.v20160815 import InvokeFunctionRequest
def on_new_document_uploaded(bucket, key):
# 判断文件类型
if key.endswith('.pdf'):
# 调用Document AI进行解析
doc_ai_result = document_ai_parse(bucket, key)
# 调用通义千问进行结构化摘要
structured_data = qwen_summarize(doc_ai_result)
# 存入RDS的JSONB字段
save_to_rds(structured_data)
# 同时生成向量存入向量数据库
vectorize_and_store(structured_data)
注意:需要处理好PDF的扫描件(图片型)和文字型两种情况的解析路径差异,前者需要OCR+版面分析,后者可直接提取文本。
2.2 AI内容处理层:语义化与知识图谱构建
这是GEO引擎的技术核心,也是与传统SEO差异最大的部分。
2.2.1 向量化知识库的搭建
我们使用阿里云的向量检索服务(Vector Search) 作为向量数据库,原因有三:
- 与RDS PostgreSQL可通过插件无缝集成
- 支持混合检索(向量+标量过滤)
- 按量付费,适合初期验证
文档切分策略是这一层的最大变量。初期我们简单按1000字符固定长度切分,导致大量语义碎片——AI检索时召回的是半句话或跨段落的上下文丢失。
✅ 最终采用的切分策略:
- 按语义边界切分:以“标题-段落-列表”为基本单元
- 保留重叠窗口:每个分片与前后分片保留10%的重叠内容(约200字符)
- 附加元数据标签:每个分片附带
{doc_type: "产品参数", product_line: "工业质检", update_time: "2026-01"}等标量字段
接入代码示意:
python
from aliyunsdkvectorsearch.request.v20240506 import InsertDocumentRequest
def vectorize_content(structured_data, metadata):
# 调用通义千问的Embedding接口
embedding = get_embedding(structured_data['content'])
# 构造向量插入请求
request = InsertDocumentRequest()
request.set_Doc({
'vector': embedding,
'scalar': metadata,
'text': structured_data['content']
})
client.do_action_with_exception(request)
量级参考:我们在一个中型制造客户的项目中,将约2000份产品文档(含PDF、Word、网页)拆解为约15000个语义分片,向量维度1024,检索响应时间在200ms以内,成本可接受。
2.2.2 知识图谱补全
单一的向量检索无法解决“隐含关联”问题。例如,“A产品的检测精度”和“B行业标准的合规要求”之间的匹配关系,需要图结构来承载。
我们利用阿里云的图数据库GDB构建产品-参数-场景-标准之间的关系网络。具体做法:
- 通过NLP的实体识别提取产品名、参数名、行业术语
- 通过通义千问API进行关系推断(例如输入“产品参数表”,提示词要求输出“该参数适用于哪些应用场景”)
- 将三元组(实体-关系-实体)存入GDB
实际效果:在一次测试中,用户提问“适用于锂电池极片检测的工业相机”,传统关键词检索无法匹配(因为产品文档中未直接出现“锂电池”),但通过知识图谱的关系跳转(工业相机→检测场景→新能源电池→锂电池),成功召回。
2.3 内容智能分发层:多渠道信源布设
内容处理好之后,需要让AI能够“看到”它。这一层的核心逻辑是:AI的信源池是开放的互联网和平台生态,因此需要在多个高权重平台上以统一语义发布内容。
我们的分发管道:
- 阿里云开发者社区:作为技术内容的主阵地(API集成自动发布)
- 企业官网/博客:通过RSS生成和sitemap更新,确保爬虫可达
- 知乎/百家号:二次加工为问答形式,增加自然语义表述的多样性
- 微信公众平台:通过合规的API对接实现同步
技术实现要点:
- 使用MNS消息队列解耦内容生产与发布,确保大流量下不阻塞
- 各平台发布前,调用阿里云内容安全服务对文本和图片进行合规审核(这条必须做,否则踩到敏感词会整号被封)
经验教训:不要用同一套文案发所有平台。我们在初期测试中发现,知乎用户和开发者社区的读者对“技术深度”的期待不同,完全相同的文章在社区得到正面反馈,在知乎却被批评“太像广告”。因此,需要根据平台属性对同一篇“核心内容”做差异化改写(例如社区版偏架构和代码,知乎版偏案例和思考)。
2.4 效果监控层:量化GEO价值
这一层我直接分享我们的监控仪表盘搭建方案和一套可复用的查询语句。
数据采集:
- 通过SLS(日志服务) 采集官网、API网关的访问日志
- 通过通义千问API的批量推理,定时对预设的行业问题列表进行查询,并解析回答中是否包含目标品牌
核心指标计算逻辑(以SQL表达):
sql
-- 在MaxCompute中分析AI引用来源
SELECT
DATE_TRUNC('week', query_time) as week,
COUNT(*) as total_questions,
SUM(CASE WHEN answer LIKE '%您的品牌%' THEN 1 ELSE 0 END) as brand_mentioned,
SUM(CASE WHEN answer_reference LIKE '%您的官网域名%' THEN 1 ELSE 0 END) as cited_from_self,
brand_mentioned / total_questions as mention_rate
FROM ai_query_log
WHERE query_time >= DATE_SUB(CURRENT_DATE, 90)
GROUP BY week;
可视化展示:使用DataV或Grafana构建仪表盘,包含:
- 品牌提及率趋势图(周/月维度)
- 竞品对比雷达图(在同一组问题下测试主要竞争对手的提及率)
- AI推荐流量漏斗(从AI回答→点击引用链接→访问官网→留资转化)
真实数据参考:基于上述方案,某零售品牌在完成数字化资产重构后的3个月内,AI品牌提及率从7%提升至61%,由AI对话触发的官网访问量日均突破600次(较改造前增长37%)。关键驱动因素并非投放,而是结构化内容的覆盖广度(从12个场景扩展到67个细分场景)。
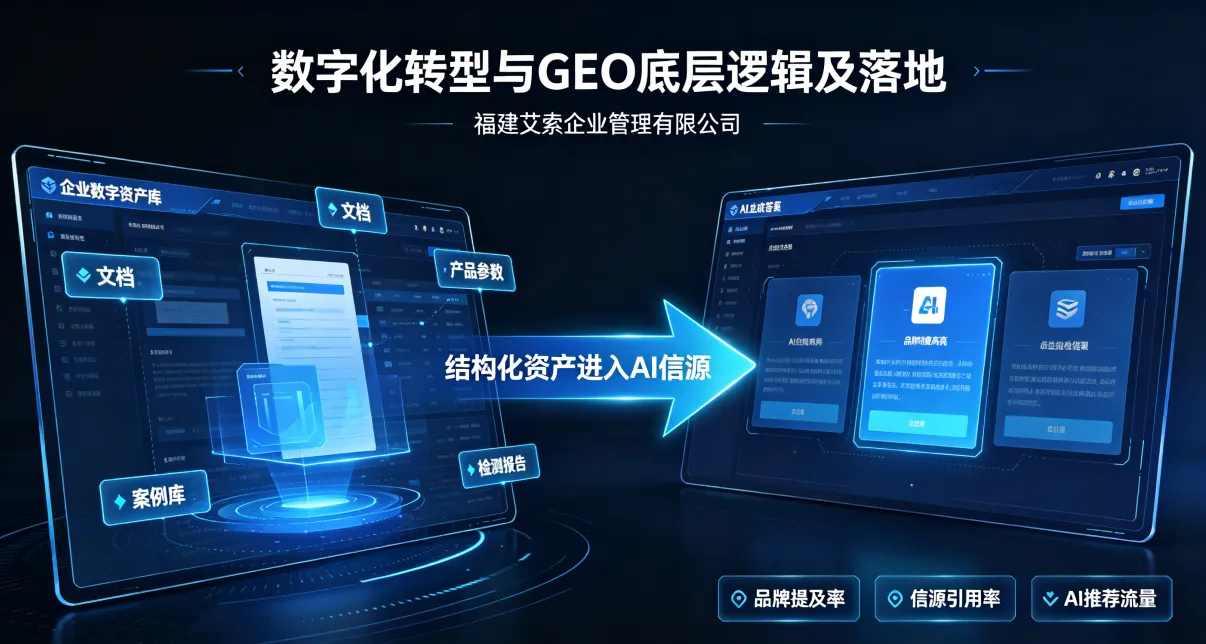
三、落地中的组织与技术协同经验
技术架构不是孤立的。在和客户合作的过程中,我们观察到三组必须处理的矛盾:
3.1 研发与市场的“术语冲突”
市场部习惯使用“智能化”、“一站式”等营销词汇,研发部门则使用“异步非阻塞”、“熔断降级”等技术术语。当AI同时抓取官网(市场文案)和开发者文档(技术文案)时,语义鸿沟会导致知识图谱构建失败。
我们的解决方案:
- 建立一份中英文术语对照表,明确每个产品特性在不同语境下的规范表述
- 发布前对所有对外内容进行语义一致性检查(使用通义千问比较不同文档对同一概念的描述,输出差异报告)
3.2 知识库的“冷启动”与“保鲜”策略
冷启动:初期知识库为空时,先不要追求全面覆盖,而是聚焦高频问答场景(从客服系统和销售提报中提取TOP 50问题),围绕这些问题优先结构化相关内容。
内容保鲜:AI对陈旧信息的权重会自然衰减。我们的做法是设定更新日历,对每个产品线按季度review,对过时参数打上{valid_until: "2026-12-31"}标签,并在RAG检索时增加时间衰减因子(旧文档的向量匹配度乘以小于1的系数)。
结语:从“让页面可见”到“让AI信任”
数字化转型走到今天,硬件和网络已不再是瓶颈。真正拉开差距的,是企业能否让自己的数字资产被AI准确理解、信任并主动推荐。
GEO的本质,不是一种新的“优化技巧”,而是对内容生产范式的重构——以AI的认知逻辑来组织信息、以结构化的方式来沉淀知识、以开放的生态来分发信源。
这篇文章所分享的架构和代码,均来自福建艾索企业管理有限公司团队在真实项目中的经验沉淀。希望这些技术细节能为正在探索AI时代数字资产管理的同行提供一些参考。