
企业做数据分析时,最容易被低估的环节,往往不是建模,也不是做可视化,而是数据清洗。同一个客户被录入三次,手机号前后带空格,订单金额出现负数,日期字段中混入“暂无”,已经取消的订单仍被计入销售额……这些问题看起来只是几行脏数据,一旦进入指标计算,就可能造成客户数虚高、销售额重复、平均值失真、部门数据无法核对。
更麻烦的是,很多数据问题并不会直接报错。SQL可以正常执行,报表也能正常刷新,但最终结果是错的。等业务部门发现数字异常,再回头排查数据源、加工逻辑和统计口径,往往已经消耗了大量时间。
所以,数据清洗不是简单删除错误记录,而是按照明确的业务规则,把原始数据转换成完整、一致、准确、可追溯的数据。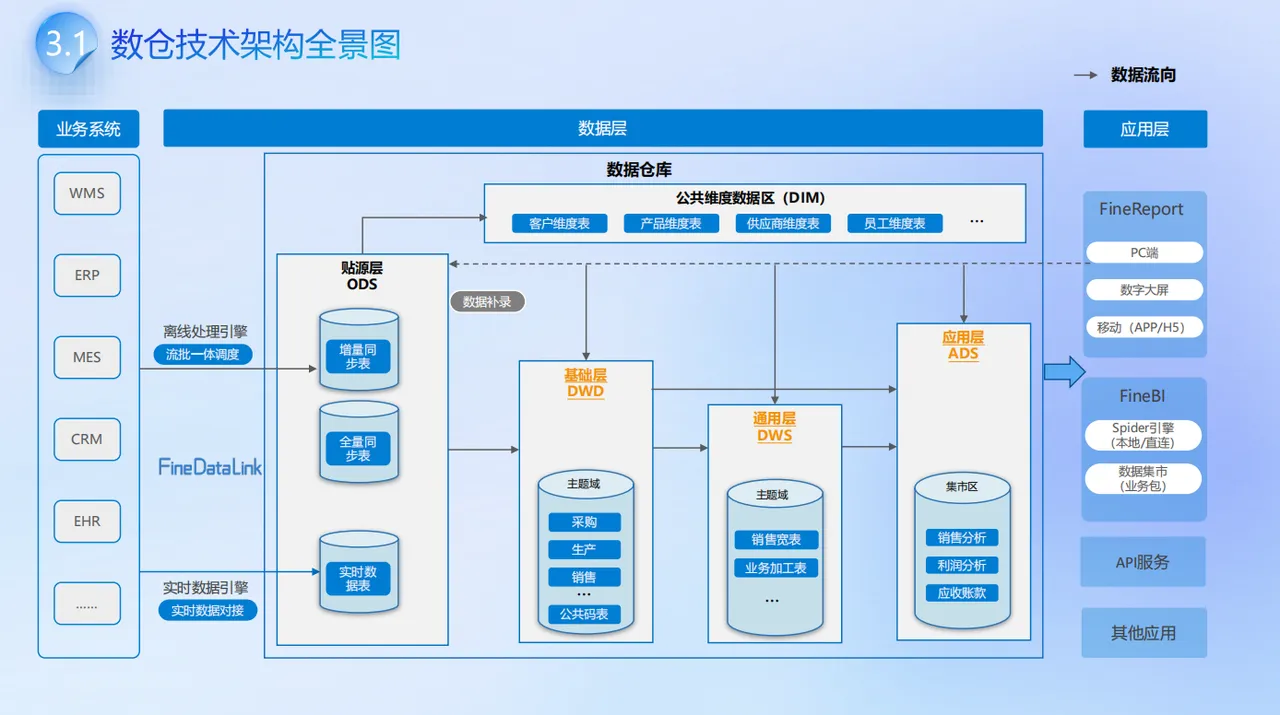
一、写SQL之前,先把清洗规则定义清楚
很多人拿到数据后的第一反应,是直接写 DELETE、UPDATE、DISTINCT 或 COALESCE。但SQL只能执行规则,不能替企业定义规则。
例如,一张客户表中存在两个姓名相同、手机号相同,但客户编号不同的记录。它们可能是重复录入,也可能是同一联系人代表两家公司。如果没有结合企业主体、证件号码、所属公司和交易记录判断,直接删除其中一条,就可能破坏真实业务关系。
因此,正式清洗前,至少要明确四件事。
什么数据属于错误?
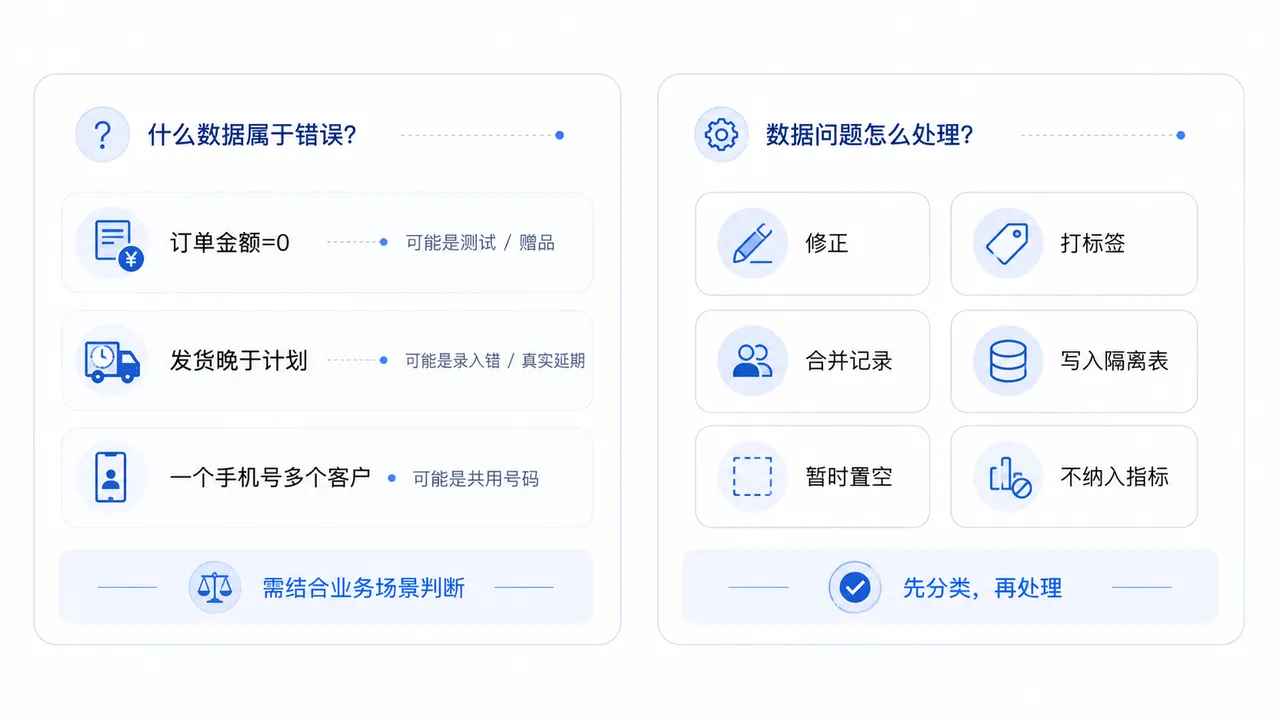
数据异常不一定等于数据错误。订单金额为0,可能是测试数据,也可能是赠品订单;发货日期晚于计划日期,可能是录入错误,也可能是真实延期;一个手机号对应多个客户,也可能是家庭成员、门店共用号码或者企业联系人。所以,清洗规则必须结合业务场景定义,不能只看字段值是否“正常”。
数据问题应该怎样处理?
常见处理方式并不只有删除,还包括:修改为正确值;保留原值并增加异常标签;合并多条记录;将异常记录写入隔离表;暂时置空,等待业务补充;保留记录,但不进入指标计算。能够确定错误原因的数据,可以自动修复;无法确定真实含义的数据,应先标记和隔离,而不是直接覆盖。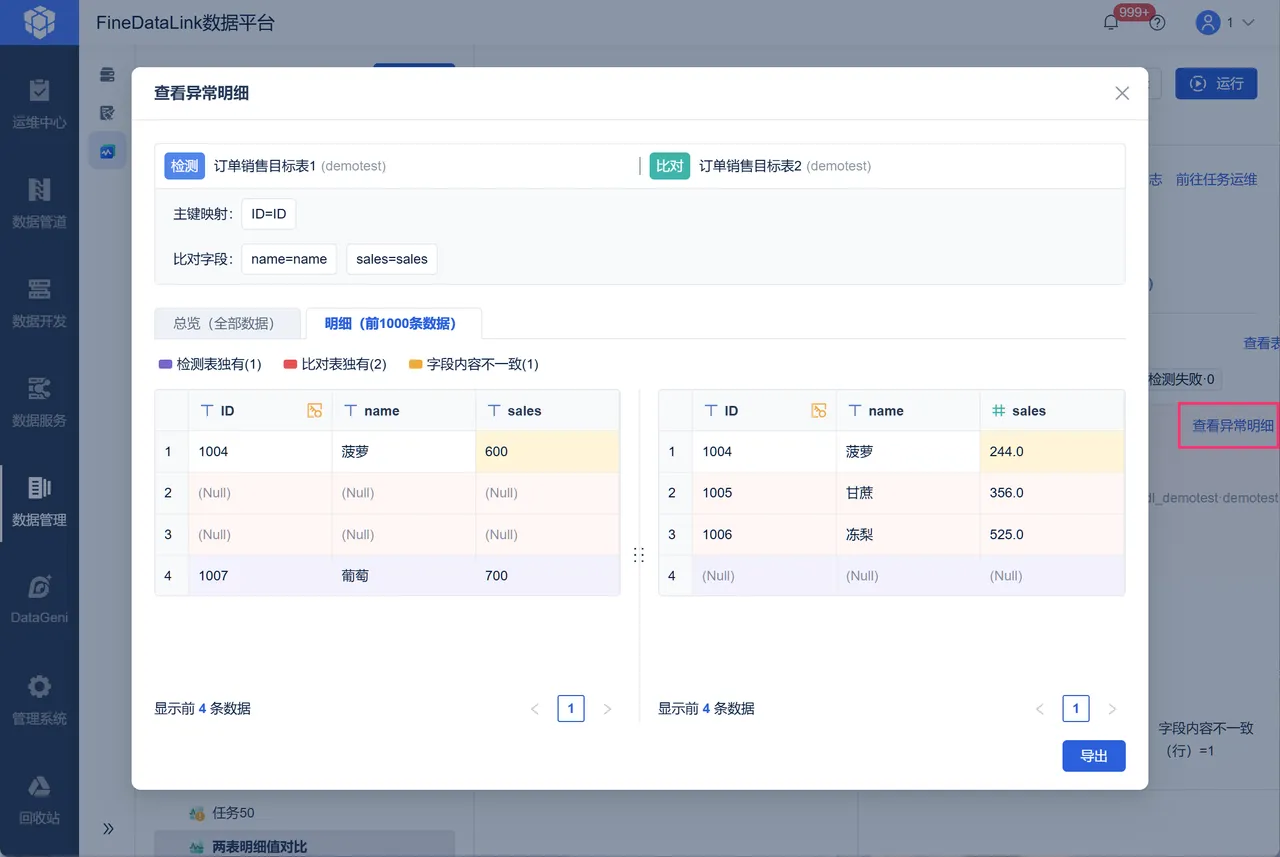
清洗规则作用在哪一层?
不建议直接修改原始数据表。更稳妥的做法是建立分层结构:原始层:完整保留源系统数据; 清洗层:执行格式统一、去重、空值处理和异常校验; 应用层:向报表、指标和分析模型提供标准数据; 异常层:保存未通过规则、需要人工核查的数据。这样做的价值在于,一旦清洗逻辑出现问题,还能回到原始数据重新计算,而不是把原始事实永久修改。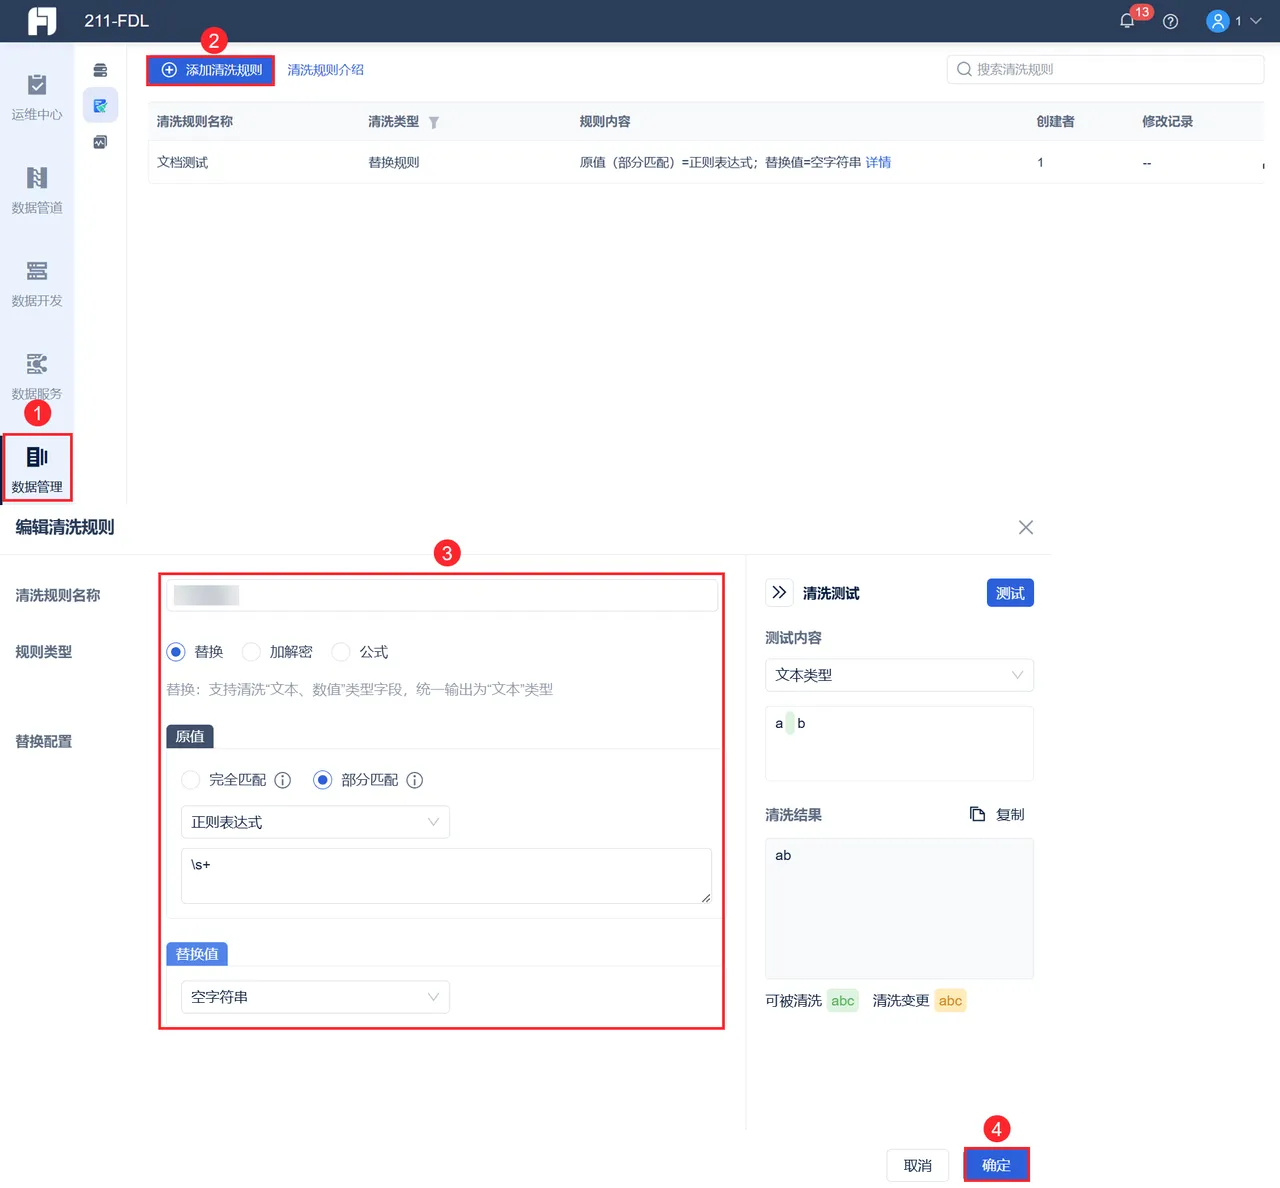
清洗结果怎样验证?
每条清洗规则都要设计验证指标,例如:去重前后分别有多少条记录; 删除或合并了哪些业务对象;空值率下降了多少;异常记录占比是多少;清洗前后金额合计是否一致;主表和明细表能否正常关联。
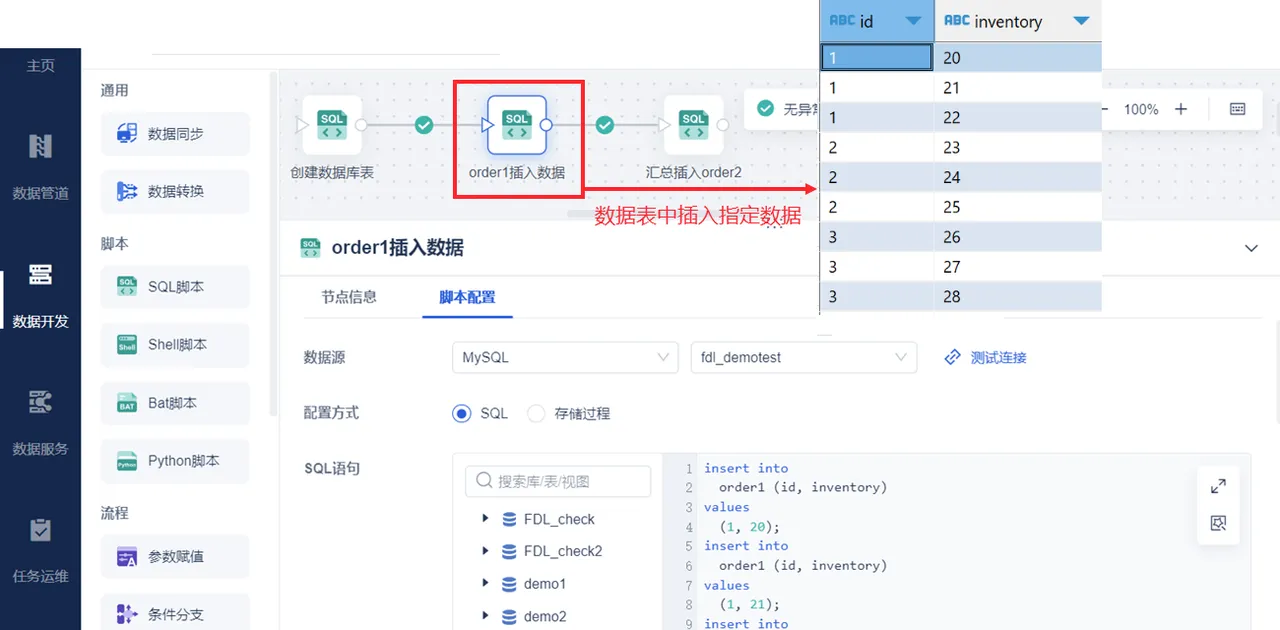
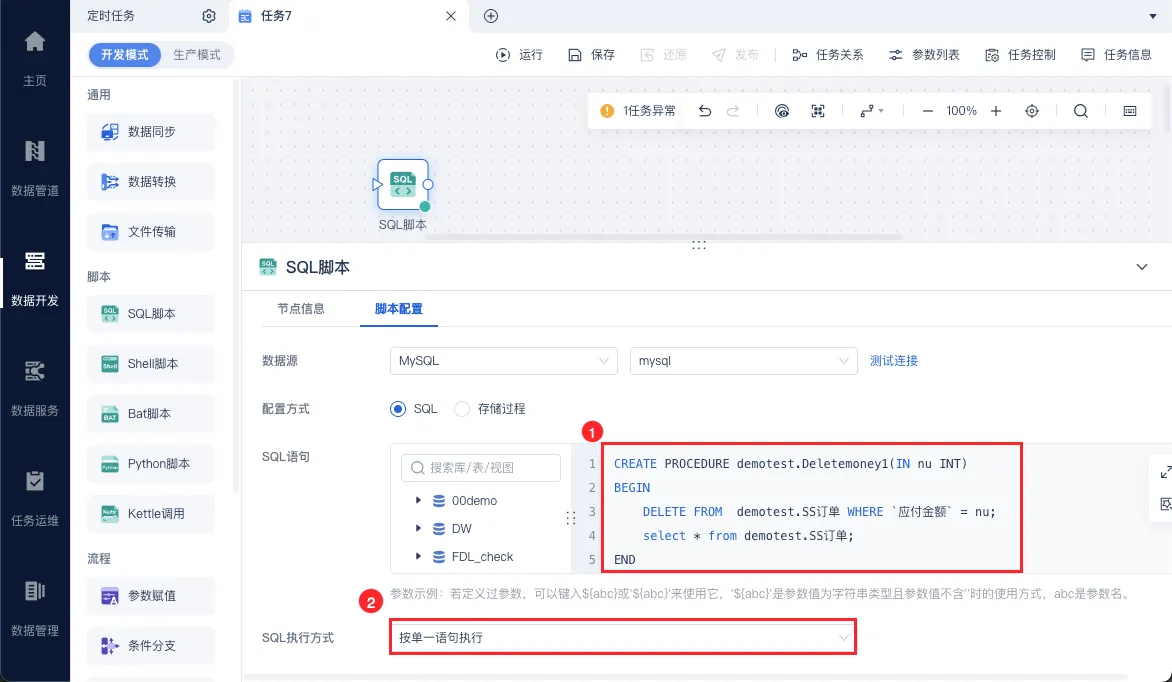
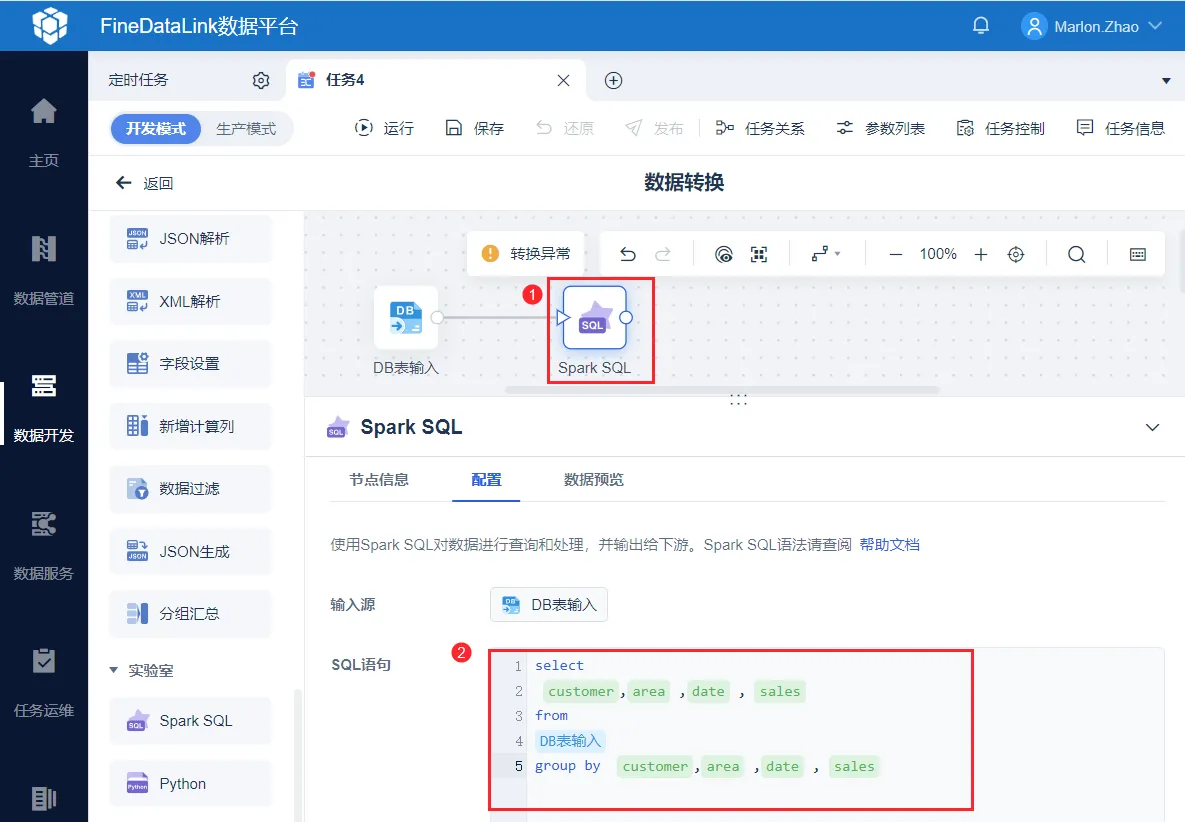
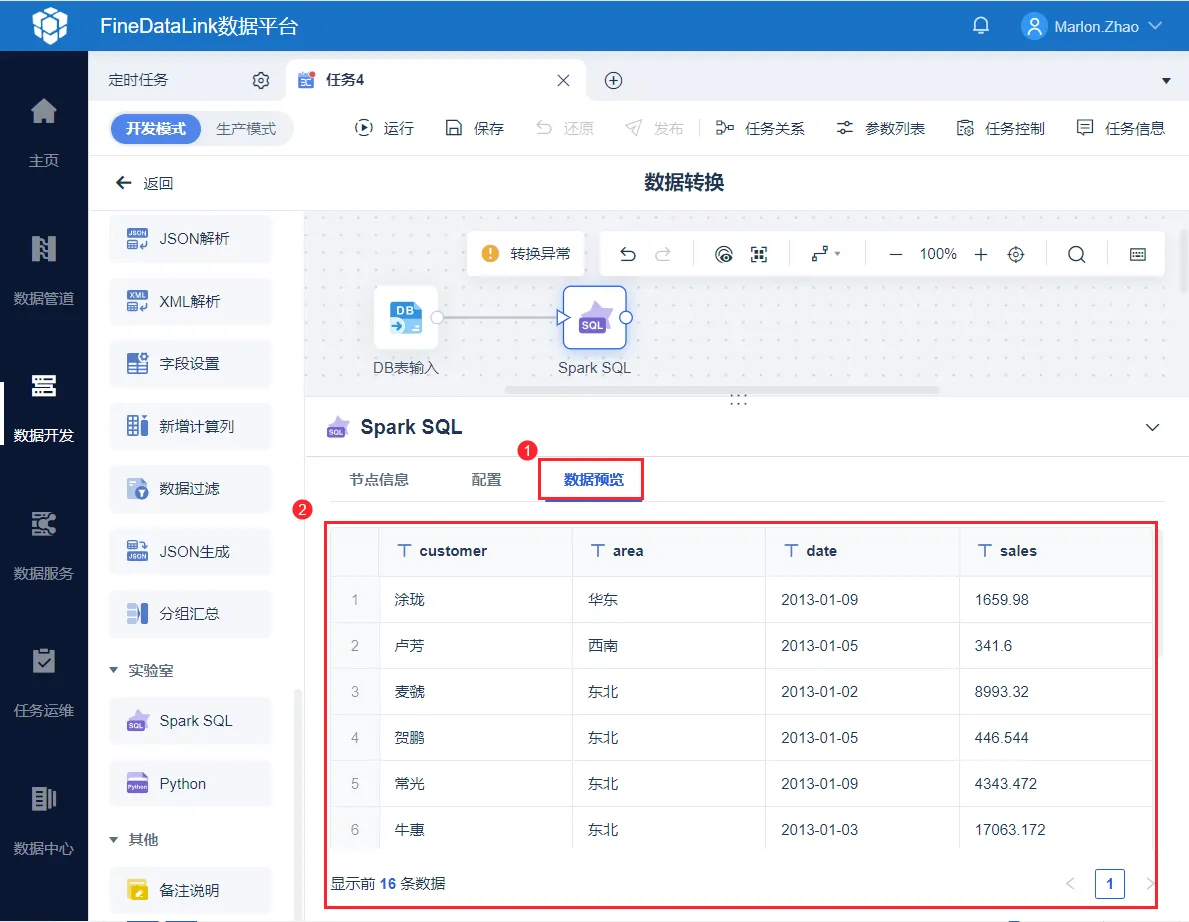
面对ERP、CRM、Excel、数据库等多类数据源时,零散SQL脚本很容易出现执行顺序混乱、规则重复和任务无人维护的问题。
二、重复值处理:不是去掉相同行,而是识别同一业务对象
很多人处理重复数据时,会直接使用:
SELECT DISTINCT *
FROM customer;
但 DISTINCT 只能去掉每个字段都完全相同的记录。真实业务中的重复数据,通常并不会完全一致。
例如:
| 客户编号 | 客户名称 | 手机号 | 地址 | 更新时间 |
|---|---|---|---|---|
| C001 | 华星公司 | 13800000000 | 上海市 | 2026/7/1 |
| C089 | 华星有限公司 | 13800000000 | 上海 | 2026/7/15 |
两条记录字段不同,但很可能属于同一客户。因此,去重的第一步不是删除,而是确定业务唯一键。
不同对象的唯一性判断方式不同:订单通常按订单号判断;员工通常按工号判断;商品通常按商品编码判断;客户可能按统一社会信用代码判断;缺少统一编码时,可能需要使用“名称+手机号+地址”等组合字段。识别重复记录,可以使用窗口函数:
SELECT *
FROM (
    SELECT
        t.*,
        ROW_NUMBER() OVER (
            PARTITION BY phone
            ORDER BY update_time DESC
        ) AS rn
    FROM customer t
) s
WHERE rn > 1;
这段SQL表示:按照手机号分组,将更新时间最新的一条记录标记为1,其余记录作为重复候选。但“保留最新一条”并不一定永远正确。
如果旧记录填写了完整地址,新记录只有手机号;或者旧客户编号已经关联大量订单,新记录却没有历史交易,那么简单保留最新记录,反而可能造成信息丢失。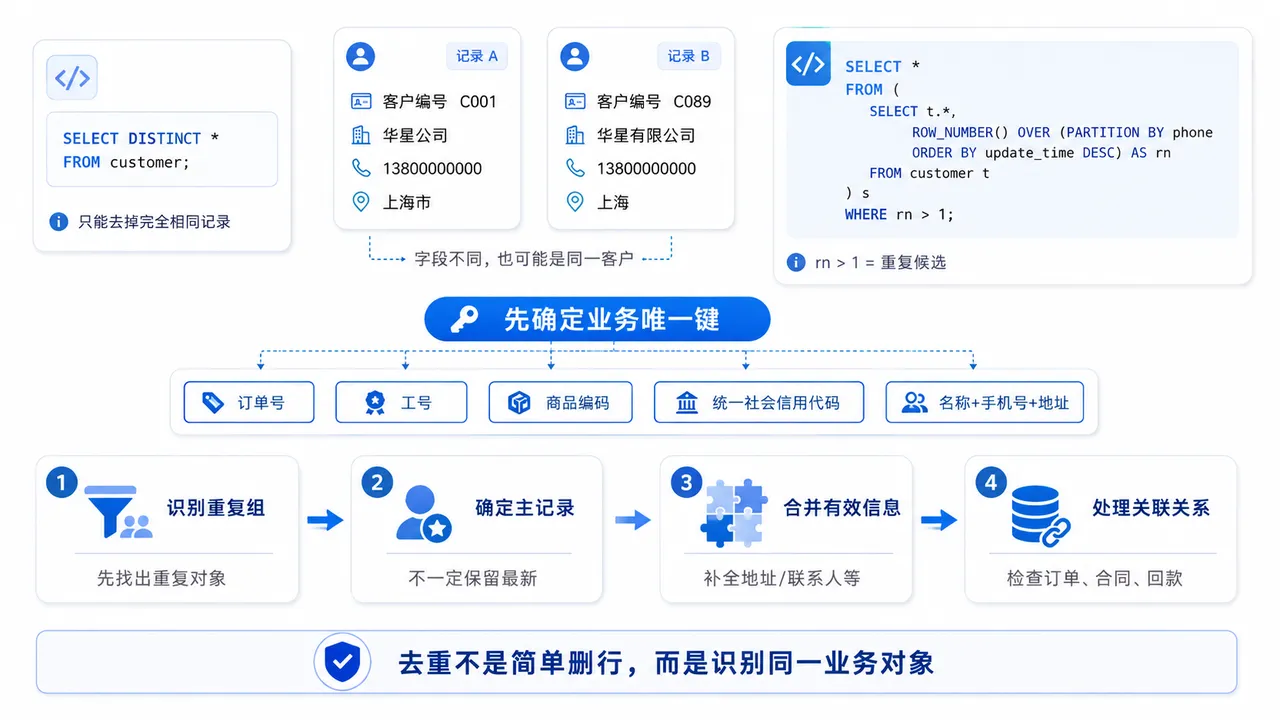
更可靠的去重过程通常包括四步。
第一步:识别重复组
先根据业务唯一键找出重复对象:
SELECT
    phone,
    COUNT(*) AS record_count
FROM customer
WHERE phone IS NOT NULL
GROUP BY phone
HAVING COUNT(*) > 1;
第二步:确定主记录
主记录可以按照以下规则选择:业务编码最早创建;更新时间最新;字段完整度最高;历史交易记录最多;已通过业务认证;被下游系统引用最多。企业最好把多项条件组合成优先级,而不是只依赖一个字段。
第三步:合并有效信息
重复记录中的信息可能需要互补,而不是全部舍弃。例如,可以保留主记录的客户编号,同时补充其他记录中的地址、联系人和客户等级。对于冲突字段,则需要按照数据来源可信度、更新时间或者业务确认结果处理。
第四步:处理关联关系
删除重复客户前,必须检查订单、合同、开票和回款表是否引用旧客户编号。通常需要先建立映射表:
SELECT
    old_customer_id,
    master_customer_id
FROM customer_merge_mapping;
再把下游业务表中的旧编号替换为主编号,最后才处理重复记录。去重真正解决的不是“表中多了几行”,而是同一业务对象在企业内部存在多个身份的问题。 如果只在下游反复执行去重,却不增加唯一索引、录入校验和主数据规则,重复数据仍会持续产生。

三、空值处理:NULL、空字符串、0和“未知”不能混在一起
数据表中的空值,通常不止一种形式:
NULL- 空字符串
'' - 一个或多个空格
- “暂无”
- “未知”
- “-”
- “N/A”
- 数字字段中的0
- 日期字段中的特殊默认值
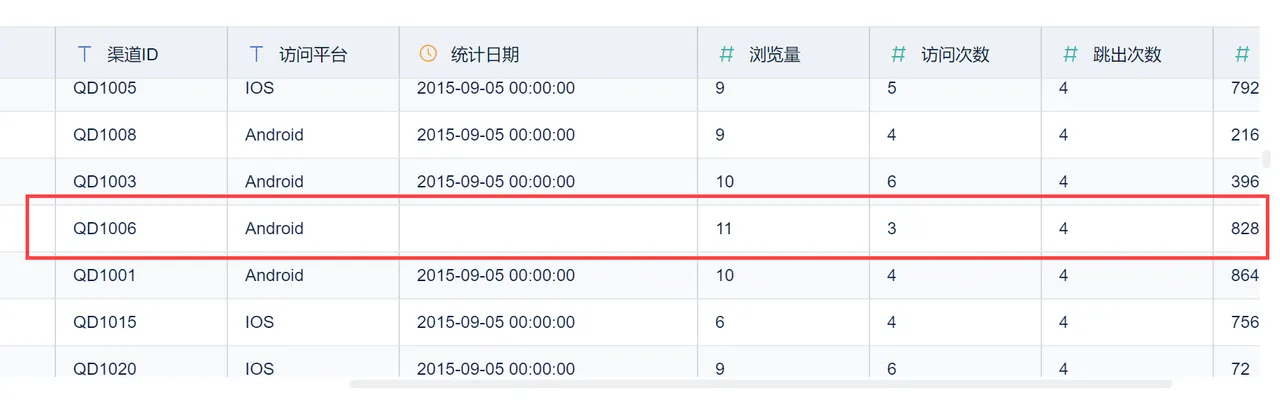
这些值看起来都表示“没有数据”,但业务含义可能完全不同。数据库中的 NULL 一般表示未知或缺失;空字符串表示字段存在但未填写;0则是一个明确的数值。
例如:
SELECT AVG(order_amount)
FROM orders;
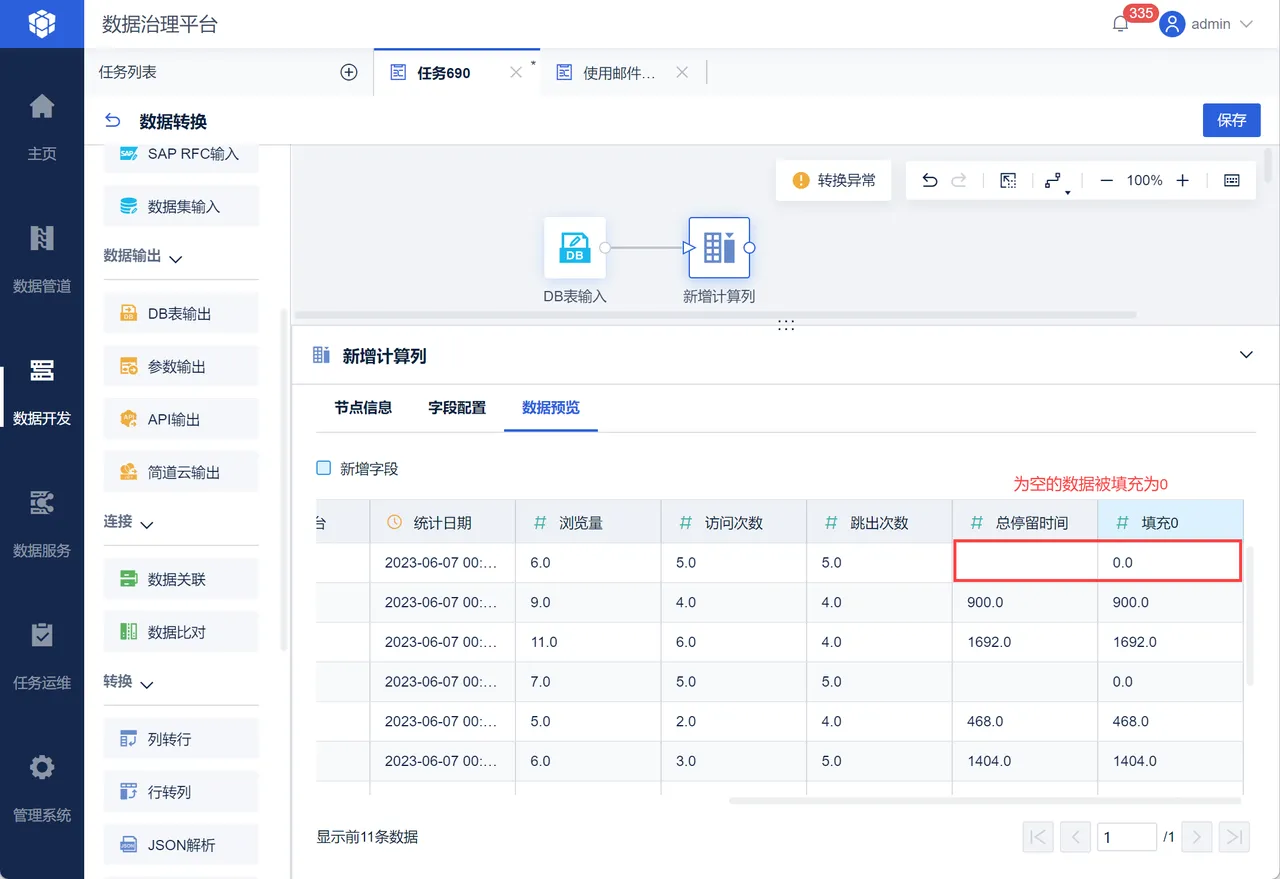
计算平均值时,AVG()通常忽略 NULL,但会把0纳入计算。如果订单金额暂时没有录入,却被统一填成0,平均订单金额就会被人为拉低;如果未付款金额被填成0,则可能被误判为客户已经结清。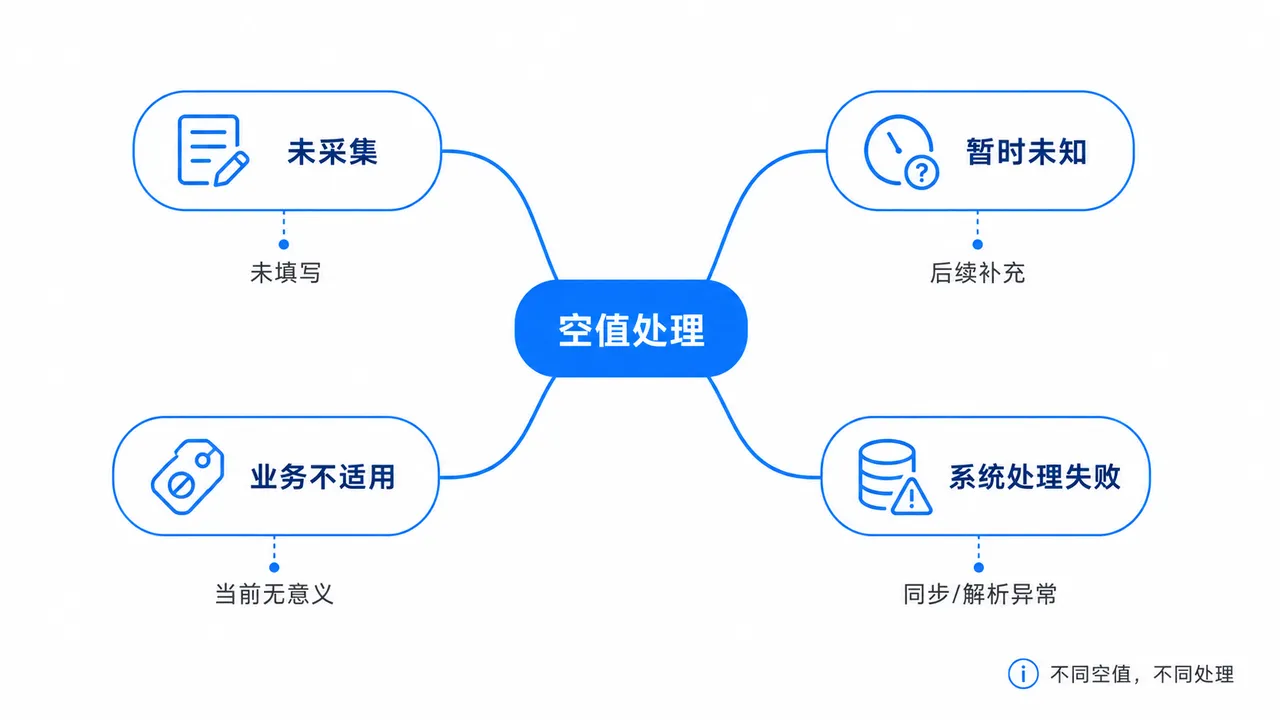
因此,处理空值时,首先要区分空值产生的原因。
未采集
业务人员没有填写,例如客户邮箱为空。
暂时未知
目前没有结果,但未来会补充,例如订单尚未确定发货日期。
业务不适用
字段对当前记录没有意义,例如线下客户没有线上账号。
系统处理失败
数据同步、字段解析或格式转换失败,导致目标字段为空。
这四类空值的处理方式不应该相同。首先,可以把不同形式的“伪空值”统一转换为 NULL:
UPDATE customer
SET email = NULL
WHERE email IS NULL
   OR TRIM(email) = ''
   OR TRIM(email) IN ('暂无', '未知', '-', 'N/A');
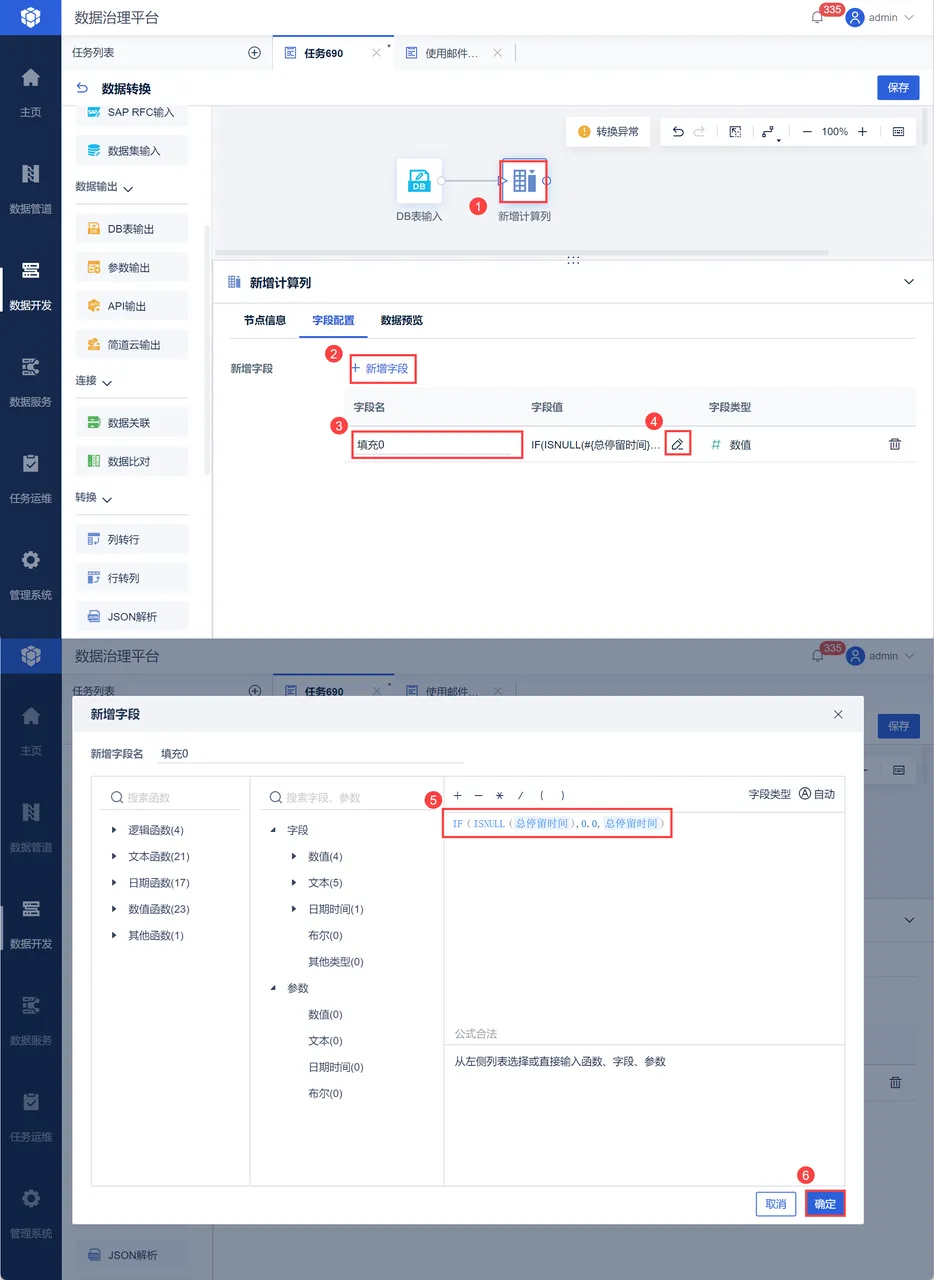
需要注意,生产环境中通常更建议在清洗层生成新字段或新表,而不是直接更新源表。对于允许使用默认值的字段,可以使用 COALESCE:
SELECT
    COALESCE(discount_amount, 0) AS discount_amount,
    COALESCE(customer_level, '待识别') AS customer_level
FROM orders;
但默认值必须有明确业务依据。折扣金额为空,可以在规则确认后按0处理;付款日期为空,却通常表示尚未付款;客户等级为空,也不能直接认定为普通客户。
更稳妥的方法,是保留原字段,同时增加状态字段:
SELECT
    payment_date,
    CASE
        WHEN payment_date IS NULL THEN '未付款或待确认'
        ELSE '已记录付款日期'
    END AS payment_status
FROM orders;
对于必填字段,还可以统计空值率:
SELECT
    COUNT(*) AS total_count,
    SUM(CASE WHEN customer_id IS NULL THEN 1 ELSE 0 END) AS null_count,
    ROUND(
        SUM(CASE WHEN customer_id IS NULL THEN 1 ELSE 0 END) * 100.0
        / COUNT(*),
        2
    ) AS null_rate
FROM orders;
空值率不仅用于一次清洗,也可以作为长期数据质量指标。
例如,客户手机号空值率从2%突然上升到20%,问题可能不是客户突然不愿提供手机号,而是录入页面、接口映射或者同步任务发生了变化。
四、异常值处理:先判断违反了什么规则,再决定是否修复
异常值是最容易被误删的一类数据。订单金额突然达到1000万元,可能是录入人员多写了两个0,也可能是真实的大客户订单;某商品销量突然增长5倍,可能是数据重复,也可能是促销活动产生的真实增长。所以,异常值表示偏离常态,但不一定表示数据错误。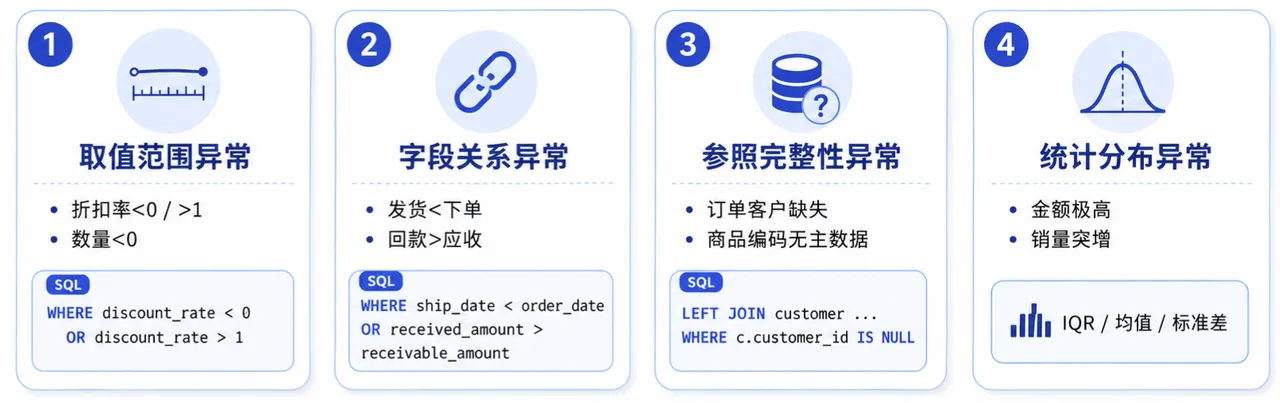
实际处理中,可以从四个层面识别异常。
取值范围异常
某些字段存在明确边界,例如:折扣率应在0到1之间;数量原则上不能小于0;年龄不能为负数;已完成订单金额不能为0;日期不能超出合理业务周期。
SELECT *
FROM sales
WHERE discount_rate < 0
   OR discount_rate > 1;
范围规则适合识别明确错误,但边界要结合业务定义。例如,库存数量出现负数,可能代表超卖,也可能是系统允许的负库存。
字段关系异常
单个字段看起来正常,多个字段组合后却不符合业务逻辑。例如:发货日期早于下单日期;回款金额大于应收金额;已取消订单仍有发货数量;订单状态为“已完成”,但完成时间为空。
SELECT *
FROM orders
WHERE ship_date < order_date
   OR received_amount > receivable_amount;
字段关系规则通常比单字段范围判断更有价值,因为它更接近真实业务流程。
参照完整性异常
业务表中的编码,应当能够关联到有效主数据。例如,订单中的客户编号必须存在于客户表,商品编号必须存在于商品表。
SELECT o.*
FROM orders o
LEFT JOIN customer c
    ON o.customer_id = c.customer_id
WHERE c.customer_id IS NULL;
出现无法关联的记录,可能是主数据缺失、编码变化、接口截断或者同步顺序错误。这类问题不能只在订单表中修正,还要继续追溯上游系统。
统计分布异常
对于订单金额、交付周期、库存周转天数等连续变量,可以使用均值、标准差或分位数识别极端值。例如,使用四分位距判断:
WITH stat AS (
    SELECT
        PERCENTILE_CONT(0.25)
            WITHIN GROUP (ORDER BY order_amount) AS q1,
        PERCENTILE_CONT(0.75)
            WITHIN GROUP (ORDER BY order_amount) AS q3
    FROM orders
)
SELECT o.*
FROM orders o
CROSS JOIN stat s
WHERE o.order_amount < s.q1 - 1.5 * (s.q3 - s.q1)
   OR o.order_amount > s.q3 + 1.5 * (s.q3 - s.q1);
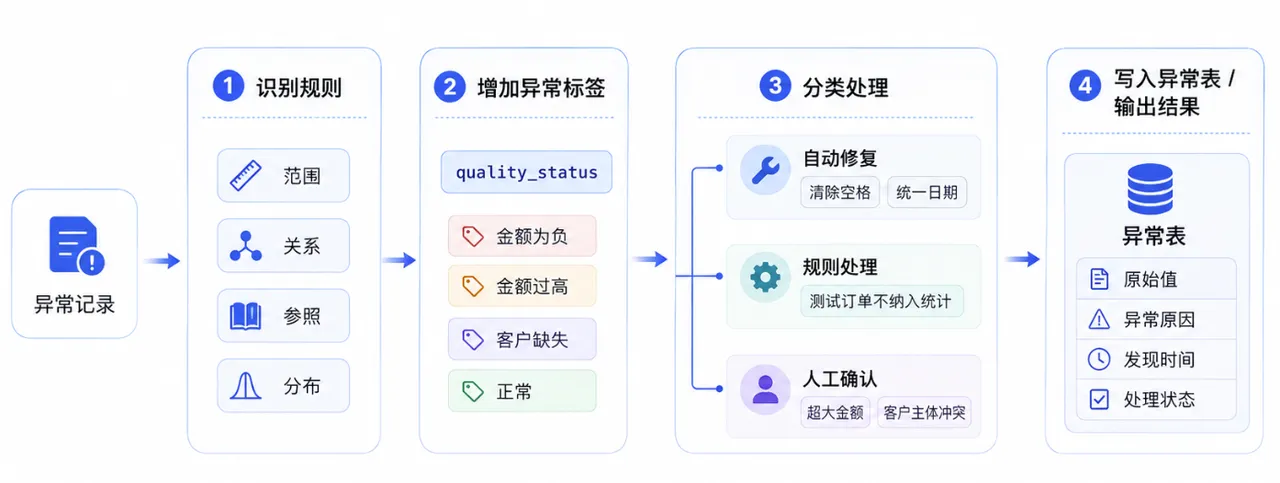
统计方法只能筛选“值得关注的记录”,不能直接作为删除依据。更合理的处理方式,是为数据增加异常类型和处理状态:
SELECT
    t.*,
    CASE
        WHEN order_amount < 0 THEN '金额为负'
        WHEN order_amount > 1000000 THEN '金额过高'
        WHEN customer_id IS NULL THEN '客户缺失'
        ELSE '正常'
    END AS quality_status
FROM orders t;
异常记录可以分为三类: 可以自动修复:例如清除空格、统一日期格式; 可以按明确规则处理:例如测试订单不计入正式统计; 必须人工确认:例如超大金额订单、客户主体冲突。清洗任务中还可以把未通过规则的数据单独写入异常表,保留原始值、异常原因、发现时间和处理状态。
结语
SQL数据清洗看似是在处理重复值、空值和异常值,实际解决的是三个更深层的问题:同一个业务对象怎样保持唯一,缺失数据怎样保留真实含义,异常数据怎样在错误和业务信号之间作出判断。
因此,可靠的数据清洗不能只追求“执行成功”,还要做到:原始数据能够保留;清洗规则有业务依据;处理结果能够验证;异常记录可以追溯;清洗逻辑能够重复运行;上游问题能够定位到具体系统和责任环节。
真正高质量的数据,不是表面上没有空值和重复值,而是每一次修改都有依据,每一条异常都有去向,每一个指标都能追溯到可信的数据来源。

