💡 一句话总结:DocMemo 把长文档检索从“先选一批页再硬答”改成“读、记、更新置信度、再找”的循环;如果你做的是 RAG、文档 Agent 或多模态文档理解,这篇最值得拿走的不是分数,而是把检索状态显式建模的工程思路。
导语:你的 RAG 不是没读到,而是读完就忘
先问一个可能戳到你的问题:你那个长文档问答系统,第一次检索错页之后,还有机会自己纠正吗?
很多做文档 RAG 的人大概都见过这一幕:问题明明在第 38 页的表格和第 52 页的图注里,系统却抱着前 10 页不撒手,最后用旁边的普通段落硬编一个答案。更麻烦的是,长 PDF 里的证据常常是稀疏的、跨页的、混在表格和图片里的。上下文窗口越长,并不等于系统真的会找证据。
多轮检索当然是一个方向。可是如果每轮只是把更多上下文堆进 prompt,那它更像“反复重新搜一遍”,缺少真正的状态:上一轮哪些页被证明有用?哪些证据缺口还没补?页面相关性有没有随着新线索变化?
DocMemo 的作者把这个问题说得更直接:长文档理解的关键不是被动读完整本文档,而是在有限证据预算下动态定位、更新和整合相关页面。论文提出的 DocMemo,就是一个带三层记忆的多模态长文档问答框架。
想自己动手试?
- 📄 论文:arXiv 2608.07067
- 💻 代码:GitHub · Harrygof/DocMemo
🎯 这篇论文到底想解决什么问题?
论文的全名是 DocMemo: Dynamic Evidence Discovery via Probabilistic Memory-Guided Retrieval for Multi-Modal Document Understanding。拆开看,关键词其实是两个:动态证据发现,和概率记忆引导检索。
它针对的第一类痛点是静态检索。传统 RAG 通常先做一次 top-k 页面检索,把候选页塞给模型回答。问题是,如果关键证据在第一轮就没被检索到,后面几乎没有纠错机会。对短文档这也许只是小失误,对上百页 PDF 就是结构性风险。
第二类痛点是多轮但不带状态。像 SimpleDoc 这类迭代方法允许模型多轮检索,证据不够就继续找。但 DocMemo 的批评是:它们主要靠上下文重建来保留跨轮信息,缺少明确的状态传播机制。换句话说,系统知道“我又搜了一轮”,却不太知道“这一轮之后,我对每一页相关性的信念应该怎么变”。
这里可以用一个不算太精确但好懂的类比:静态 top-k 像考试前只抄第一页笔记;普通多轮检索像每次都重新翻书;DocMemo 想做的,是一边翻书一边在便签上写下“第 38 页肯定有表,第 50 页附近可能还有图”,下一轮按这张便签继续找。
论文的实验场景也确实够长:MMLongBench-Doc 有 135 份长文档、1082 个问题,文档最多 112 页、平均 47.5 页;LongDocURL 有 396 份 PDF、2325 个问答对;PaperTab 有 307 篇论文、393 个表格问题。它们分别覆盖文本、布局、图表、表格、不可回答问题、数值推理和跨元素定位。
🛠️ 它的思路是什么?
DocMemo 的核心设计是三层记忆。名字听起来有点论文味,但每层职责其实很清楚。
- 🧭 Document Schema Memory:离线为整份文档建立结构导航,包括文档类型、章节页码范围、主题标签和全局摘要。它回答“这份文档大概长什么样,哪一段在讲什么”。
- 📊 Page Belief Memory:给每一页维护一个相关性信念,而不是一次性分数。论文用 Beta 分布表示每页“相关/不相关”的不确定性,推理反馈会持续更新它。
- 🧩 Question Episodic Memory:记录当前问题的中间发现、证据缺口和查询改写历史。它回答“这个问题我已经知道什么、还缺什么”。
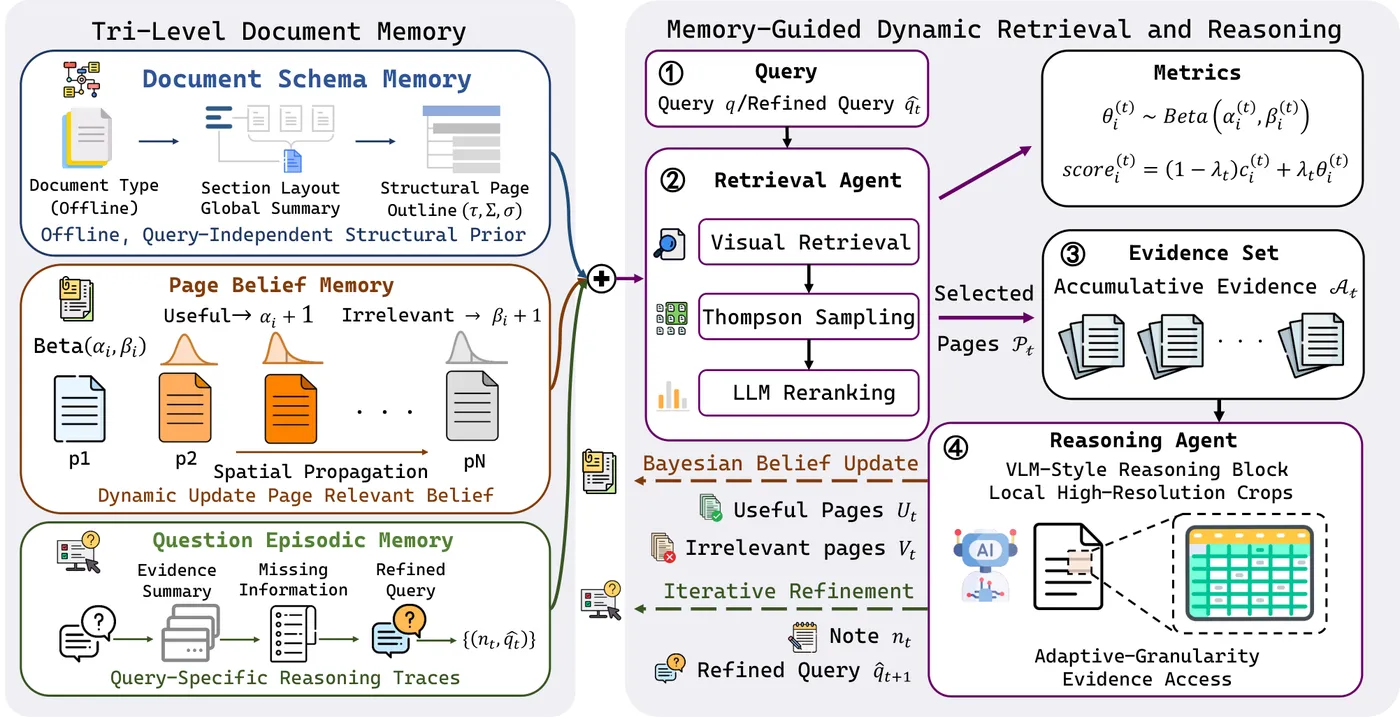
图说:左边是三层文档记忆,右边是每一轮里“选页、读证据、产生反馈、更新信念”的循环。
离线阶段,系统先用 ColQwen2.5 给每页做视觉嵌入,再生成页级摘要,最后聚合成文档结构记忆。在线回答一个问题时,它最多跑三轮检索-推理循环:先根据当前查询和页面信念选候选页,再让推理 VLM 读页面图片、抽取文本和高分辨率局部区域,最后输出答案、继续检索的理由,或者明确说不可回答。
最有趣的是页面信念怎么更新。推理器每轮会标出 useful_pages 和 irrelevant_pages;被标为有用的页面增加 Beta 分布的正证据,无用页面增加负证据。论文还做了一个局部传播:如果第 $i$ 页被确认有用,距离不超过 2 的邻近页也会获得一个随距离衰减的正证据。这背后的假设很朴素:长文档的证据经常连续分布在附近页面,比如同一节、同一张跨页表、同一个实验说明。
下一轮选页时,DocMemo 从每页的 Beta 后验中采样一个相关性估计,再和当前查询的视觉相似度融合。论文里唯一的核心公式可以概括成这样:
$$ \operatorname{score}_i^{(t)}=(1-\lambda_t)c_i^{(t)}+\lambda_t\theta_i^{(t)}. $$
$c_i^{(t)}$ 是当前改写查询和第 $i$ 页的即时相似度,$\theta_i^{(t)}$ 是从历史信念中采出来的页面相关性,$\lambda_t$ 决定这一轮更信即时检索还是更信历史积累。随着轮数增加,$\lambda_t$ 逐步变大,系统会从“先按相似度找”转向“按已验证证据继续探索”。
为什么要采样,而不是直接取后验均值?这就是 Thompson Sampling(汤普森采样,一种带探索的 Bandit 策略):高置信页面有机会被继续利用,还没被验证过但不确定性大的页面也有机会被翻到。直觉上,它防止系统过早锁死在第一批看起来最像的页面上。
还有一个很工程化的细节:候选页不会直接全塞给模型。论文设置先保留 30 个候选页,由 LLM 根据页面摘要、文档结构和问题记忆重排,最后最多给推理 VLM 9 页;表格区域每题最多注入 5 个高分辨率裁剪。这个“从粗导航到细证据”的预算控制,比单纯喊多模态长上下文更落地。
📈 效果到底怎么样?
先看主结果。在三个基准上,DocMemo 的 Accuracy(准确率,越高越好)分别是 MMLongBench-Doc 71.3、LongDocURL 81.1、PaperTab 80.4。对比同表里的 SimpleDoc,三者分别是 60.6、72.3、65.4。
这意味着 LongDocURL 提升 8.8 个百分点,PaperTab 比 SimpleDoc 高 15.0 个百分点。MMLongBench-Doc 上,DocMemo 也比表中最强的 agentic baseline DocLens 高 3.7 个百分点。更重要的是,论文还做了受控实验:同样使用 Qwen3.5-9B、ColQwen2.5、相同页预算和三轮设置时,MoLoRAG 为 67.1,SimpleDoc 为 69.3,DocMemo 为 71.3。这说明提升不完全来自换更强底座。
我最看重的是证据召回这条证据链。MMLongBench-Doc 上,DocMemo 的 Evidence Recall(证据页召回率,越高越好)从第一轮的 28.32% 提升到第三轮的 69.56%;All-Hit Rate(所有标注证据页都被找到的问题比例)从 12.90% 提升到 58.05%。这直接回应了“能不能从早期漏检里恢复”的核心问题,而不只是最终答案分数好看。

图说:左半部分看证据召回和全命中率如何随轮次上升,右半部分对比 DocMemo 和 SimpleDoc 的相对效率。
消融也很有信息量。MMLongBench-Doc 上完整模型为 71.28;去掉全部记忆模块降到 68.47,去掉 Bayesian 更新降到 68.80,把 Thompson Sampling 换成贪心选择降到 68.62,去掉自适应粒度证据访问降到 69.91。我的读法是:真正的大头来自跨轮状态和探索策略,表格裁剪则是针对局部细节的补强。
效率方面,DocMemo 平均每题 1.24 轮,而 SimpleDoc 固定三轮;论文用 LLM/VLM 调用次数估算,DocMemo 的相对计算成本约为 SimpleDoc 的 0.41 倍,相对效率约 2.4 倍。这里的效率不是墙钟时间,读结果时要留意口径。
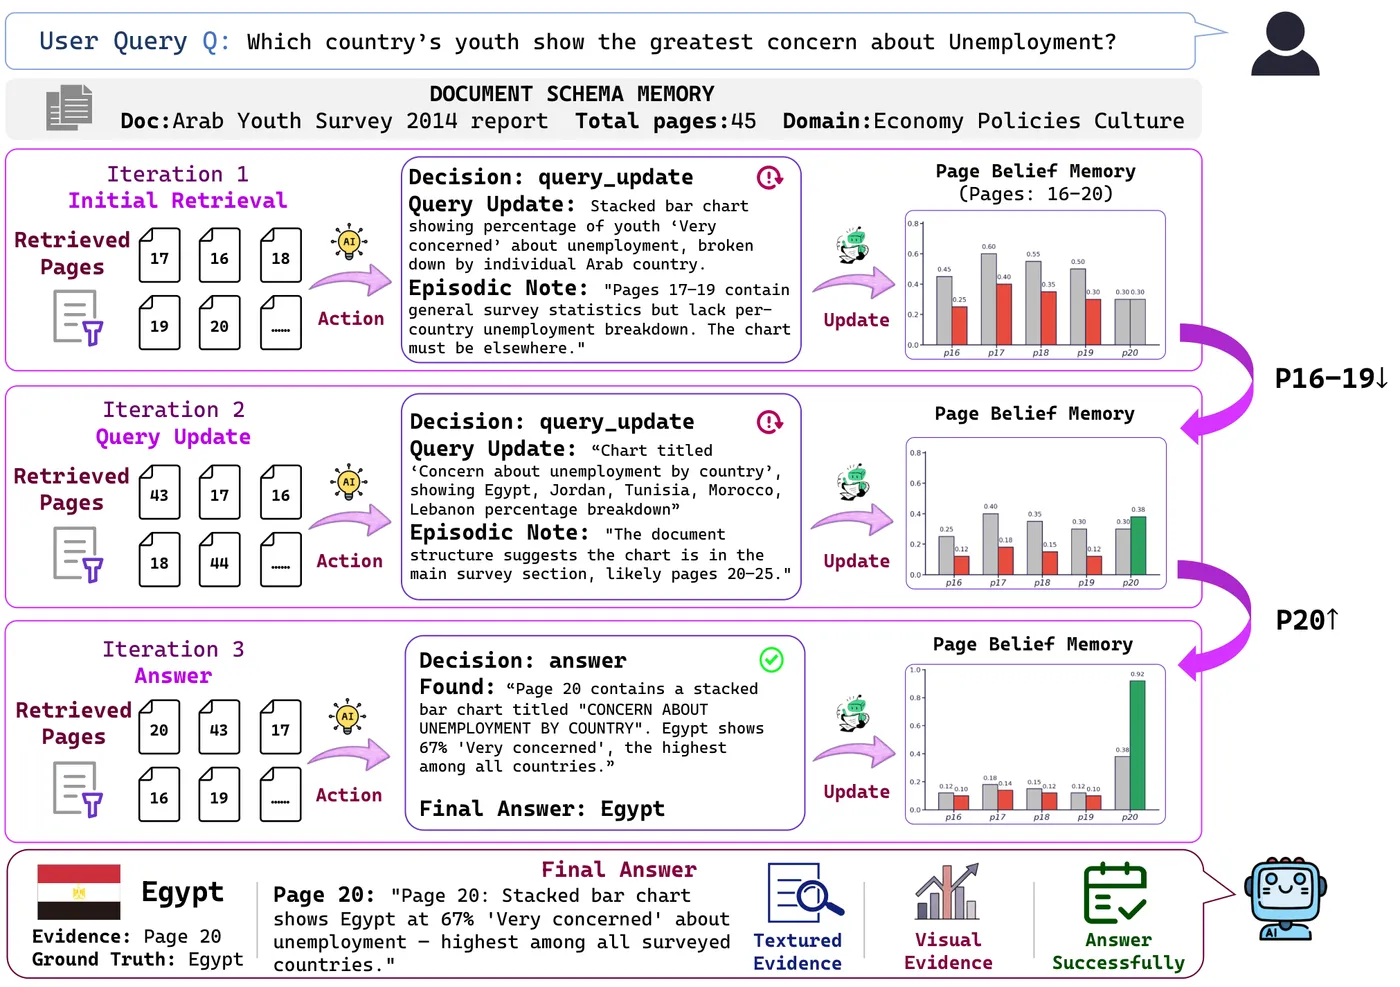
图说:一个具体问题里,DocMemo 如何从初始检索转向证据缺口,再通过记忆和页面信念定位关键图表页。
💡 为什么你要关心?
如果你做 RAG,这篇至少有三点可以直接借鉴。
- 🔁 别把 top-k 当终点:把首轮检索视为假设,而不是结论。后续推理应该能产出结构化反馈,比如哪些 chunk 有用、哪些问题还没被回答。
- 🧮 给候选保存不确定性:不一定要照搬 Beta 分布,但“相关/不相关证据计数 + 后验采样”是一个很轻的状态设计,比把整段历史塞回 prompt 更可解释。
- 🧱 利用文档结构先验:页码邻近、章节连续、表格高分辨率裁剪,这些都是长文档特有的便宜信号。多模态不是只加图片,而是让不同粒度的证据互相校正。
对做 Agent 的读者,它还有一个更一般的启发:记忆不应该只是一堆历史消息。DocMemo 把记忆拆成“可复用的文档知识、可更新的任务状态、当前问题的经验轨迹”,这种分层让每次工具调用都有明确写入对象。你完全可以把这个设计迁移到代码检索、日志排查、工单分析或企业知识库 Agent 里。
换个角度看,这也是对“长上下文解决一切”的温和反驳。模型能吃进更多 token,不代表检索问题消失。证据预算、页面选择、反馈更新和早停机制,仍然是成本、延迟和准确率之间的关键控制面。
🤔 理性看待
这篇是 arXiv v1,代码公开但仓库暂无 license,论文也没有经过同行评审。仓库包含脚本、prompt 和核心模块,数据集与完整评测输出仍需自行准备,因此“能复现实验”和“马上开箱即用”之间还有距离。
评测上,答案正确性主要由 GPT-4.1 自动判定。论文补了 300 个样本的人工校验,与人类判断一致率 96.7%、Cohen's kappa 0.92,这一点不错;但它仍是自动评测为主的流程。主表里部分 baseline 结果来自 leaderboard 或原论文,好在同配置受控实验缓解了不少疑虑。
我的另一个保留是:长文档证据局部连续的假设在很多报告、论文和手册里成立,但未必适合证据随机散落的场景。邻近页传播会带来收益,也可能在强干扰段落附近制造偏置。要迁移到自己的数据上,最好先统计证据页距离分布,再决定是否保留空间传播。
即便如此,DocMemo 的方向是值得认真看的:它把“检索器”从一个静态排序函数,变成了一个能被推理反馈更新的状态机。对长文档系统来说,这个视角比单纯刷一个 benchmark 更有价值。
作者:lusca
版本:lusca-paper-blog v1.5.0
出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-blog