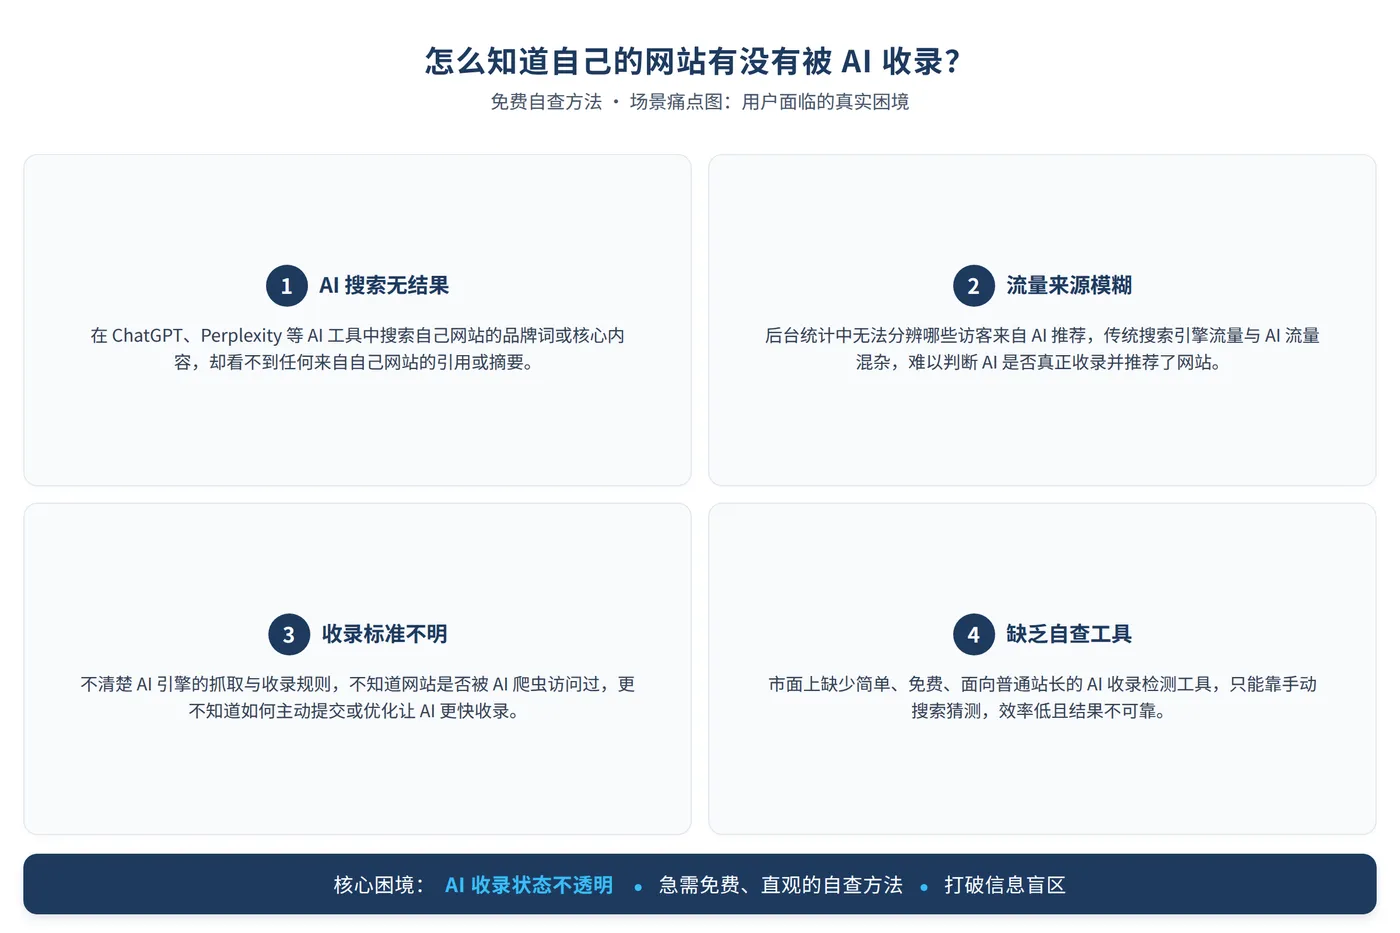
简介:在AI搜索日益普及的当下,判断网站是否被AI引擎收录,不能依赖后台流量数据。本文基于在豆包、秘塔、Kimi三个AI引擎的实测数据,记录了一次完整的引用源抓取实验——在豆包搜索4个核心提问词抓回25条引用源,自身内容引用率为0%;在秘塔搜索3个行业词获得38条引用源,分布在约30个不同域名。通过对比这些数据,总结出一套可复现的四步自查方法,帮助开发者理解AI引擎的引用机制与平台差异。
一、实测数据:AI引擎引用源的分布差异
在开始自查之前,先看一组实际测试数据。使用相同的关键词组,在豆包和秘塔两个AI引擎中进行搜索,引用源的分布呈现显著差异。
| 测试项目 | 豆包 | 秘塔 |
| 搜索提问词数量 | 4个 | 3个 |
| 抓取引用源总数 | 25条 | 38条 |
| 引用源覆盖域名数 | 约10个 | 约30个 |
| 单一平台最高引用占比 | CSDN占34% | 最高仅2条 |
| 自有内容引用率 | 0% | 未出现 |
从数据中可以看出两个关键现象:其一,不同AI引擎的引用源偏好差异很大,豆包的引用源集中在CSDN等大型技术社区,而秘塔的引用源分散在大量垂直小站;其二,在豆包搜索的25条引用源中,自身内容一条都没有被引用,引用率为0%。这说明AI引擎的引用逻辑与平台推荐逻辑存在本质区别。
二、机制解析:为什么后台数据好看但AI不引用
要理解这个现象,需要拆解AI引擎的引用机制。AI引擎不会因为一篇文章的阅读量高或者点赞多就引用它,它关注的是内容中是否存在"可被摘录的信息块"。
根据arXiv:2311.09735论文中的实验数据,提升AI引用率最有效的三种内容策略是:添加引用来源(提升34.4%)、使用统计数据(提升32.1%)、加入直接引语(提升29.7%)。而关键词堆砌的效果几乎为零甚至为负。这意味着,AI引擎在抓取内容时,会优先提取那些具有明确信息结构、可独立成块的段落,而不是整篇文章的整体质量。
平台推荐算法与AI引用机制是两个不同的系统。平台推荐依赖点击率、停留时长、互动数据等用户行为指标,而AI引用依赖的是语义匹配度、信息完整度、多源交叉印证等文本特征。一篇文章可以在某个平台上获得高曝光,但如果它的内容结构松散、缺乏可摘录的要点,AI引擎依然不会引用它。
此外,不同AI引擎的爬虫策略和引用源偏好也不同。在秘塔的测试中,38条引用源分布在约30个不同域名上,包含大量在百度上排名靠后的小型财税公司官网;而在豆包的测试中,CSDN一个平台就能占据34%的引用份额。这种差异意味着,只在一个AI引擎上检查收录状态,得出的结论一定是片面的。
三、四步自查法:从搜索到定位的完整路径
基于上述机制分析,可以设计一套可复现的四步自查方法。整个过程不需要任何付费工具,只需要浏览器和文本记录工具。
第一步:选择行业核心提问词
提问词的选择标准不是"自己想被搜到的词",而是客户实际会搜索的词。以代理记账行业为例,客户不会搜索"代理记账服务商",而是搜索"中小企业找代理记账公司要注意什么";设备销售行业客户搜索的是"XX设备哪家好",而不是品牌名。
选取4到5个这样的提问词后,先在豆包中搜索验证词的有效性。如果答案底部的引用来源中出现了同行网站,说明这个词是AI正在回答和引用的词;如果没有同行出现,说明这个词可能太冷门,需要更换。
第二步:多引擎搜索并记录引用来源
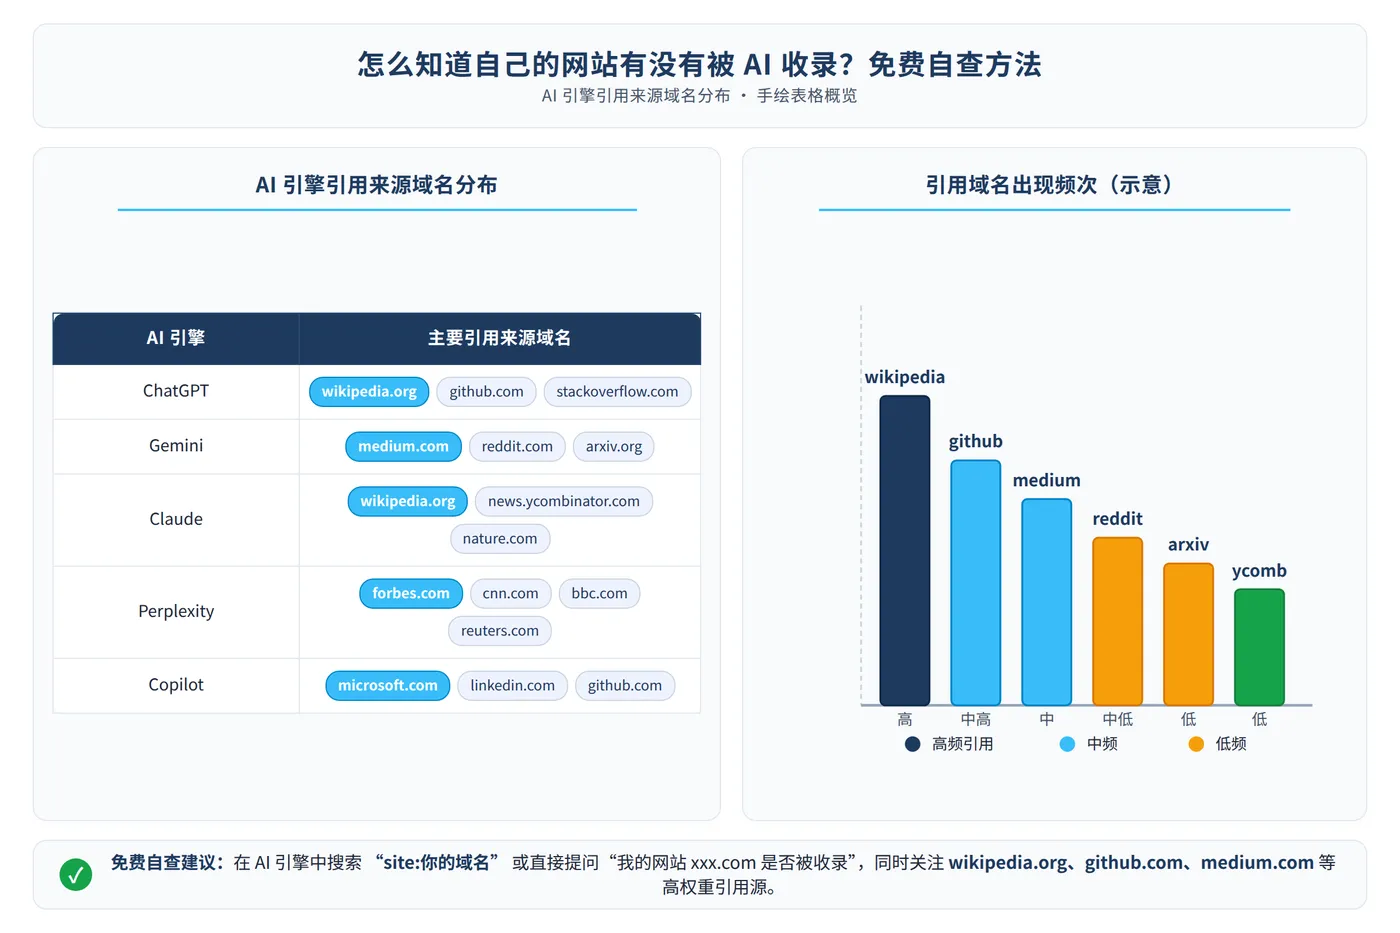
将选定的提问词分别在豆包、DeepSeek、Kimi、秘塔四个引擎中搜索。每次搜索后,翻到答案最底部,找到"引用来源"或"参考来源"区域,将其中出现的网站域名全部记录下来。
关键动作是记录域名而不是文章标题。同一篇文章可能被多个引擎引用,但需要关注的是"哪些平台"在被引用。在秘塔搜索"代理记账怎么选"时,15条引用覆盖了14个不同域名,其中大量是百度上搜不到的小型财税公司官网。这说明在秘塔中,垂直小站有真实被引用的机会。
第三步:定位自身网站在引用池中的位置
搜索完成后,在记录表中查找自己的网站域名是否出现、出现了几次、在哪个引擎中出现。通常存在三种情况:
情况一:四个引擎中都没有出现。说明内容尚未进入任何AI引擎的引用池。此时需要检查内容铺了哪些平台。如果只发了公众号和官网,而行业在豆包的引用源全是CSDN和头条,那么内容写得再好也无法被引用。
情况二:某个引擎出现了,其他没有。说明内容方向正确但平台覆盖不够。例如在豆包被引用但秘塔没有,需要查看秘塔在行业中的引用源是哪些平台,去这些平台补充内容。
情况三:多个引擎都出现了但引用次数少。说明已经进入引用池,接下来需要优化内容结构。参考arXiv论文数据,添加引用来源、统计数据、直接引语是提升引用率最有效的方式。
第四步:固定周期复查
单次查询只能反映当前时刻的状态。AI引擎的引用池是动态变化的,平台权重会调整,算法会更新,新内容也会不断挤压旧内容的位置。建议每月固定一天,使用同一组提问词在四个引擎中重新搜索,记录出现次数和引用来源的变化。
这个动作每月耗时约半小时。连续执行三个月后,就能看到自身位置的变化趋势——是哪个引擎在掉,哪个平台的内容在起作用。将AI搜索优化当作数据实验来对待,而不是玄学。
四、未收录的常见原因与两个辅助信号
如果自查后发现未被收录,多数问题并不在内容数量上,而在于内容链路。AI引擎不会凭空发现网站,它只引用平台已经推荐过的内容。完整的链路是:编写内容→按照平台推荐规则调整→平台推荐→平台权重上涨→AI爬虫高频抓取→被引用。很多人跳过了平台推荐这一步,直接研究Schema.org、llms.txt等技术层内容,结果内容根本没有铺到AI会抓取的平台上。
另外,一键分发工具也是常见问题。一篇文章在5个平台需要5个不同版本,标题、结构、字数、情绪强度都不一样。一键分发等于用同一个版本铺所有平台,违背了每个平台的推荐规则,结果就是哪个平台都推不起来。自己手动修改5个版本虽然慢,但每个版本都对题。
还有一种情况是铺了"死号"。注册了CSDN后只发了两篇内容,阅读量为零,账号权重为零。AI爬虫抓取的是平台推荐池中的内容,零权重账号发布的内容根本进不了推荐池,AI自然也不会抓取。
除了主动搜索提问词,还有两个被动信号可以辅助判断:
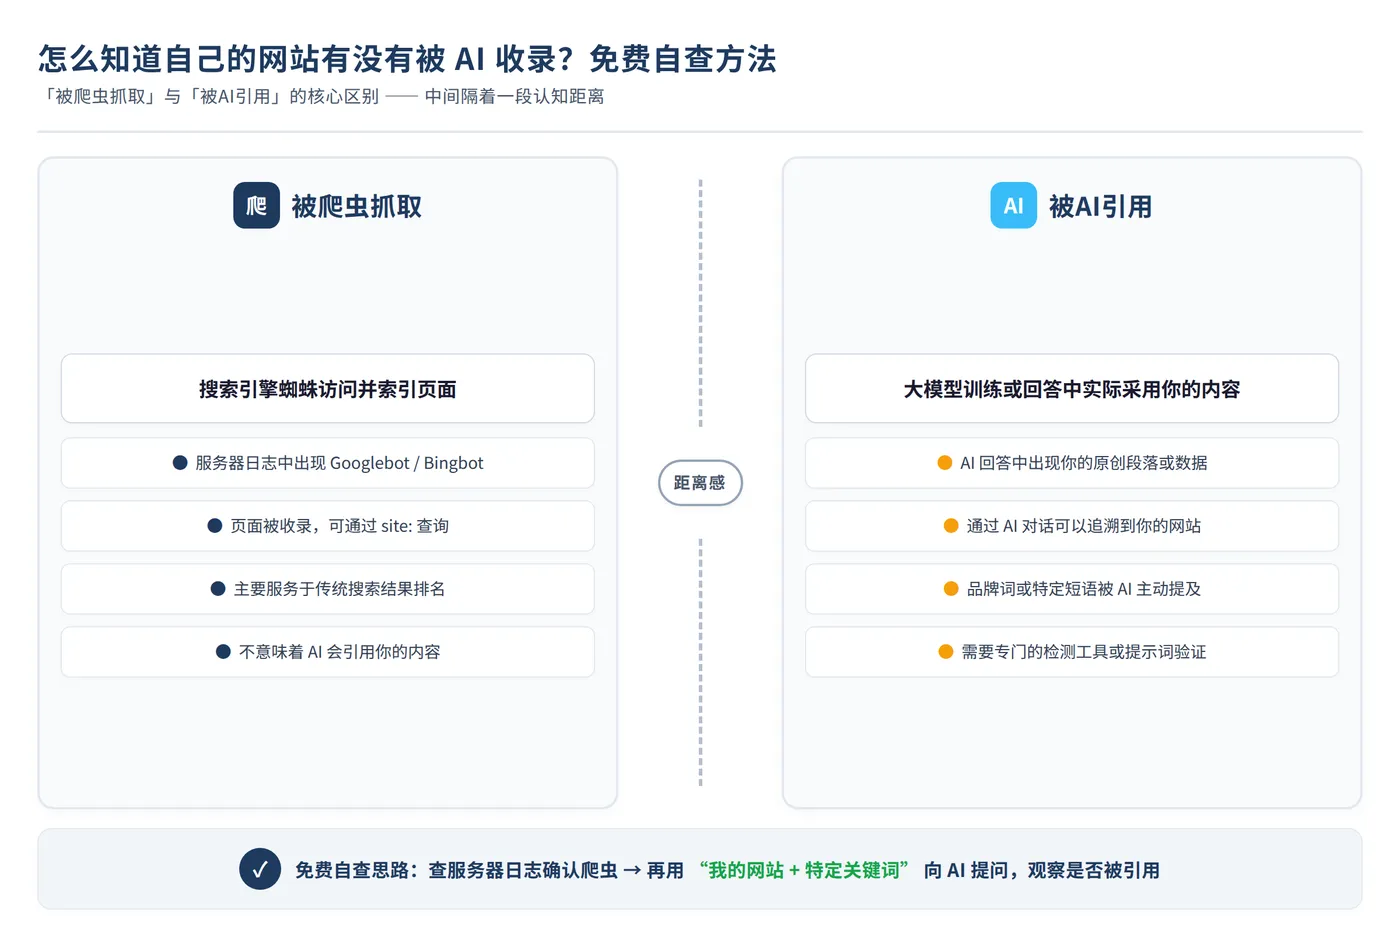
信号一:服务器日志中的爬虫记录。打开服务器日志,搜索"GPTBot"、"ClaudeBot"、"Bytespider"、"Bingbot"等爬虫标识。如果这些爬虫最近访问过网站,说明AI引擎的抓取程序已经知道域名存在。但被抓取不等于被引用,爬虫访问只是其一,离被引用还隔着内容质量和平台权重两道关。
信号二:搜索品牌名加行业词。例如搜索"V哥AI增长 AI搜索优化"。如果AI答案中能出现品牌名,说明AI已经将品牌视为可识别的信息源。这个方法比通用提问词更精准,因为品牌名是唯一的。但品牌名搜索只能说明AI"知道"品牌,不能说明AI在回答客户问题时"引用"了品牌内容。
五、结语:将自查变成常态化数据实验
AI引擎的引用机制是一个动态演进的系统,不同引擎有不同偏好,同一引擎的算法也在不断调整。通过每月定期执行四步自查法,记录引用源的变化趋势,能够逐步建立起对AI引用机制的直观认知。这套方法不需要额外成本,只需要持续记录和对比。当连续三个月的数据积累起来后,就能清晰地看到哪些平台的内容建设在发挥作用,哪些方向需要调整。将AI搜索优化视为一个数据驱动的长期实验,而不是一次性的内容发布,才能真正理解并适应AI引擎的引用逻辑。