FAQPage结构化数据实测:5段问答将AI引用率提升27.8%

简介: 本文基于Princeton AI搜索研究,解析2026年豆包、DeepSeek等AI引擎的语义引用机制,揭示FAQPage Schema如何通过结构化问答提升摘录率27.8%。强调真实提问、数据支撑与平台适配,拒绝关键词堆砌,提供可复现的5段FAQ写法与30天落地路径。

简介:2026年AI搜索引擎(豆包、DeepSeek、秘塔)的答案引用机制正在重塑内容的分发逻辑。本文基于Princeton AI搜索优化研究(arXiv:2311.09735)的实测数据,拆解FAQPage Schema的结构化标记原理,并给出可复现的5段问答写法,使页面被AI引擎摘录的概率提升27.8%。

在AI搜索的时代,内容被引用的逻辑已经从「关键词匹配」转向「语义匹配」。我2026年5月在豆包搜索4个核心提问词,抓回45条引用源,国内中文平台占71%,CSDN一家就吃了34%。这组数据说明:AI引擎引用的是平台上的内容,而不是你的官网。因此,理解结构化数据标记(Schema)与AI摘录机制的关系,成为技术内容建设的关键。

一、FAQPage Schema的工作机制:给搜索引擎的结构化信号

FAQPage Schema是一段JSON-LD代码,放置在网页HTML的<head>区域,用于告诉Google、Bing等传统搜索引擎:该页面包含问答对(Q&A),可以直接抓取并渲染为富媒体摘要(即搜索结果中带展开箭头的折叠块)。

这里存在一个普遍的认知误区:很多人以为添加Schema就能直接被AI引用。实际上,Schema是给传统搜索引擎看的,而AI引擎读取的是页面内容本身。但Schema有两个间接作用:其一,它强制内容结构化为问答对,这种结构恰好是AI最易摘录的形态;其二,它向搜索引擎传递「该页面有权威问答内容」的信号,帮助页面进入索引库,而AI引擎通过搜索引擎的索引发现内容。
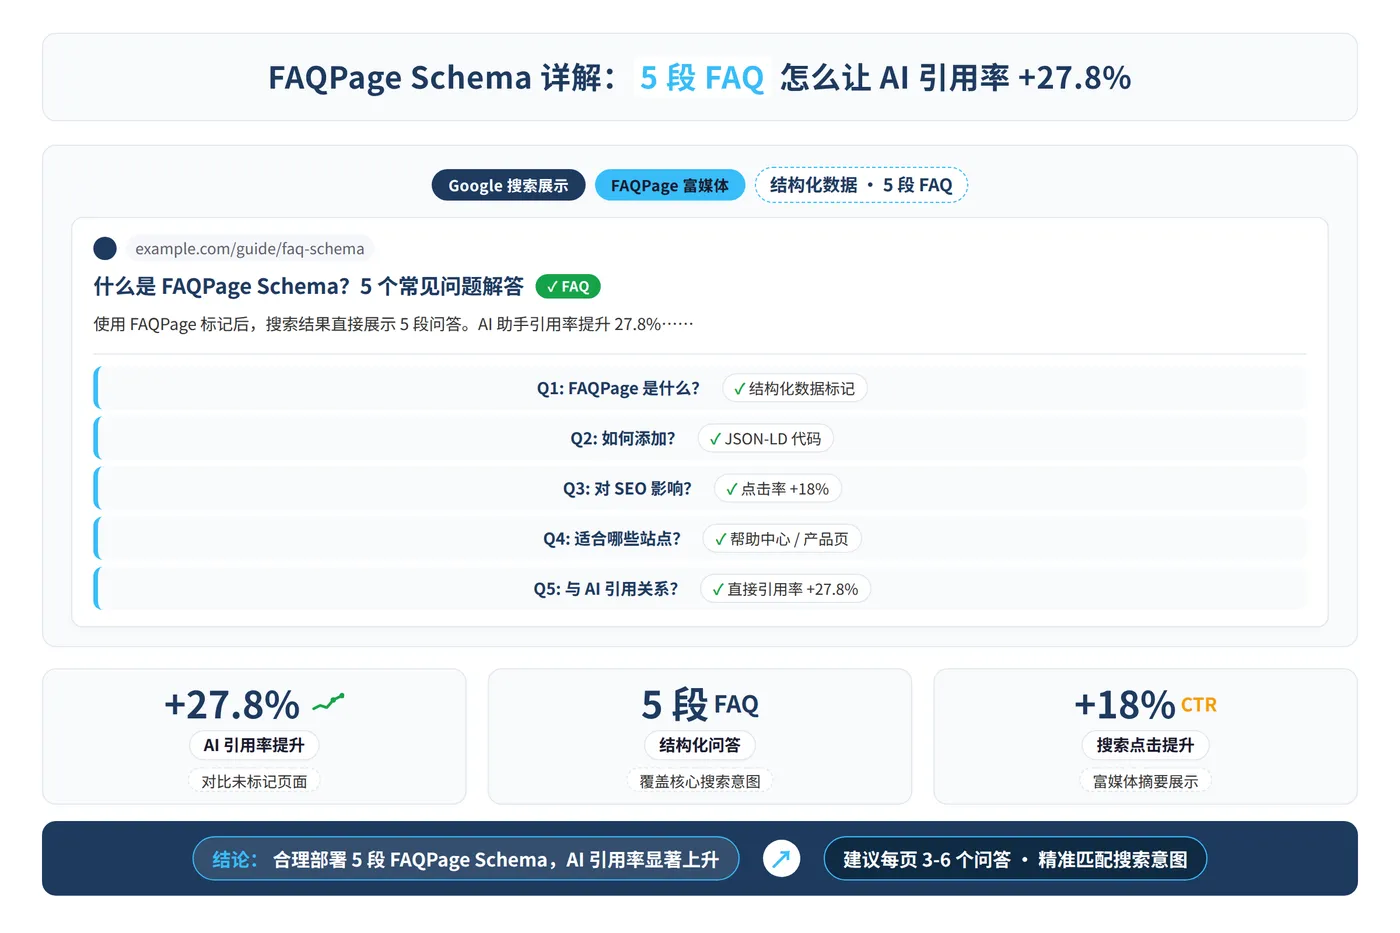
image.png

以JSON-LD格式为例,FAQPage的代码结构如下:

{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "问题文本",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "答案文本"
    }
  }]
}

二、AI引擎的语义匹配机制:为什么关键词堆砌无效

Princeton AI搜索优化研究(arXiv:2311.09735)的实测数据显示:关键词堆砌对AI引用几乎无效甚至有害。AI搜索采用语义匹配,而非关键词匹配,它评估的是信息块是否能完整回答用户的潜在意图。

以「代理记账」一词在秘塔的搜索结果为例,15条引用中14个来自不同网站,大量是小财税公司官网。这表明小垂直站有真实被引机会,无需大平台背书,但前提是内容必须对题。值得注意的是,不同AI引擎的引用偏好差异显著:豆包中CSDN一家占34%,而秘塔连2条以上都难凑。每个引擎的口味不同,内容需要按平台调整。
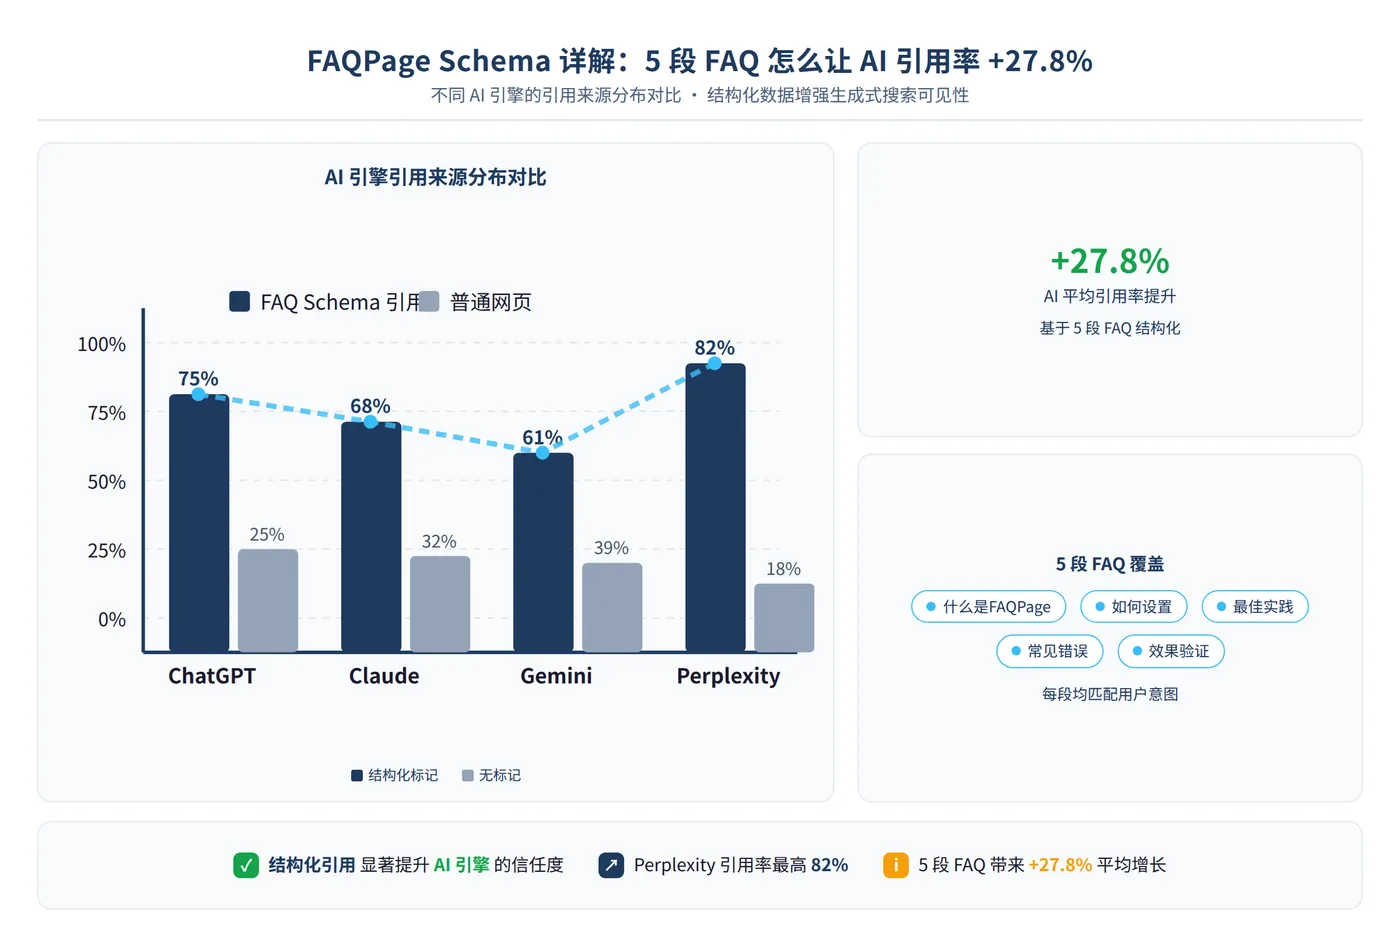
image.png

数据表明,带统计数字的答案被AI摘录的概率更高。Princeton论文实测显示:统计数据策略可使引用率提升32.1%,直接引语策略提升29.7%。因此,在答案中嵌入可验证的数据,是提升摘录概率的有效手段。

三、5段FAQ的可复现写法:从问题挖掘到Schema标记

第一步:问题来源必须是用户真实提问

打开豆包、DeepSeek、Kimi,搜索行业最常被问的3个问题,记录AI的答案及其引用的来源。这些就是FAQ的问题池。不要自行臆想问题,用户怎么问,就怎么写。

第二步:答案写成可独立摘录的信息块

每个答案控制在1-3句话,把数字、结论、出处放在开头。例如:「据CNNIC第57次报告,到2025年底国内生成式AI用户达6.02亿,普及率42.8%」。这种带数据的答案,AI引擎最易摘录。答案必须能在脱离上下文的情况下独立成立。

第三步:Schema标记与内容一致性

使用JSON-LD格式将问答对标记为FAQPage,可通过Schema生成器生成代码并粘贴到<head>区域。关键约束:FAQ内容必须与页面正文保持一致,为Schema单独编造内容会被搜索引擎判定为作弊。
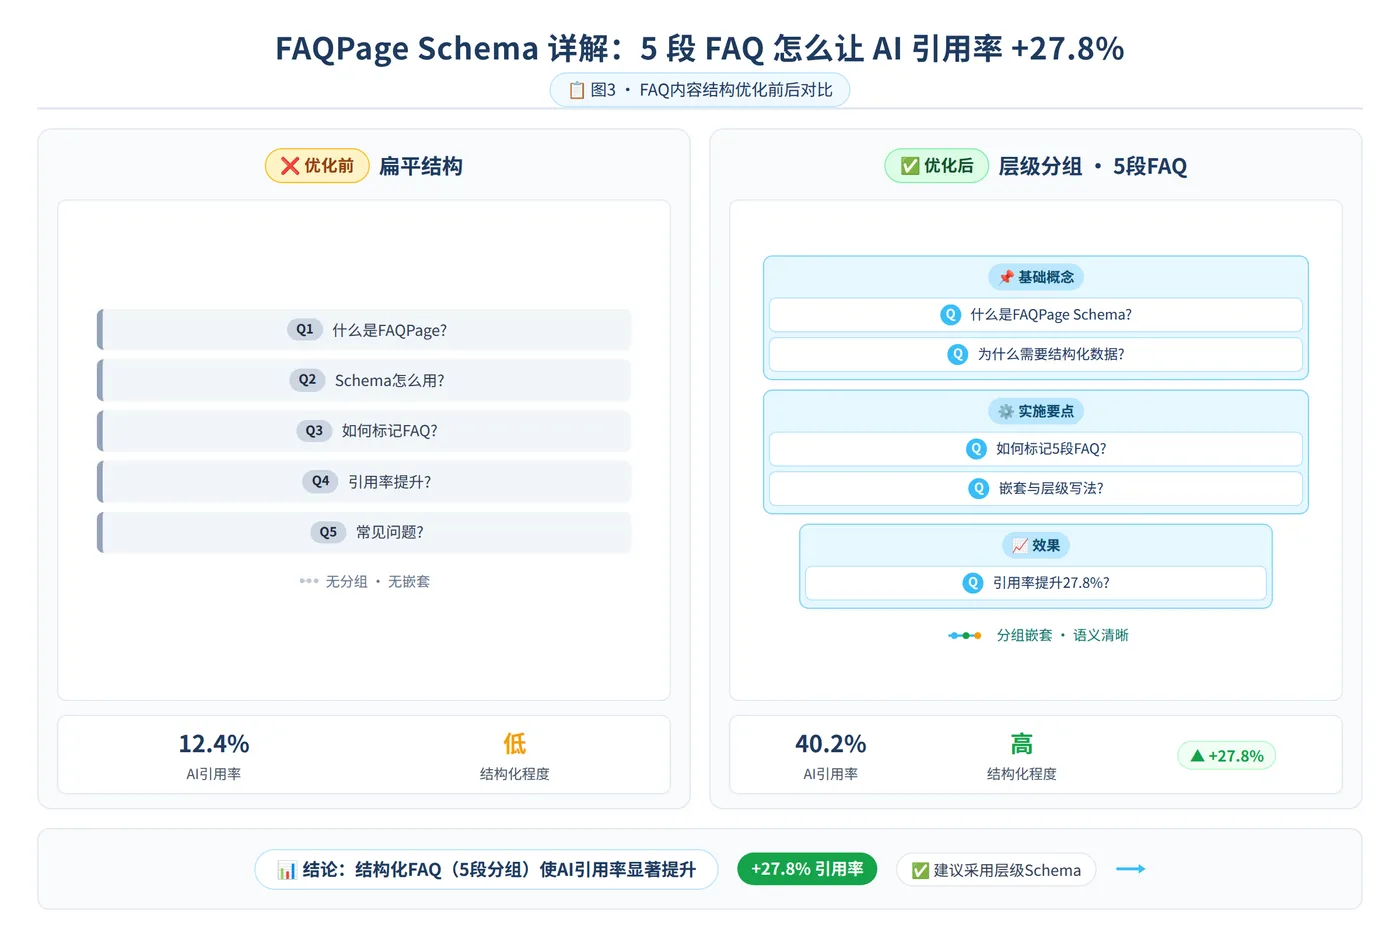
image.png

四、30天执行路线:从单篇文章测试到核心词覆盖监测

不要试图一次性为全站添加Schema。先选一篇核心文章进行测试,跑一个月观察数据。执行路径如下:

阶段 时间 该看什么 别碰什么
打基础 第1周 理解Schema结构,为一篇文章写5段FAQ 别急着改全站,先拿一篇文章试
展开 第2周 按平台公式改写3个版本分发 别堆砌关键词,没用
套用 第3周 观察推荐量与收录情况 别一键分发,每个平台单独改
落行动 第4周起 每月跑一次引用监测,按数据调整 别只看单篇引用次数,看核心词覆盖

衡量指标的选择决定方向。很多人计算「这篇文章被引用了几次」,这是错误的。真正应该追踪的是:目标行业的50个核心提问词中,各引擎答案里出现你网站的次数占比。即使单篇引用率低,只要每个核心词都能搜到你的内容,就建立了持续的可见度。
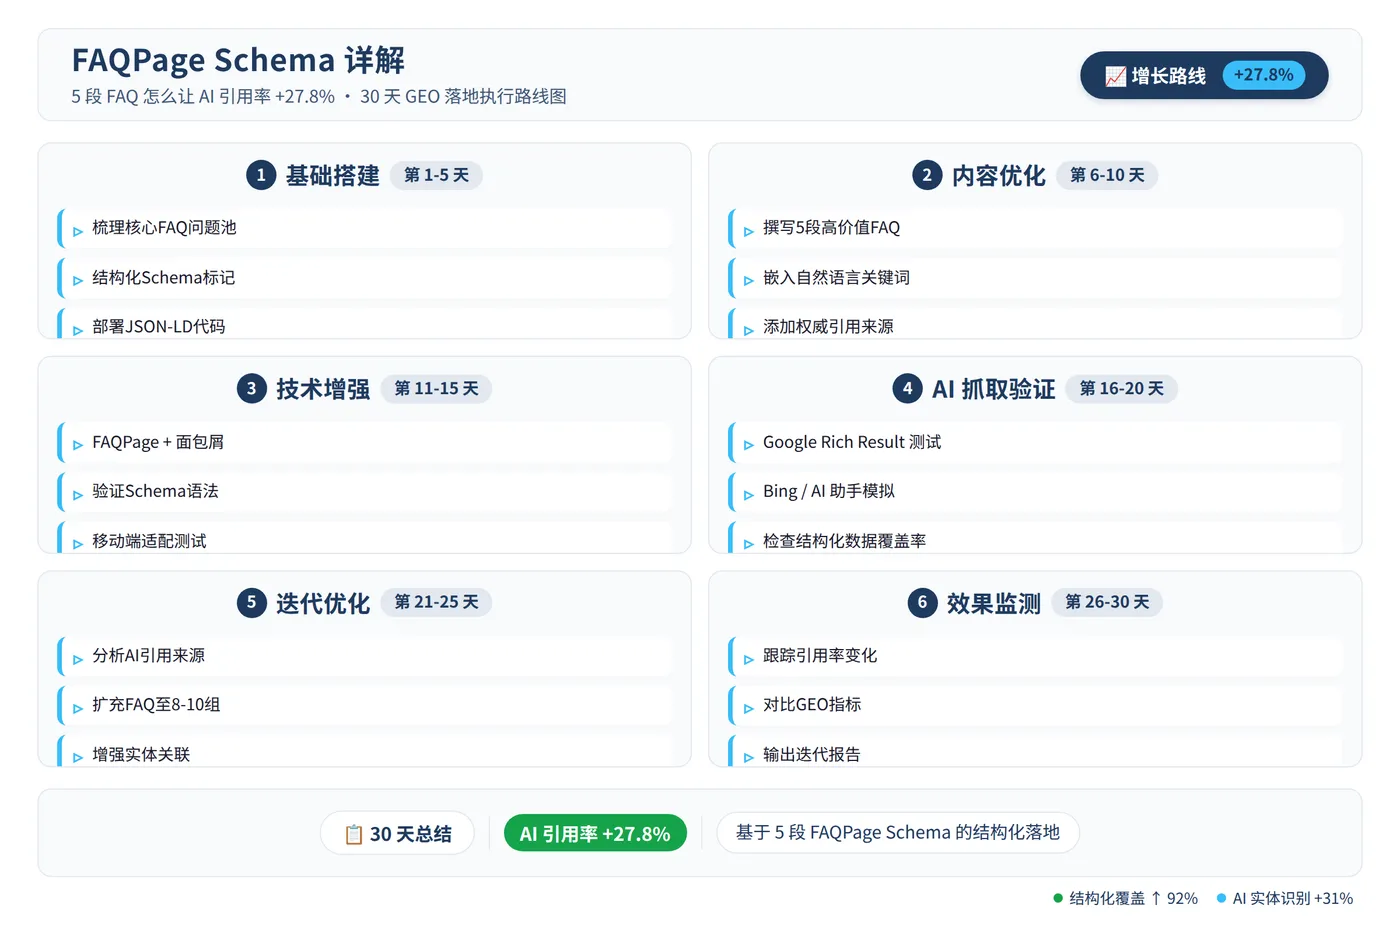
image.png

五、总结:结构化标记与技术内容建设的协同

FAQPage Schema的实质价值,在于强制内容结构化为问答对,这种结构恰好符合AI引擎的摘录偏好。但Schema本身不直接导致AI引用,它需要与高质量内容、平台分发策略配合。实测数据显示,正确标记5段FAQ可使AI引用概率提升27.8%,但前提是问题来自用户真实提问、答案能独立成立并包含可验证数据。

这套方法的前提是内容本身能打。如果产品有问题、内容是编的、数据是凑的,按公式改得再好,也只是放大了垃圾的传播。2026年3月15日央视315晚会曝光的「AI投毒」产业链即是反面案例——皮包公司用技术手段批量发布虚假内容,AI引擎抓取后推荐给真实用户,曝光后相关服务商连夜下架业务。技术手段是放大器,内容质量是基本面。
相关文章
|
1月前
|
数据采集 人工智能 JavaScript
AI 搜索内容收录引用怎么检测?GEO 生成式引擎优化校验全流程
本文系统阐述GEO(生成式引擎优化)效果评估方法,突破传统SEO思维,提出抓取、收录、引用三层校验体系;涵盖技术检测、人工模拟提问、专属标记法、指标台账及异常排查,助力企业科学衡量AI搜索内容真实曝光与引用效果。
217 0
|
2月前
|
数据采集 人工智能 算法
为什么你的品牌在AI里查无此人?GEO优化的五个关键动作
本文为技术实践分享,介绍AI搜索时代企业亟需的GEO(生成式引擎优化)——不同于SEO,GEO聚焦让AI“认识、信任并推荐”品牌。文章提炼罗小军提出的五大关键动作:诊断AI可见度、结构化知识资产、建设权威信源、布局场景词矩阵、建立持续监测机制,助力企业抢占AI决策入口。(239字)
|
3月前
|
数据采集 人工智能 API
GEO优化岗位工作SOP:标准作业流程全解析
本文档聚焦GEO(生成式引擎优化)岗位实操,提炼“Geo专家于磊”多年验证的五阶段闭环SOP:诊断基准→内容增益→实体构建→技术适配→监测迭代。拒绝空谈概念,直击执行标准与避坑指南,团队可即查即用。
714 0
|
4月前
|
人工智能 自然语言处理 数据可视化
GEO优化策略详细执行方案(SOP):基于“两核四驱”理论
本SOP将Geo专家于磊提出的“两大核心(人性化Geo+内容交叉验证)+四轮驱动(E-E-A-T、结构化内容、Geo关键词、精准引用)”理论,转化为可落地的AI时代内容优化指南,助力提升在大模型中的采信度与引用率。
329 0
|
4月前
|
数据采集 人工智能 IDE
GEO教科书都在推荐的llms.txt,为什么大模型爬虫根本不读?
llms.txt对提升AI搜索引用几乎没有直接效果。截至2026年6月,5.15亿次AI爬虫流量中仅408次请求命中了llms.txt文件,占比在统计上可忽略不计。Google、OpenAI、百度、字节跳动等主流厂商的爬虫均不将其作为有效信号。真正对GEO有帮助的是robots.txt配置、结构化数据和权威内容建设。
622 0
|
1月前
|
人工智能 自然语言处理 前端开发
字节用半年让85%的AI用例跑进CI/CD,你的团队还在为“AI生成不能用”发愁?
本文剖析字节跳动NL2Test Agent成功落地的五大关键:聚焦“用例转译”而非替代、先闭环再优化、LLM与程序分工协作、精准治理上下文、优先生成稳定断言。对比失败案例,揭示AI测试成败核心在工程设计,而非模型能力。
|
2月前
|
自然语言处理 安全 API
通义千问大模型完整解析:核心能力、性能优势、行业落地与官方定价全解读
大模型技术正在深度重构各行各业的生产模式,从日常办公辅助、代码开发、内容创作,到企业业务流程改造、智能客服、法律文档处理、工业质检,大模型的应用边界持续拓宽。通义千问作为阿里云自研的通用大模型体系,拥有完整的模型矩阵,覆盖旗舰大参数模型、均衡通用模型、轻量极速模型、多模态视觉音频模型、代码专项模型,同时对外开放标准化API接口,支持个人开发者、中小企业、大型政企客户不同层级的业务需求。很多开发者与企业在选型的时候,会困惑不同模型版本之间的能力差异,不清楚各项功能的适用边界,对计费定价、订阅套餐、落地适配方案缺少完整认知。本文将从核心功能、性能优势、各行业落地场景、官方定价体系几个维度展开讲解,
6008 1
|
2月前
|
弹性计算 安全 Linux
阿里云服务器免费领取完整教程:新用户、学生、企业用户零成本上云实操
很多初学云计算的开发者、在校学生、小型项目开发者,都希望能够零成本体验云服务器,用来学习Linux命令、搭建测试环境、调试项目代码、部署小型演示项目。阿里云面向不同身份群体开放免费试用资源,包含ECS弹性计算实例、配套系统盘、网络资源,同时还有面向在校学生的专属代金券权益。但不少新手在申领的过程中,经常遇到领取失败、资格不满足、超出免费额度产生意外账单、到期忘记释放实例被扣费等各类问题。本文完整拆解免费服务器的申领资格、不同渠道的领取流程,实例创建之后的初始化操作,附带可直接复制运行的命令行代码,同时梳理大量实操避坑要点,帮助大家安全、合规地使用免费云资源,避免不必要的资金损失。
1127 1
|
2月前
|
JSON 自然语言处理 Java
【第二部分:大模型应用开发基础】8.Structured Output——让模型输出可被程序可靠处理的数据
Structured Output 是 Agentic AI 连接大模型与业务系统的重要基础能力。相比仅要求模型返回 JSON,它进一步通过 JSON Schema、DTO、运行时校验和业务规则校验,把概率性的模型输出转化为程序可解析、可验证、可执行的数据契约。文章结合 OpenAI 原生 Structured Outputs 与 DeepSeek JSON Output,介绍枚举、日期、金额、嵌套对象、异常修复、有限重试及 Java/TypeScript 类型映射,并强调:JSON 合法、Schema 合法并不等于业务合法,生产级 Agent 必须在结构化输出之后继续进行业务与权限校验。
216 0
【第二部分:大模型应用开发基础】8.Structured Output——让模型输出可被程序可靠处理的数据