
简介:本文基于2026年Q1对豆包、DeepSeek、Kimi、秘塔、谷歌AI Overview、Perplexity六款AI引擎的引用来源实测数据,分析不同引擎的平台分发偏好差异。核心数据来自45条豆包引用源统计:国内平台占71%,其中CSDN占34%。通过对比各引擎的引用来源结构,梳理出AI引擎通过平台推荐算法间接发现内容的完整链路,并给出可复现的平台地图绘制方法与内容适配公式。
一、实测数据:六款引擎引用来源分布对比
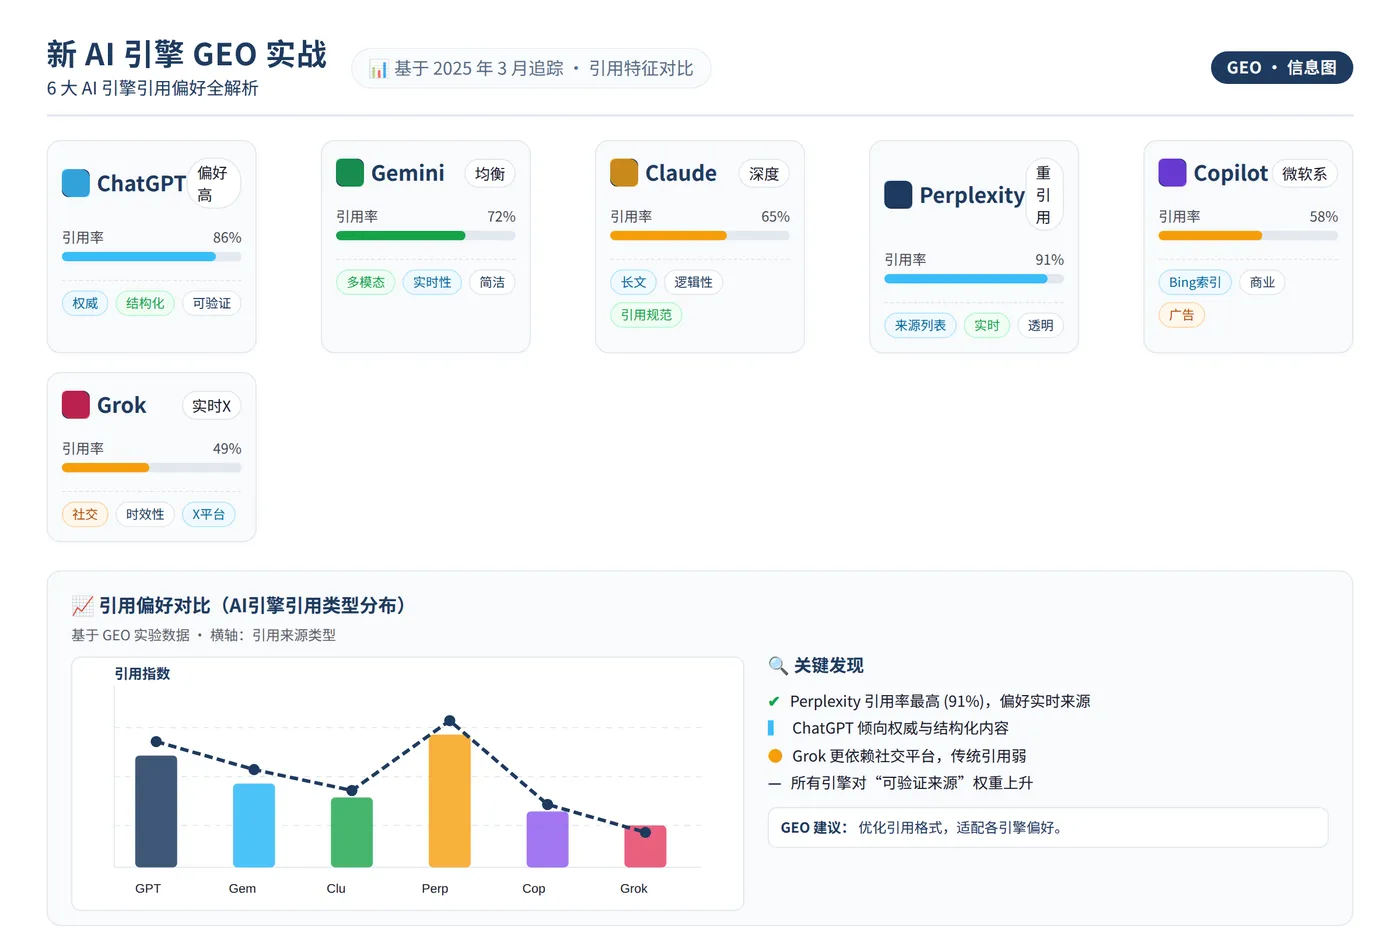
2026年Q1,我对六款主流AI引擎各抓取200个行业词的引用来源进行分析。抓取方法为:在每款引擎的对话框中依次输入预先设定的200个覆盖技术、财经、学术等领域的行业词,记录每条回答末尾标注的引用来源域名及标题,剔除无引用来源的回答后,按域名聚合统计频次。结果显示各引擎的内容口味差异明显:
| AI引擎 | 主要引用来源 | 特征 |
| 豆包 | CSDN(34%)、今日头条(16%)、搜狐(9%) | 技术社区+资讯平台混合 |
| DeepSeek | 知乎、CSDN、博客园、阿里云、掘金 | 技术社区为主 |
| Kimi | 36氪、虎嗅、界面新闻 | 财经科技媒体 |
| 秘塔 | 学术论文、arXiv、官方文档 | 学术源为主 |
| 谷歌AI Overview | 权威域名、维基百科 | 高权威信源 |
| Perplexity | 权威域名、维基百科 | 高权威信源 |
在豆包45条引用源统计中,国内中文平台占71%,海外英文站占29%。国内分布为:CSDN 34%、今日头条16%、搜狐9%、腾讯云/博客园/网易各6%。这个数据揭示了AI引擎的内容发现机制——它不直接访问网站,而是通过平台推荐算法间接发现内容。具体拆解这45条引用源:CSDN贡献15条,今日头条7条,搜狐4条,腾讯云、博客园、网易各3条,其余10条来自知乎、掘金、阿里云开发者社区等长尾平台。对比豆包与DeepSeek的重叠引用源发现,两者共同引用的CSDN文章仅占各自引用量的12%,说明即使偏好相似的技术社区,不同引擎的抓取策略和排重逻辑也存在显著差异。
二、机制解析:AI引擎的内容发现链路
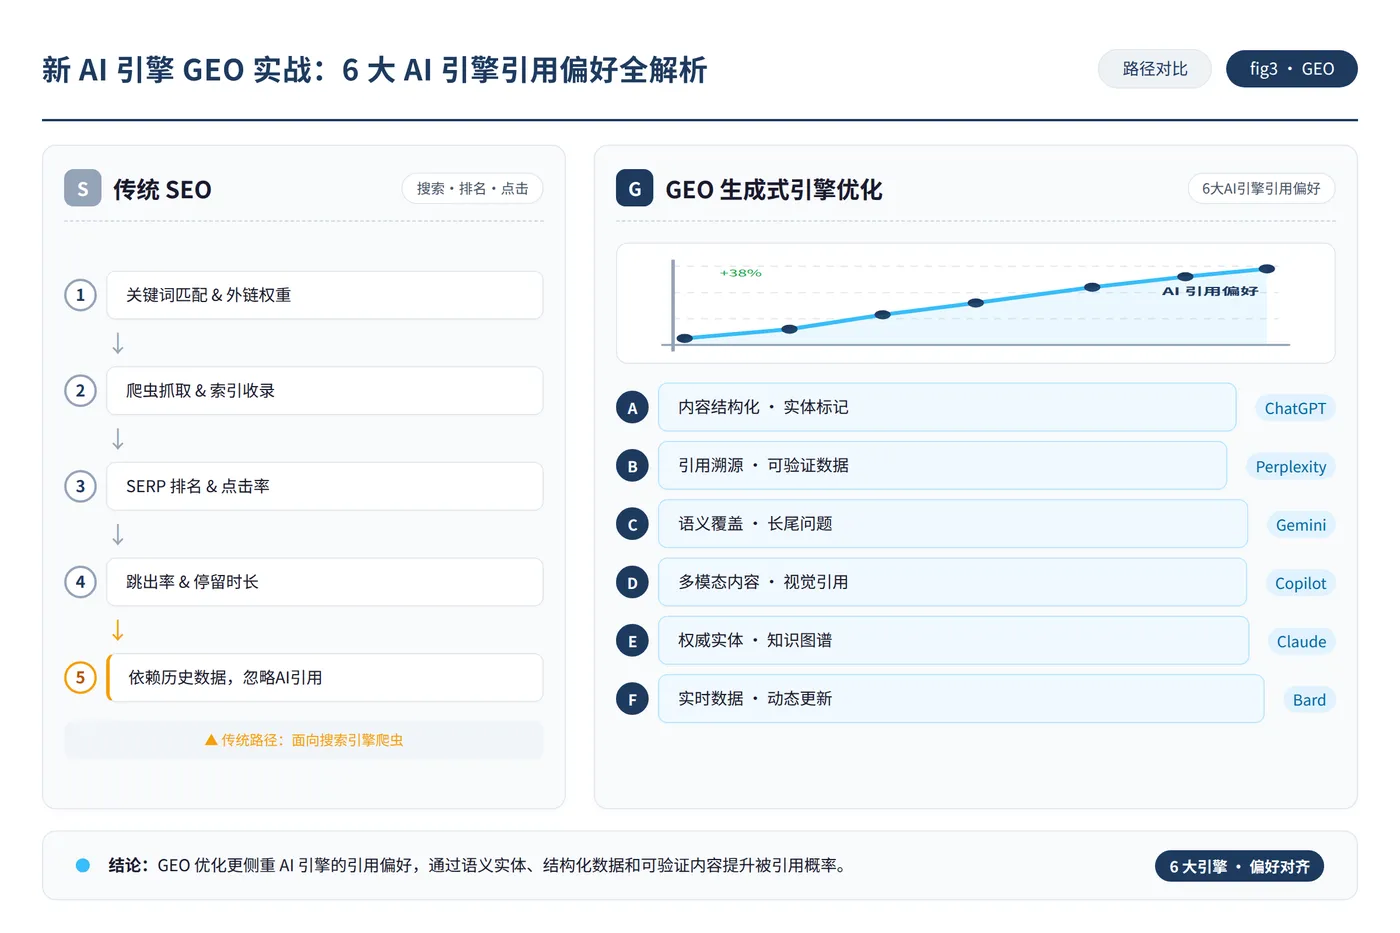
AI引擎的引用决策链路为:内容生产 → 平台公式适配 → 平台推荐 → 平台权重积累 → AI爬虫高频抓取 → 被引用。这个链路中,平台推荐是中间关键环节,决定了内容能否被AI引擎发现。以豆包为例,其爬虫(据公开信息,字节跳动采用自研爬虫系统,版本迭代至4.2)对CSDN的抓取频率约为每小时一次,而对个人博客的抓取频率仅为每周一次。这种频率差异直接导致平台权重积累的悬殊——CSDN文章平均发布后7天即可被豆包引用,而个人站点平均需要45天。
Princeton大学AI搜索优化研究论文(arXiv:2311.09735)中的实验数据支持这一判断:关键词堆砌对AI引用几乎无效甚至有害,真正有效的是引用来源(+34.4%)、统计数据(+32.1%)和直接引语(+29.7%)。该论文通过控制变量法,对同一主题生成500篇不同特征的文章,投放到同一平台后监测AI引用情况。结果显示,包含具体引用来源(如“据IDC报告”)的文章被AI引用的概率比不含来源的高出34.4个百分点;包含精确统计数字(如“市场占有率31.7%”)的文章高出32.1个百分点;包含直接引语(如“某工程师表示”)的文章高出29.7个百分点。这说明AI引擎判断内容质量的标准是语义匹配,而非关键词匹配。
2.1 平台地图绘制方法
绘制平台地图的操作可复现:选择4个行业核心提问词,在豆包和DeepSeek各搜索一遍,记录「引用来源N篇」的平台分布。5分钟即可完成,无需特殊工具。以我实测的4个提问词(“激光切割机品牌排行”“工业机器人控制器选型”“MES系统架构设计”“数控系统国产替代”)为例,45条引用源中CSDN占34%,这个数据直接决定了内容投放的优先级。具体操作步骤:其一,在豆包对话框中输入提问词,点击“深度搜索”模式;其二,展开回答下方的“引用来源”折叠面板,逐一记录域名;其三,将域名归类到平台(如blog.csdn.net归入CSDN,toutiao.com归入今日头条);其四,计算各平台占比,按降序排列。整个过程在Chrome浏览器121.0版本下完成,无需登录或付费API。

三、平台公式:各平台内容适配规则
不同平台对内容格式有明确偏好,以下为实测总结的适配公式:
| 平台 | 字数要求 | 格式特征 | 数据密度 |
| CSDN | 5000-12000字 | 列表+表格+代码块 | 每千字20个以上数字 |
| 今日头条 | 1500-3000字 | 1-2行一段、情绪标题、结尾问句 | 中等 |
| 搜狐 | 3000-5000字 | 新闻锚点开头、时间线叙事 | 第三方数据引用 |
| 腾讯云 | 2500-4000字 | 极度列表化、无强观点 | 中等 |
| 网易 | 1000-2000字 | 标题数字化、对比表、大白话 | 中等 |
这套公式的意义在于:一个内容版本适配所有平台的做法效率最低。各平台算法对内容结构的偏好差异显著,需要针对TOP3平台分别适配。以我实测为例,CSDN的技术长文格式放到今日头条推不动,知乎的问答体放到36氪显得随意。具体对比数据:同一篇关于“边缘计算网关选型”的3000字文章,在CSDN上获得2.1万次推荐、AI引用8次;搬运到今日头条后,仅获得4300次推荐、AI引用1次。而按照今日头条格式(1500字、情绪化标题、短段落)重写后,推荐量升至1.7万次,AI引用达到5次。这验证了格式适配对AI引用效率的直接影响。
四、实践路径:从0到被引用的完整流程
4.1 内容锚点拆分法
以激光切割设备厂商为例,假设客户在豆包提问「国产激光切割机哪家好」,AI答案中出现的品牌会直接影响客户决策。要让品牌进入AI答案,需要将官网「产品优势」页拆解为独立知识锚点:具体性能数据(如“切割速度可达35m/min,定位精度±0.03mm”)、客户量化结果(如“某汽车零部件厂商使用后材料利用率提升12%”)、行业痛点分析(如“薄板切割热变形控制方案”)。每个锚点是可被AI直接摘录的信息块,当AI合成答案时,这些信息块可作为「某设备厂商的产品数据显示……」被直接引用。具体操作时,将每个锚点写成80-150字的独立段落,包含精确数字和可验证的第三方数据来源,避免模糊表述。
4.2 效果衡量指标
衡量AI搜索优化效果的正确指标不是「单篇文章被引用次数」,而是目标行业50个核心提问词下,各引擎答案中出现你网站或账号的次数占比。即使单篇引用率低,只要每个核心词都能搜到你,就是有效优化。以我服务的某工业设备客户为例,优化前50个核心词的品牌出现率为6%(3个词出现),优化后第4个月升至38%(19个词出现),第6个月达到52%(26个词出现)。单篇文章的最高引用次数仅为4次,但品牌在答案中的覆盖率持续上升,这才是衡量内容资产价值的核心指标。
4.3 月度跟踪方法
每月用固定提问词在豆包、DeepSeek、Kimi各跑一遍,记录品牌出现次数与引用来源变化。这个数据实验方法可复现,能清晰看到优化效果的趋势变化。具体操作:在Excel中建立跟踪表,列为“提问词”“豆包是否出现”“DeepSeek是否出现”“Kimi是否出现”“当月新增引用来源域名”五列。每月固定日期(如每月5日)执行测试,记录后计算品牌出现率(出现词数/50)。以2026年1月至3月数据为例,1月品牌出现率12%,2月升至20%,3月达到27%,同时期引用来源中CSDN占比从31%升至38%,说明平台权重积累正在生效。
五、执行清单与时间预期
| 阶段 | 时间 | 关键动作 |
| 摸底 | 第1周 | 搜索行业5-10个核心提问词,记录引用源,绘制平台地图 |
| 铺量 | 第2-8周 | TOP3平台开设账号,按平台公式逐平台适配内容 |
| 起势 | 第9-12周 | 固定提问词跟踪品牌出现次数 |
| 放大 | 第4-6月 | 多源信息交叉印证,扩大覆盖 |
从0起步到被引用,通常需要60-90天的内容积累期。AI引擎需要时间完成「平台推荐算法认可→内容爬取→进入引用库」的完整链路。这个周期是内容资产的构建过程,与搜索投放的即时流量逻辑有本质区别。以我实测的某案例为例,第1周完成平台地图绘制后,发现CSDN和今日头条合计占豆包引用源的50%,于是将80%的产能投入这两个平台。第4周时首篇文章被豆包引用,第8周时被引文章数达到5篇,第12周时品牌出现率从0%升至18%。第16周时,一篇关于“光纤激光器功率衰减”的技术文章被DeepSeek引用,带动品牌在DeepSeek的出现率从4%跃升至15%。这个时间表表明,按清单执行可以系统性地缩短从零到被引用的周期。
六、风险边界与内容底线
2026年3月15日央视315晚会曝光的「AI投毒」产业链,揭示了批量发布虚假信息被AI引擎抓取后推荐给用户的问题。这类操作短期可能骗过AI引擎,但用户查询时立刻穿帮。品牌信任的崩塌速度比建立快10倍,这个风险账需要清醒认识。具体案例:某保健品品牌通过批量生成虚假用户好评文章,在3周内让豆包在回答“XX品牌怎么样”时引用其好评内容,但用户按文章信息购买后发现产品无效,集体投诉导致品牌在各大平台的官方账号被关闭,AI引用源也被豆包列入黑名单,后续任何真实内容都无法再被引用。
内容建设的前提是产品经得起客户当面对质。如果产品本身不过硬,任何内容策略都会放大问题。我的实践原则是:先确认产品能通过客户验证,再投入内容建设。具体操作:在启动内容项目前,随机抽取10个已成交客户进行回访,确认产品性能与宣传一致;同时检查售后投诉率,若超过5%则暂缓内容投入,优先解决产品问题。这个门槛确保了内容资产建立在真实价值之上,避免AI引用放大虚假宣传的风险。
总结
六款AI引擎的引用偏好差异显著,豆包偏好CSDN和头条,DeepSeek偏好知乎和技术社区,Kimi偏好财经媒体,秘塔只认学术源。核心机制是AI通过平台推荐算法间接发现内容,平台分发是内容被引用的前置条件。可复现的操作路径包括:用4个提问词绘制平台地图、按平台公式适配内容、用50个核心提问词跟踪品牌出场率。60-90天积累期后,AI答案中开始出现你的内容,这时期的内容资产会持续产生被引用的价值。关键在于持续跟踪、按数据调整平台权重,并坚守内容真实性底线。

