
问题描述:按账户分组,序列号在每次活动间隔超过 1 小时后重置
一张表包含 account_number 和 dt 两个字段。每个账户的记录按时间排序,需要生成一个序列号 Seq。规则如下:
按账户分组,按日期时间升序处理
如果当前行的活动时间与上一行的时间间隔超过 1 小时,则序列号重置为 1
否则(间隔 ≤ 1 小时),序列号递增 1
源数据:
account_number dt
19 2024-04-03 07:02:02
19 2024-04-03 07:02:41
19 2024-04-03 14:58:49
19 2024-04-03 19:58:49
19 2024-04-05 14:58:49
19 2024-04-05 14:59:31
19 2024-04-17 23:56:13
20 2024-04-17 23:59:13
19 2024-04-18 00:15:13
19 2024-04-18 14:56:13
20 2024-04-18 07:41:55
20 2024-04-18 19:41:55
20 2024-04-18 19:56:55
19 2024-04-19 07:41:55
19 2024-04-19 07:42:20
19 2024-04-19 08:41:20
期望结果:
19 2024-04-03 07:02:02 1
19 2024-04-03 07:02:41 2
19 2024-04-03 14:58:49 1
19 2024-04-03 19:58:49 1
19 2024-04-05 14:58:49 1
19 2024-04-05 14:59:31 2
19 2024-04-17 23:56:13 1
19 2024-04-18 00:15:13 2
19 2024-04-18 14:56:13 1
19 2024-04-19 07:41:55 1
19 2024-04-19 07:42:20 2
19 2024-04-19 08:41:20 3
20 2024-04-17 23:59:13 1
20 2024-04-18 07:41:55 1
20 2024-04-18 19:41:55 1
20 2024-04-18 19:56:55 2
SQLazy 分步实现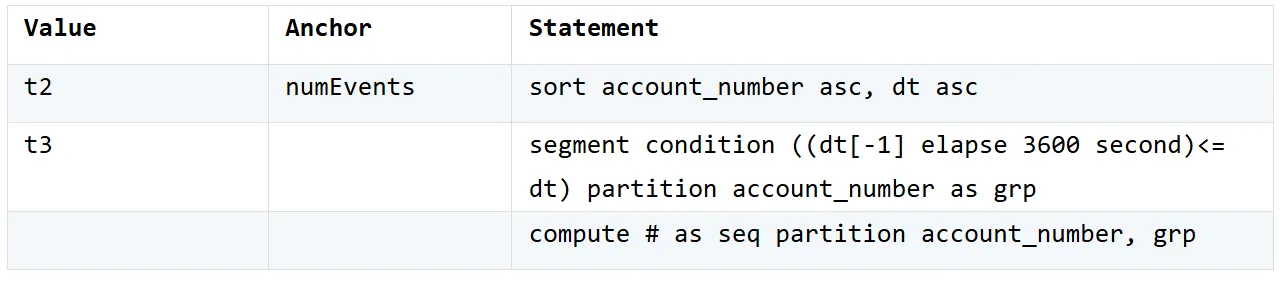
下面分别解释这些步骤。
第 1 步:按账户和日期时间升序排序
sort account_number asc, dt asc
将原始数据按 account_number 和 dt 升序排列。这一步确保每个账户内的记录按时间先后顺序处理。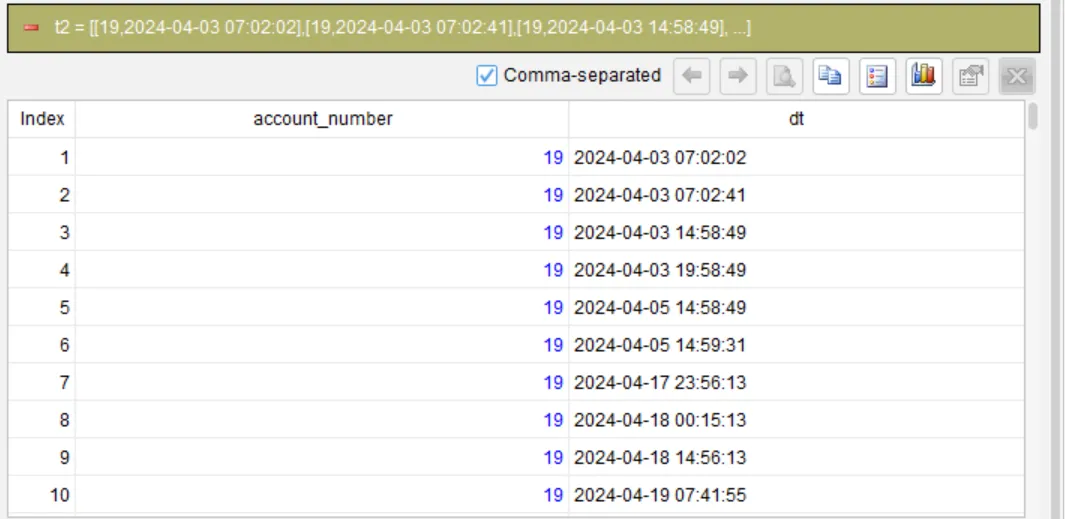
第 2 步:分段 - 判断是否超过 1 小时,生成组号
segment condition ((dt[-1] elapse 3600 second)<= dt) partition account_number as grp
在每个账户分区内,依次检查当前行的 dt 与上一行的 dt 是否间隔超过 1 小时(3600 秒)。条件 (dt[-1] elapse 3600 second) <= dt 的含义是:“上一行的时间加上 3600 秒后,是否小于等于当前行的时间”。如果成立,说明间隔 ≥ 1 小时,则新开一个组;否则与上一行同组。最终为每个记录生成一个组号 grp。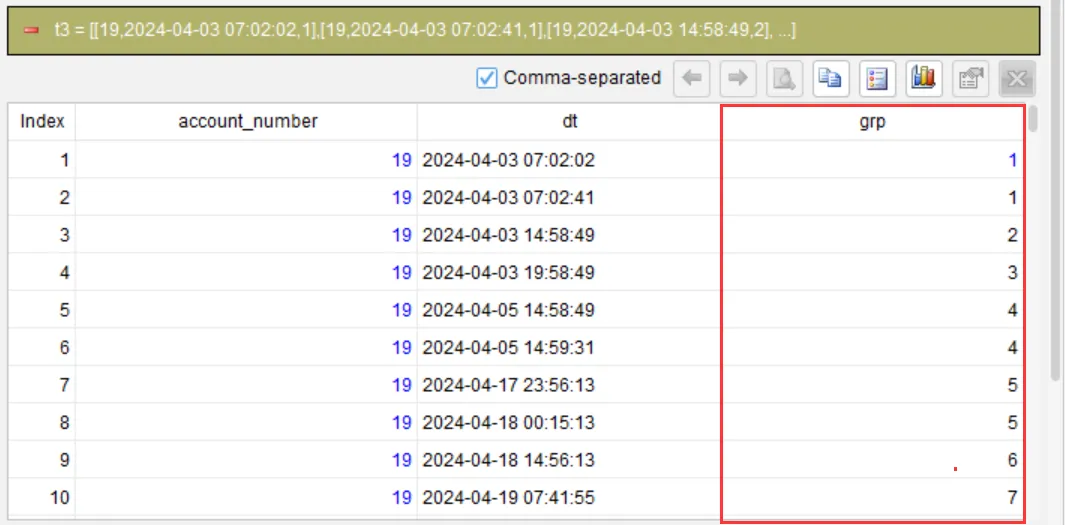
第 3 步:在每个 (account_number, grp) 内生成组内序号
compute # as seq partition account_number, grp
表示按分区内的当前顺序自动生成的序号(从 1 开始)。这里按账户和组号分区,在每个分区内按原顺序(已排序)生成序号 seq。这正是我们需要的序列号。
执行后,最终输出如下: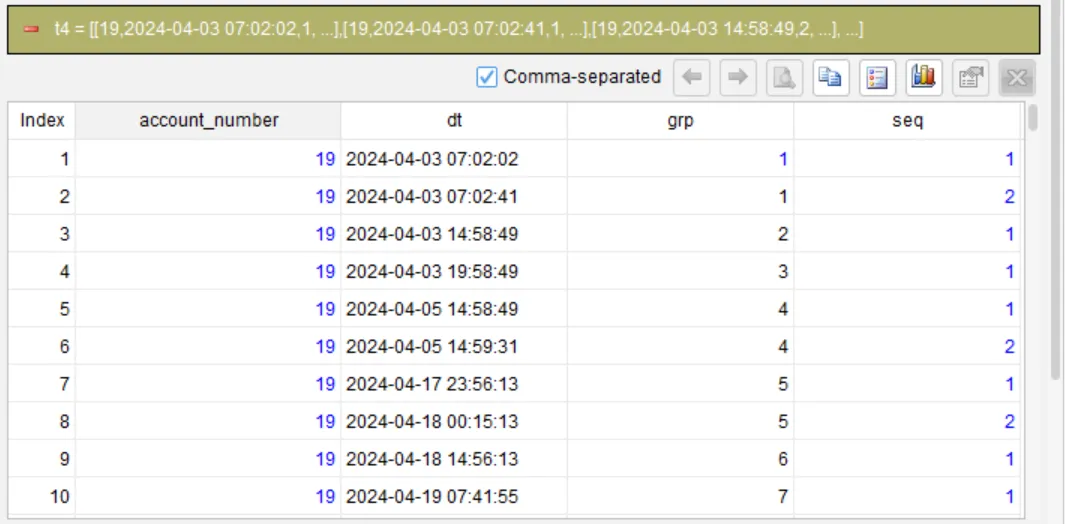
最后删除辅助列 grp(或直接输出所需列)即可得到期望结果。
编译生成 SQL
完成上述步骤后,通过 SQLazy 的编译器可以生成等价的原生 SQL,无需手动编写。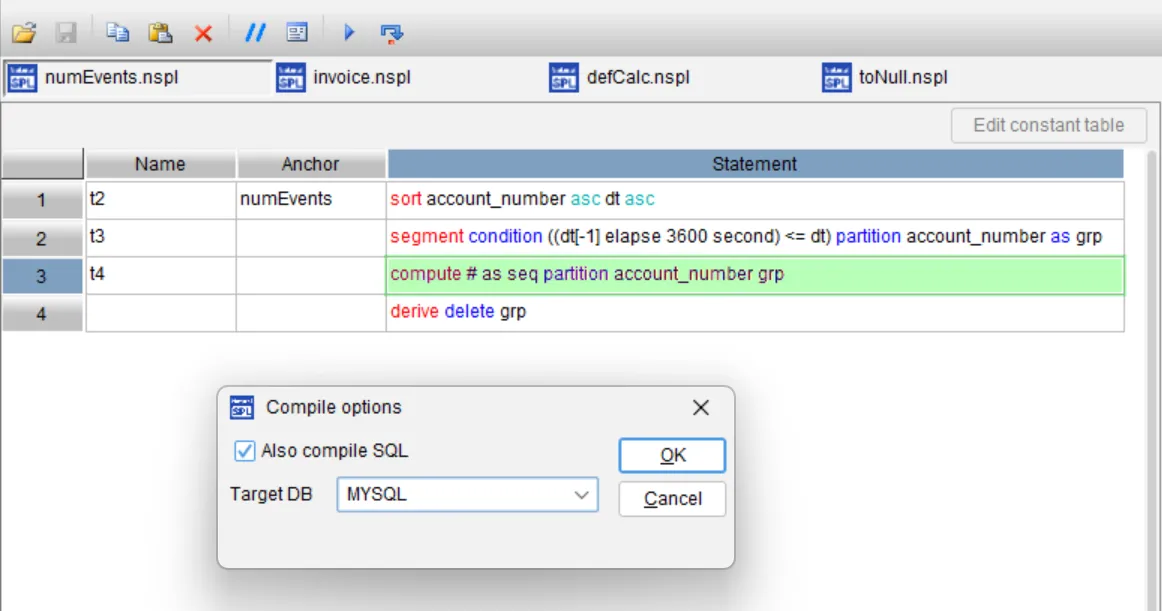
以下是生成的目标数据库语句(以 MySQL 为例):
WITH t2 AS (
  SELECT
    account_number,
    dt
  FROM
    numEvents
),
t3 AS (
  SELECT
    account_number,
    dt,
    SUM(
      CASE
        WHEN (col__5 + INTERVAL 3600 SECOND <= dt) THEN 1
        ELSE 0
      END
    ) OVER (
      PARTITION BY account_number
      ORDER BY
        CASE
          WHEN account_number IS NULL THEN 1
          ELSE 0
        END,
        account_number ASC,
        CASE
          WHEN dt IS NULL THEN 1
          ELSE 0
        END,
        dt ASC
    ) + 1 AS grp
  FROM
    (
      SELECT
        t2.*,
        LAG(dt) OVER (
          PARTITION BY account_number
          ORDER BY
            CASE
              WHEN account_number IS NULL THEN 1
              ELSE 0
            END,
            account_number ASC,
            CASE
              WHEN dt IS NULL THEN 1
              ELSE 0
            END,
            dt ASC
        ) AS col__5
      FROM
        t2
    ) sub__6
)
SELECT
  account_number,
  dt,
  grp,
  ROW_NUMBER() OVER (
    PARTITION BY account_number,
    grp
    ORDER BY
      account_number,
      CASE
        WHEN account_number IS NULL THEN 1
        ELSE 0
      END,
      account_number ASC,
      CASE
        WHEN dt IS NULL THEN 1
        ELSE 0
      END,
      dt ASC
  ) AS seq
FROM
  t3
ORDER BY
  account_number,
  CASE
    WHEN account_number IS NULL THEN 1
    ELSE 0
  END,
  account_number ASC,
  CASE
    WHEN dt IS NULL THEN 1
    ELSE 0
  END,
  dt ASC
你不需要读懂或调试这段 SQL,只需确认前面三步的逻辑正确,编译器就会输出可运行的代码。
列个表格总结一下: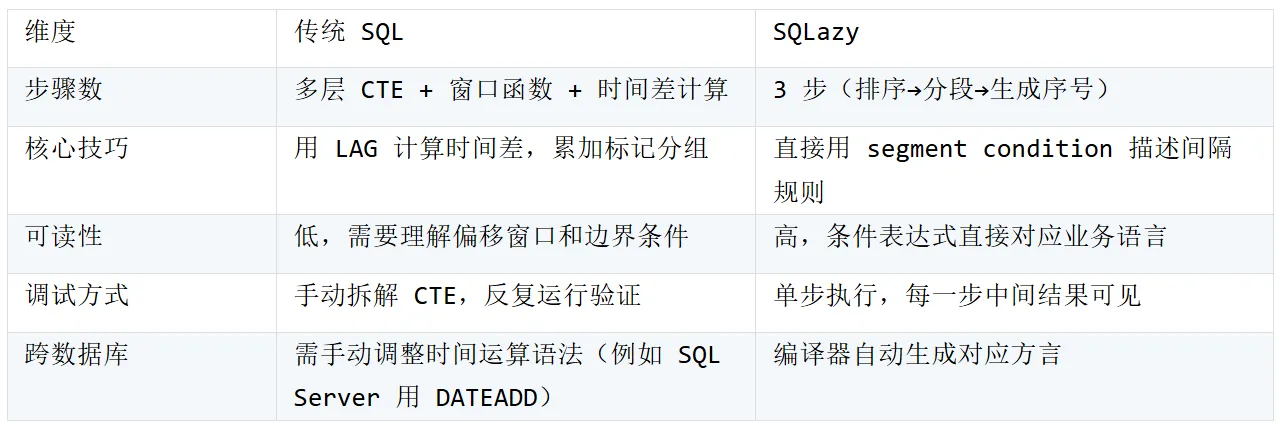
这个实例展示了 SQLazy 处理“基于时间间隔的会话划分”类问题的简洁性:通过 segment condition 直接描述“超过 1 小时就新开一组”,再配合分区内行号,完美映射了业务需求。
