AI已能产出可运行的 SQL,但可运行不等于可审计。
在复杂查询上,公开评测显示最先进模型在 BIRD-bench 等基准上的执行准确率常在六成左右徘徊,远未达到可直接评审通过的程度。典型偏差不在语法,而在窗口边界、分区键、聚合口径等较复杂逻辑,尤以会话化、时序 gap、动态透视等场景尤甚。SQL需多层嵌套 CTE 与窗口累加,关联条件隐蔽,改一处需从最内层逐层验证是否影响外层。
后果是三重成本叠加:难以 review、难以单步调试、难以跨库移植。代码确实能跑,但逻辑是否对,还需要把嵌套在脑子里完整重跑一遍才能确认。
LLM 直出 SQL 的确定性问题
问题的根因不在 AI 能力,而在范式。让概率模型直接承担终态 SQL 的生成,把“规划”与“生成”绑在同一次采样中,确定性无从保证。
看个例子:一张状态流水表,每行记录一个 ID 在某时刻的状态 NewStatus,需求是取出每个 ID 在 ConfirmationStarted 之前最近的那条 Closed。
直接让 AI 产出这条 SQL,常见结果为多层嵌套:
WITH t2 AS (
        SELECT CreatedAt, ID, NewStatus
            , 1 + SUM(CASE
                WHEN NewStatus = 'ConfirmationStarted' THEN 1
                ELSE 0
            END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
        FROM mytable
    )
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
    SELECT CreatedAt, ID, NewStatus, seg
    FROM (
        SELECT CreatedAt, ID, NewStatus, seg
        FROM (
            SELECT CreatedAt, ID, NewStatus, seg
            FROM t2
            WHERE NewStatus = 'Closed'
        ) t_1
        WHERE seg = 1
    ) t_2
    WHERE ID IN (
        SELECT ID
        FROM (
            SELECT ID
            FROM t2
            WHERE NewStatus = 'Closed'
                AND seg = 1
        ) t_3
        GROUP BY ID
    )
) t_4
GROUP BY ID
ORDER BY ID
这段 SQL 能跑对,但要逐层展开才能验证逻辑是否正确,这就是让 AI 直接产终态 SQL 的代价:每一步都藏在嵌套里,无法单步审计。
要恢复确定性,需将规划与生成分离。
架构总览:规划与生成分离
把一次性的 Prompt→SQL 黑盒拆为 Prompt→Workflow→SQL 白盒,Workflow 即契约。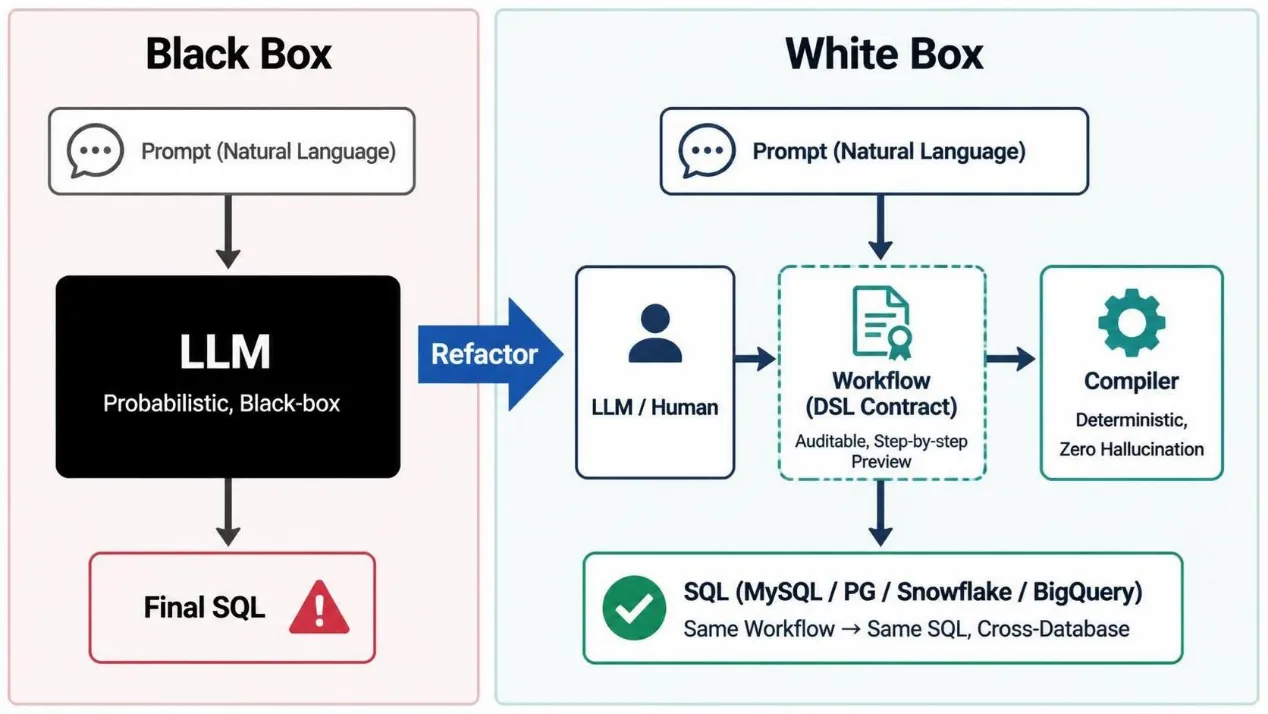
三个环节:
Planner:人或 LLM 产出自然语言步骤集,负责把口语需求拆解为顺序步骤
Workflow:DSL 契约,结构清晰、问题分解、人类可读、每步可执行预览、本身就是可执行的文档。同一 Workflow 永远对应同一结果
Compiler:确定性编译器,按固定规则将 Workflow 翻译为目标方言的原生 SQL。一份 Workflow 可编译为 MySQL、PostgreSQL、Snowflake、BigQuery 的原生 SQL
契约作用在于约束两端。LLM 的输出受 DSL 约束,不直接产出SQL;编译器的输入即 Workflow,不做猜测。同一 Workflow 今天与明天编译,结果完全一致。Workflow 本身成为可审计的逻辑文档,审查者无需猜测 AI 意图,只需审阅步骤。
SQLazy正是这种架构的具体实现:LLM只规划步骤,编译器确定性生成SQL。
关键设计
三个设计点共同支撑确定性与可审计性。
设计 1 :步骤 DSL 与单步调试
步骤按人类思考顺序组织,错在第 2 步就只改第 2 步。每步可独立执行并预览中间表,边界偏差在中间结果中直接显现,无需在最终结果中反推。以分段为例,执行后立即看到分段列的取值,分段是否按预期切分当场可判。
设计 2 :确定性编译
编译器按固定规则翻译,非概率生成。Workflow 中的排序、筛选、分段、聚合等操作,分别一一对应到 ORDER BY、WHERE、SUM(CASE WHEN) OVER(PARTITION BY) 分段、GROUP BY 等 SQL 语法,无幻觉,可复现。同一 Workflow 跨次执行、跨机器执行始终一致,满足受监管场景对可追溯的要求。
设计 3: 变更审计与版本化
Workflow是纯文本契约,天然可进 Git 做版本管理。逻辑变更只改对应步骤,SQL 由编译器自动重建,逻辑与 SQL 不会脱节。每次变更可 diff、可评审、可回滚,历史清晰可查,监管审计只需翻 Git 提交记录。
实例验证与适用范围
用前面的例子验证一下。
源数据 mytable:
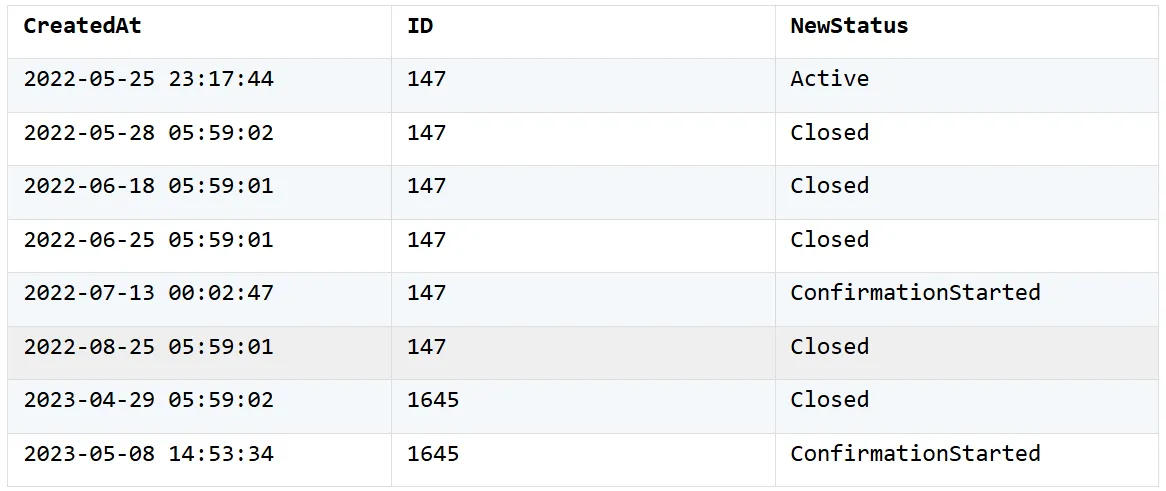
期望结果仅两行(147→2022-06-25,1645→2023-04-29),其余 Closed 要么过早,要么在 ConfirmationStarted 之后。
在 SQLazy 中,同一逻辑按顺序写作 Workflow: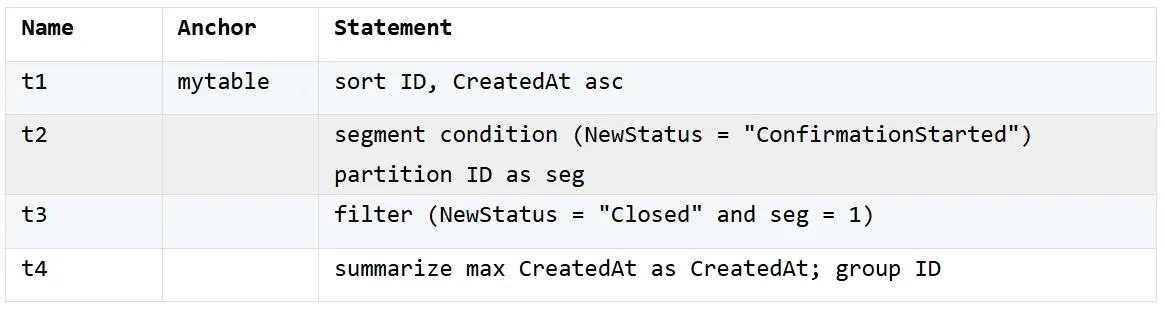
第 1 步 sort ID, CreatedAt asc 按 ID 与时间排序,确保时序正确。sort对应 ORDER BY。
第 2 步 segment condition (NewStatus = "ConfirmationStarted") partition ID as seg 按 ConfirmationStarted 切段,partition ID保证每 ID 独立分段。执行后多出一列 seg,seg=1 即目标区间,无需手写SUM(CASE WHEN ...) OVER。分段对不对,点开 t2 看 seg 列即可。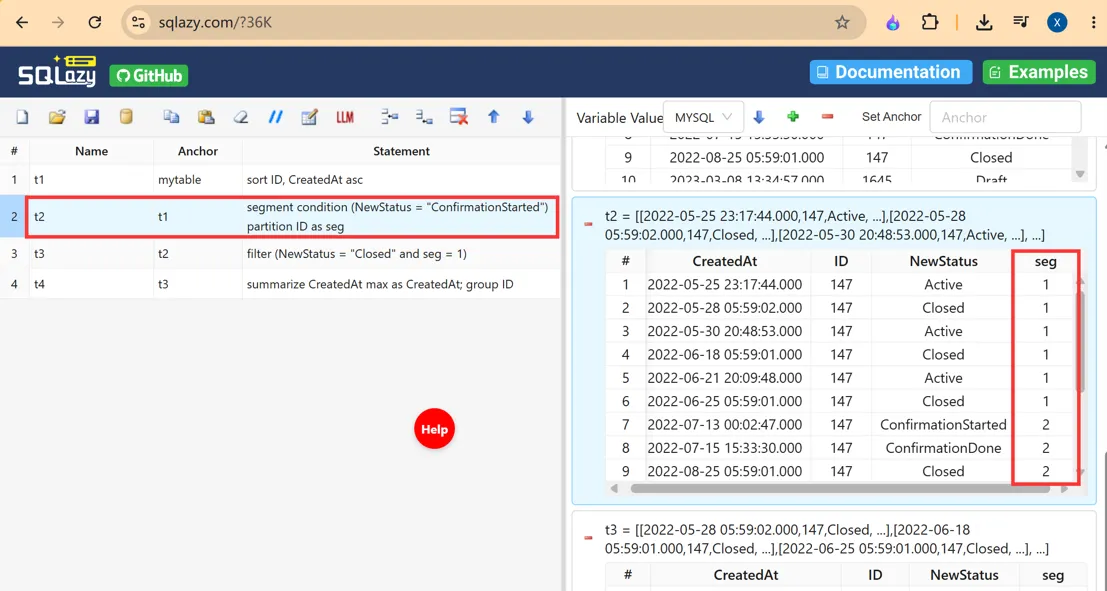
第 3 步 filter (NewStatus = "Closed" and seg = 1) 只保留目标区间内的 Closed。filter对应 WHERE。
第 4 步 summarize max CreatedAt as CreatedAt; group ID 按 ID 分组取最大时间,即最近一条。summarize对应 GROUP BY 与聚合。
Workflow写完点编译,按固定规则产出的 SQL(与前面的 SQL 相比步骤更清晰):
WITH t2 AS (
        SELECT CreatedAt, ID, NewStatus
            , 1 + SUM(CASE
                WHEN (NewStatus = 'ConfirmationStarted') THEN 1
                ELSE 0
            END) OVER (PARTITION BY ID ORDER BY ID ASC, CreatedAt ASC ROWS UNBOUNDED PRECEDING) AS seg
        FROM mytable
    )
SELECT ID, MAX(CreatedAt) AS CreatedAt
FROM (
    SELECT CreatedAt, ID, NewStatus, seg
    FROM t2
    WHERE (NewStatus = 'Closed'
        AND seg = 1)
) t_3
GROUP BY ID
ORDER BY ID
同一 Workflow 多次编译结果完全一致,切换方言无需改 Workflow。
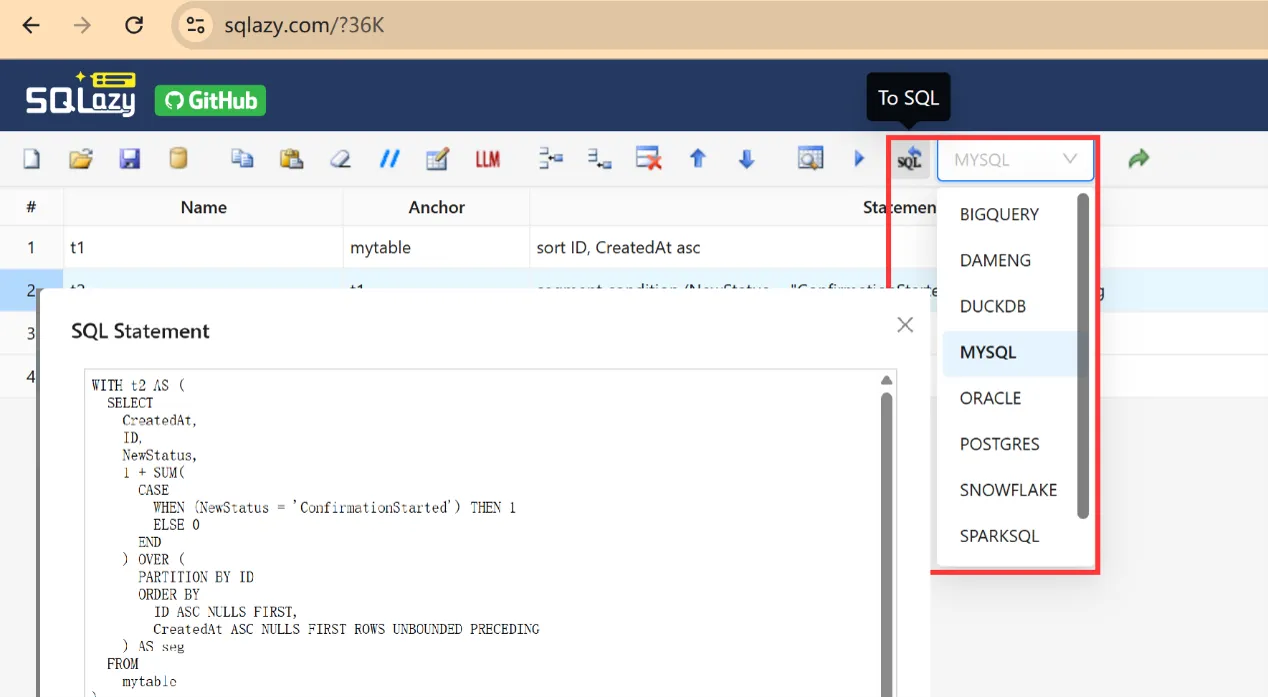
适用范围同样需要诚实说明。简单 CRUD 直接写 SQL 更合适,为三五行逻辑引入 Workflow 并不划算;宏与循环等能力尚在路线图中。SQLazy 的定位是复杂分析逻辑的设计与验证,随后嵌入 dbt 等工作流,而非替代。
产品与开源的边界:SQLazy 的语法与示例开源,编译器与 IDE 为商业闭源并提供免费版;IDE 支持本地 / 私有化部署,契合企业对数据出境与离线使用的要求。
AI writes the logic. A compiler writes the SQL.