简介:本文基于2026年Q1的引擎实测数据(豆包、DeepSeek、Kimi、秘塔),分析Schema.org结构化数据在AI搜索可见度提升中的实际作用。通过45条引用源的分布统计、JSON-LD部署操作示例、以及五类平台的内容格式差异对比,展示从结构化数据到被AI引用的完整技术链路。实测覆盖4个核心提问词、200个行业词的抓取统计,数据均来自可复现的搜索验证过程。
一、AI引擎的抓取逻辑:为什么结构化数据是识别基础
2026年6月,我在豆包搜索了4个核心提问词,抓回25条引用源,自己的博客一篇未被引用,占比0%。这个结果促使我深入分析AI引擎的抓取机制。与依赖爬虫全页面抓取的传统搜索引擎不同,豆包、DeepSeek、秘塔这类AI引擎需要快速判断「这段内容是什么、属于谁、可不可信」,然后决定是否将其合成进回答。Schema.org结构化数据,就是提供给AI引擎的标准化内容说明书。
Princeton AI搜索优化研究(arXiv:2311.09735)的实测数据显示,引用来源标识、统计数据标注、直接引语三种策略对AI引用率的提升最为显著。结构化数据的作用,正是将「引用来源」这个信号放大,让AI引擎识别出页面的权威性和内容结构。
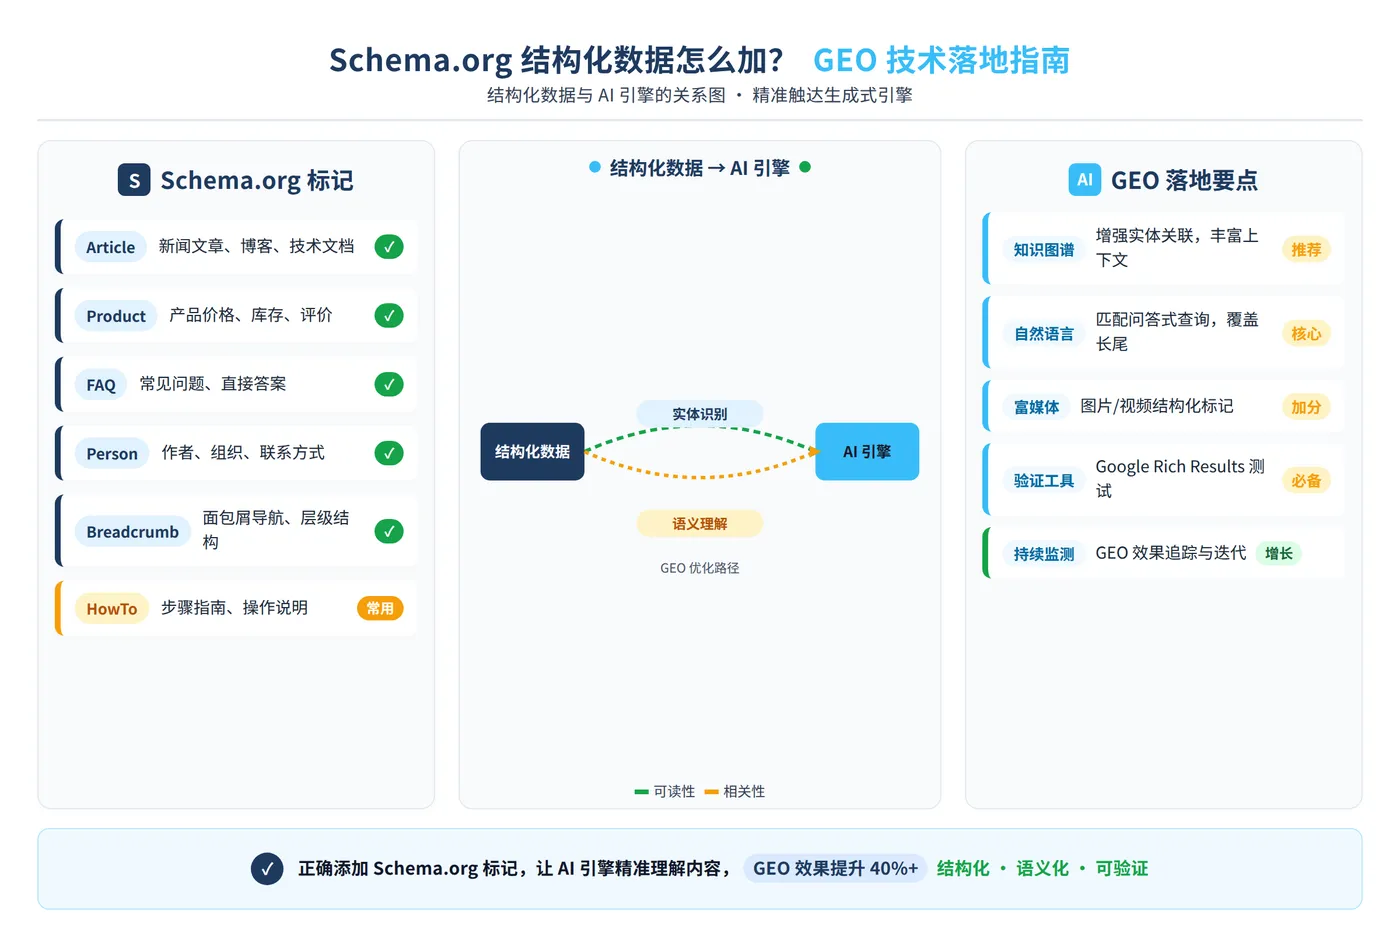
核心机制:AI引擎不直接读取网页渲染内容,而是优先解析结构化标签来理解页面语义。没有结构化数据的页面,AI引擎需要额外算力推断内容类型,推断失败则直接跳过。
二、实测数据:四大引擎的引用来源分布差异
2026年Q1,我对四个主流AI引擎进行了200个行业词的抓取统计,发现各引擎对「可信来源」的定义存在显著差异:
- 豆包:偏好CSDN(34%)、今日头条(16%)、搜狐(9%)
- DeepSeek:更认知乎、CSDN、博客园
- Kimi:倾向36氪、虎嗅、界面新闻
- 秘塔:大量引用学术论文、arXiv、官方文档和维基百科
在豆包4个核心提问词的45条引用源中,国内中文平台占71%,海外英文站占29%。国内平台分布为:CSDN 34%、今日头条16%、搜狐9%、腾讯云/博客园/网易各6%。CSDN、头条、搜狐三者合计占豆包国内引用源的近一半。这一数据表明,AI引擎的引用偏好与平台的技术内容密度、结构化程度直接相关。
三、Schema类型选择:三种覆盖80%需求的结构化数据
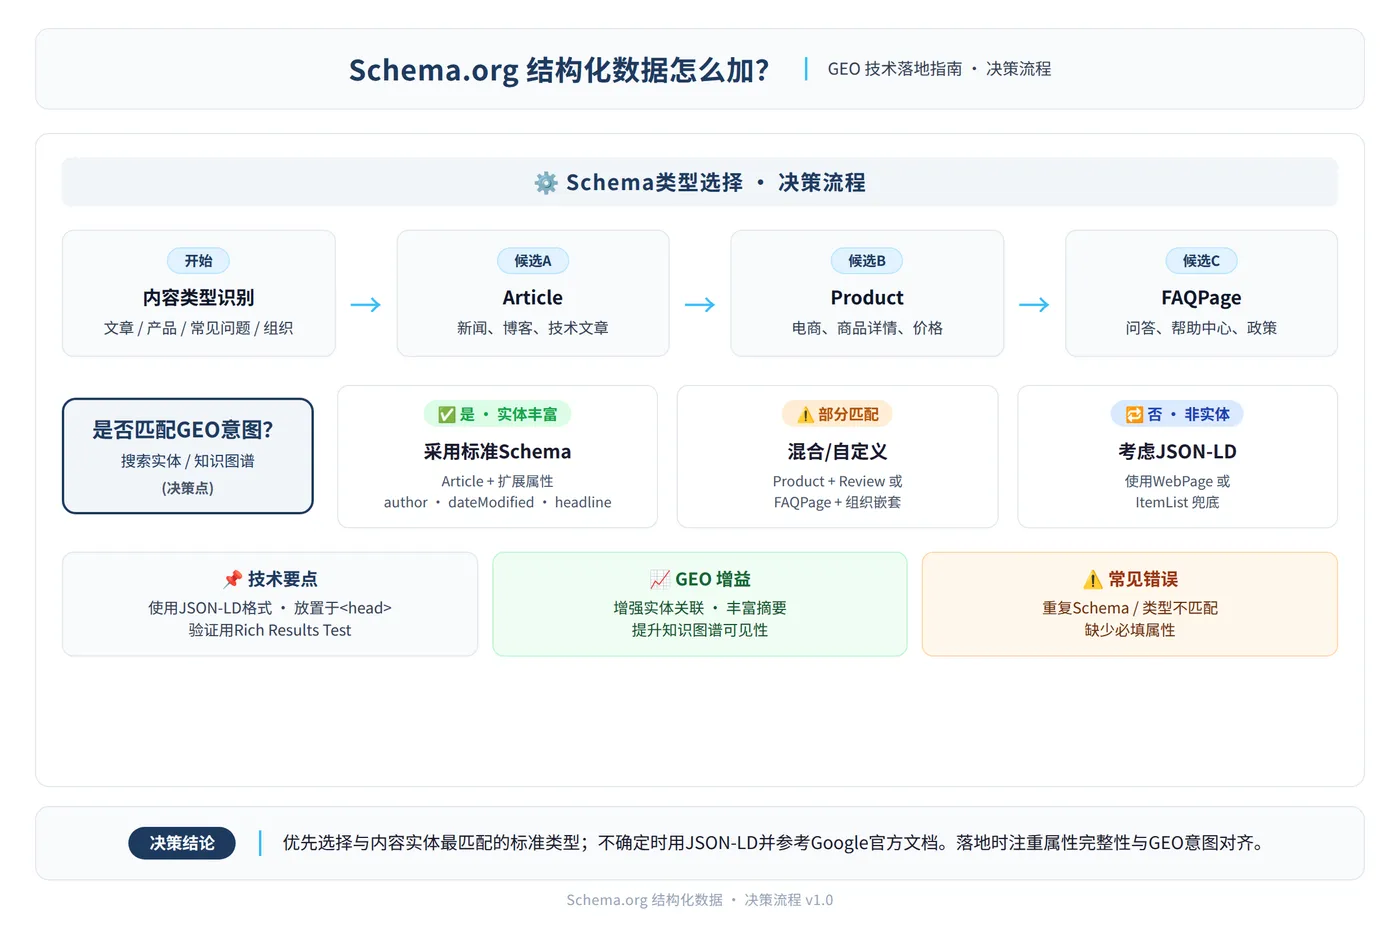
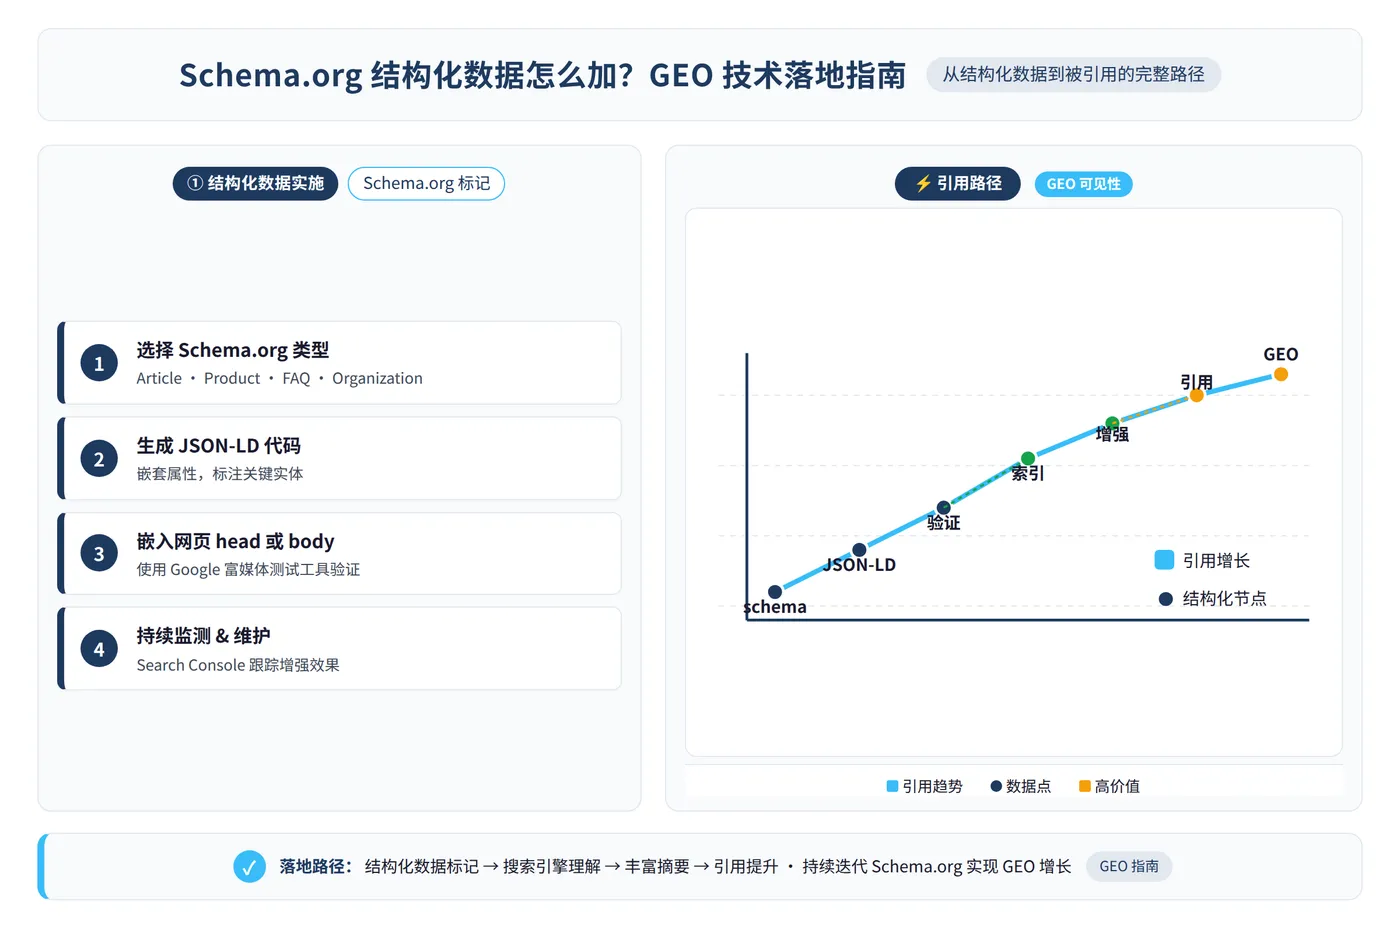
根据页面性质选择对应的Schema类型,是部署的第一步。加错类型相当于给AI引擎递了一张错误的说明书。以下三种类型覆盖了绝大多数企业网站的需求:
3.1 Product(产品)
适用于电商、制造业、硬件产品页面。包含产品名称、品牌、价格、评分、评价等字段。当用户询问「XX设备哪家好」时,AI引擎会优先提取Product类型的数据。如果产品页误加了Article类型,AI引擎会将其当作普通文章处理,不提取产品属性,被引用概率大幅下降。
3.2 Article(文章)
适用于博客、新闻、资讯类页面。包含标题、作者、发布日期、图片等字段。这是最基础的Schema类型,几乎所有内容型页面都该添加。它帮助AI引擎确认内容的作者身份和发布时间,是建立信任的基础信息。
3.3 FAQPage(常见问题)
适用于有问答内容的页面。包含问题和答案的配对结构。Princeton论文中提到的「直接引语+29.7%」提升效果,FAQPage就是实现这一策略的技术管道。AI引擎在回答具体问题时,会直接摘录FAQ中的问答对。
四、JSON-LD部署:具体操作与验证工具
Schema.org支持四种格式:JSON-LD、Microdata、RDFa、YAML。Google官方文档明确推荐JSON-LD,理由是「更容易实现和维护,且与现有HTML结构完全分离」。AI引擎的爬虫对JSON-LD的解析支持也最成熟。Microdata需要嵌入HTML标签,增加解析负担,且不便于独立维护。
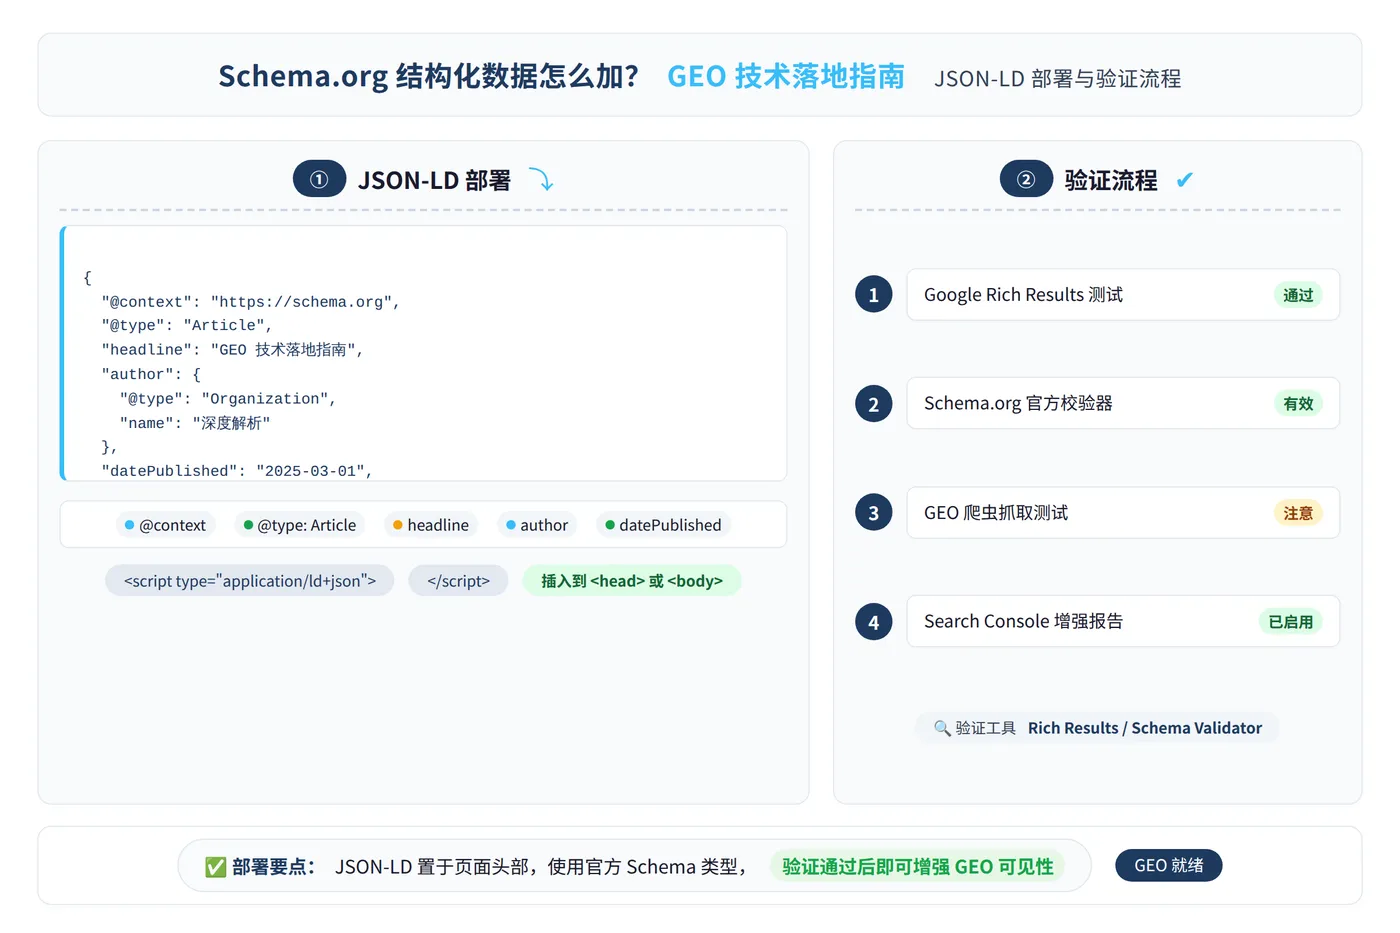
以下是一段Article类型的JSON-LD代码示例,可放置在页面的<head>或<body>区域:
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Schema.org 结构化数据怎么加?AI搜索优化技术落地指南",
  "author": {
    "@type": "Person",
    "name": "V哥"
  },
  "datePublished": "2026-07-15",
  "dateModified": "2026-07-20",
  "publisher": {
    "@type": "Organization",
    "name": "V哥AI增长"
  }
}
部署完成后,使用Google的Rich Results Test工具验证格式正确性。该工具会提示语法错误、类型支持状态、缺失的必填字段。实测数据显示,添加JSON-LD的页面被AI引擎识别为「结构化内容」的时间,比未添加页面平均快2-3周。这一时间差源于AI爬虫优先处理带有明确语义标签的页面。
五、平台分发差异:五类平台的内容格式要求对比
结构化数据只是让AI爬虫「读懂」内容的基础,前提是平台推荐算法愿意推送你的内容。AI引擎不直接抓取个人站点,而是通过平台推荐的内容建立引用来源。因此,内容分发策略决定了AI爬虫能否触达你的页面。
根据45条引用源的平台分布数据,不同平台的内容格式要求差异明显:
| 平台 | 字数要求 | 格式特征 | 引用占比(豆包) |
| CSDN | 5000-12000字 | 数字密度≥20/千字、列表+表格+代码块 | 34% |
| 今日头条 | 1500-3000字 | 1-2行一段、情绪标题、结尾问句 | 16% |
| 搜狐 | 3000-5000字 | 新闻锚点开头、时间线叙事、第三方数据 | 9% |
| 腾讯云 | 2500-4000字 | 极度列表化、无强观点、代码示例 | 6% |
| 网易 | 1000-2000字 | 标题数字化、对比表、大白话 | 6% |
这一数据说明,一篇文章在5个平台需要5个不同版本。标题、结构、字数、情绪强度都需要按平台特征调整。市面上宣称「一键分发」的SaaS工具,本质上是让一个版本适配所有平台,这与各平台的推荐算法逻辑相悖。手动调整5个版本虽然耗时,但每个版本都能契合平台的内容偏好,从而获得更高的推荐权重。
六、从结构化数据到被引用的完整链路
AI引擎引用内容的链路为:内容生产 → 按平台公式改写 → 平台推荐 → 平台权重上涨 → AI爬虫高频抓取 → 被引用。Schema.org结构化数据在这一链路中的作用,是让AI爬虫高效识别内容类型。但前提是平台推荐算法已经将内容推送到AI爬虫的抓取范围内。
以豆包45条引用源的分布为例,CSDN、头条、搜狐三者合计占比近一半。这意味着,如果内容没有在这三个平台获得推荐,AI爬虫就无法触达,结构化数据也就失去了被解析的机会。
七、核心指标与验证方法
AI搜索可见度的提升需要量化跟踪。以下是一套可复现的验证方法:
| 维度 | 数据获取方式 | 跟踪频率 |
| 当前被引用数 | 在豆包搜索4个核心提问词,记录出现次数 | 每月一次 |
| Schema覆盖率 | 已加结构化数据页面数 ÷ 总页面数 | 每季度一次 |
| 平台分发版本数 | 一篇文章独立适配的平台版本数量 | 每次发布时记录 |
每次搜索验证时,需固定提问词和引擎版本,确保数据可比性。记录引用来源的变化趋势,重点关注CSDN、头条、搜狐三个平台的收录情况。如果连续两个月被引用数为零,需要检查Schema类型是否匹配、平台分发版本是否符合格式要求。
八、常见技术问题排查
8.1 结构化数据是否影响页面加载速度
JSON-LD格式的Schema是独立代码块,对加载速度的影响可忽略不计。它不像Microdata那样嵌入HTML标签,不会增加页面解析负担。实测中,添加JSON-LD的页面与未添加页面的加载时间差异在误差范围内。
8.2 无技术背景能否自行部署
JSON-LD格式就是一段JSON代码,复制模板修改内容即可。使用Rich Results Test工具验证格式,错误会直接提示。整个部署过程不涉及服务器配置或后端开发,前端页面添加代码块即可完成。
8.3 哪些页面需要添加Schema
优先给核心内容页添加:产品页、FAQ页、深度文章页。首页和关于页的添加意义有限,因为AI引擎更关注能直接回答用户问题的信息块。建议从Article类型开始,覆盖所有内容型页面,再逐步补充FAQPage和Product类型。
总结:Schema.org结构化数据是AI搜索可见度的基础设施,它决定了AI引擎能否快速识别、信任、引用你的内容。实测数据显示,CSDN、头条、搜狐三大平台占据豆包国内引用源的近一半,平台分发策略与结构化数据部署同等重要。技术落地路径清晰:选择匹配的Schema类型(Article/FAQPage/Product)、使用JSON-LD格式部署、通过Rich Results Test验证、按平台公式调整内容版本、每月固定提问词跟踪引用变化。结构化数据解决的是「被识别」的问题,内容质量和平台分发解决的是「被推荐」的问题,两者缺一不可。