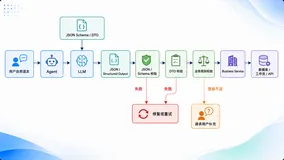
在企业办公、合同管理、知识库、档案管理和云文档等系统中,文件既是业务信息的主要载体,也是 Agent 执行真实任务时必须面对的对象。
用户可以直接向 Agent 提出:
- 打开这份合同,定位付款条款;
- 把一批 Office 文件统一转换成 PDF;
- 合并这些 PDF,并添加“内部资料”水印;
- 提取文档正文,生成摘要并写入知识库;
- 清除 Word 中的批注和修订,生成正式版本。
大模型能够理解这些自然语言指令,但并不适合直接操作复杂的文档文件。文件获取、格式识别、在线预览、格式转换、内容提取和结构修改,仍然需要由稳定、可追踪的专业文档能力完成。
BaseMetas IDP 围绕企业文档处理中的三个基础问题,形成了三类核心产品能力:
- 文件预览:解决文件能否在线查看的问题;
- 格式转换:解决不同文件格式如何统一的问题;
- 内容处理:解决如何按照业务规则操作文档的问题。
三类能力既可以独立接入 OA、云文档、知识库、合同和档案系统,也可以进一步封装为 Agent Skill,为智能办公和企业级 Agent 提供可靠的文档执行能力。原始产品材料同样将预览、转换和内容处理定义为一套完整文档处理中台的三类核心能力。
一、三大产品构成完整的文档能力底座
文件预览、格式转换和内容处理并不是三个彼此孤立的工具,而是覆盖文件查看、标准化和深度操作全过程的三类能力。

 编辑
对传统业务系统而言,这三类产品提供的是标准文档服务;对 Agent 而言,它们则可以成为可理解、可选择和可调用的外部工具。
三者之间的关系可以简单概括为:
- 预览负责让文件“能看”;
- 转换负责让格式“统一”;
- 内容处理负责让文档“能操作”。
例如,一份 WPS 合同可以先转换为 PDF,供用户在线审阅;随后提取正文,交给大模型分析;最后根据业务要求添加水印、页码或执行归档。
二、文件预览:让 Agent 具备查看文档的“眼睛”
1. 产品定位
文件预览解决的是不同类型的文件如何在浏览器中直接查看的问题。
用户不需要安装对应的桌面软件,业务系统也不需要针对每一种格式分别开发查看器。只需将文件地址、文件标识或者上传文件提交给预览服务,即可获得在线预览页面或可嵌入业务系统的预览地址。
文件预览适合应用于:
- OA 和 BPM 系统中的流程附件;
- 网盘和云文档系统中的在线查看;
- 合同、档案和电子证照系统;
- CRM、ERP 和项目管理系统中的业务附件;
- 知识库和智能问答系统中的原文查看;
- Agent 执行结果的人工确认与复核。
2. 覆盖多类型文件
BaseMetas 文件预览支持超过 200 种文件格式,整体覆盖以下类别:
- 办公文档与文本:包括文字、表格、演示、WPS、开放文档和常见文本文件;
- 版式文档:包括 PDF、OFD 等适合正式分发和归档的文件;
- 图片:覆盖常见图片、扫描图片及部分专业图像格式;
- 音视频:支持常见音频、视频文件的在线播放;
- 压缩包:支持在线查看压缩包目录,并继续预览其中受支持的文件;
- CAD 与工程图纸:适用于建筑、机械、制造和工程管理等场景;
- 3D 模型:适用于工业设计、三维展示、建筑可视化和数字资产管理;
- 流程图与思维导图:覆盖业务流程、系统架构和知识结构等文件;
- 代码与配置文件:适合研发管理、代码查看和 DevOps 场景;
- 电子书:适合培训资料、电子教材和产品手册的在线阅读。
本文重点不在于逐一罗列扩展名,而在于说明:预览产品能够为企业业务系统提供统一的文件查看入口,使 Office、PDF、CAD、3D 等差异较大的文件都可以进入同一套在线使用流程。
3. 复杂文件场景
除了普通文件查看,企业应用还经常遇到网络文件、长文档、大文件、密码文档和加密压缩包等复杂情况。
预览产品需要覆盖:
- 网络文件获取与预览;
- 长文档分页加载;
- 大文件异步处理;
- 密码 Office 文档;
- 加密压缩包;
- 压缩包目录浏览;
- 重复文件结果复用;
- 文件访问权限控制;
- 预览地址有效期控制;
- 水印、下载、打印和复制权限控制。
官方格式说明显示,BaseMetas 文件预览支持密码保护的 Office 文档以及常见加密压缩包,用户提供正确密码后可以继续查看。
4. 作为 Agent Skill 的价值
在传统业务系统中,预览通常只是一个页面功能;在 Agent 应用中,预览还可以成为文档任务的可视化入口和人工复核环节。
例如用户提出:
打开这份工程资料,让我查看其中的 CAD 图纸。
Agent 可以调用文件预览 Skill,获得预览地址并返回给用户,而不需要理解 CAD 文件的内部结构。
建议将预览能力封装为:
name: preview_document
description: >
  将文件生成可在浏览器中查看的预览资源,
  支持办公文档、版式文档、图片、音视频、压缩包、
  CAD、3D模型、流程图、代码和电子书等类型。
inputs:
  file_source:
    description: 文件地址、文件标识或上传文件
  password:
    description: 文件或压缩包密码,可选
  preview_options:
    description: 预览模式、权限、水印及页面参数
outputs:
  task_id:
    description: 异步任务标识
  preview_url:
    description: 在线预览地址
  file_type:
    description: 识别出的文件类型
  status:
    description: 当前处理状态

适合触发该 Skill 的用户意图包括:
- 打开或预览文件;
- 查看压缩包中的内容;
- 在线查看 CAD 图纸;
- 展示 3D 模型;
- 打开流程图或思维导图;
- 查看 Agent 处理后的结果文件。
三、格式转换:为不同文档建立统一的使用方式
1. 产品定位
格式转换解决的是不同文件格式之间难以统一使用的问题。
企业文件来源复杂,同一个系统中可能同时存在 Office、WPS、PDF、OFD、图片、CAD、流程图和音视频文件。如果上层应用分别适配每一种格式,开发和维护成本会持续增加。
格式转换产品可以将来源不同的文件转换为适合预览、归档、编辑、交换或者智能分析的目标格式。
2. 核心能力
格式转换的典型场景包括:
- Office、WPS 等文档转换为 PDF;
- 文档或 PDF 转换为图片;
- PDF 转换为可编辑或可提取内容的格式;
- OFD 与 PDF、图片等格式之间转换;
- 图片和多页扫描件转换为 PDF;
- 流程图和工程图纸生成便于分发的预览文件;
- 音视频文件转换为统一播放格式;
- 企业历史文件批量转换为标准归档格式。
原始材料将转换产品定位为覆盖多类文件的企业级格式转换能力,并强调其支持异步执行、任务追踪和水平扩展。
格式转换不仅是一个“导出文件”的功能,还承担着文档标准化的作用。
例如:
- 知识库可能需要将来源不同的文件统一转换为便于提取内容的格式;
- 合同系统可能要求正式归档文件统一为 PDF;
- 多模态模型可能需要将长文档转换为逐页图片;
- 预览系统可能需要先生成浏览器能够稳定展示的版本。
3. 作为 Agent Skill 的价值
当用户提出:
把这份 Excel 转成 PDF。
Agent 只需要识别当前文件、用户意图和目标格式,然后调用转换 Skill:
name: convert_document
description: >
  将文件从当前格式转换为指定目标格式,
  适用于预览、归档、编辑、交换和后续智能分析。
inputs:
  file_source:
    description: 文件地址、文件标识或上传文件
  target_format:
    description: 目标文件格式
  source_format:
    description: 源文件格式,可选,可自动识别
  options:
    description: 页面范围、输出质量及其他转换参数
outputs:
  task_id:
    description: 异步转换任务标识
  result_url:
    description: 转换结果地址
  output_format:
    description: 实际输出格式
  status:
    description: 任务执行状态

适合触发转换 Skill 的用户表达包括:
- 转换成 PDF;
- 导出为图片;
- 把 OFD 转成 PDF;
- 将 Office 文件统一为归档格式;
- 生成适合在线查看的版本;
- 把文档转换为可以进行后续分析的格式。
4. Agent 工作流中的标准化节点
格式转换 Skill 往往不是最终步骤,而是后续智能处理的前置节点。

 编辑
例如,一份演示文稿可以先转换为 PDF,再生成逐页图片,最后由多模态模型分析每一页内容。
因此,格式转换在 Agent 工作流中承担的是“文档格式翻译器”和“标准化入口”的角色。
四、内容处理:让 Agent 能够真正操作文档
1. 产品定位
格式转换主要改变文件的载体形式,内容处理则直接操作文件内部的页面、文本、工作表、批注、修订、水印、安全属性和文档结构。
例如:
- Word 转 PDF 属于格式转换;
- 接受 Word 中的全部修订属于内容处理;
- PDF 转图片属于格式转换;
- 删除 PDF 中的指定页面属于内容处理;
- Excel 转 PDF 属于格式转换;
- 合并多个 Excel 工作表属于内容处理。
内容处理使 Agent 不再只是“读取文件”,而是能够按照用户要求生成可交付的结果文件。
2. PDF 内容处理
PDF 内容处理可以覆盖:
- 文档合并和拆分;
- 页面删除、插入、旋转和排序;
- 添加页码和水印;
- 提取文本、图片、表格和附件;
- 表单填写;
- 批注清理和扁平化;
- 文档保护、加密和解密;
- 文档安全清理。
例如,用户可以要求:
把这些扫描件合并成一份 PDF,每页添加“仅限内部使用”水印,并在底部插入页码。
这些操作可以组合为一次连续的文档处理任务。
3. Word 内容处理
Word 内容处理可以覆盖:
- 提取或删除批注;
- 接受或拒绝修订;
- 开启或关闭修订模式;
- 添加或移除水印;
- 插入或替换页眉页脚;
- 合并多个文档;
- 清理文档内容;
- 应用正式文档模板;
- 公文套红;
- 文档保护、加密和解密。
这类能力适合合同定稿、公文处理、材料汇编、审阅清稿和正式文件生成等场景。
4. Excel 内容处理
Excel 内容处理可以覆盖:
- 合并或拆分工作簿;
- 合并、插入、删除和隐藏工作表;
- 规范化表格结构;
- 处理数据透视表;
- 处理条件格式;
- 设置或取消工作表保护;
- 文件加密和解密。
这类能力可以用于报表汇总、数据模板生成、批量台账整理和业务数据交付。
原始材料将内容处理定义为针对 PDF、Word 和 Excel 的结构化编辑与提取能力,并支持将多个操作组成连续处理流程。
5. 结构化操作指令
为了让 Agent 稳定调用,可以将每一种文档操作定义为结构化操作码:
Pdf.document.merge
Pdf.watermark.insert
Pdf.text.extract
Pdf.page.remove
Word.revision.acceptAll
Word.comment.remove
Word.document.applyTemplate
Excel.workbook.merge
Excel.sheet.remove
Excel.table.normalize

自然语言由大模型负责理解,实际执行则通过确定性的操作指令完成。
例如,用户提出:
合并这五个 PDF,在每页右上角添加“机密”水印,最后设置打开密码。
Agent 可以生成:
{
  "files": [
    "file-001",
    "file-002",
    "file-003",
    "file-004",
    "file-005"
  ],
  "operations": [
    {
      "operation": "Pdf.document.merge",
      "parameters": {
        "order": "input"
      }
    },
    {
      "operation": "Pdf.watermark.insert",
      "parameters": {
        "text": "机密",
        "position": "top-right",
        "opacity": 0.25
      }
    },
    {
      "operation": "Pdf.security.encrypt",
      "parameters": {
        "password": "******"
      }
    }
  ]
}

6. 作为 Agent Skill 的价值
内容处理能力可以封装为:
name: process_document
description: >
  对 PDF、Word 或 Excel 文件执行结构化内容处理,
  支持合并、拆分、提取、水印、修订、模板和安全保护等操作,
  并支持多个操作按顺序执行。
inputs:
  file_source:
    description: 单个文件、多个文件或文件标识列表
  operations:
    description: 按顺序执行的结构化操作列表
  execution_mode:
    description: 单文件、多文件合并或批量处理模式
outputs:
  task_id:
    description: 内容处理任务标识
  result_url:
    description: 最终结果文件地址
  operation_results:
    description: 每个操作的执行结果
  status:
    description: 当前任务状态

适合触发内容处理 Skill 的用户意图包括:
- 合并或拆分文件;
- 添加水印和页码;
- 接受全部修订;
- 清除批注;
- 提取 PDF 文本或表格;
- 应用正式文档模板;
- 合并 Excel 工作表;
- 对文件进行加密或安全清理。
五、三类 Skill 如何协同完成复杂任务
假设用户提出:
把客户上传的 Word 合同转换成 PDF,添加机密水印,提取合同正文,并分析其中的付款和违约条款。
Agent 可以将任务拆解为以下步骤:

 编辑
在这个流程中:
- 格式转换负责将原始合同标准化;
- 内容处理负责添加水印和提取正文;
- 大模型负责理解合同语义;
- 文件预览负责向用户展示原文和处理结果。
其核心分工是:
大模型负责理解、规划和判断,文档 Skill 负责准确、稳定地执行。
六、Agent Skill 的推荐实现方案
1. 建立基础 Skill 层
第一步可以将三类产品能力分别封装为三个基础 Skill:
Document Skills
├── preview-document
├── convert-document
└── process-document

每个 Skill 至少应包含:
- 能力说明;
- 适用场景;
- 输入参数定义;
- 输出结果定义;
- 支持范围;
- 调用限制;
- 错误处理规则;
- 权限和安全要求。
Agent 通过 Tool Calling、Function Calling 或其他工具调用机制选择 Skill,并生成符合约束的参数。
2. 增加统一的 Skill Adapter
为了避免 Agent 直接处理复杂的产品接口,可以增加统一的 Skill Adapter。

 编辑
Skill Adapter 负责:
- 接收 Agent 生成的结构化参数;
- 校验文件来源和操作权限;
- 提交任务;
- 查询任务状态;
- 处理超时和失败;
- 将错误转换为 Agent 可理解的信息;
- 返回预览地址、结果文件或提取内容。
3. 封装异步任务生命周期
文档预览、转换和内容处理可能需要一定时间,因此不应要求大模型持续阻塞等待。
Skill 应封装完整的任务生命周期:
提交任务
  ↓
获得 taskId
  ↓
查询状态或等待结果通知
  ↓
任务完成
  ├─ 成功:返回预览地址、结果文件或提取内容
  ├─ 失败:返回结构化错误
  └─ 超时:进入重试、取消或人工处理

结构化错误可以采用以下形式:
{
  "error_code": "FILE_PASSWORD_REQUIRED",
  "message": "该文件已加密,需要提供正确的打开密码。",
  "retryable": true,
  "required_action": "request_password"
}

Agent 读取该结果后,可以继续向用户询问密码,而不是直接终止整个任务。
4. 增加能力查询 Skill
文件格式和内容处理能力会持续扩展,因此不建议将全部支持范围永久写死在 Prompt 中。
可以增加一个能力查询 Skill:
name: query_document_capabilities
description: 查询当前支持的文件格式、转换目标和内容处理操作。
inputs:
  capability_type:
    description: preview、convert 或 process
  source_format:
    description: 源文件格式,可选
  target_format:
    description: 目标格式,可选
  document_type:
    description: PDF、Word、Excel 等,可选
outputs:
  supported:
    description: 是否支持
  capabilities:
    description: 可用格式或操作列表
  constraints:
    description: 文件大小、密码和页面范围等限制

Agent 在执行不确定的任务前,可以先查询能力范围,再决定下一步操作。
七、从基础 Skill 到业务复合 Skill
预览、转换和内容处理属于原子能力。在实际应用中,还可以围绕业务目标封装更高层的复合 Skill。
| 复合 Skill | 主要能力组合 |
| 合同审查 | 格式转换、文本提取、条款分析、结果预览 |
| 文档归档 | 格式标准化、水印、页码、安全处理、归档 |
| 文档对比 | 文件转换、正文提取、版本差异分析 |
| 正式文件生成 | 清除批注、接受修订、应用模板、导出 PDF |
| 知识库入库 | 格式识别、转换、内容提取、切分和入库 |
| 档案数字化 | 扫描件整理、页面处理、内容识别和归档 |
| 工程资料助手 | CAD 预览、资料查看、文件转换和归档 |
| 三维资产助手 | 3D 模型预览、资料关联和资产信息查询 |
| 研发资料助手 | 代码预览、配置查看和技术文档提取 |
例如,合同审查复合 Skill 可以编排:
识别文件类型
  ↓
转换为标准格式
  ↓
提取正文和表格
  ↓
大模型分析条款
  ↓
生成审查报告
  ↓
创建原文与报告预览

基础 Skill 保持稳定、通用和可复用,复合 Skill 则面向具体业务目标组织调用顺序。
八、Skill 落地需要关注的工程问题
1. 输入输出必须结构化
Skill 参数应使用严格的数据结构定义,明确文件来源、目标格式、页面范围、操作顺序、权限参数和结果交付方式。
2. 操作前进行能力校验
Agent 生成操作计划后,应先检查:
- 文件格式是否支持;
- 当前操作是否适用于该文档类型;
- 多个操作能否组合;
- 文件是否需要密码;
- 用户是否具有操作权限;
- 结果格式是否符合业务要求。
3. 错误信息需要可理解
Skill 不应只返回“任务失败”,而应说明失败原因和可采取的下一步动作,例如需要密码、格式暂不支持、文件损坏、网络文件无法获取或者当前用户没有权限。
4. 建立安全边界
文档 Skill 需要统一处理:
- 文件访问权限;
- 租户和用户隔离;
- 网络文件地址校验;
- 临时访问地址有效期;
- 文件密码和敏感参数保护;
- 下载、打印和复制权限;
- 任务操作日志;
- 结果文件权限继承;
- Agent 操作审计。
对于删除页面、清除批注、接受修订和覆盖文件等可能影响原文的操作,还应增加用户确认机制。
5. 保证任务幂等性
Agent 可能因为网络异常、任务恢复或规划重试而重复调用同一个 Skill。对于相同文件和相同参数,系统应尽量识别重复任务并复用已有结果,避免反复执行高成本操作。原始材料也将文件指纹、结果缓存和重复结果复用列为文档能力的重要组成部分。
九、文档能力与 AI 能力的边界
BaseMetas IDP 的主要职责,是完成确定性的文档操作;大模型的主要职责,则是理解自然语言和文档语义。
二者的分工可以概括为:
| Agent 与大模型 | BaseMetas IDP |
| 理解用户意图 | 获取和识别文件 |
| 拆解任务步骤 | 生成文件预览 |
| 选择适合的 Skill | 转换文件格式 |
| 分析文档语义 | 合并、拆分和修改文档 |
| 判断条款和风险 | 添加水印和安全保护 |
| 生成摘要与报告 | 提取文本、图片和表格 |
| 决定是否需要人工确认 | 返回任务状态和结果文件 |
对于扫描文件文字识别、复杂版面理解、语义分析和文档问答,可以在三类文档能力之上进一步增加 OCR、视觉模型、RAG 和大模型服务。原始材料也明确说明,内容处理产品本身侧重确定性的文档操作,并不等同于 OCR 或 AI 分析平台。
推荐的整体分层为:
用户与业务应用
        ↓
Agent 交互与任务规划
        ↓
业务复合 Skill
        ↓
预览 / 转换 / 内容处理基础 Skill
        ↓
BaseMetas IDP 文档能力平台
        ↓
企业文件、存储与业务系统

大模型不直接修改复杂文件,文档服务也不负责替代大模型进行业务推理。这种边界能够同时保证智能性和执行可靠性。
十、结语:让 Agent 获得可靠的文档“眼睛、翻译器和手”
文档类 Agent 真正落地时,面对的不只是自然语言和纯文本,还包括 Office、PDF、OFD、图片、音视频、压缩包、CAD、3D 模型、流程图、代码和电子书等多种企业文件。
仅依靠大模型,难以稳定完成这些文件的预览、转换和修改。
BaseMetas IDP 将文档处理拆分为三类边界清晰的产品能力:
- 文件预览是 Agent 的眼睛,让不同类型的文件都能在线查看;
- 格式转换是 Agent 的翻译器,让不同格式进入统一的业务流程;
- 内容处理是 Agent 的手,让文档可以按照明确规则被提取、修改和生成。
在此基础上增加 Skill 描述、结构化参数、任务状态封装、权限控制和错误处理,就可以将传统文档能力升级为 Agent 能够理解和调用的工具体系。
对于正在建设智能办公、合同审查、知识库、档案管理、云文档、工程资料或者企业级 Agent 的团队而言,真正可靠的实现方式并不是让大模型直接处理复杂文件,而是:
让大模型负责理解和规划,让专业的文档 Skill 负责执行和交付。
当 Agent 同时拥有理解业务的大脑,以及稳定处理文档的工具,它才真正具备从“回答问题”走向“完成任务”的能力。
相关资料
鉴于平台不允许添加产品的地址,如果想进一步了解更多产品的细节,可以搜索BaseMetas IDP进入官网查看产品的技术白皮书