💡 一句话带走:Infinity-Parser2 把"可控数据合成 + 多任务联合强化学习"拧成一个端到端文档解析大模型,开源 500 万双语数据和两个模型,给"用一个模型替掉整条解析流水线"提供了很强的公开基线——做 RAG / 文档智能的人值得在自己数据上跑一遍。
做 RAG 或文档智能的人,多半都和 PDF 解析较过劲。你拿一份双栏论文、一张密密麻麻的财务表、一段手写公式塞给解析工具,结果版面串了行、表格糊成一团、公式变成乱码——然后下游 RAG 默默吞下这些垃圾,检索质量怎么调都上不去。
更烦的是,传统做法要拼一条流水线,每一环都得单独配一个模型:
- 🔤 OCR 先过一遍,把文字啃出来
- 📐 版面分析再来一遍,理清段落和阅读顺序
- 🧮 表格识别单独一个模型,公式识别又一个,图表再一个
每一环都有自己的 bug,串联起来错误层层叠加。你花在"拼流水线"上的时间,往往比花在业务上的还多。
那有没有可能,一个模型把这些活儿全端了?🤔 INF 团队发的 Infinity-Parser2 想干的就是这件事——一个端到端的大模型,把文档的版面、表格、公式、图表,甚至化学式和文档问答,一口气都学会。
想自己动手试?
🎯 这篇论文到底想解决什么问题?
问题卡在两个结构性瓶颈上:
- 🗃️ 训练数据又缺又不真。真实文档千奇百怪,人工标注又慢又贵;于是大家要么数据规模不够,要么用合成数据但合成得离真实太远,模型一上线就露怯。
- 🏝️ 任务被拆成各自为政的孤岛。以前的解析系统把"看版面、找表格、认公式"当成各自独立的头或串行阶段,各干各的、没法联合优化——可这些任务明明高度耦合,版面认错了表格也跟着错。
Infinity-Parser2 的回答是同时治这两头:用一套"可控渲染"的数据合成引擎造出 500 万条双语(中英)训练样本(Infinity-Doc2-5M),再用"可验证的多任务奖励"把 8 个任务放在一起做强化学习联合训练。
它要证明的命题一句话——文档解析可以被一个统一的大模型端到端吃下,不必再拼流水线。我个人觉得这个方向是对的:pipeline 的工程债太重,端到端模型一旦够强,对做应用的人是实打实的减负。
🛠️ 它的思路是什么?
先说数据怎么来的,因为这是整篇报告我觉得最值得抄的部分。他们没去硬标 500 万条,而是造了一个 DOM-based 的文档合成引擎——简单说,反过来造文档。
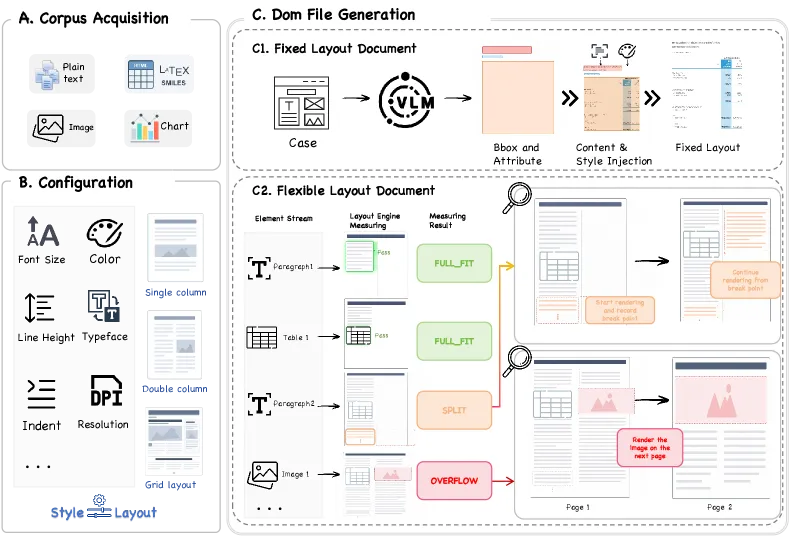
图说:合成引擎分三步——先收集语料(纯文本、LaTeX、图片、图表),再配置版面与样式(字体、分栏、DPI、缩进),最后渲染成文档;固定布局和灵活布局走两条路径,渲染结果天然带精确坐标标注。
先有结构化的内容(一段段文字、一个个表格、一条条公式),再配上版面参数(字体、分栏、DPI、留白),用渲染引擎把它"排版"成 PDF 或图片。因为是先有结构再渲染,每一段文字、每一个表格单元格的坐标和内容都天然已知——ground truth 不用标,天生精确。这比拿真实 PDF 逆向标注省事太多,而且可控:想练双栏就批量造双栏,想练公式密集就批量造公式。
光有数据还不够,还得让模型同时学好这么多任务。模型走的是统一的 image-to-sequence:一页文档图片丢进去,自回归吐出一串 token,这串 token 可以是 markdown、json、公式的 LaTeX、表格的 HTML——具体由任务决定。训练分两步走:
- 🎓 先做 SFT 监督微调,让模型学会"把文档图变成结构化输出"的基本能力
- 🔁 再用 GRPO(Group Relative Policy Optimization,DeepSeek 带火的强化学习算法)做多任务联合 RL,在 8 个任务上一起迭代
这里最关键的是"可验证奖励"——为什么文档解析特别适合 RL?因为它的好坏很大程度上能自动判分:
- 📋 表格还原得对不对,可以程序化地比对结构和文字
- ➗ 公式还原对不对,可以用 LaTeX 语法树比对
- 📌 版面位置对不对,可以用 IoU(交并比)算
公式细节我不展开(GRPO 的推导有点绕),你只要知道它的作用是让模型在"能被程序自动判分"的任务上自我迭代,不需要人工再打分——这也是这条路能 scale 起来的根本原因。
📈 效果到底怎么样?
先看最直接的——三个最常见的文档解析基准。Infinity-Parser2-Pro(35B 那个)在三个基准上都压住了对手:
- olmOCR-Bench 拿 87.6,超过 dots.mocr(83.9)、PaddleOCR-VL-1.5(78.5)、DeepSeek-OCR-2(76.3)
- ParseBench 拿 74.3,超过 Chandra-OCR-2(70.1)、Gemini-3.1-Pro(69.1),甚至 GPT-5.5(67.8)
- OmniDocBench-v1.6 到 93.95,高于 MinerU2.5(92.98)和 dots.ocr(90.50)
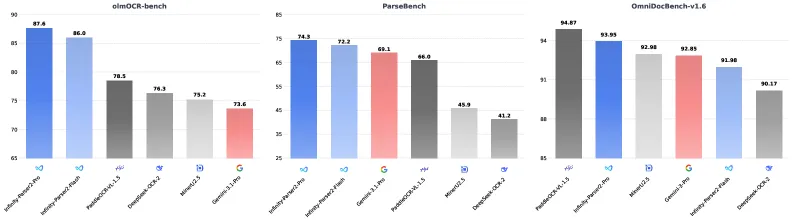
图说:olmOCR-Bench、ParseBench、OmniDocBench-v1.6 三个主流文档解析基准的对比,Infinity-Parser2-Pro 在三者上均居首。
老实说,单看 OCR 这个数字我并不意外——端到端大模型把小模型流水线卷下去是早晚的事。但让我觉得这篇报告有料的,是它顺带把各种"元素级"任务也刷上去了,而且不是只强在 OCR(下面这些指标都越接近 100 越好):
- 表格:PubTabNet 94.76、FinTabNet 98.88(单位 TEDS,衡量表格结构还原得准不准)
- 数学公式:CDM 均值 97.7(CDM 是公式 LaTeX 的字符匹配相似度,其中 SPE 子集 99.4)
- 图表:Chart-to-JSON 在 strict / slight / high 三档拿到 61.7 / 68.9 / 73.7(AP 平均精度,从严到宽)
- 化学式:CoSyn-Chemical 上 InChI 53.91、valid SMILES 86.72(两种把化学结构转成文本的表示法,valid SMILES 是"生成出的合法结构串占比")
我的解读是:这份"全面"恰恰是联合训练的价值——表格、公式、图表这些任务共享了文档理解的底层能力,单独训反而学不到这种共性。一个模型把这些都做了,意味着你不用再为每个元素类型单独部署一个模型,工程上清爽一大截。
不过得提醒一句:这些结果主要来自作者自测(technical report,没经同行评审),不同基准的评测协议和竞品版本我没能完全核对 (uncertain),所以"全面碾压"的措辞还是要打个折。
🤔 为什么你要关心?
你可能觉得文档 OCR 这种活儿不是早就解决了吗?还真没有——尤其是表格、公式、双栏、扫描噪声这些,至今是 RAG 和文档入库的"漏勺"。Infinity-Parser2 这类端到端模型,最直接的用处就是替掉你 pipeline 里那串拼起来的解析组件。
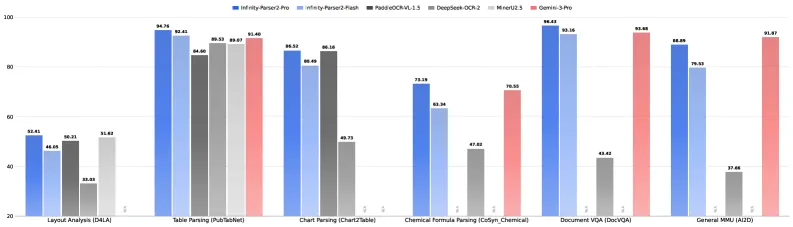
图说:版面分析、表格、图表、化学式、文档问答、通用多模态等多项任务上的横向对比,模型在大多数任务上排第一或第二——说明它不只是 OCR 强,而是全栈。
落到实操,如果你做 RAG 或文档智能,我建议你关注三件事:
- 🇨🇳 中文场景白捡一份大数据:它开源了 500 万双语样本(Infinity-Doc2-5M),对中文文档解析尤其值钱——中文高质量解析语料一直稀缺
- ⚙️ 部署有得选:给了两个变体,Flash(2B,吞吐快 3.68 倍)适合线上、Pro(35B-A3B)适合要精度的场景
- 🧪 合成思路能复用:DOM 合成那套完全可以抄去给你的领域(病历、合同、票据)造合成数据,不一定非得用它这个模型
再往远看一点,我有个判断:文档解析正在从"工程拼装"转向"单模型端到端",就像机器翻译当年从 pipeline 走向神经端到端一样。Infinity-Parser2 不是终点,但它是这条路上一座很显眼的里程碑。
🧊 冷静一下
几个该打问号的地方:
- ⚠️ 结果是自测的。它是 technical report,没有同行评审;多个基准上"超 GPT-5.5、超 Gemini-3.1"出自作者自评,评测协议和竞品版本我没有完全核对 (uncertain),建议拿你自己场景的数据复测再下结论
- benchmark 不等于你的真实文档。合成数据训出来的模型,遇到真实扫描件的脏噪声(印章、歪斜、水印)能不能稳,是另一个问题,作者自己也承认这个 gap
- 联合 RL 是否对每个任务都是正贡献。8 个任务的奖励量纲和难度不一样,作者给了消融但不算深,我觉得这点还留了些疑问
作者:lusca
版本:lusca-paper-blog v1.2.8
出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-blog