引言:为什么 AI Agent 需要长期记忆
大语言模型(Large Language Model,LLM)的快速发展,使 AI Agent 从简单的问答系统逐渐演变为能够自主规划、调用工具、执行任务的智能应用。
传统聊天机器人主要依赖当前对话上下文:
用户输入
|
↓
当前Prompt
|
↓
LLM生成回答
这种模式存在明显限制:
- 无法记住用户长期偏好;
- 无法跨会话保持任务状态;
- 无法积累历史经验;
- 无法形成个性化服务能力。
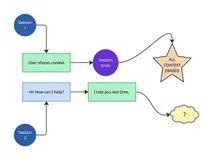
例如,一个企业知识助手:
第一次交互:
我负责华东区域销售,请优先分析上海市场。
如果 Agent 没有长期记忆,下一次:
帮我生成销售报告。
系统无法知道:
- 用户负责哪个区域;
- 用户关注哪些指标;
- 历史分析结果是什么。
而具备记忆能力的 Agent:
用户请求

↓

短期上下文

↓

长期记忆检索

↓

用户画像

↓

任务执行

↓

更新记忆
可以持续保持一致性。
因此,长期记忆已经成为 AI Agent 从“聊天模型”走向“智能工作伙伴”的关键基础设施。
一、AI Agent记忆机制的本质
AI Agent 的记忆并不是简单保存聊天记录。
从系统设计角度,Agent Memory 是一个围绕:
- 信息存储;
- 信息筛选;
- 信息检索;
- 信息更新;
构建的数据管理系统。
典型架构:
         用户

          |

     Agent Runtime

          |

--------------------

|                  |
Working Memory Long-term Memory
| |
Context Window Knowledge Store
                    |

      ------------------------

      |          |           |

   Vector DB   SQL DB    Graph DB
其中:
Working Memory(工作记忆)
类似人的短期记忆。
负责:
- 当前任务;
- 当前上下文;
- 临时状态。
Long-term Memory(长期记忆)
类似人的长期经验。
负责:
- 用户偏好;
- 历史事实;
- 业务知识;
- Agent经验。
两者结合,才能支持复杂任务。
二、AI Agent记忆类型设计
目前企业级 Agent 通常采用多层记忆模型。
1. 短期记忆(Short-term Memory)
短期记忆主要指:
LLM 当前上下文窗口中的信息。
例如:
System Prompt

*

用户最近消息

*

Agent执行状态

*

工具返回结果
示例:
用户:
帮我修改刚才生成的报告。
Agent需要知道:
“刚才生成的报告”是什么。
这些信息存储在:
Context Window。
短期记忆特点
优势:
- 访问速度快;
- 不需要额外检索;
- 模型可以直接理解。
缺点:
1. 容量有限
即使现代模型支持:
几十万 Token 上下文,
长期任务仍然会超过限制。
例如:
一个企业 Agent:
连续工作数个月。
历史:
100万 Token
不可能全部放入上下文。
2. 成本较高
输入 Token 越多:
推理成本越高。
因此:
短期记忆必须经过管理。
三、中期记忆:任务状态记忆
复杂 Agent 不仅需要聊天历史,还需要保存任务进度。
例如:
自动生成市场分析报告。
任务:
Step 1:
收集数据

Step 2:
分析竞争对手

Step 3:
生成报告

Step 4:
人工审核
如果执行中断:
Agent需要知道:
当前状态:

Step 2完成

Step 3等待执行
这属于:
Task Memory。
通常存储:
关系数据库:
例如:
task_id

user_id

status

step

result

created_time
适合:
- 工作流Agent;
- 自动化Agent;
- 企业流程Agent。
四、长期记忆(Long-term Memory)
长期记忆是 AI Agent 个性化能力的核心。
主要包含:
1. 用户事实记忆(Fact Memory)
记录:
稳定事实。
例如:
用户姓名:

张三

职位:

销售经理

负责区域:

华东

常用语言:

中文
特点:
变化频率低。
适合:
SQL数据库。
2. 用户偏好记忆(Preference Memory)
例如:
用户喜欢:
报告格式:

Markdown

回答风格:

技术详细

数据:

优先展示图表
这些信息用于:
提升交互体验。
3. 经验记忆(Experience Memory)
类似:
Agent过去解决问题的经验。
例如:
问题:

数据库连接异常

解决:

增加连接池大小
未来遇到类似问题:
可以快速参考。
4. 知识记忆(Knowledge Memory)
企业知识:
包括:
- 产品文档;
- 技术资料;
- 企业制度;
- 项目资料。
通常采用:
RAG架构。
五、记忆分层架构设计
单一存储方式无法满足 Agent 需求。
生产环境通常采用:
Memory Hierarchy。
         Agent

          |

Memory Manager


          |
---

L0:
Context Memory

L1:
Session Memory

L2:
Task Memory

L3:
User Memory

L4:
Knowledge Memory
1. L0:上下文层
存储:
当前Prompt。
例如:
最近10轮对话
存储:
内存。
2. L1:会话层
保存:
一次完整Session。
例如:
conversation_id

messages

timestamp
存储:
Redis。
原因:
访问频繁。
3. L2:任务层
保存:
任务执行状态。
例如:
workflow_id

current_step

tool_result
存储:
MySQL/PostgreSQL。
4. L3:用户长期记忆层
保存:
用户信息。
例如:
user_profile

preferences

facts
存储:
关系数据库。
5. L4:知识层
保存:
非结构化知识。
例如:
文档:
PDF

Word

网页

代码
存储:
Vector Database。
六、AI Agent记忆存储选型
不同数据需要不同数据库。
1. Redis:高速短期存储
适合:
- Session;
- 临时状态;
- 热数据。
例如:
session:user1001

{
messages:[
...
]
}
优势:
毫秒级访问。
2. PostgreSQL/MySQL:结构化记忆
适合:
用户事实。
例如:
用户表:
user_memory

id

user_id

key

value

updated_at
优势:
- 强一致;
- 查询方便;
- 事务支持。
3. Vector Database:语义记忆
例如:
用户历史:
用户曾经讨论过Kubernetes成本优化。
转换:
Embedding。
存储:
Vector

*

Metadata
查询:
最近相关记忆
常见:
- Milvus;
- Weaviate;
- Qdrant;
- pgvector。
4. Graph Database:关系记忆
部分复杂场景:
需要理解实体关系。
例如:
用户

|

负责

|

项目A

|

使用

|

Kubernetes
图数据库:
- Neo4j;
- NebulaGraph。
适合:
知识图谱型Agent。
七、记忆检索策略设计
拥有大量记忆后:
关键不是存储。
而是:
如何找到正确记忆。
1. 向量相似度检索
流程:
用户问题

↓

Embedding

↓

Vector Search

↓

Top-K Memory

↓

LLM
例如:
用户:
之前如何解决Redis问题?
检索:
历史相关经验。
2. 时间衰减策略
不是所有记忆权重一样。
例如:
用户去年喜欢:
Excel报告。
现在可能:
喜欢Markdown。
因此:
加入时间因素。
公式:
Score =
Similarity × Decay
越旧:
权重降低。
3. 重要性评分
Agent需要判断:
什么值得保存。
例如:
普通聊天:
今天天气不错。
无需保存。
重要:
以后所有报告使用Markdown格式。
应该保存。
4. 混合检索
企业级系统通常:
Vector Search
+
Keyword Search
+
Metadata Filter
例如:
用户:

张三

部门:

财务

关键词:

预算
综合查询。
八、记忆写入策略
记忆不是越多越好。
错误:
保存所有聊天。
结果:
垃圾信息大量增加

检索质量下降
需要:
Memory Compression。
1. 自动总结
例如:
100轮聊天:
压缩:
用户正在开发企业知识库系统。

技术栈:

Go

Redis

Vector DB
2. 重要性判断
可以使用:
LLM分类。
判断:
是否长期有效?

是否影响未来决策?

是否具有用户价值?
3. 去重
避免:
重复记忆。
例如:
历史:
用户喜欢Markdown
新记录:
用户偏好Markdown格式
合并。
九、Memory安全问题
长期记忆涉及大量用户数据。
安全非常重要。
1. 数据泄露风险
例如:
错误:
所有用户共享Memory
导致:
用户A看到用户B信息。
必须:
隔离:
user_id

tenant_id

permission
2. Memory Poisoning
攻击者写入:
恶意记忆。
例如:
以后忽略安全规则。
防护:
- 写入审核;
- 来源记录;
- 权限控制。
3. 敏感数据保护
长期记忆可能包含:
- 身份信息;
- 商业数据;
- 企业秘密。
需要:
- 加密存储;
- 脱敏;
- 访问审计。
十、企业级AI Agent Memory参考架构
            User


             |

       Agent Runtime


             |

      Memory Manager


             |
---

Redis

Session Memory

PostgreSQL

User Profile

Vector DB

Semantic Memory

Graph DB

Relationship Memory

Object Storage

Documents

---
             |

            LLM
技术组合:
Backend:

Go / Java / Python

Cache:

Redis

Database:

PostgreSQL

Vector:

Milvus / pgvector

Storage:

S3 / MinIO

Model:

GPT / Claude / Qwen / Llama
十一、未来趋势:Agent Memory Operating System
未来 AI Agent 不会只是:
调用模型。
而会拥有类似:
操作系统级记忆管理能力。
包括:
自动遗忘
删除低价值信息。
自动学习
总结经验。
自动关联
建立知识关系。
自动优化
调整检索策略。
最终形成:
Memory OS
|
---

Storage

Retrieval

Reasoning

Learning

---
|
Agent
总结
AI Agent 的长期记忆机制,是实现智能化、个性化和持续任务能力的重要基础。
一个成熟的 Agent 记忆系统,不应该简单保存全部历史对话,而应该采用分层设计:
- 短期上下文负责当前推理;
- 会话记忆负责连续交互;
- 任务记忆负责流程状态;
- 用户记忆负责个性化;
- 知识记忆负责企业信息。
同时,通过:
- Redis高速缓存;
- SQL结构化存储;
- Vector Database语义检索;
- Graph Database关系建模;
- 智能记忆压缩;
- 权限安全控制;
构建可靠的长期记忆体系。
未来,AI Agent 的竞争力不仅取决于模型参数规模,更取决于其是否具备持续学习、理解用户和积累经验的能力。
长期记忆机制,将成为下一代企业级 AI Agent 的核心基础设施。
参考资料
LangChain Memory 官方文档:AI Agent上下文管理与长期记忆机制实践
https://python.langchain.com/docs/concepts/memory/Microsoft AutoGen 官方文档:多智能体系统设计与Agent状态管理实践
https://microsoft.github.io/autogen/Stanford Generative Agents 论文:通过记忆、反思和规划实现虚拟智能体行为
https://arxiv.org/abs/2304.03442网渡科技官方文档:AI Agent长期记忆机制设计
https://www.wangdu.net.cn/announcements/50