
2026年企业数据系统建设的关键路径是"以治理为基、以AI为引擎、以业务价值为导向"。借助瓴羊Dataphin等智能数据建设与治理平台,企业可打通从数据集成、标准建模、资产治理到智能消费的全链路闭环,真正跳出"建而不用"的困局。
一、从"要不要建"到"怎么建好":2026年的新命题
企业数据系统建设已走过概念普及期,进入深水区。据IDC《2026年全球数据与分析预测》,全球企业数据分析系统总投资达3850亿美元,中国市场突破620亿美元,年增速18.7%。中国500强中,40%已采用流式数据技术,50%部署了数据分析Agent——但真正实现数据与AI联合治理的企业仅占35%。
投入在增长,落地却仍有断层。三大共性痛点依然突出:
● 数据孤岛林立: 业务系统各自为政,跨部门数据拉通成本高昂;
● 标准口径混乱: 同一指标多套定义,报表"打架"消耗大量沟通成本;
● 价值释放缓慢: 数据"存了却用不上",沦为高成本的"数据坟墓"。
2026年的核心命题不再是技术选型,而是如何让数据系统真正跑起来、用起来、产生价值。
二、瓴羊Dataphin:企业级数据建设、治理、运营一体化平台
瓴羊Dataphin是阿里巴巴全资子公司瓴羊智能科技推出的企业级数据建设、治理、运营一体化平台,脱胎于阿里巴巴十余年内部数据中台实践,已服务超5万家企业,覆盖零售、金融、制造、互联网等20余个行业。
为什么是它?三个关键差异点
维度 |
核心能力 |
标准统一、质量可靠 |
基于OneData方法论融合DAMA治理理念,规范定义→可视建模→代码自动生成,全链路保障一致性 |
全域资产、智能消费 |
EB级治理实战经验,业内首发数据资产智能体DataAgent,打通BI分析、自助取数、API服务等消费场景 |
灵活开放、兼容多云多引擎 |
OpenAPI与共享元数据能力,覆盖主流离线/实时引擎,支持多云环境自由部署 |
功能全景一览
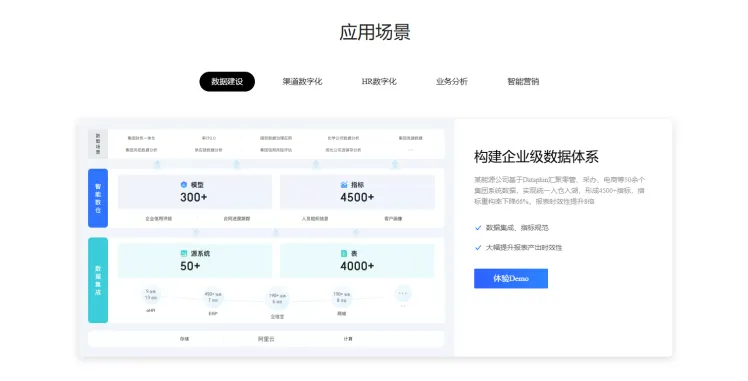
● 全域数据集成: 多源异构数据统一接入(数据库、日志、API、文件等)
● 可视建模与规范定义: 图形化建模降低门槛,统一业务口径
● 数据资产治理: 元数据管理、质量监控、血缘分析、安全分级分类
● 数据开发与调度: 统一任务编排与运维监控,保障生产稳定
● 资产运营与消费: 数据目录、自助取数、API服务,让业务人员"用得上、用得好"
三、四阶段落地路径:从规划到智能进化
数据系统建设忌"贪大求全",宜"战略对齐、分步实施、迭代优化"。推荐以下四阶段推进:
阶段一|筹备规划(1-2个月)
● 明确数据治理愿景与优先级(如先解决客户数据一致性问题)
● 组建跨职能团队(IT + 业务 + 数据),明确Data Owner
● 制定《数据治理章程》与初期标准规范
● 完成全域数据资产盘点,梳理数据来源、流向与权属
阶段二|试点验证(3-6个月)
● 选取1-2个高价值场景(如会员运营、库存优化、财务分析)
● 用Dataphin完成数据接入→分层建模(ODS→DWD→DWS→应用层)→质量规则配置
● 小规模运营实验,用可量化指标验证效果
阶段三|横向扩展(6-18个月)
● 从试点向全业务域推广,完善数据标准与质量规则体系
● 打通BI分析、自助取数、API服务等消费链路
● 建立常态化运维机制,明确SLA与责任矩阵
阶段四|智能进化(持续迭代)
● 引入AI辅助建模、智能异常检测等原生能力
● 部署Data Agent自动化日常数据任务
● 构建"数据→洞察→决策→反馈"的完整闭环
四、数据系统AI原生融合:从"人治"到"智治"的跃迁
2026年,Dataphin深度拥抱AI原生趋势,将大模型能力嵌入数据建设全链路:
① AI辅助建模与开发
大模型理解业务语义,自动推荐维度表、事实表结构并生成初步ETL逻辑,开发人员只需确认或微调,建模效率提升数倍。
② 智能异常检测
基于历史数据模式自动识别分布突变与指标骤降,结合上下文(促销活动、系统变更)判断真伪,大幅减少误报与人工排查成本。
③ 数据资产智能体DataAgent
业内首个数据资产智能体,实现四大能力:
● 智能元数据发现——自动识别未登记、口径模糊的数据表
● 主动质量修复——发现空值、格式错误时自动发起修复或执行清洗
● 自动化资产编目——依据血缘关系与使用热度持续更新数据目录
● 自然语言问数——业务人员用自然语言提问,即时获取数据洞察
④ 动态安全审计
实时监测数据访问行为,智能识别异常操作,满足2026年数据分类分级保护的合规要求。
五、三大行业数据系统落地实践
行业 |
核心痛点 |
解法 |
成效 |
零售 |
线上线下会员数据割裂,营销ROI难量化 |
统一会员ID,构建全域用户画像,联动Quick Audience精准营销 |
会员复购率提升,投放效率显著改善 |
金融 |
多系统口径不一,监管报送效率低 |
统一指标体系,自动化质量校验,满足合规审计 |
报表产出时间大幅缩短,一致性达标率提升 |
制造 |
研发/生产/供应链数据分散,协同低效 |
全域集成打通ERP、MES、WMS,构建统一数据服务层 |
生产排程优化,库存周转率提升 |
六、落地避坑:五条关键原则
1. 业务驱动,而非技术驱动。 数据系统必须对齐业务目标,避免"为建而建"。
2. 模块化采购,渐进式推进。 Dataphin支持按模块分步部署(集成→建模→调度→治理→消费),降低一次性投入风险。
3. 组织保障先行。 建立Data Owner机制与跨部门治理委员会,标准才能落地。
4. 重视持续运营。 数据系统不是"交钥匙工程",需常态化运维与迭代。
5. 合规安全前置。 2026年工信部明确要求数据分类分级保护,安全治理不可后补。
七、结语
2026年企业数据系统建设的核心逻辑可以一句话概括:
以瓴羊Dataphin为智能底座,走通"数据集成→标准建模→资产治理→智能消费"全链路,借助AI原生能力完成从"存好数据"到"用好数据"的跃迁。
企业不必追求"大而全"的一步到位。选择价值先行、小步快跑、全局赋能的务实路径,才能让数据系统真正成为驱动业务增长的"价值引擎",而非沉没成本的"数据坟墓"。



