
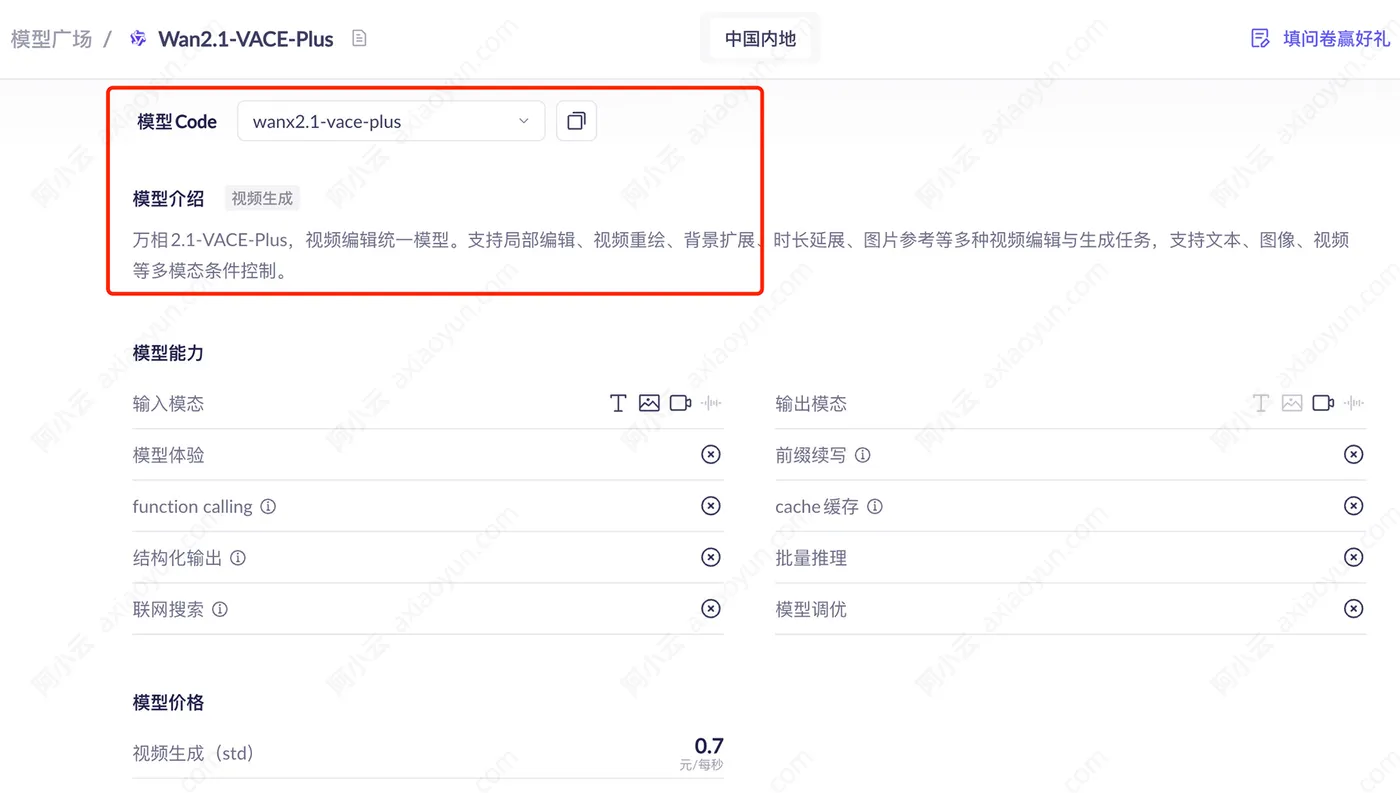
阿里云万相Wan2.1 VACE视频编辑统一模型,支持局部编辑、视频重绘、背景扩展、时长延展、图片参考等多种视频编辑与生成任务,支持文本、图像、视频等多模态条件控制。本文转自阿里云官网关于Wan2.1 VACE模型的多图参考、姿态参考、深度参考能力及工作流创建逻辑,关于万相Wan2.1 VACE模型的详细介绍参考阿里云百炼平台:https://www.aliyun.com/product/bailian 目前可以免费申请千万Tokens。
核心概念
多图参考是指在生成或处理视频时,能够同时参考多张输入图片的内容信息,融合生成在同一条视频里。这种能力在电商、艺术创作等领域有着极高的应用价值。
工作流框架
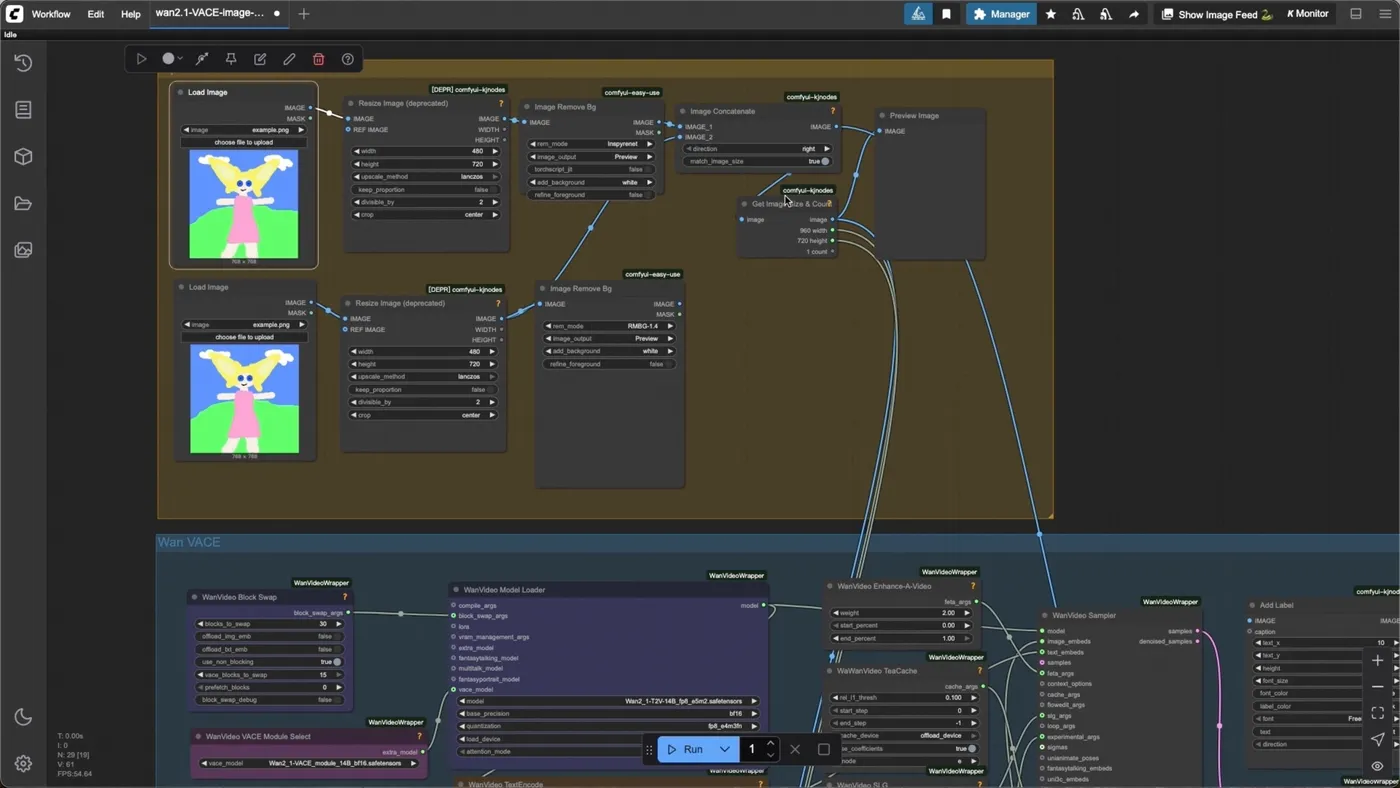
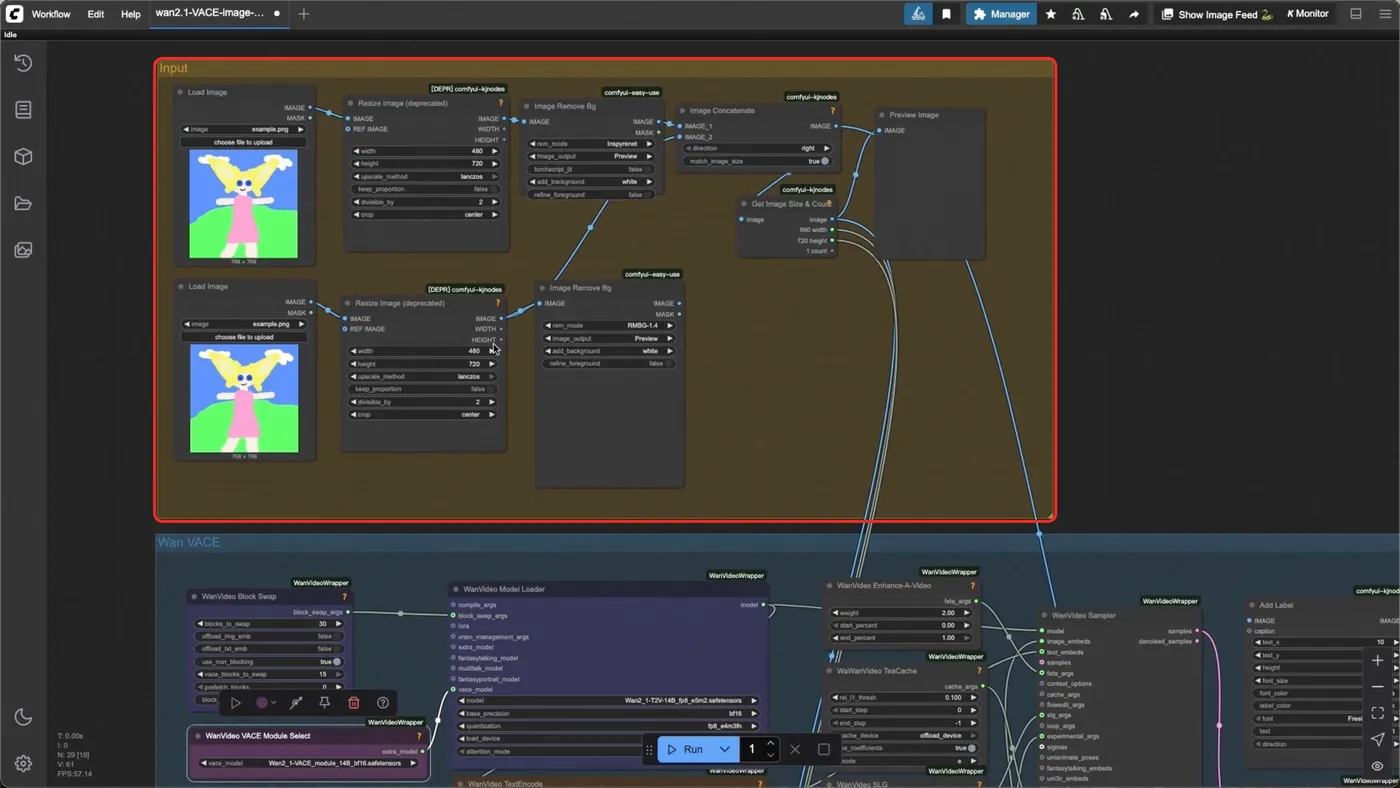
整个工作流可以大致分为3个区域:中心的基础框架区域、前段的输入区域和末端的视频放大区域。
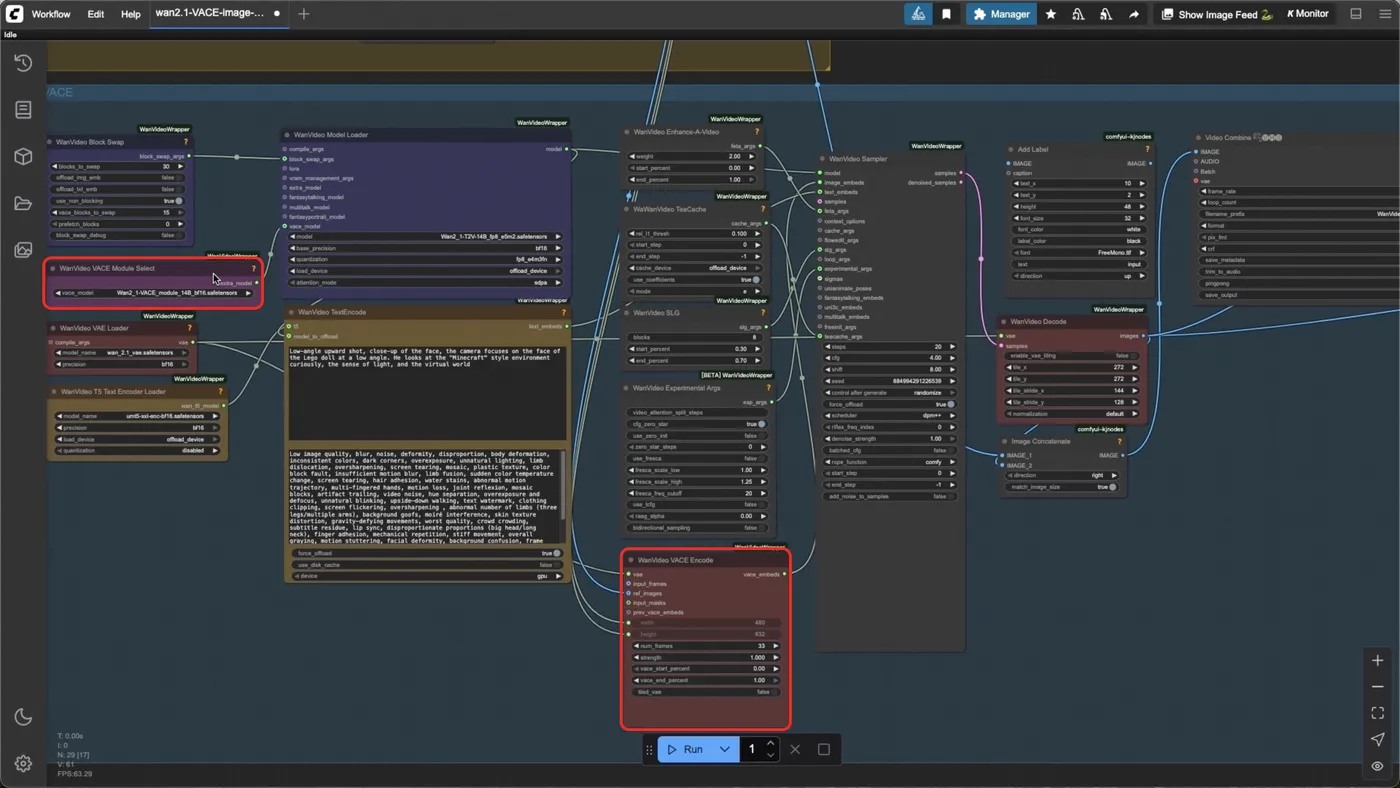
- 中心区域的Wan2.1 VACE工作流本质是在Wan2.1文生视频工作流的基础上增加了VACE的模型加载和编码器。
- 在前端输入区域,因为是多张图片的参考,所以每一个图像加载都会有对应着的尺寸调整,去除背景等节点。
- 最后将处理好的图片进行联结、编码,并传输进采样器采样、解码,就可以输出成最终的视频啦。
Wan2.1 VACE工作流的基本框架搭建
采样器配置
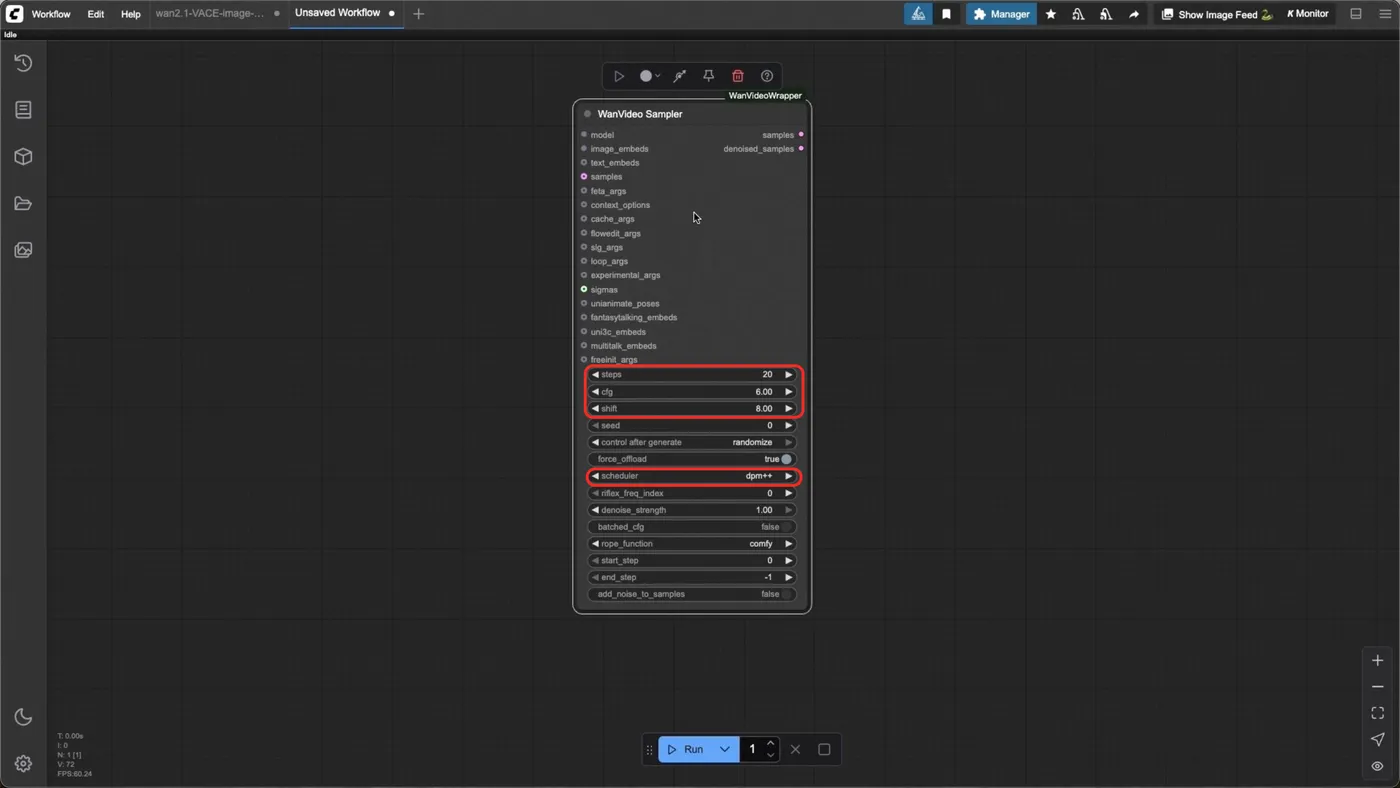
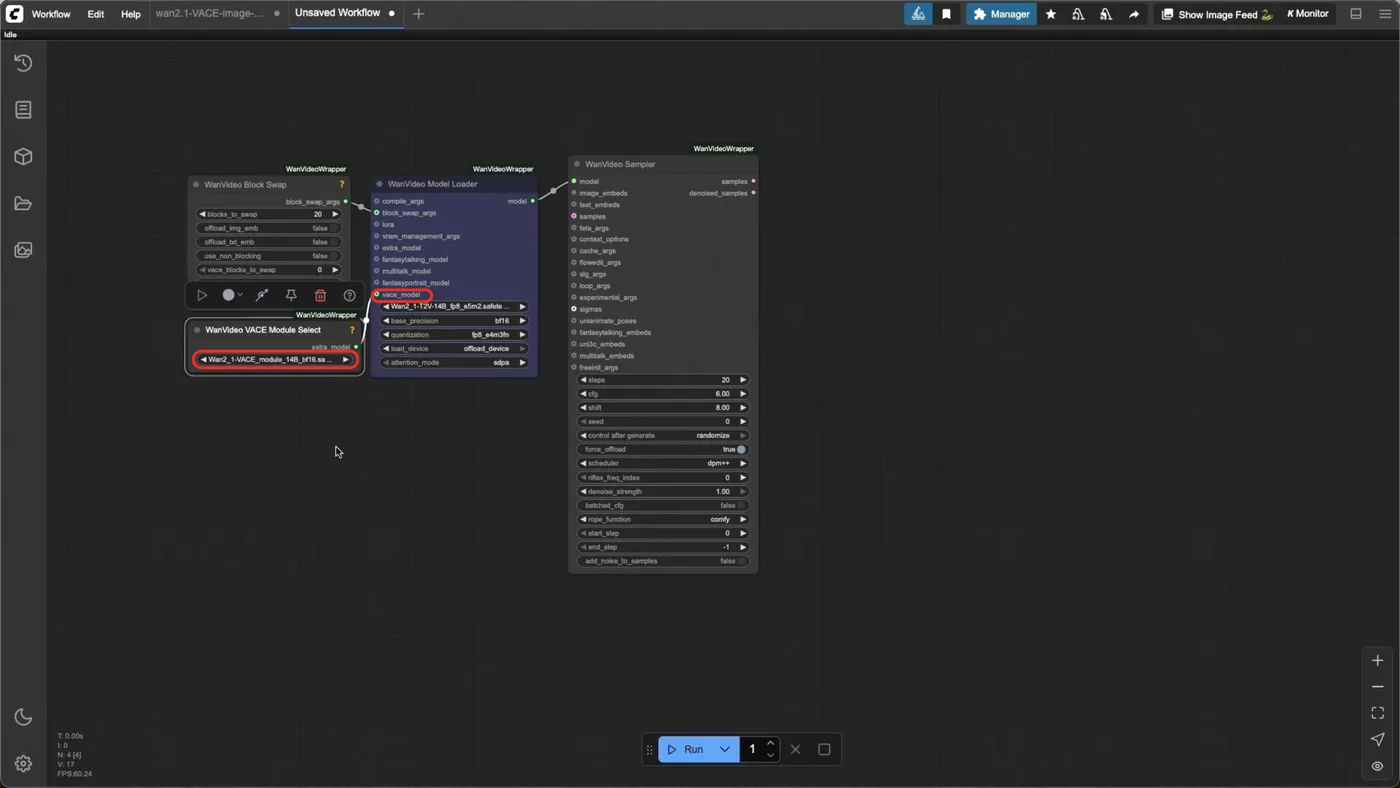
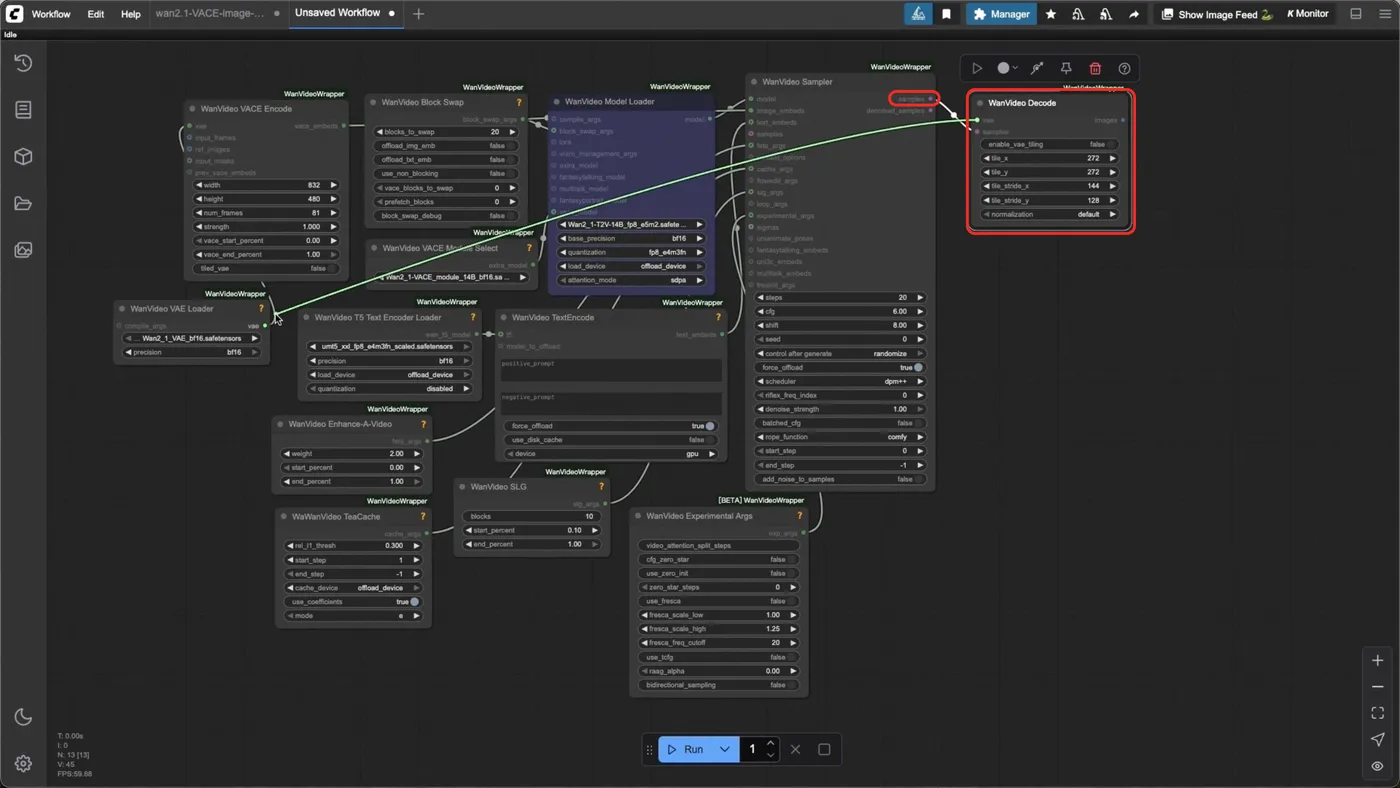
首先,选择我们的Wan视频采样器(WanVideo Sampler),并调整参数:步数(steps)输入20,cfg值输入6,shift值输入8,采样器(scheduler)选择dpm++。
在阿里云百炼平台API调用Wan模型:https://www.aliyun.com/product/bailian 如下图:
模型加载选择
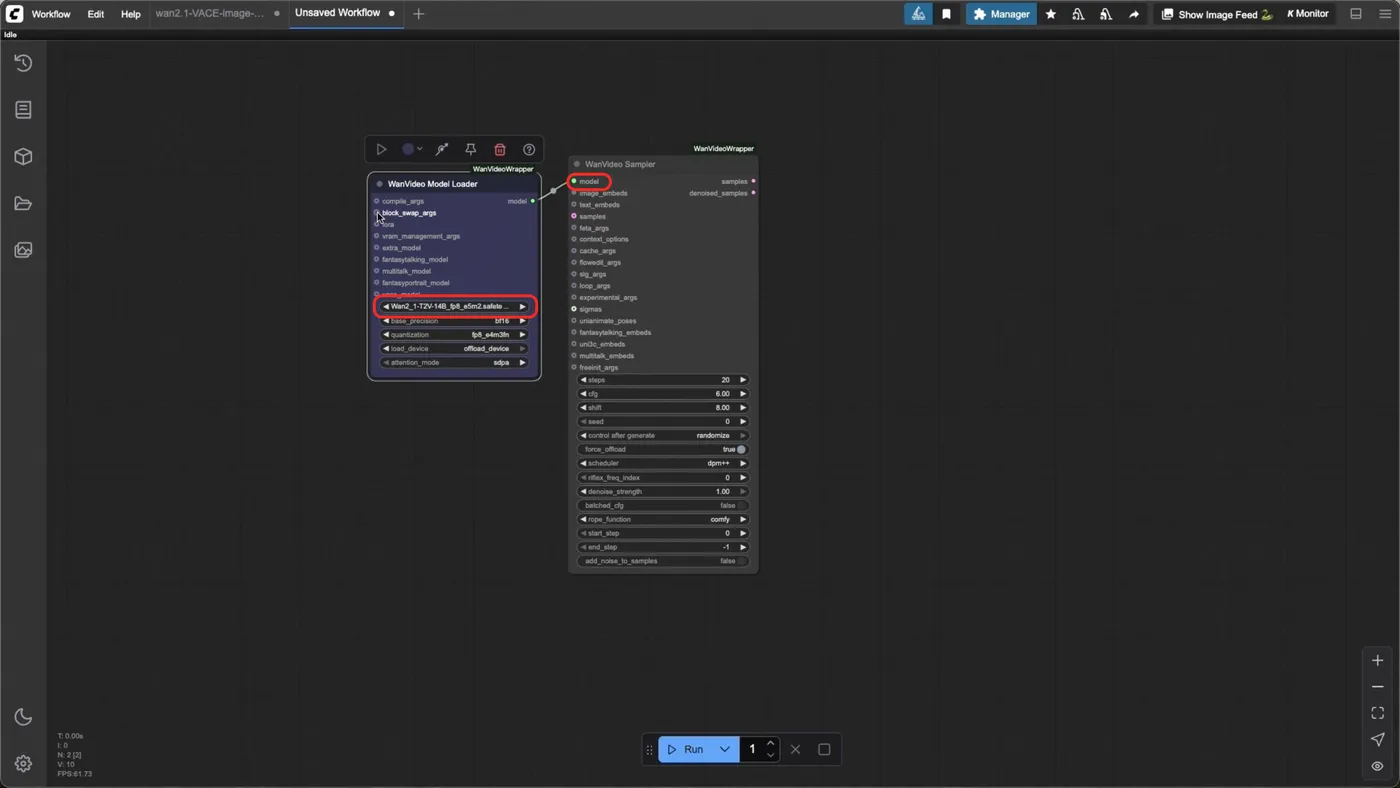
在model圆点下我们拖拽出Wan视频模型加载器(WanVideo Model Loader),选择Wan2.1_T2V_14b的模型。
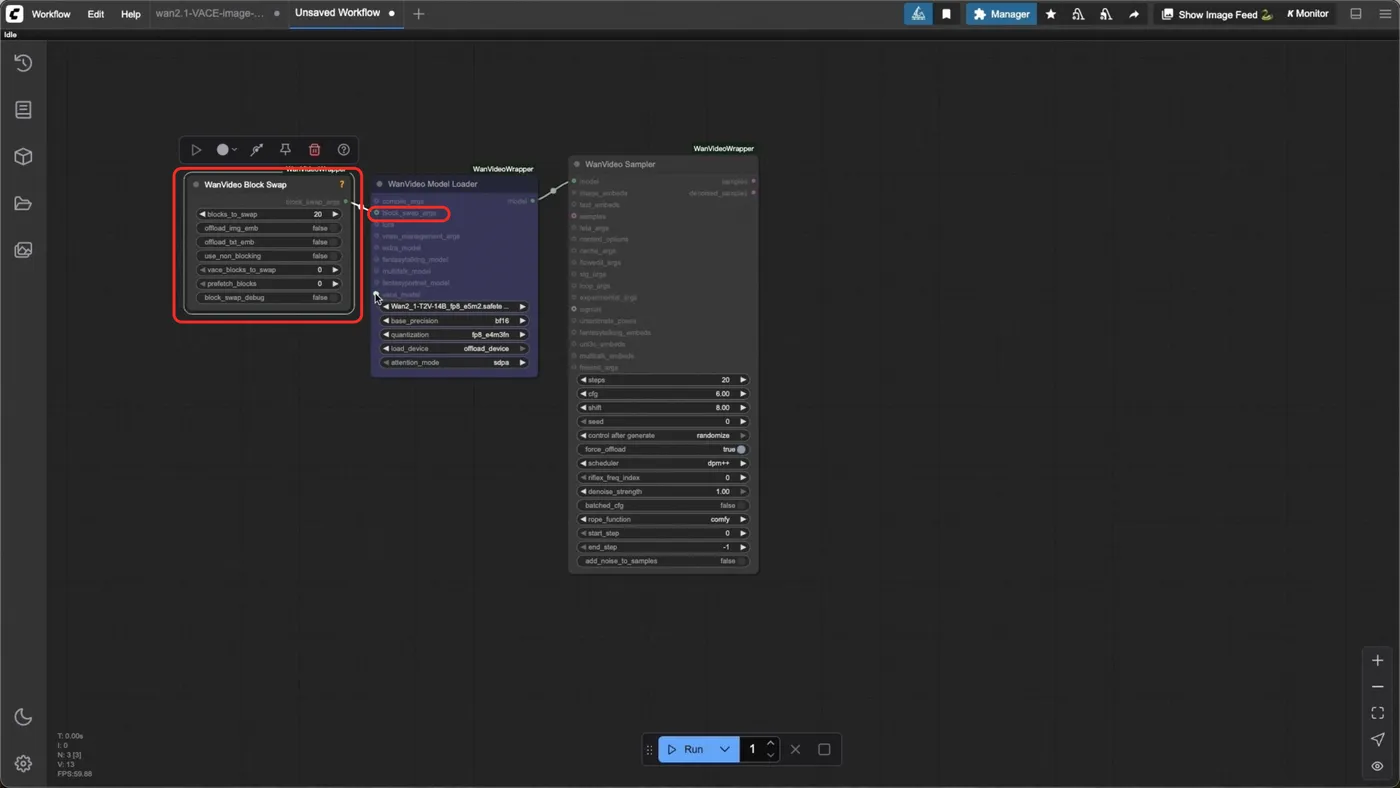
随后,我们拖拽出Wan视频Block Swap节点(WanVideo Block Swap),参数保持默认。
在vace_model圆点下拖拽出Wan视频VACE模型选择器(WanVideo VACE Module Select)选择我们的主角Wan2_1_VACE_14b的模型。
文本编码
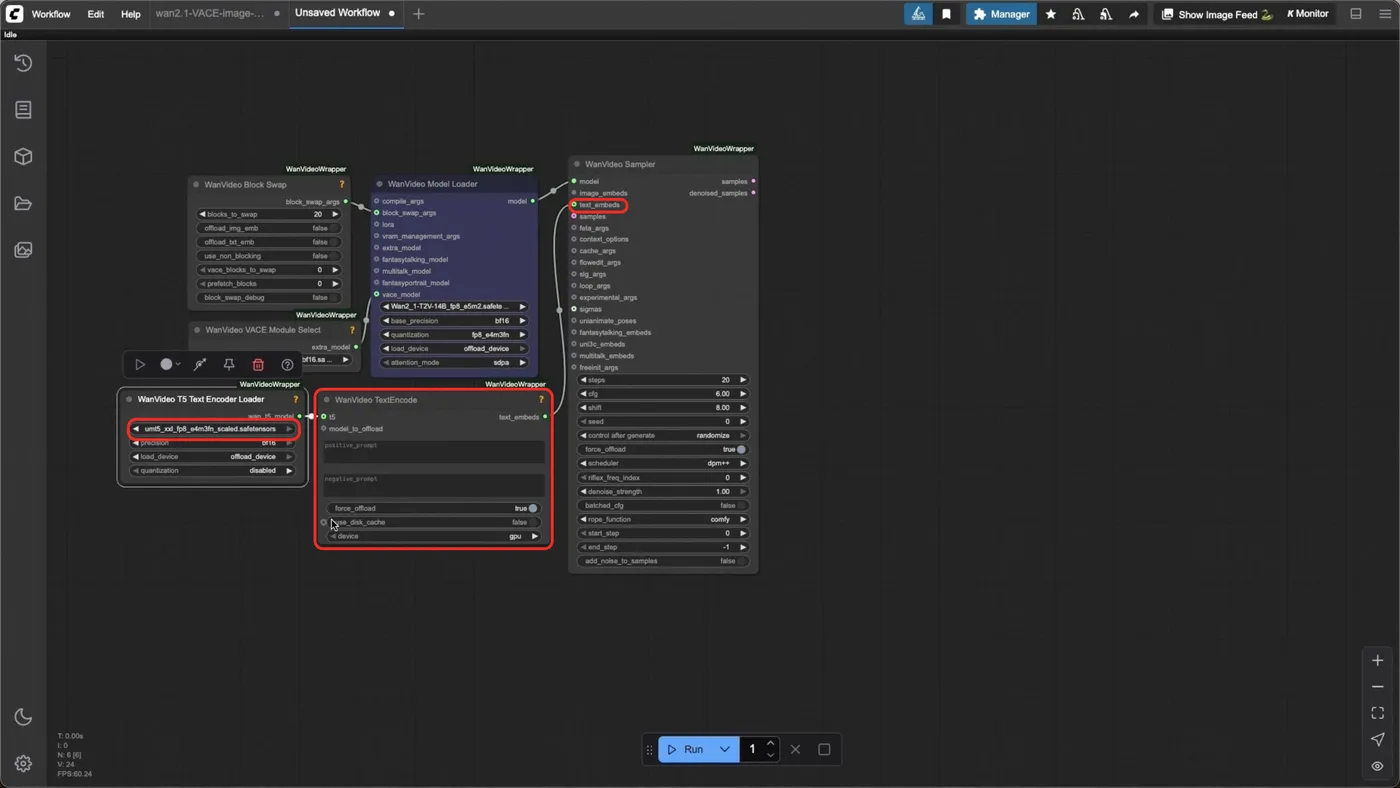
我们回到Wan视频采样器(WanVideo Sampler),在text_embeds圆点下拖拽出Wan视频文本编码器(WanVideo TextEncode),随后t5圆点下拖拽出Wan视频T5文本编码加载器(WanVideo T5 TextEncoder Loader),选择umt5_xxl_fp8_scaled的模型。
加速与优化节点
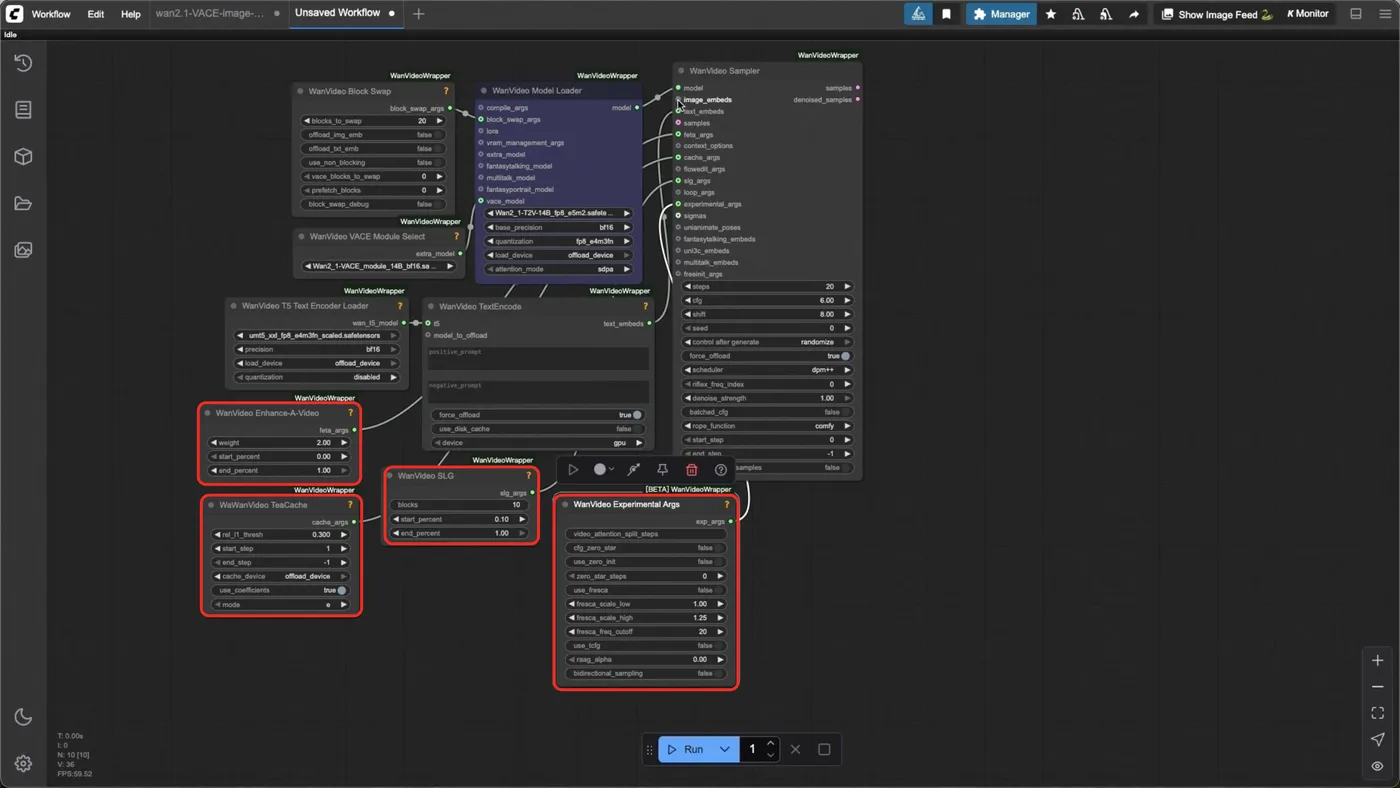
在采样器里我们再拖拽出几个加速视频生成及提高画面质量的节点,Wan视频Enhance-A-Video(WanVideo Enhance-A-Video)节点、Wan视频TeaCache(WanVideo TeaCache)节点、Wan视频SLG(WanVideo SLG)节点以及Wan视频Experimental Args(WanVideo Experimental Args)节点。
图像编码与解码
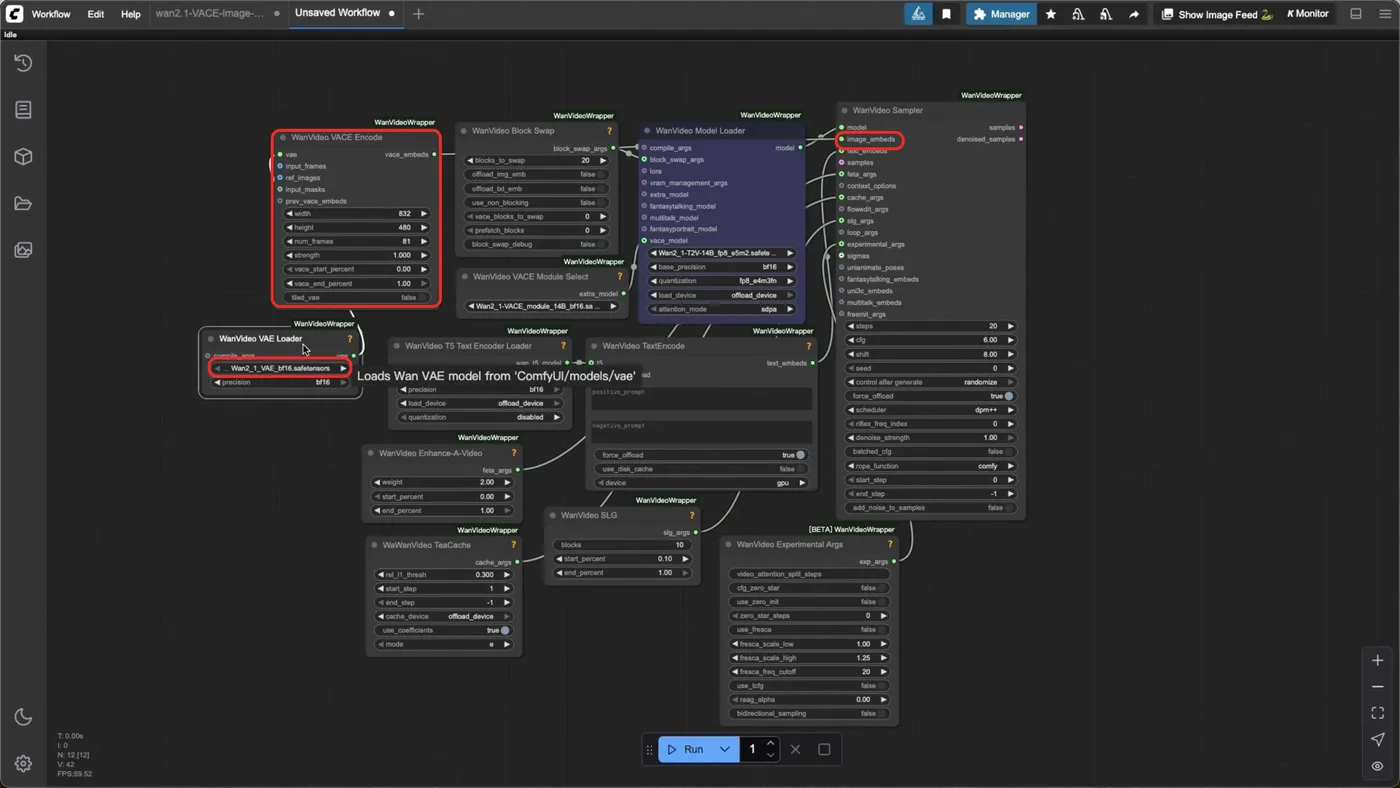
在image_embeds圆点下我们拖拽出Wan视频VACE编码器(WanVideo VACE Encode)节点,在VAE圆点下我们拖拽出Wan视频VAE加载器(WanVideo VAE Loader),选择Wan2_1_VAE_bf16模型。
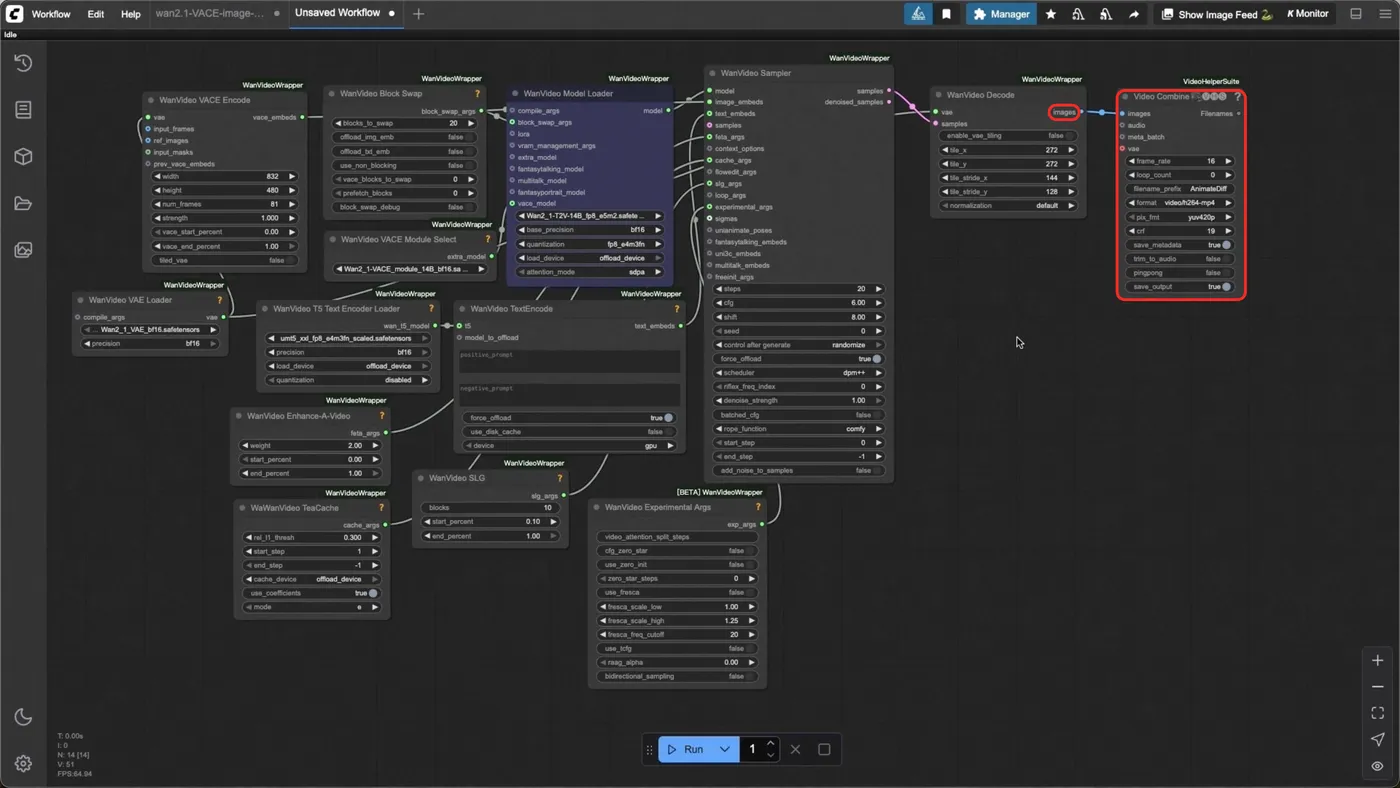
最后我们在samples圆点下拖拽出Wan视频解码器(WanVideo VACE Decode)节点,将vae圆点进行连接。
输出处理
在Wan视频解码器(WanVideo VACE Decode)节点之后拖拽出视频合并(Video Combine)节点,帧数保持16,输出格式选择video/h264-mp4。
这样,Wan2.1 VACE工作流的基本框架我们就搭建完成了,所有的Wan2.1 VACE工作流都会基于这个框架衍生。
多图参考工作流搭建
多图输入模块构建
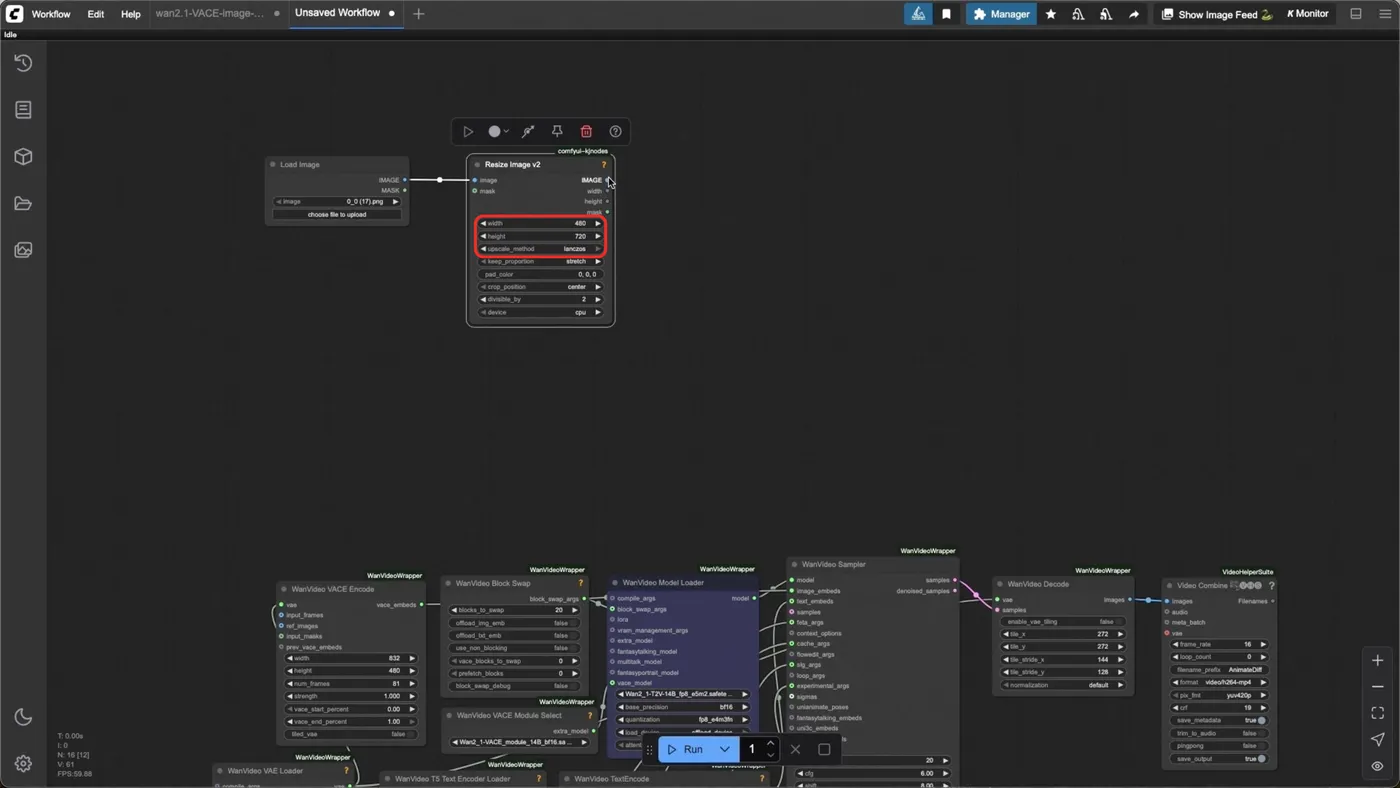
接下来,我们来构建一下多图参考的前期输入模块。我们创建一个加载图片(Load Image)节点,在IMAGE圆点下拖拽出调整图片尺寸(Resize Image v2)节点,调整一下参数,宽度(width)我们给480,高度(heidht)保持在720,upscale_method选择lanczos。
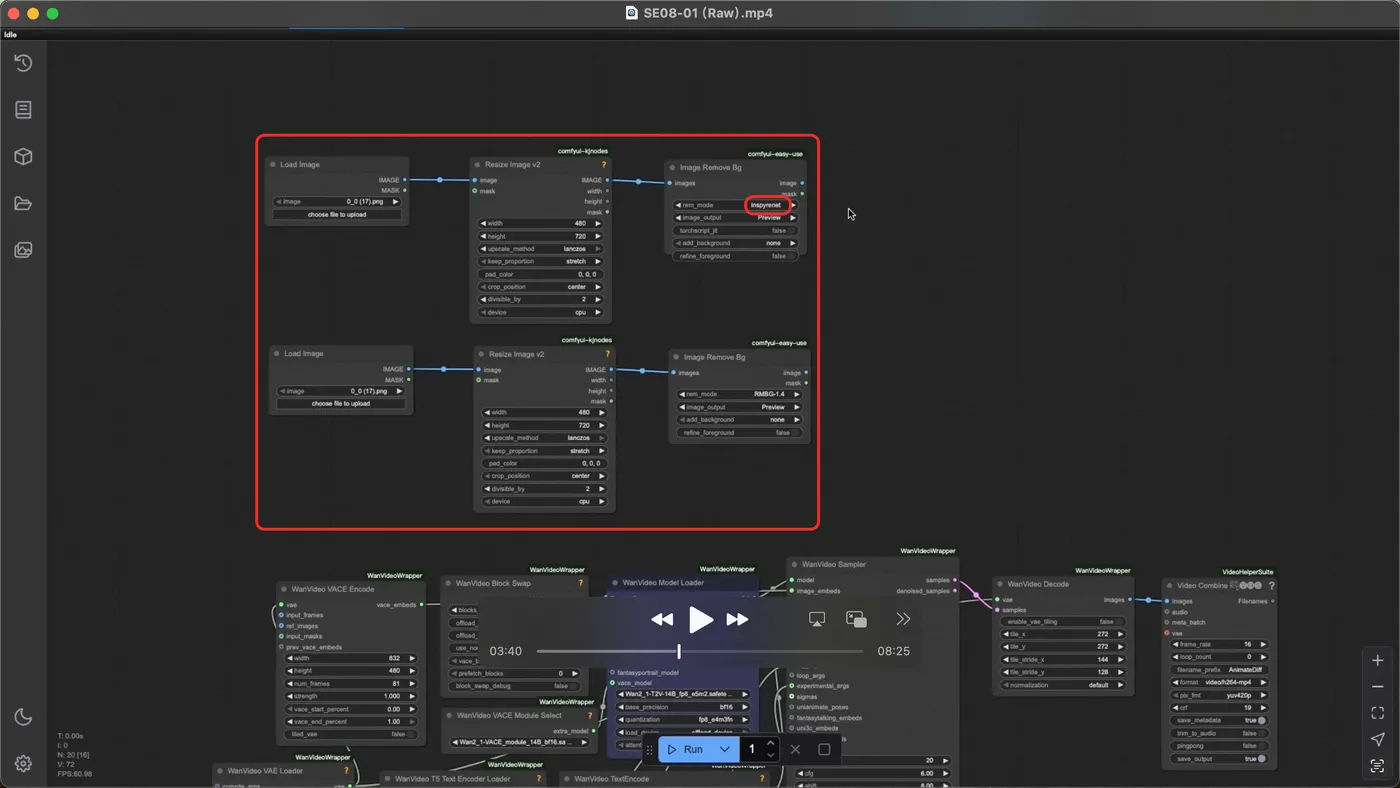
随后在这个节点后拖拽出图像背景移除(Image Remove Bg)节点,我们将这三个节点复制一份,主图的rem_mode模式我们选择Inspyrenet。
随后我们加载一个图像联结(Image Concatenate)节点,将两张图联结,方向(direction)保持右侧(right)。
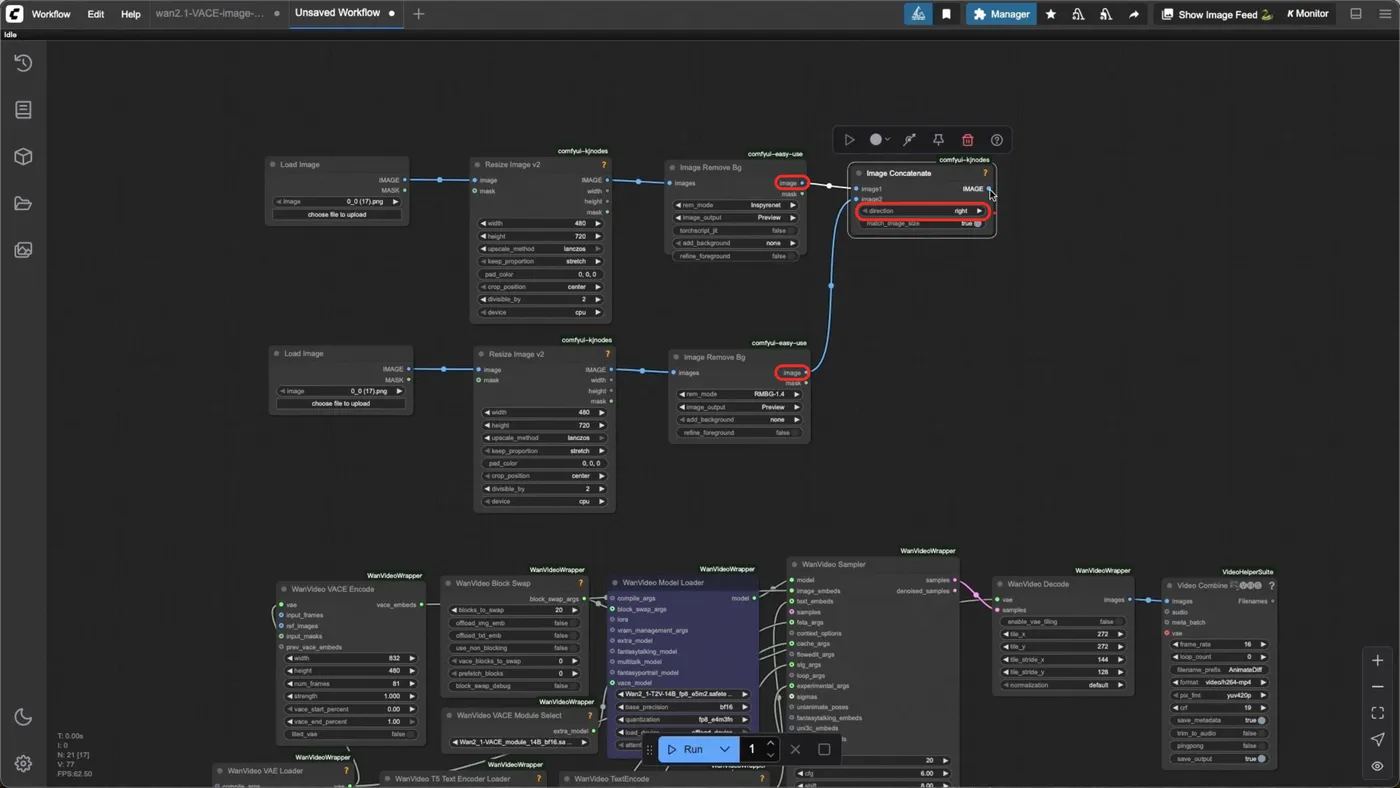
在图像联结节点下的IMAGE圆点我们拖拽出一个Get Image Size&Count节点方便我们统一处理图片尺寸。
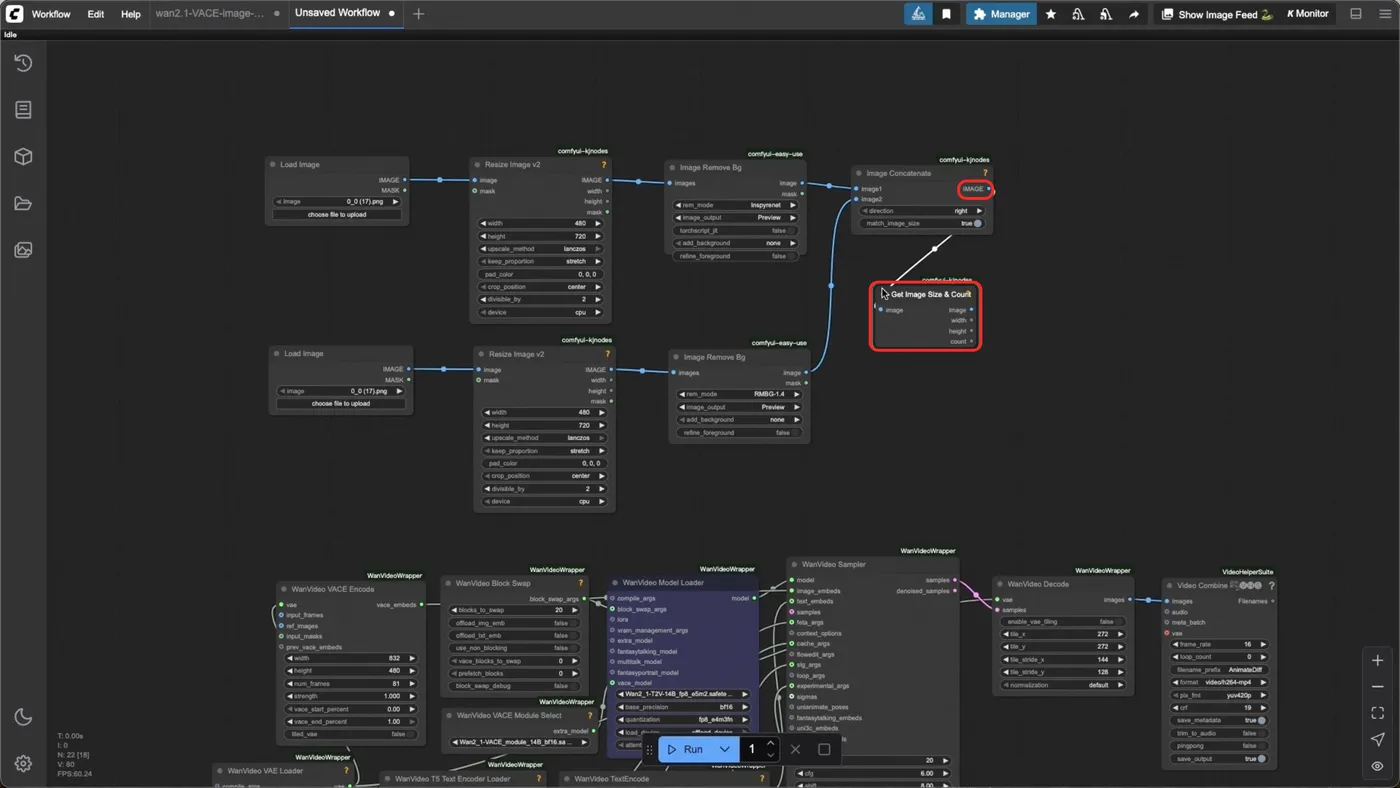
我们还可以加载一个图像预览(Preview Image)节点待会看看合并效果。
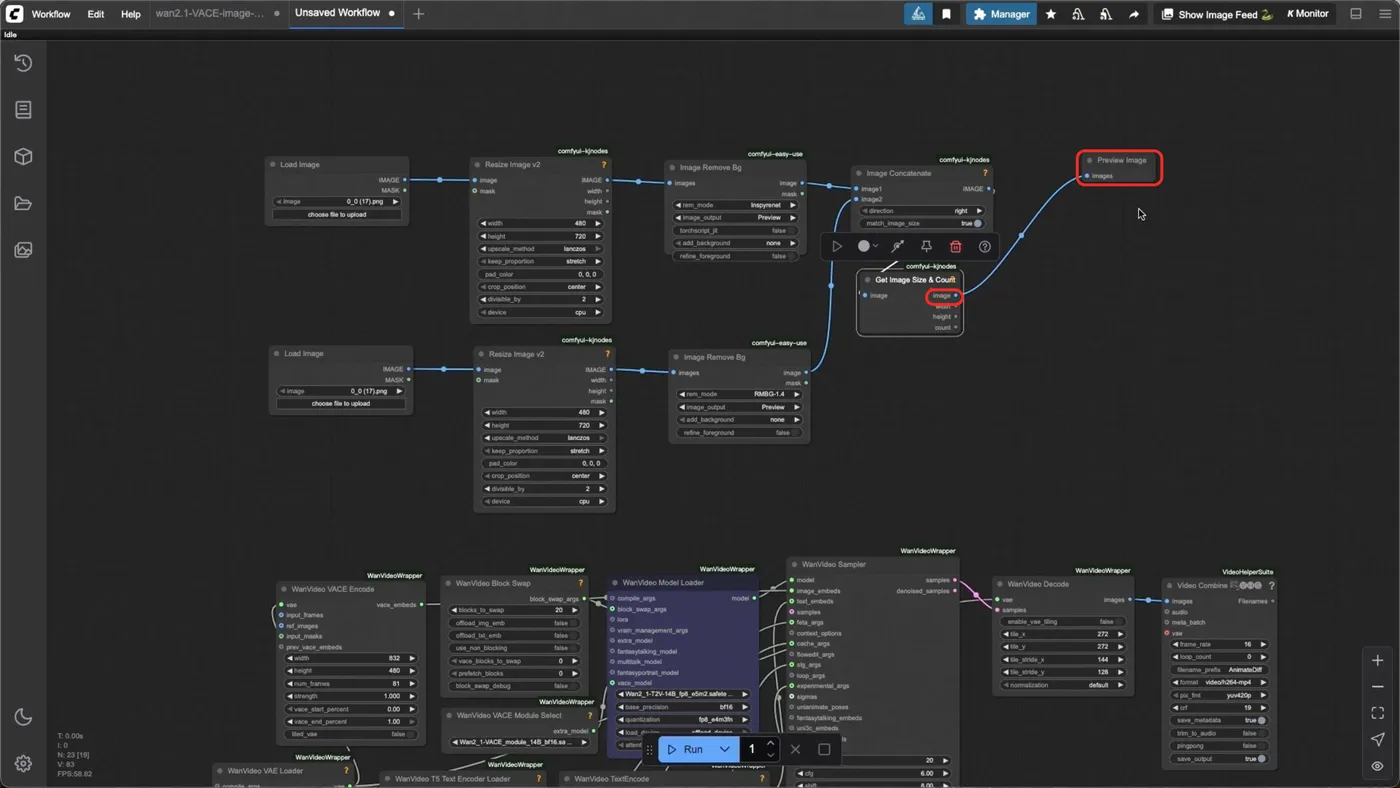
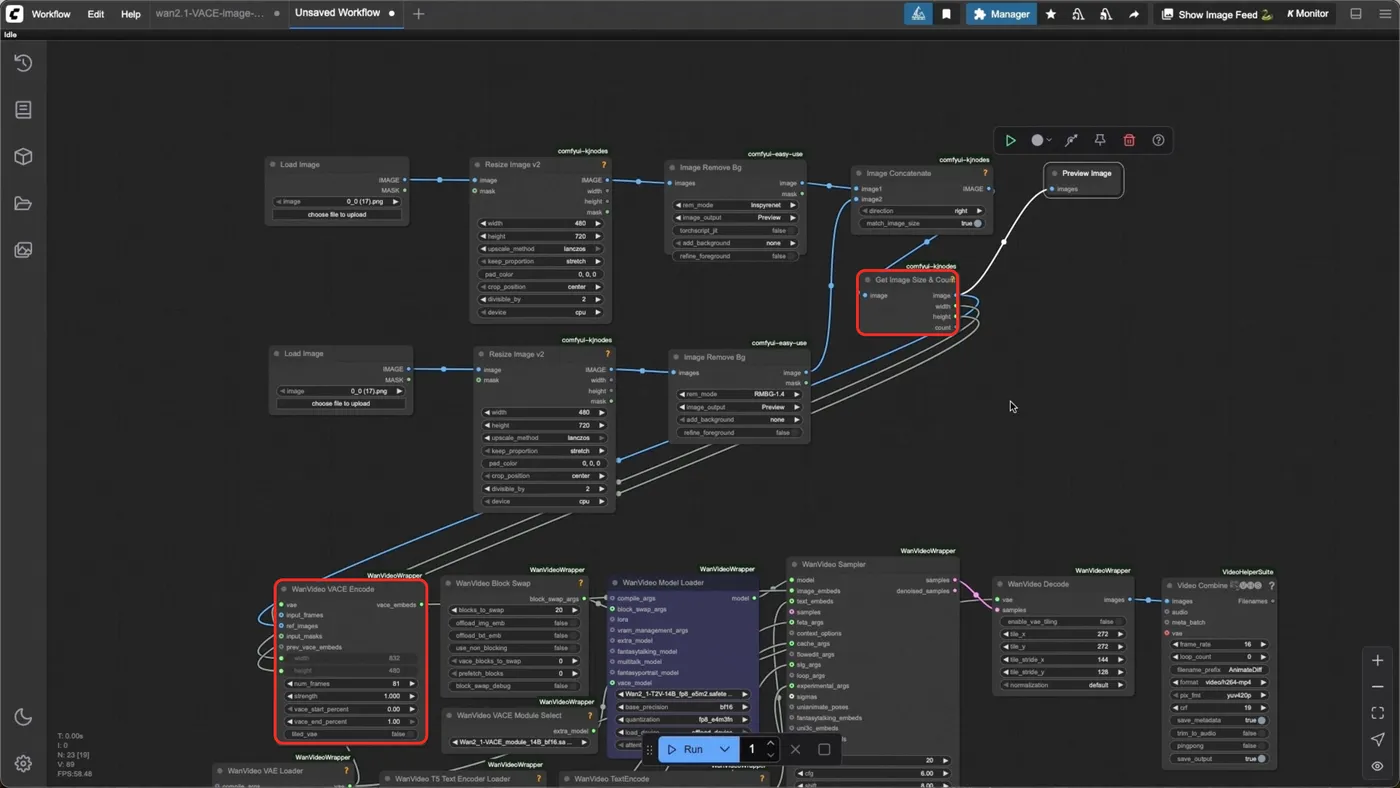
最后我们将处理后的的图像接入Wan视频VACE编码器(WanVideo VACE Encode)节点下的ref_images圆点作为参考图,将宽(width)及高(height)也连接一下。
在空白区域我们再创建一个图像联结(Image Concatenate)节点,将解码后的图像与前期预处理的图像进行一个联结,传输进我们复制的视频合并(Video Combine)节点,这样我们可以方便的看到预处理与生成画面的整体效果。
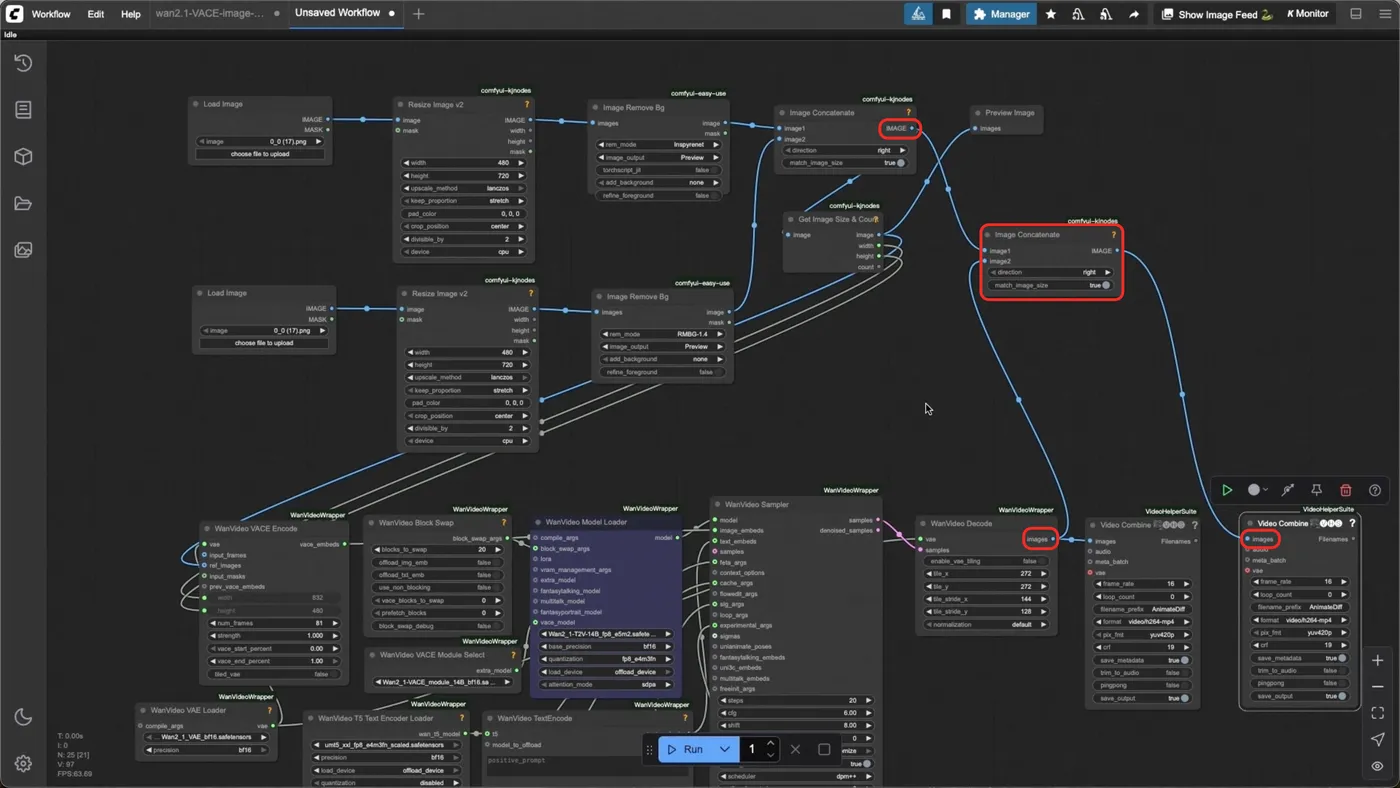
这样我们的Wan2.1 VACE多图参考的工作流就搭建完成了。
多图参考工作流测试案例
我们上传两张图片一起来测试一下效果,我希望主图的红发女人能与副图的水下金鱼场景融合,在这里因为副图是作为背景,不需要扣像,所以我们将副图的背景移除节点关闭,将节点重新连接一下,我们将负向提示词模版复制进来,输入一下正向提示词,点击运行。
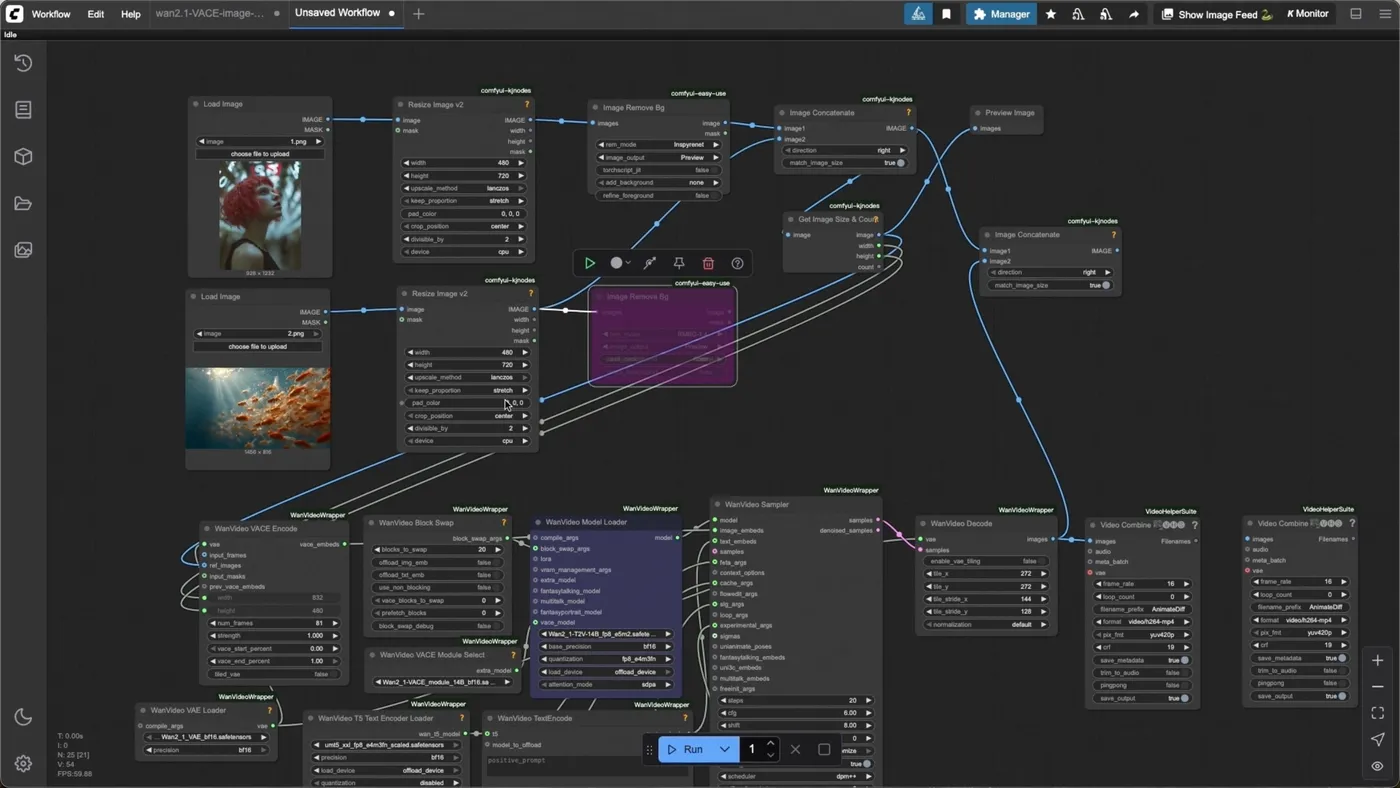
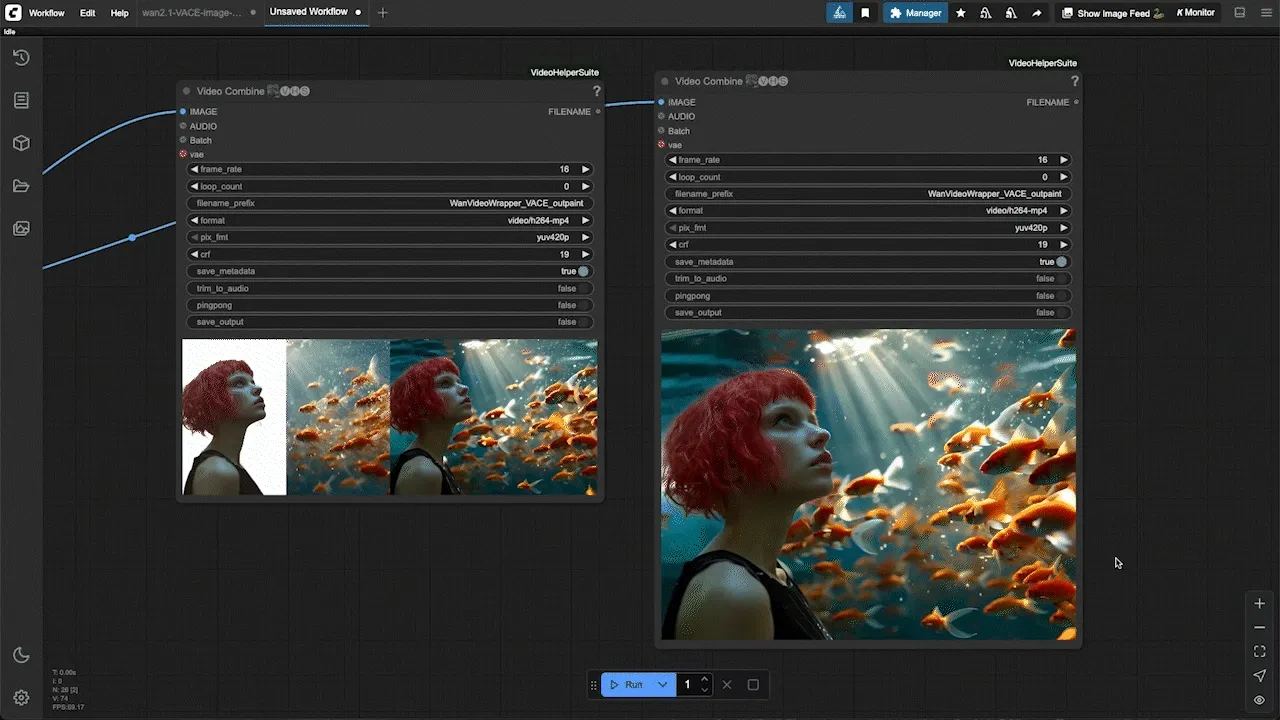
可以看到人物与背景得到了一个巧妙的融合,光影与场景细节也是非常的还原。
姿态参考与深度参考能力详解
核心原理
那再让我们来看看Wan2.1 VACE的姿态参考与深度参考工作流。
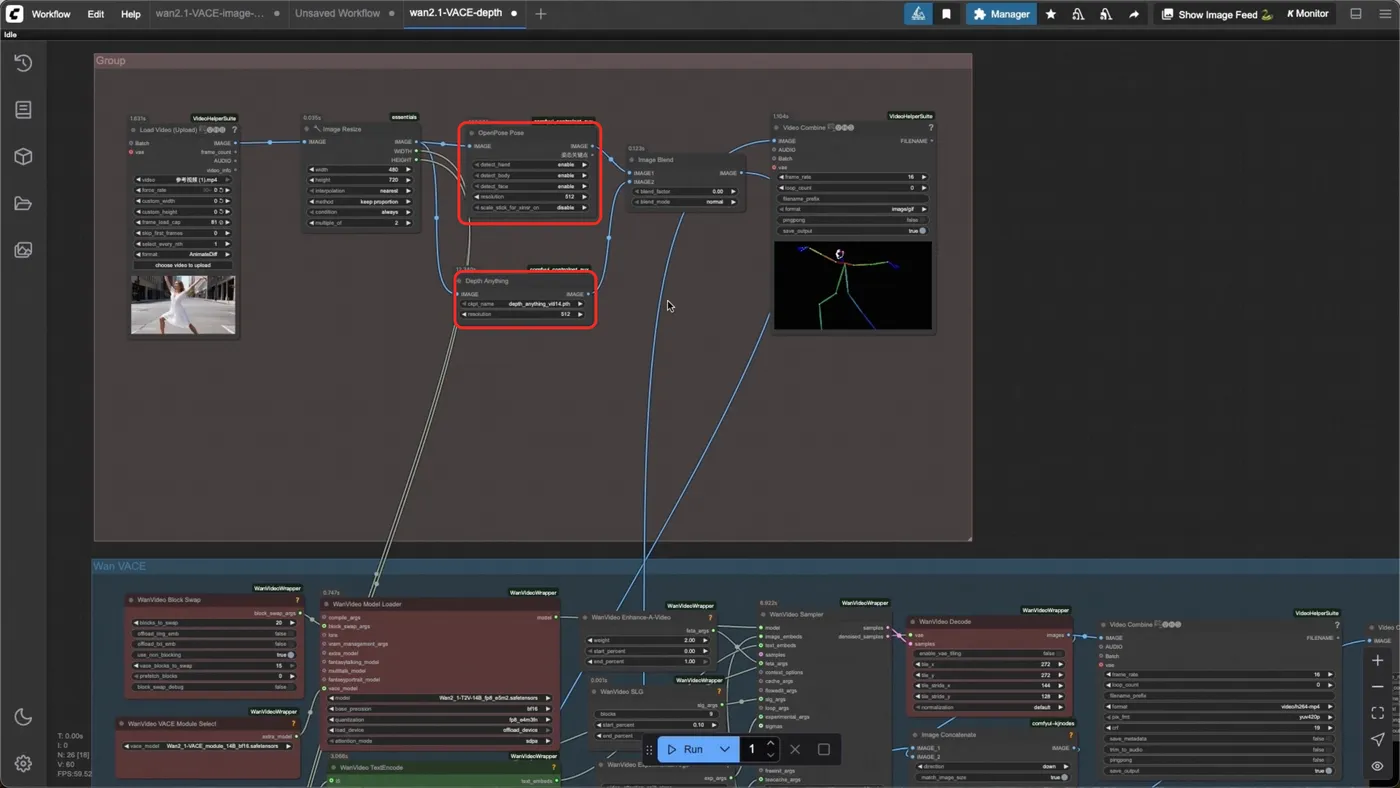
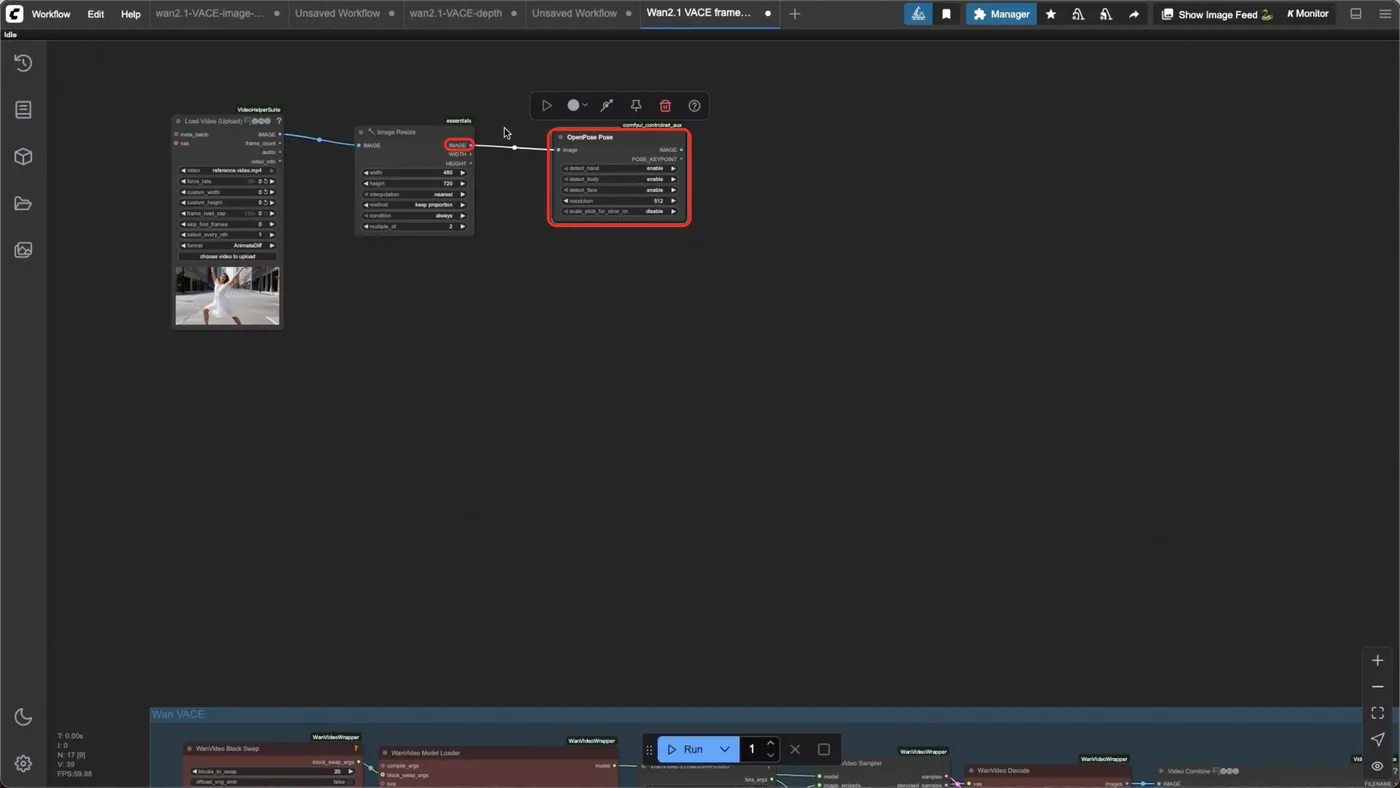
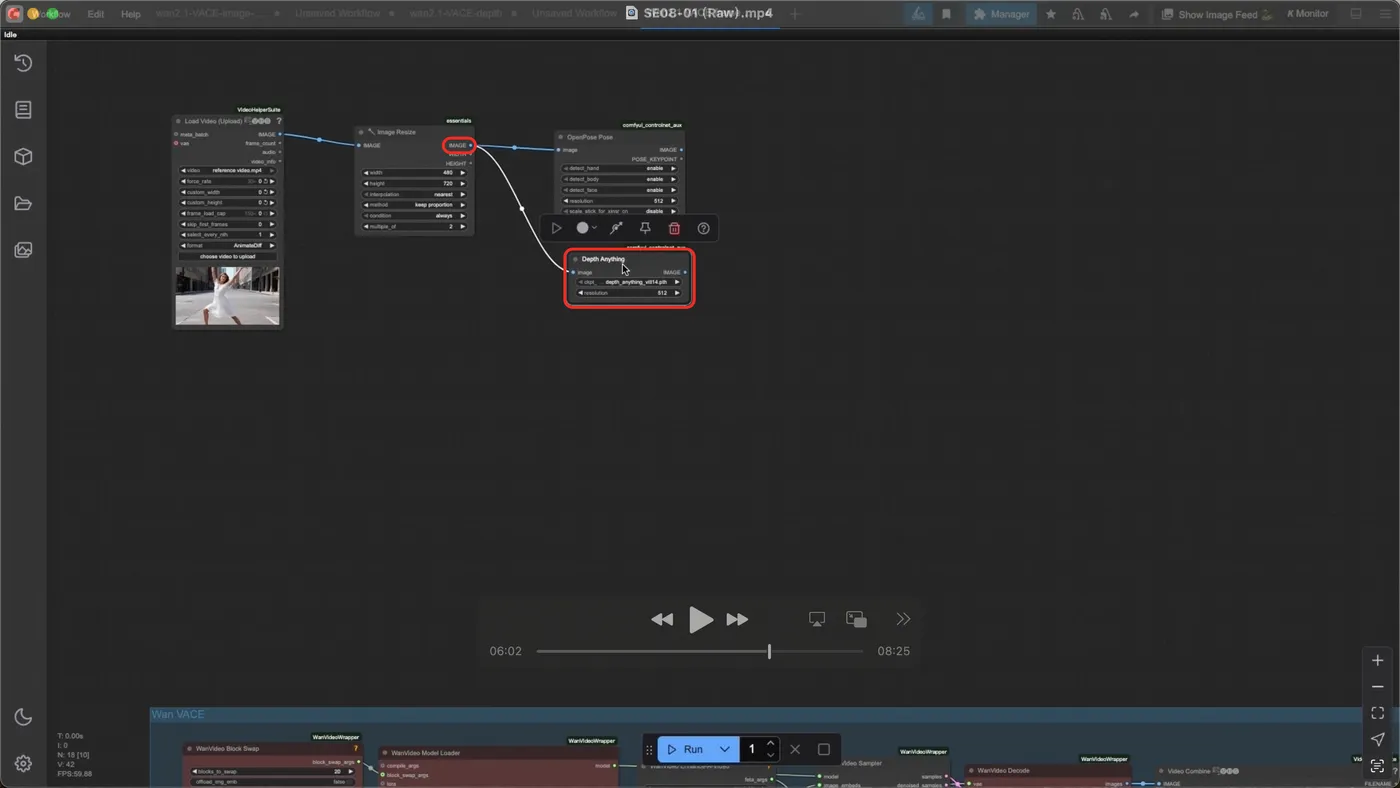
姿态参考和深度参考的原理是通过openpose模型和深度预测算法,提取上传视频的人物骨骼点或画面深度图,并结合提示词语义控制最终输出视频的画面效果。因此,这两个工作流最核心的节点就是OpenPose节点与Depth Anything节点,我们可以一起着手来搭建一下这套工作流。
姿态参考与深度参考工作流搭建
基础框架复用
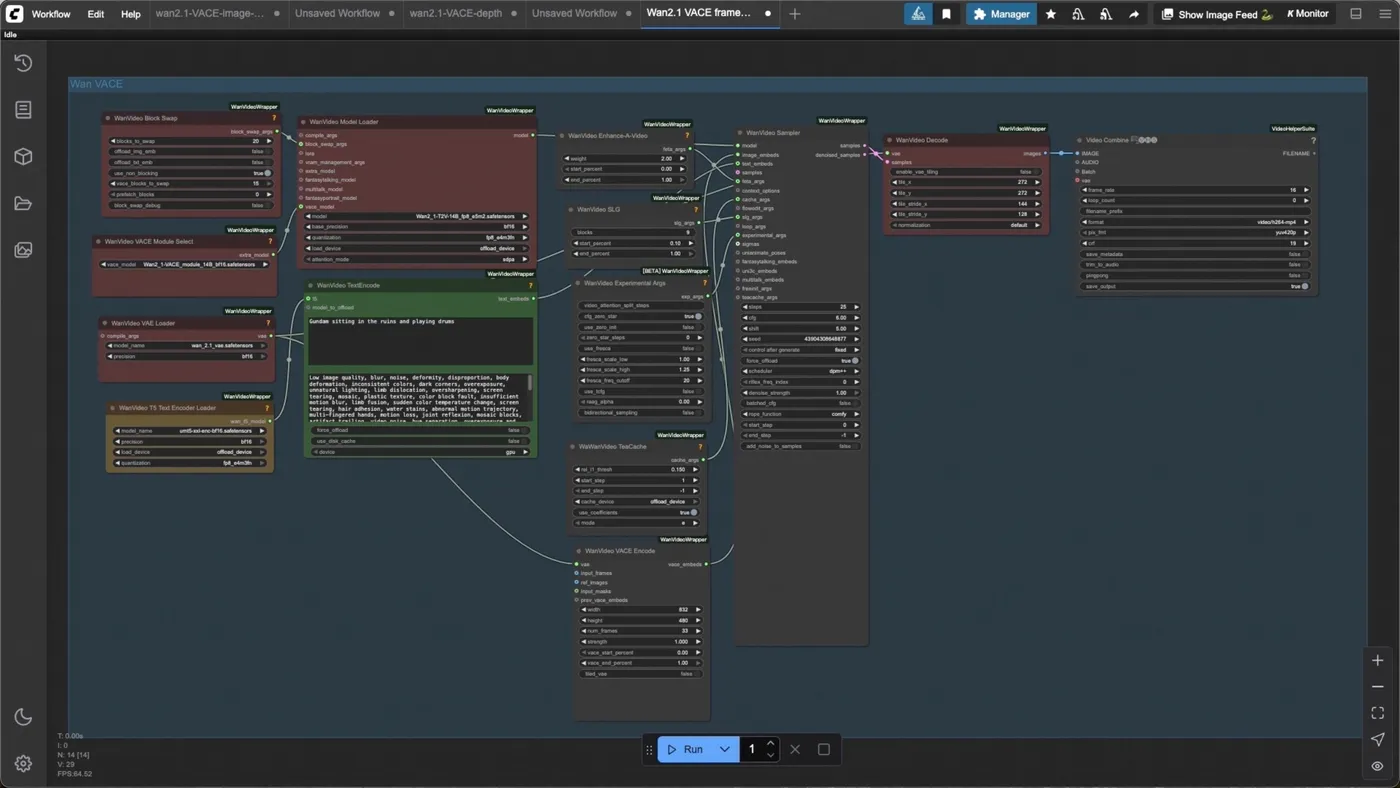
我们导入一个Wan2.1 VACE的基础框架工作流。
视频输入
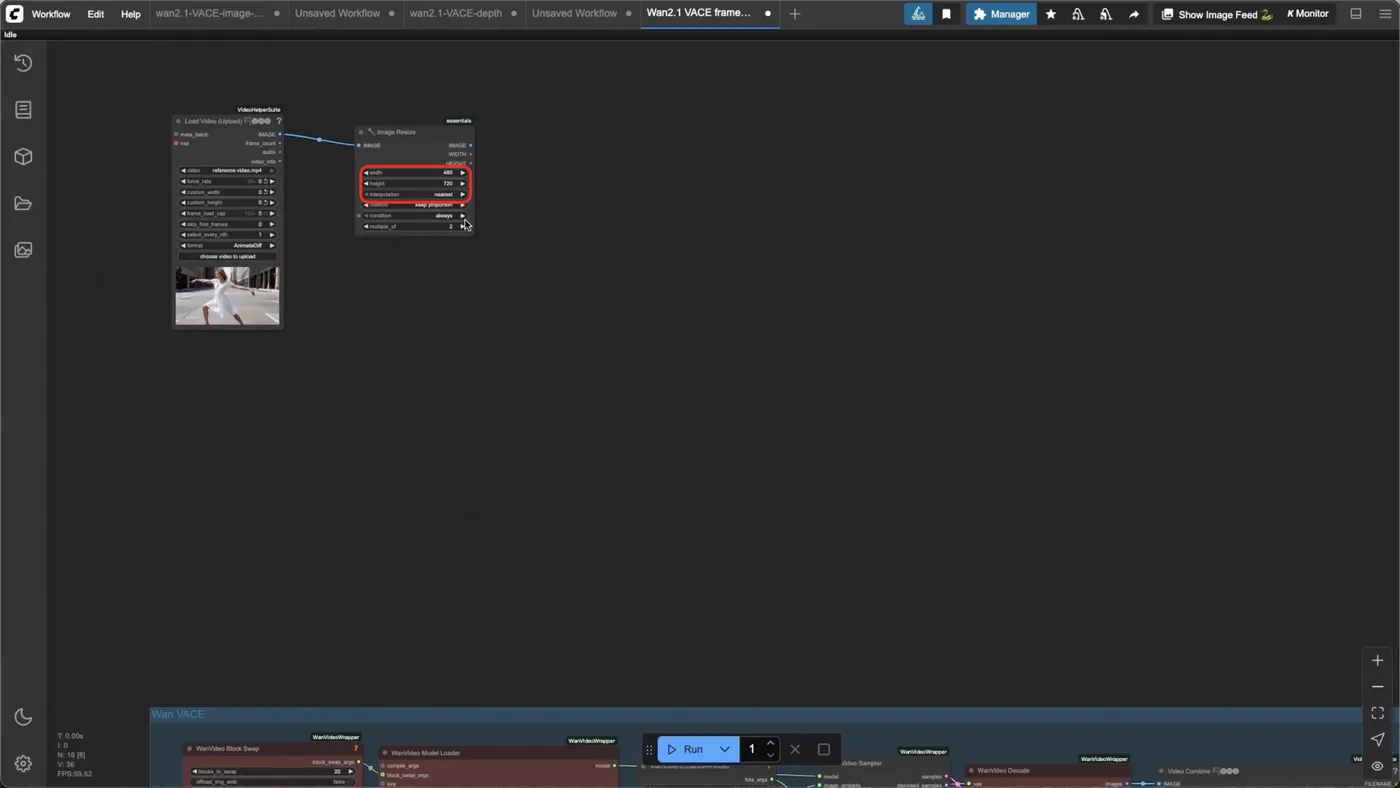
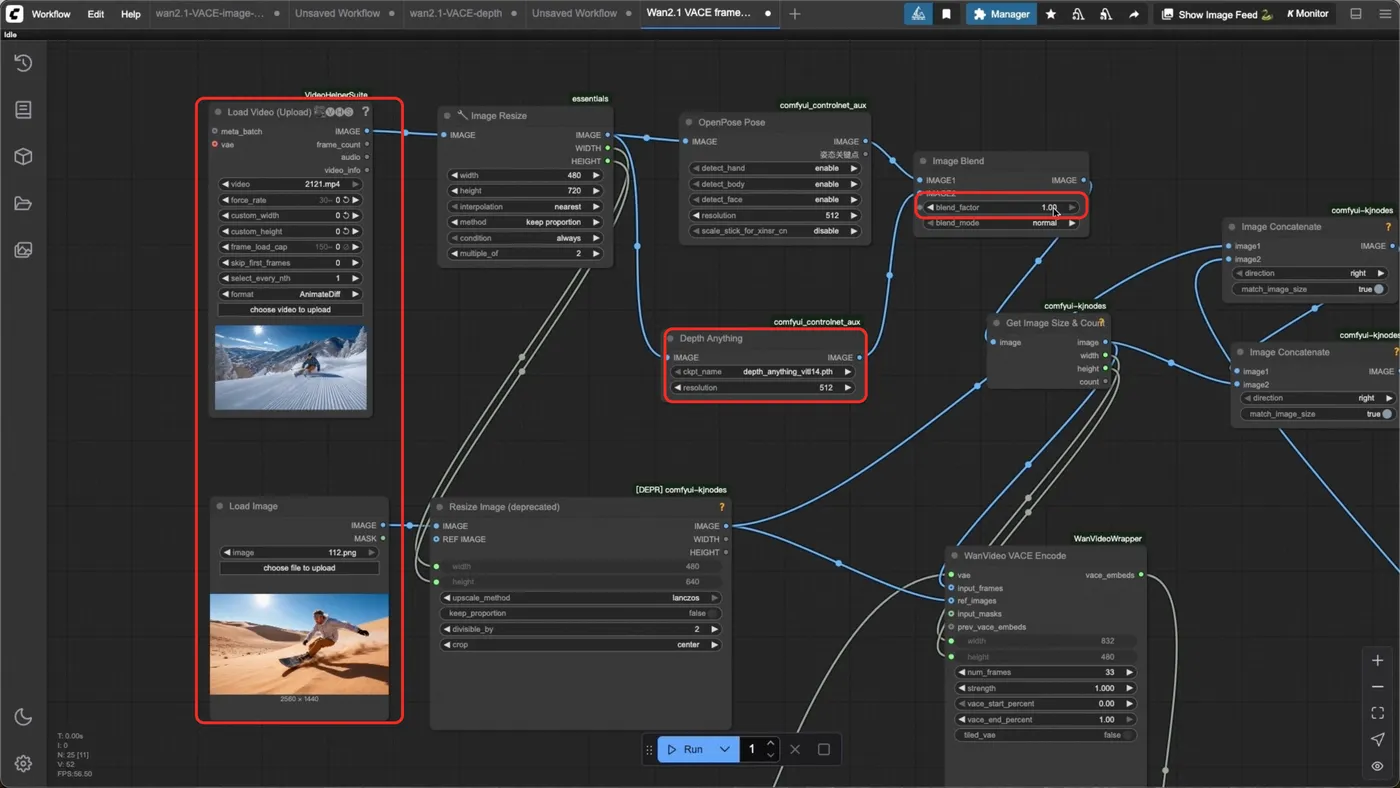
双击空白处创建一个加载视频【Load Video(Upload)】节点,我们可以直接拖拽视频上传。随后在IMAGE圆点下拖拽出Image Resize节点,调整宽(width)为480,高(height)为720,interpolation参数选择nearest。
控制节点
接着,我们拖拽出OpenPose Pose节点,这个节点主要帮助我们提取视频中的人物骨骼信息。
 同样的,我们还可以拖拽出Depth Anything节点,这个节点可以提取视频的画面深度信息。
通过图像混合(Image Blend)节点我们将两个节点混合一起,这个节点就像一个开关,当我们选择0时,对应选择OpenPose模型,写入1时可以切换Depth模型。
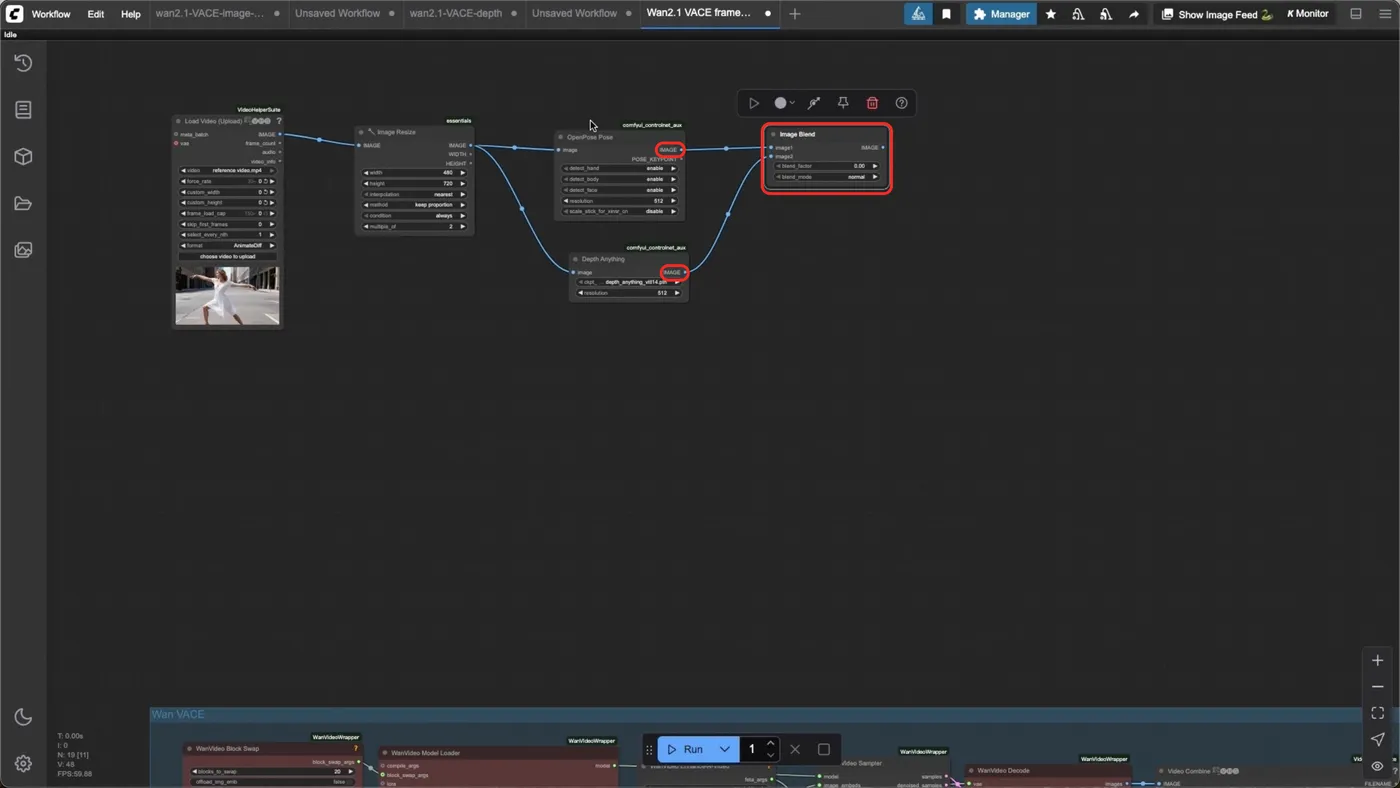
数据传输
随后在图像混合(Image Blend)节点下的IMAGE圆点拖拽出Get Image Size&Count节点,和多图参考工作流一样,我们将图像及尺寸传输进Wan视频VACE编码器(WanVideo VACE Encode)节点。
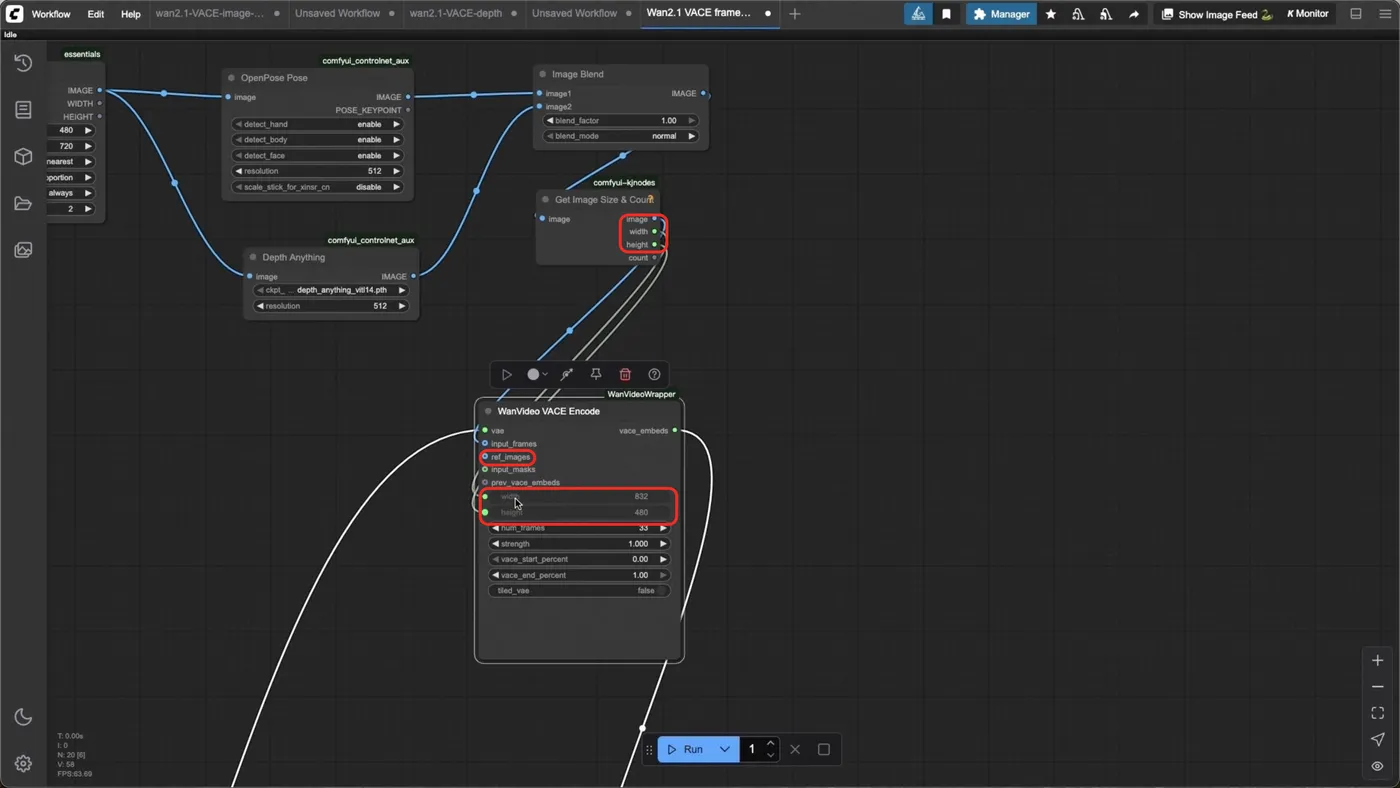
我们双击空白处,创建加载图像【Load Image(Path)】节点,随后拖拽出调整图像(Resize Image v2)节点与Wan视频VACE编码器(WanVideo VACE Encode)节点的ref_images进行连接,作为视频的参考图。
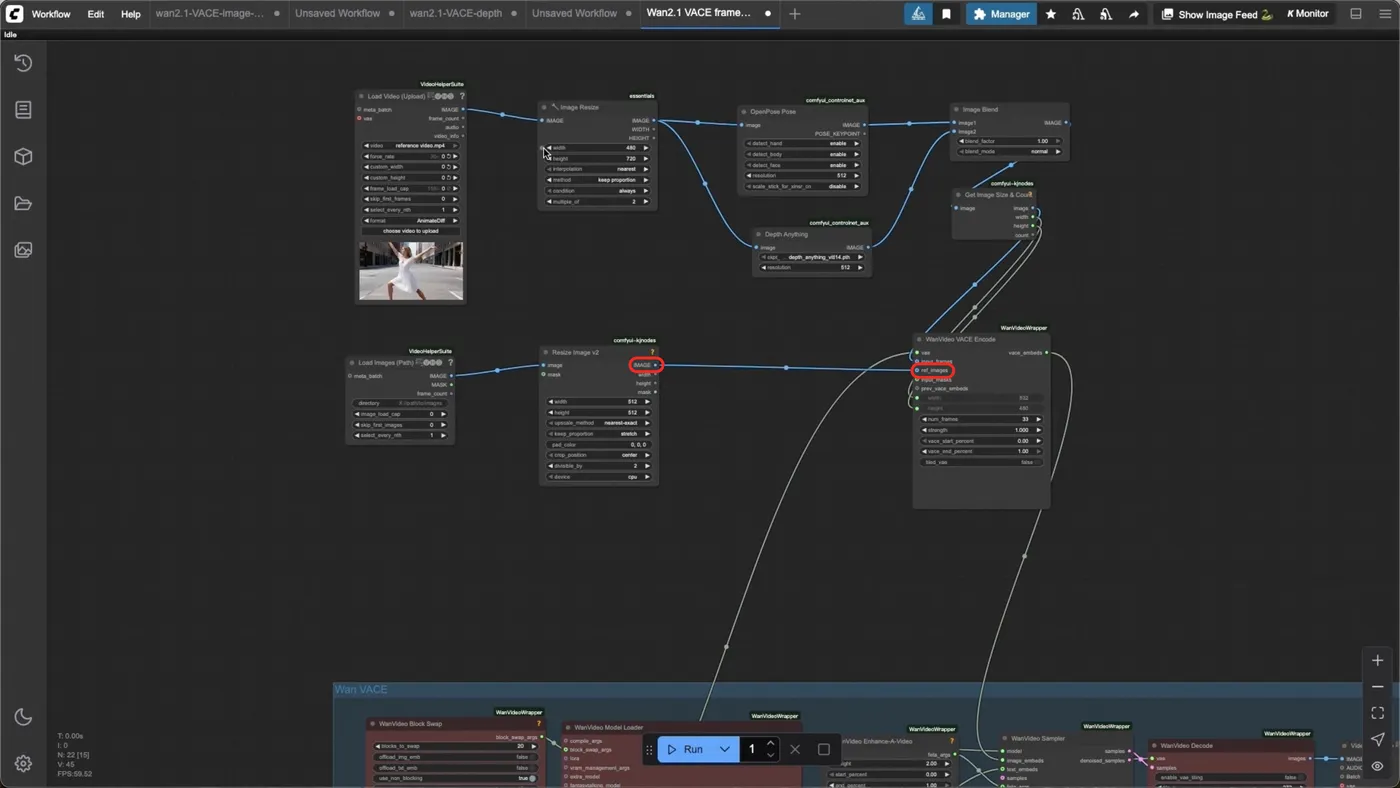
同时,我们将视频的尺寸与图像尺寸保持一致。
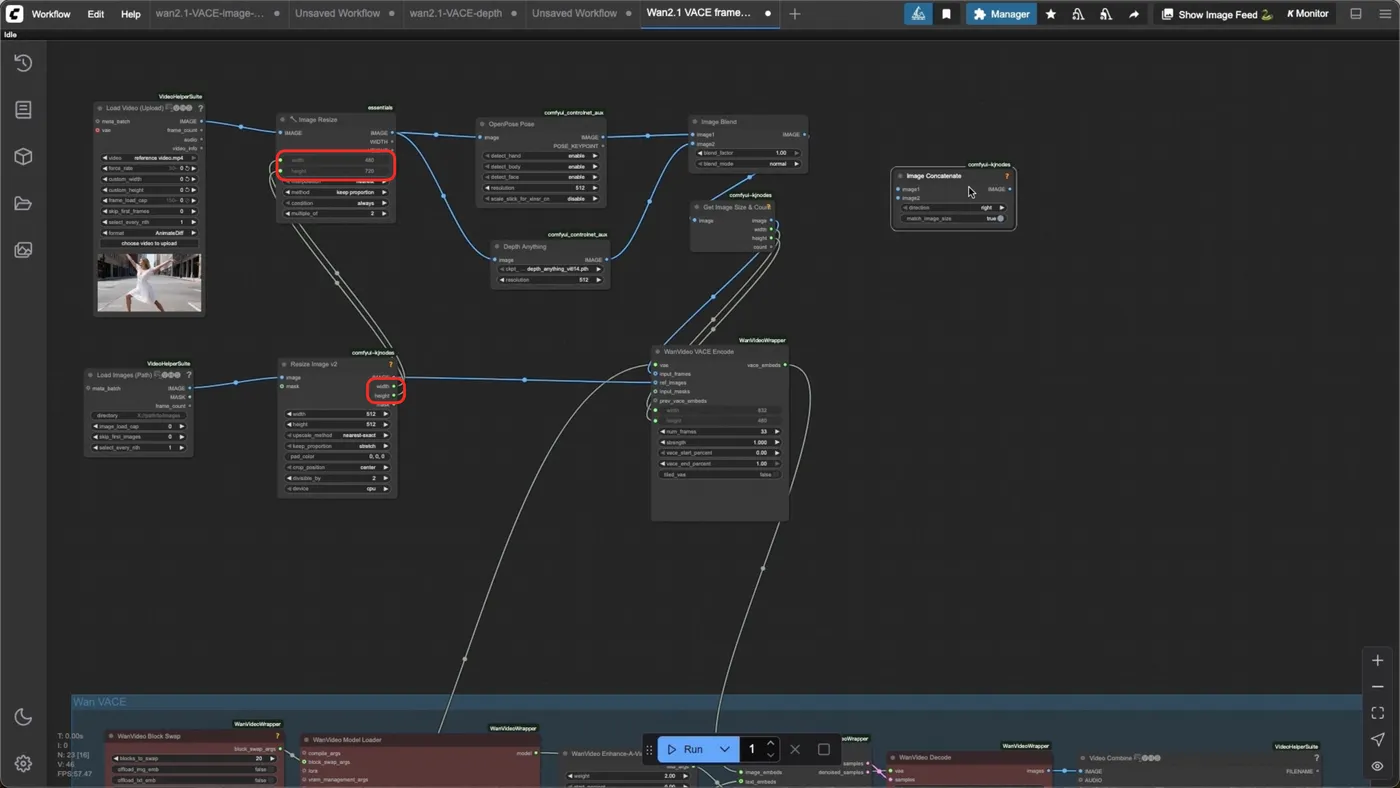
可视化对比
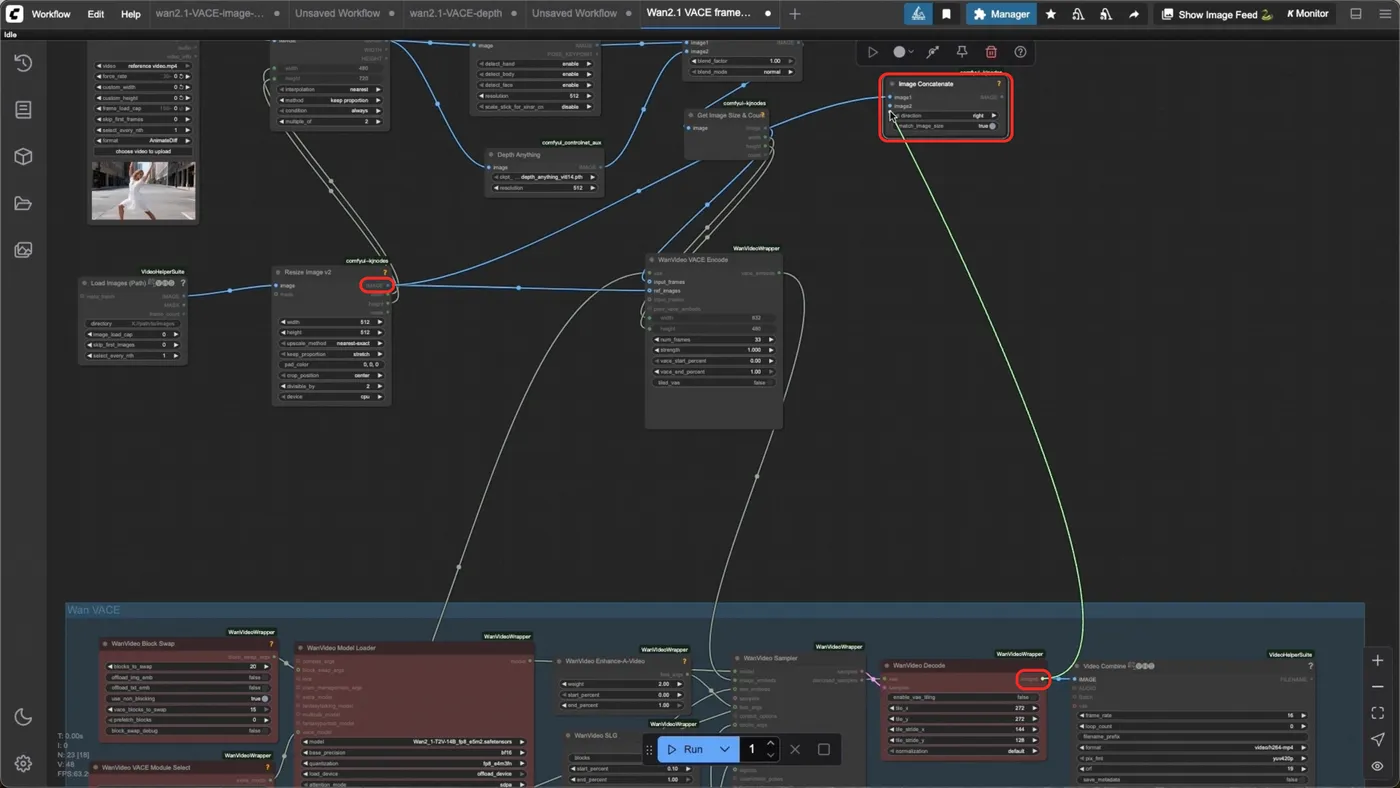
我们再次双击空白处创建图像联结(Image Concatenate)节点,将上传的图像与解码后的视频联结
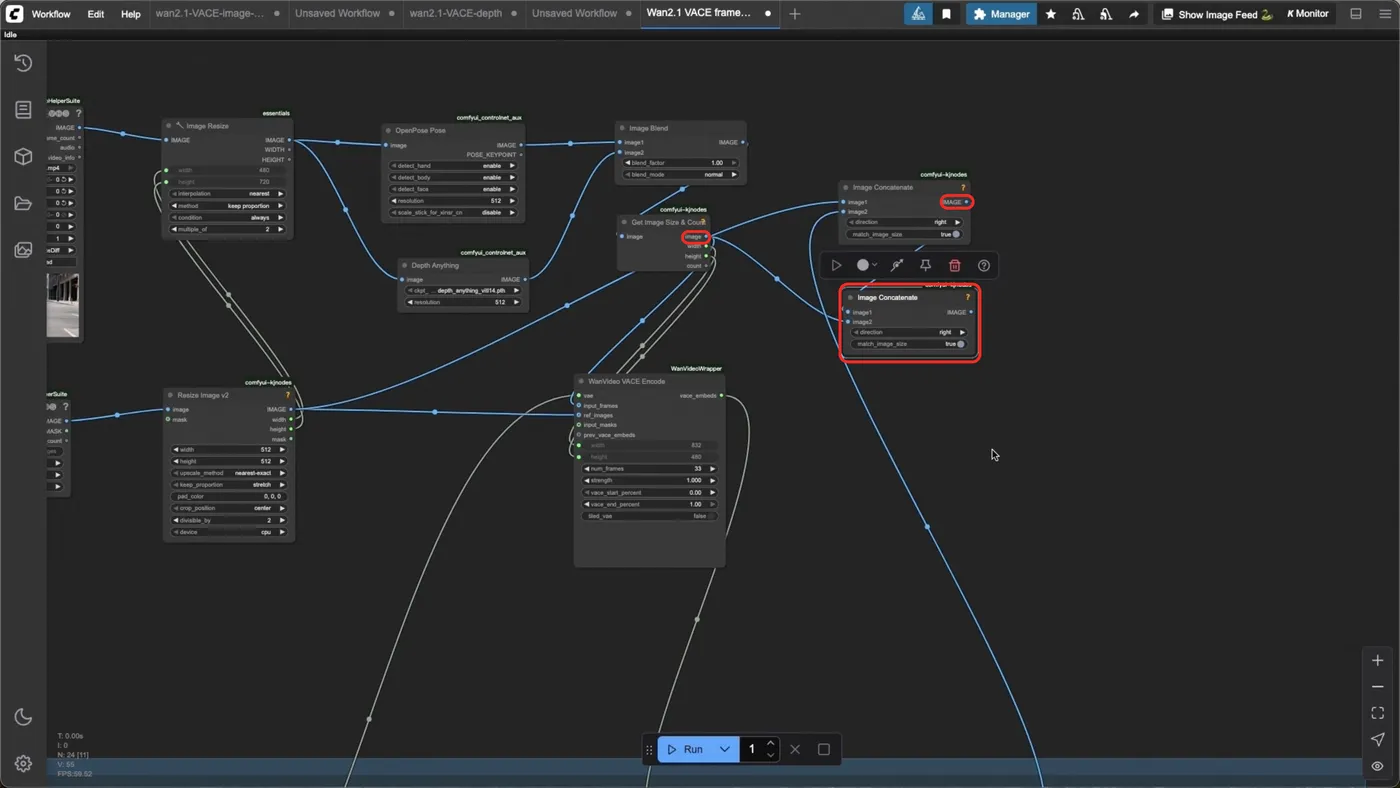
再创建一个图像联结节点将预处理的控制视频也联结过来
最后与视频合并连接,这样我们可以更直观的看到整个工作流的各个重要环节的输出结果
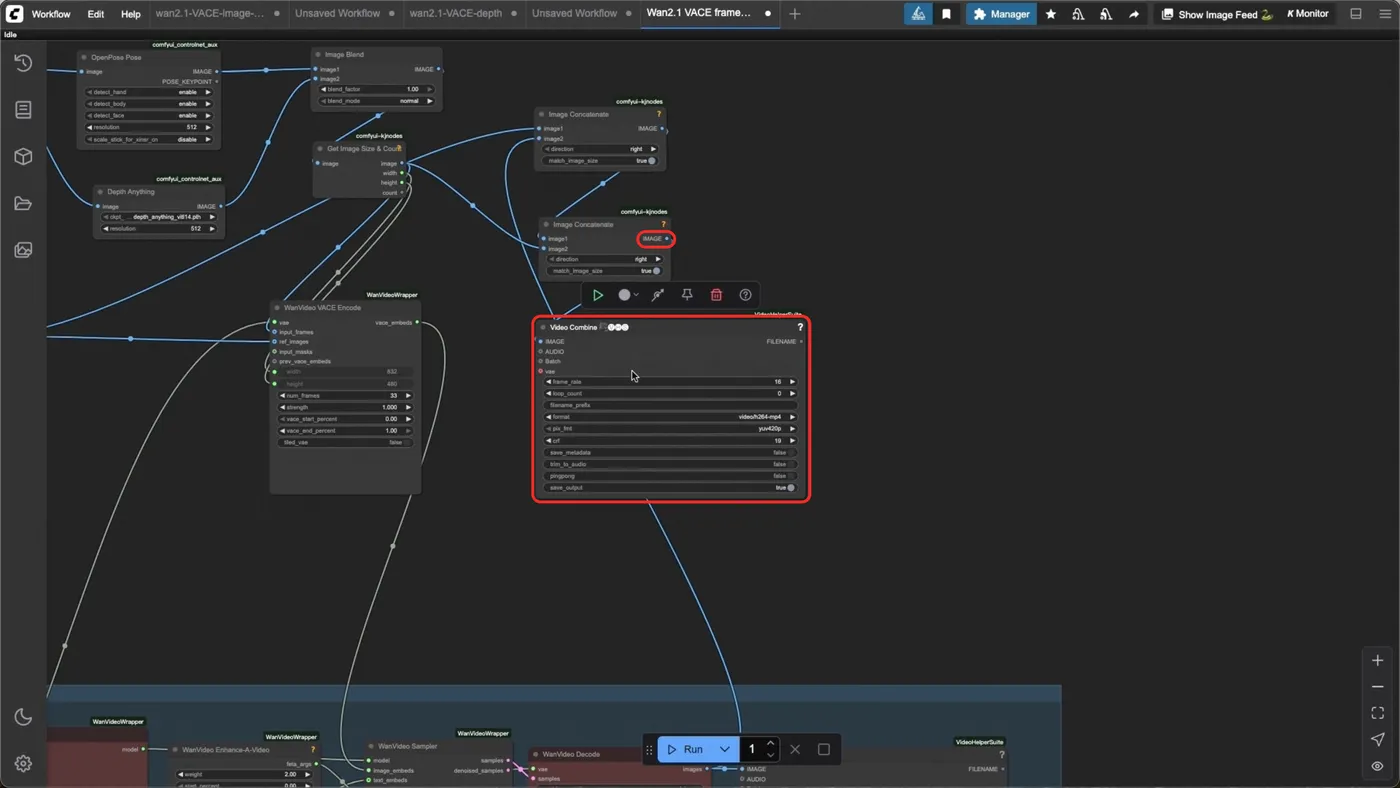
那么这样我们的整套工作流就搭建完成了。
姿态参考与深度参考测试案例
姿态参考测试
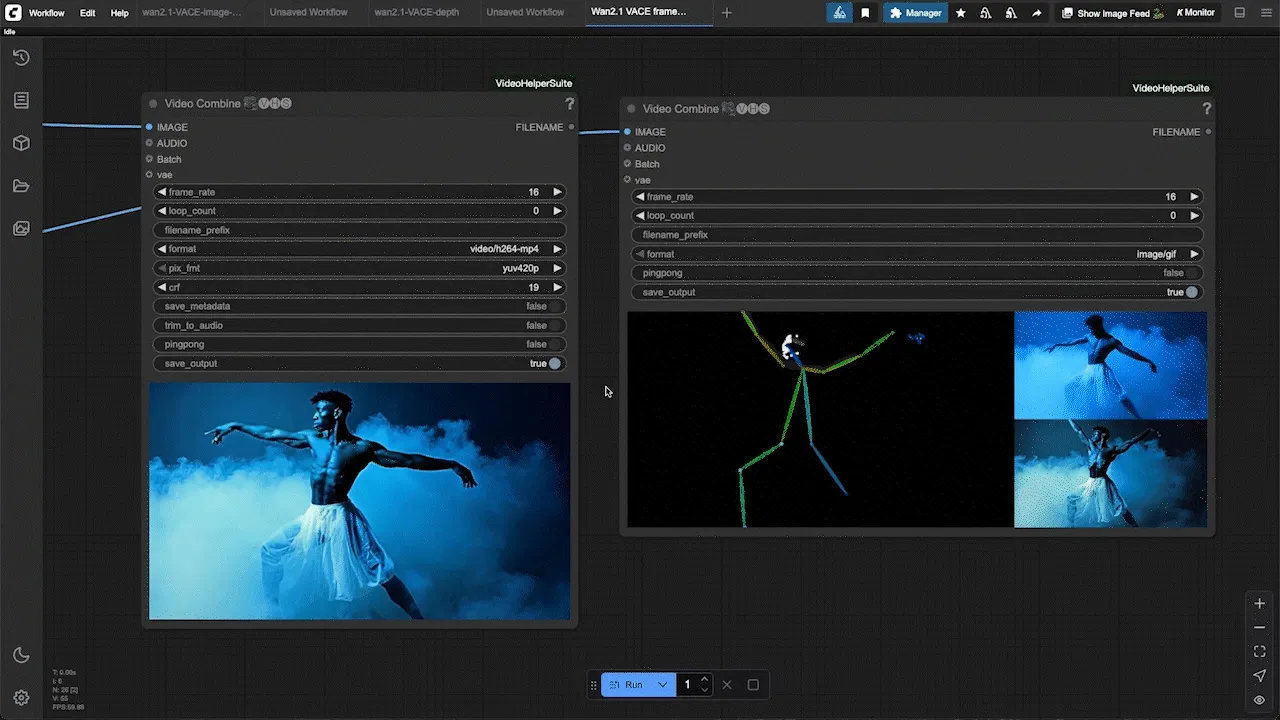
我们上传一张艺术感人物图像,用OpenPose模型来测试一下,这里我希望图像中的人物能参考视频的动作起舞,输入一下提示词点击运行。
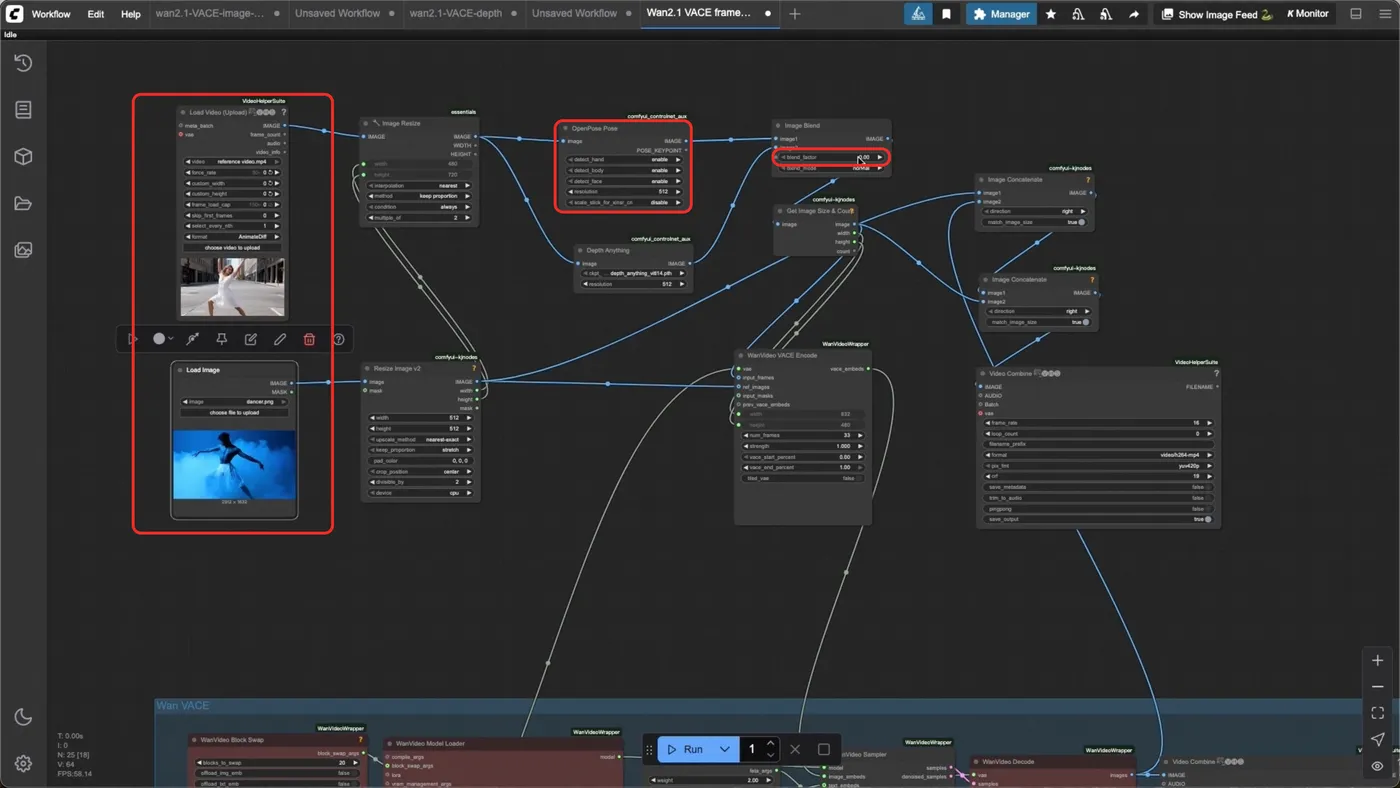
我们可以看到人物完美复刻了视频中的动作,效果非常不错,实现了精准响应。
深度参考测试
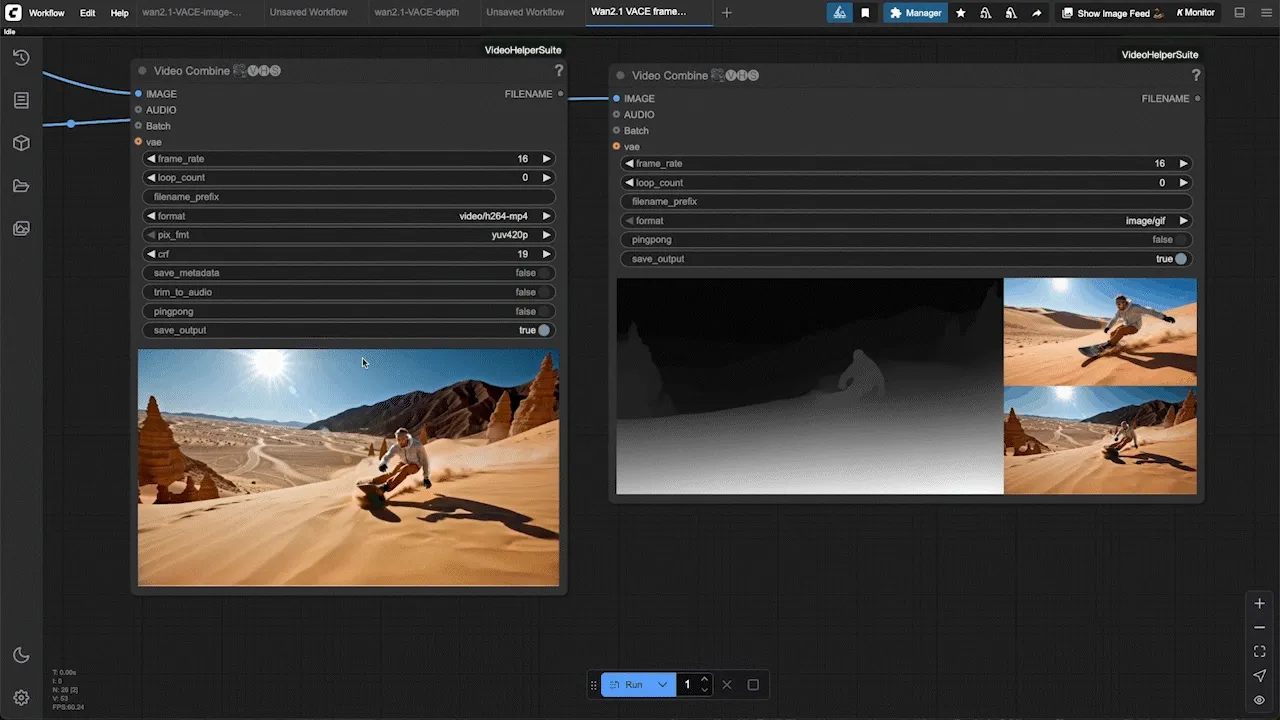
我们再上传一段场景丰富一点的滑雪视频,以及一张滑沙的图像,我们使用深度控制对视频进行控制,输入提示词,点击运行。
我们可以看到滑沙的动作参考了滑雪者运动感十足,背景的处理也变得更加丰富了。
本节课系统解析了Wan2.1 VACE模型的三大核心能力——多图参考、姿态参考与深度参考,展示了其在视频生成领域对细节还原与动态控制的强大潜力。大家可以移步到阿里云百炼平台测试:https://www.aliyun.com/product/bailian
