多头自注意力
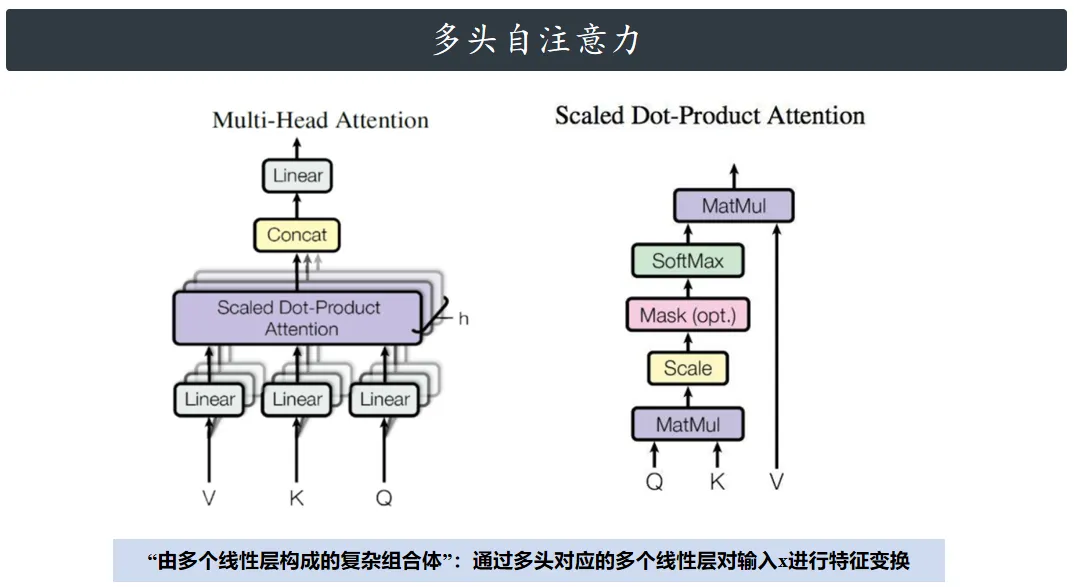
多头自注意力的本质,
是“由多个线性层构成的复杂组合体”:通过多头对应的多个线性层对输入x进行特征变换,同时
借助注意力机制精准捕捉序列内部元素间的关联信息,最终输出与输入x尺寸完全一致的特征张量
x'。

下面我们将从四个方面,系统介绍Transformer的多头自注意力机制:
(1)多头自注意力的整体结构;
(2)多头自注意力的内部细节;
(3) Attention计算公式的深入解析;
(4) 核心逻辑的代码实现。
多头自注意力的整体结构
观察Transformer的整体架构可发现,其包含3个以橙色标记的多头注意力模块:左侧编码器中设有
1个,右侧解码器中设有2个。从核心实现逻辑来看,这3个多头注意力模块的底层机制完全一致,
差异主要体现在输入数据的来源与掩码(Mask)的应用方式上。为更清晰地解析多头注意力的具
体运作,接下来我们将以解码器中的多头注意力模块为核心展开说明。
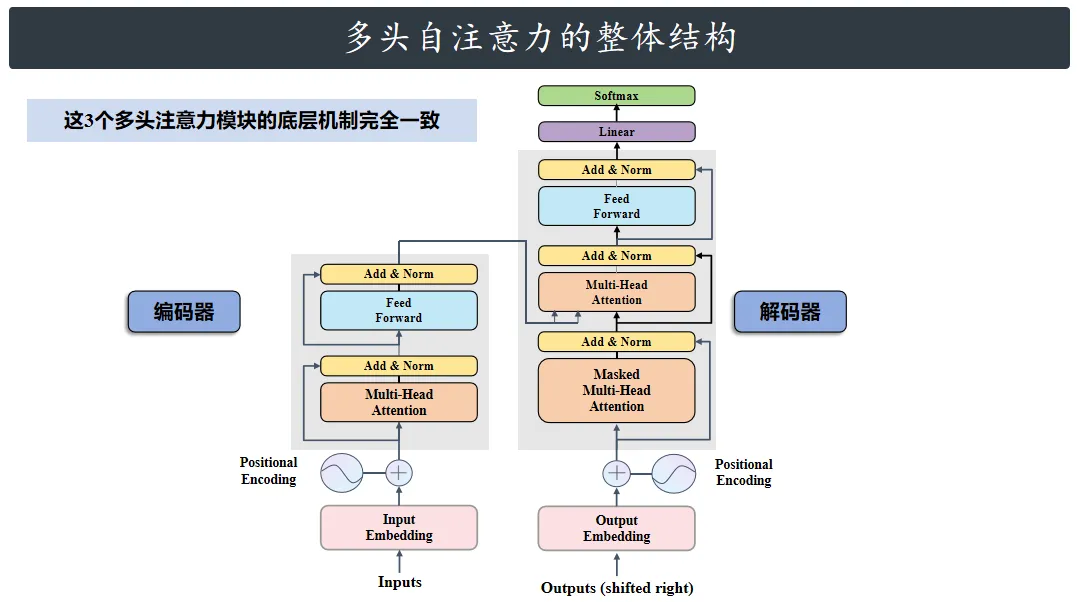

看多头注意力模块的话,能看到它有3个输入和1个输出。这3个输入咱们叫查询(Q)、键
(K)、值(V),其实就是三组数据(张量)。这三组数据可以一样,也可以不一样,不用不用
太纠结它们名字的具体意思,就当是三组输入数据就行。 再说说Transformer编码器里的情况:这
Q、K、V三组数据都是从同一个输入来的。具体来说,输入数据先经过词嵌入层和位置编码处理,
得到一组综合后的特征;然后这组特征会分成3路,分别作为Q、K、V输入到多头注意力里去。
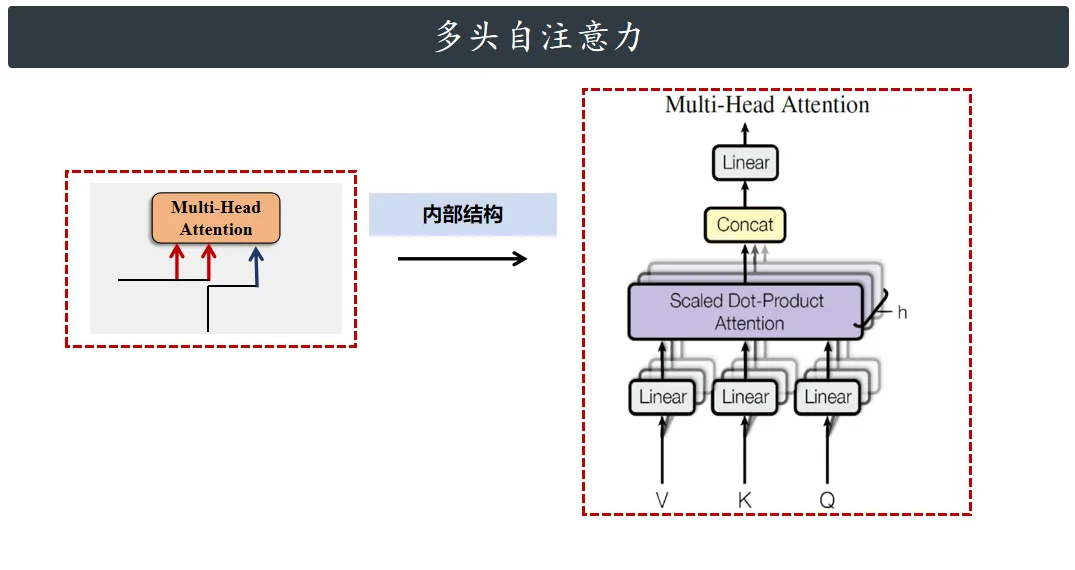

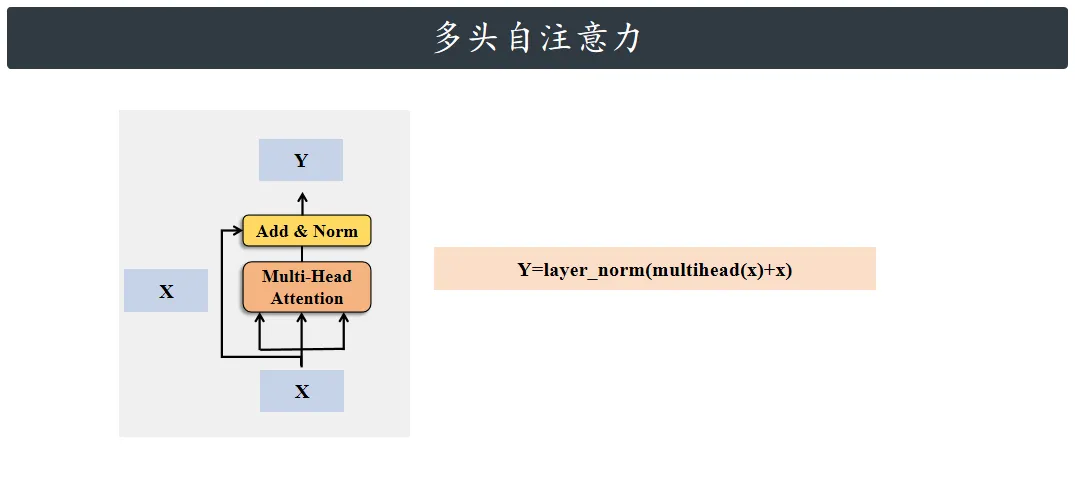
在编码器里,Q、K、V 其实指的都是同一个张量,咱们就叫它 x 吧。把 x 放进多头注意力
里,能算出一个结果,就叫 multihead (x)。另外,x 还会直接从左边走,送到 Add&Norm 那一
步。这里的 Add 就是残差连接,简单说就是把 x 和刚才算出来的 multihead (x) 加起来;Norm 就
是层归一化,会把加完的结果处理一下,让数值更稳定。所以最后从 Add&Norm 出来的,就是
“x 加上 multihead (x) 之后,再经过层归一化的结果”。

多头自注意力的内部细节
多头的意思,就是同时用多个自注意力机制来提取特征。下面拿个例子说说它是怎么算的。
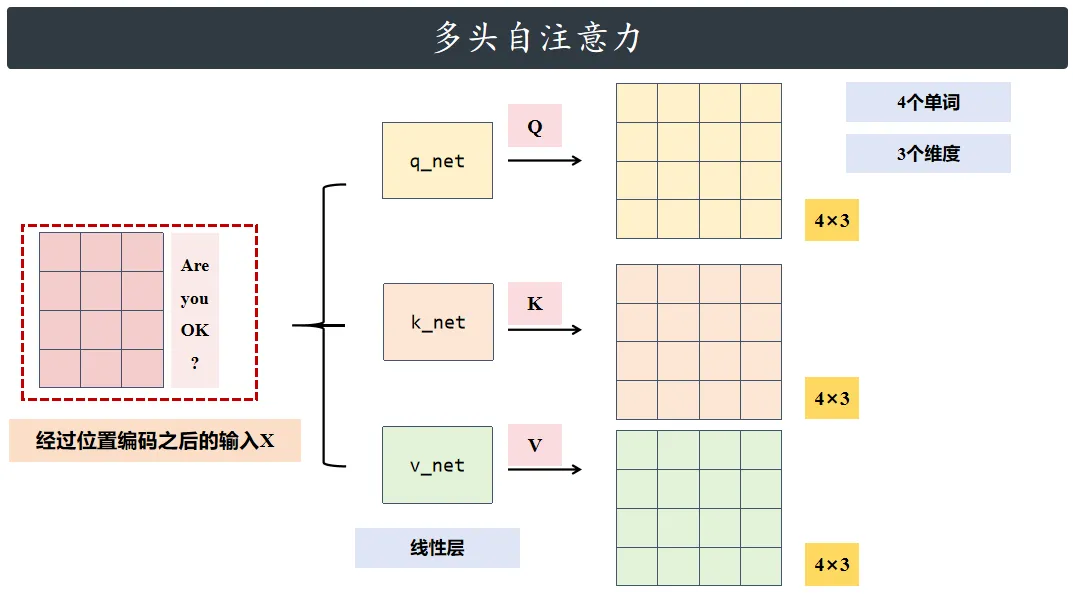
首先,我们的输入数据是加了位置编码的“Are you OK?”,就叫它x吧。这个x会分别经过3个线性
层(简单说就是做些数学变换),得到三组结果,咱们管它们叫qx、kx、vx(也就是Q、K、
V)。 接下来,把这三组结果放进注意力的计算公式里一算,得到的输出y,就把这句话里各个词
之间的全局关系(比如谁和谁关联紧密)都融合进去了。

Attention 计算公式的深入理解
 编辑
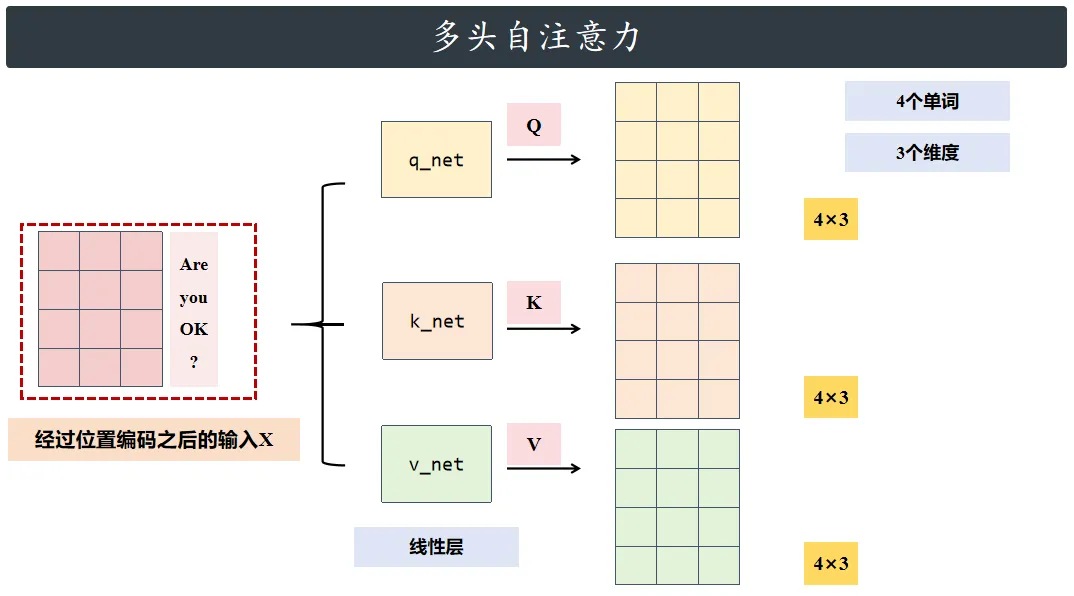
咱们假设输入的句子是 “Are you OK?”,对应的序列就叫 X。把 X 分别放进 qnet、knet、vnet 这
三个结构里计算,最后会得到 Q、K、V 三组数据(也就是张量)。这三组数据的尺寸都是 4×3:
其中 4 代表句子里的 4 个单词,3 代表每个单词都用 3 个维度来表示。

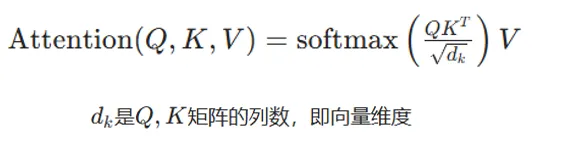
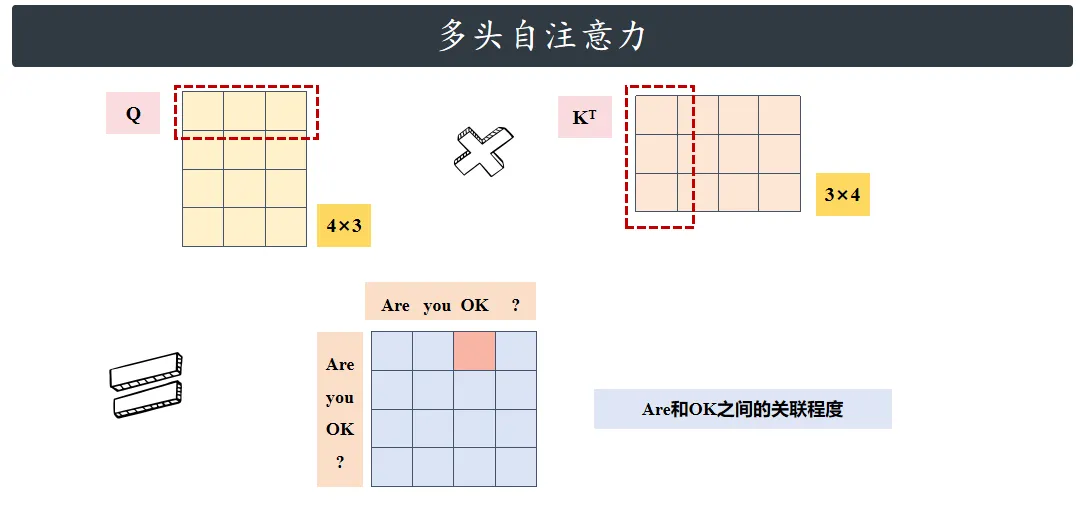
首先,我们要把Q和K的转置乘起来。你看,Q是个4×3的矩阵,K转置之后是3×4的矩阵,这俩乘
完之后,会得到一个4×4的矩阵。 这个4×4的矩阵其实就代表了输入句子里所有单词之间的关系。
比如说,矩阵里的每一行对应一个单词,每一列也对应一个单词,那行和列交叉的那个数值,就表
示这两个单词之间的关联程度。

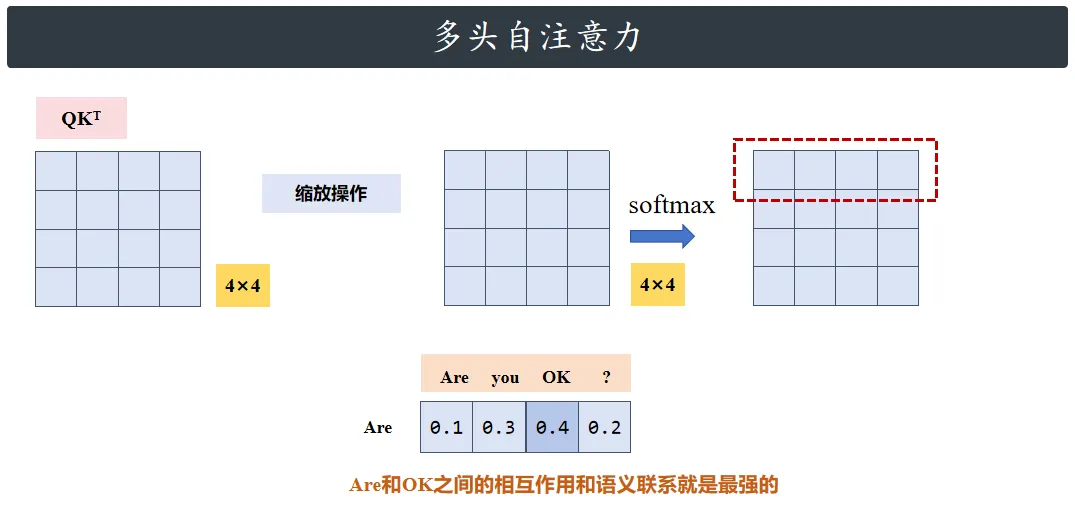
下面我们需要对计算后的结果进行缩放,缩放操作可以调节点积计算的尺度,缩放后的结果上会继
续 应用softmax的函数,将词语之间的相互关系转换成概率分布,假设这矩阵是P,矩阵的每一行
代码了该单词和其它单词的关系,这个关系是一个概率分布,假设这个矩阵的第一行是下图这样,
就说明are和ok之间的相互作用和语义联系就是最强的。

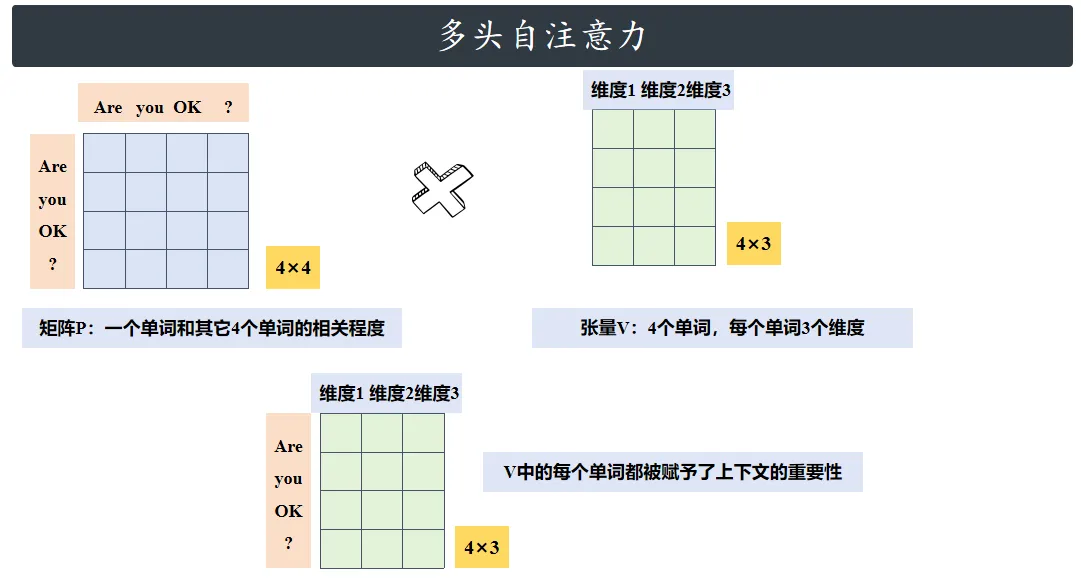
最后一步是把矩阵 P 和矩阵 V 相乘,这个操作相当于给 V 里的每个单词 “加上上下文的重要性”。
概率矩阵 P 是 4×4 的,它的每一行对应一个单词,行里的每个数代表这个单词和其他单词的相关
程度;而矩阵 V 是 4×3 的,对应 4 个单词、每个单词 3 个维度。这俩相乘后得到的结果还是 4×3
的:每一行对应原来的一个单词,每一列对应一个维度。但这时候,V 里的每个单词都已经融合了
上下文的重要性。

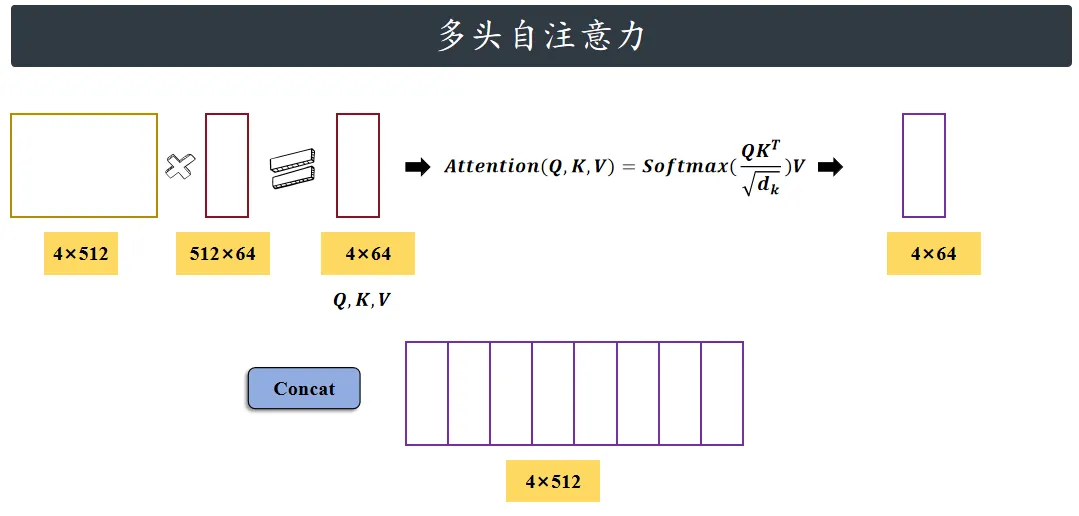
多头注意力的整体内容
假设我们的输入还是Are you OK? 每个单词都是512维度的向量,那么我的输入X就是一个4*512
的张量,原始论文中有8个注意力层,所以单个注意力的输出的维度就是512/8=64维。所以单个注
意力的输出就是4*64大小的张量。最后我们把这8个4*64大小的张量按照列进行拼接,最后会得到
4*512的输出张量。

四种注意力机制
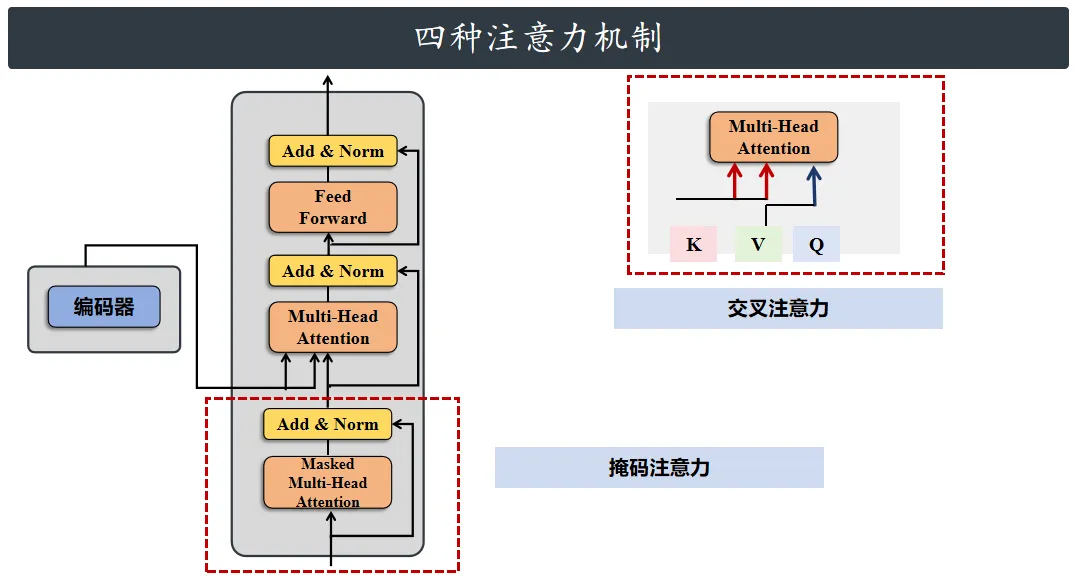
咱们看右边的解码器,里面有个多头注意力和别的不一样 —— 它多了个 “Mask”(掩码),这就是
掩码注意力。还有个特殊情况:在编码器和解码器连接的地方,K 矩阵和 V 矩阵都是从编码器来
的,只有 Q 矩阵是解码器自己的,这就是交叉注意力。

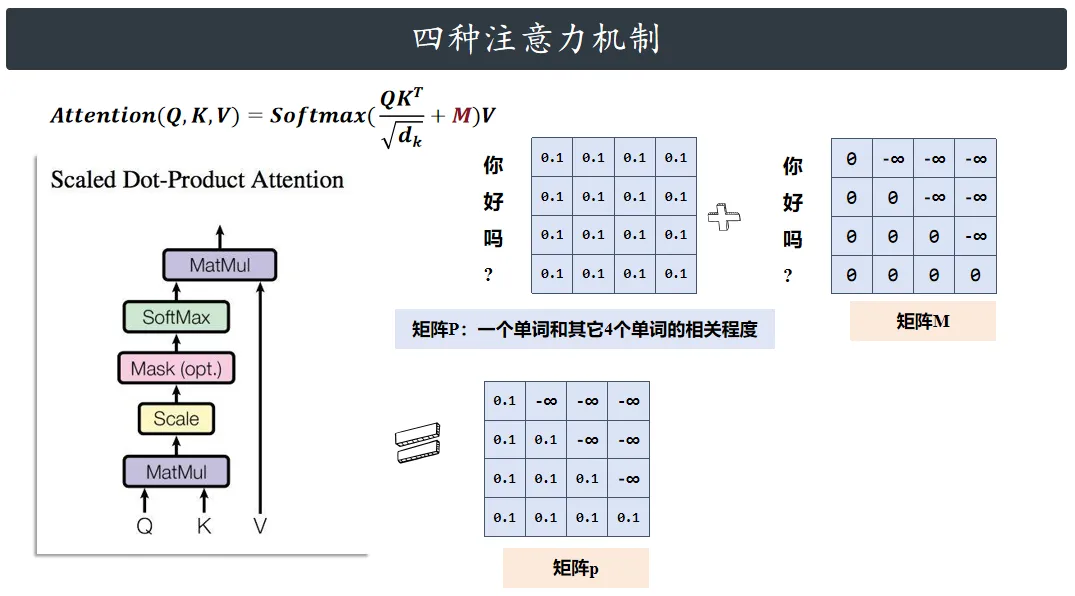
咱们先说说掩码注意力,它的计算其实就是在原来的基础上,多了一步“加矩阵”的操作——加的这
个矩阵就是M(掩码矩阵),它的样子很特别:主对角线下面的元素全是0,主对角线上面的全是
负无穷大。 具体做法就是,把这个带负无穷大的掩码矩阵,和之前算出来的相似度矩阵,对应位
置的元素一个个加起来。 效果也很直接:如果掩码矩阵里某个位置是负无穷大,那相似度矩阵对
应位置的数值就会被改掉;要是掩码矩阵里是0,那相似度矩阵原来的数值就保持不变。

代码实现
import torch
import torch.nn as nn
import torch.nn.functional as F
class MultiHeadSelfAttention(nn.Module):
    def __init__(self, d_model=64, num_heads=8):
        """
        初始化多头自注意力
        :param d_model: 输入/输出的特征维度(必须能被 num_heads 整除)
        :param num_heads: 头的数量
        """
        super().__init__()
        assert d_model % num_heads == 0, "d_model 必须能被 num_heads 整除"
        self.d_model = d_model  # 整体特征维度
        self.num_heads = num_heads  # 头数
        self.d_k = d_model // num_heads  # 每个头的特征维度(d_model / num_heads)
        # 1. 定义3个线性层,分别生成 Q、K、V(输入输出维度都是 d_model)
        self.w_q = nn.Linear(d_model, d_model)  # Q的线性变换
        self.w_k = nn.Linear(d_model, d_model)  # K的线性变换
        self.w_v = nn.Linear(d_model, d_model)  # V的线性变换
        # 2. 定义输出的线性层(拼接多头后做最终变换)
        self.w_o = nn.Linear(d_model, d_model)
        # 层归一化(用于残差连接后)
        self.layer_norm = nn.LayerNorm(d_model)
    def scaled_dot_product_attention(self, q, k, v, mask=None):
        """
        缩放点积注意力(单个头的注意力计算)
        :param q: 单个头的Q (batch_size × seq_len × d_k)
        :param k: 单个头的K (batch_size × seq_len × d_k)
        :param v: 单个头的V (batch_size × seq_len × d_k)
        :param mask: 掩码(可选,batch_size × seq_len × seq_len),0/False 表示遮挡
        :return: 注意力输出 + 注意力权重
        """
        # 第一步:Q·K^T,计算相似度(batch_size × seq_len × seq_len)
        scores = torch.matmul(q, k.transpose(-2, -1))  # k.transpose(-2,-1) 交换最后两个维度(seq_len 和 d_k)
        # 第二步:缩放(除以 sqrt(d_k),避免数值过大)
        scores = scores / torch.sqrt(torch.tensor(self.d_k, dtype=torch.float32))
        # 第三步:应用掩码(如果有)—— 遮挡位置设为负无穷,softmax后为0
        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)  # mask==0 的位置填 -1e9

        # 第四步:softmax 归一化,得到注意力权重(batch_size × seq_len × seq_len)
        attn_weights = F.softmax(scores, dim=-1)
        # 第五步:权重 × V,得到注意力输出(batch_size × seq_len × d_k)
        output = torch.matmul(attn_weights, v)
        return output, attn_weights
    def split_heads(self, x):
        """
        将 Q/K/V 拆分成多个头(batch_size × seq_len × d_model)→(batch_size × num_heads × seq_len × d_k)
        """
        batch_size = x.size(0)
        # 先拆分最后一维:d_model → num_heads × d_k
        x = x.view(batch_size, -1, self.num_heads, self.d_k)
        # 交换维度:把 num_heads 提到 seq_len 前面(方便后续并行计算)
        return x.transpose(1, 2)  # 输出:batch_size × num_heads × seq_len × d_k
    def combine_heads(self, x):
        """
        拼接多个头的输出(batch_size × num_heads × seq_len × d_k)→(batch_size × seq_len × d_model)
        """
        batch_size = x.size(0)
        # 先交换维度:num_heads 放回最后一维前面
        x = x.transpose(1, 2)  # 输出:batch_size × seq_len × num_heads × d_k
        # 拼接最后两维:num_heads × d_k → d_model
        x = x.contiguous().view(batch_size, -1, self.d_model)  # contiguous() 确保内存连续
        return x
    def forward(self, x, mask=None):
        """
        前向传播(核心流程)
        :param x: 输入(batch_size × seq_len × d_model)
        :param mask: 掩码(可选,batch_size × seq_len × seq_len)
        :return: 多头自注意力输出(batch_size × seq_len × d_model)、注意力权重
        """
        batch_size = x.size(0)

        # 1. 生成 Q、K、V(线性变换)
        q = self.w_q(x)  # batch_size × seq_len × d_model
        k = self.w_k(x)
        v = self.w_v(x)

        # 2. 拆分多头(并行计算每个头的注意力)
        q = self.split_heads(q)  # batch_size × num_heads × seq_len × d_k
        k = self.split_heads(k)
        v = self.split_heads(v)

        # 3. 计算缩放点积注意力(每个头独立计算)
        attn_output, attn_weights = self.scaled_dot_product_attention(q, k, v, mask)

        # 4. 拼接所有头的输出
        attn_output = self.combine_heads(attn_output)  # batch_size × seq_len × d_model

        # 5. 最终线性变换
        output = self.w_o(attn_output)  # batch_size × seq_len × d_model

        # 6. 残差连接 + 层归一化(Transformer 标准操作,稳定训练)
        output = self.layer_norm(x + output)  # x 是原始输入(残差),加完后归一化

        return output, attn_weights
# -------------------------- 测试代码(运行看效果)--------------------------
if __name__ == "__main__":
    # 1. 设置超参数
    batch_size = 2  # 2个样本
    seq_len = 4     # 每个样本4个词(比如 "Are you OK ?")
    d_model = 64    # 每个词的特征维度
    num_heads = 8   # 8个多头(64 / 8 = 8,每个头维度是8)

    # 2. 生成随机输入(模拟经过词嵌入+位置编码后的特征)
    x = torch.randn(batch_size, seq_len, d_model)  # 形状:(2, 4, 64)
    print("输入形状:", x.shape)  # 输出:torch.Size([2, 4, 64])

    # 3. 初始化多头自注意力
    multi_head_attn = MultiHeadSelfAttention(d_model=d_model, num_heads=num_heads)

    # 4. 前向传播(无掩码,默认计算所有词的关联)
    output, attn_weights = multi_head_attn(x)

    # 5. 输出结果查看
    print("输出形状:", output.shape)  # 输出:torch.Size([2, 4, 64])(和输入形状一致)
    print("注意力权重形状:", attn_weights.shape)  # 输出:torch.Size([2, 8, 4, 4])
    # 注意力权重解释:(batch_size, num_heads, seq_len, seq_len) → 每个头对每个词的关联权重

输入形状: torch.Size([2, 4, 64])
输出形状: torch.Size([2, 4, 64])
注意力权重形状: torch.Size([2, 8, 4, 4])