公司用了五六年的客户管理系统,查询慢、功能旧,业务部门天天提需求,旧系统根本扛不住,只能换新版平台。有时候业务越做越大,原来的本地服务器撑不起并发,老板拍板要把数据库迁到云端,追求更好的扩展性,这时候数据就得跟着迁,所以数据迁移从来不是简单的 “搬数据”,它背后是业务发展的必然选择。今天就跟大家好好聊聊数据迁移到底该怎么做,以及有哪些常见的方法。
一、数据迁移的前期准备
1. 明确迁移目标与业务边界
首先要和业务部门彻底沟通,明确迁移的核心目标,比如是提升系统性能、满足合规要求,还是支持业务扩展。同时要划定业务边界,区分核心数据和非核心数据,客户信息、交易记录属于核心数据,必须优先迁移且零差错,而历史日志、测试数据属于非核心数据,可以分批处理或简化迁移。另外,还要设定量化指标,像迁移完成时间、数据一致性阈值、业务停机容忍窗口,这些指标会直接决定后续的迁移方案选择。
2. 全面梳理源端与目标端
接下来要对源系统和目标系统进行全方位梳理。
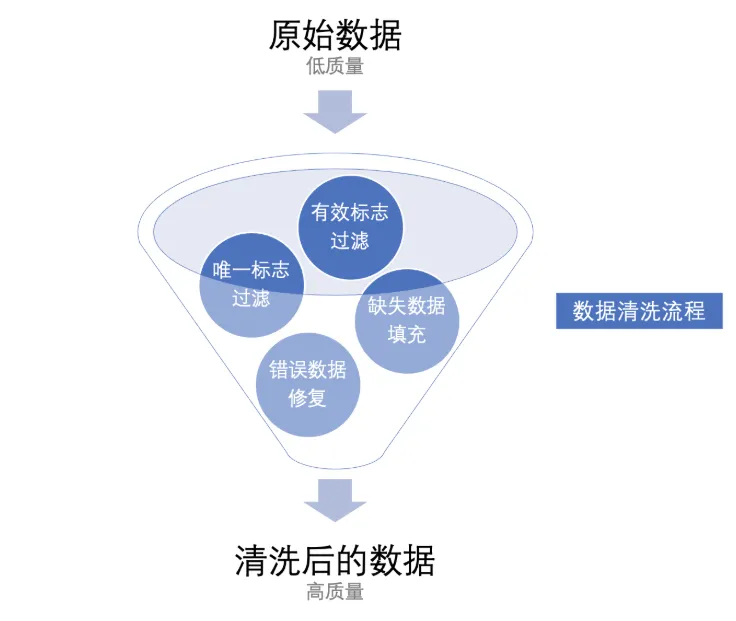
源端梳理:统计数据量、分析数据结构、评估数据质量,重点识别脏数据、重复数据、缺失值和不符合业务规则的数据。
目标端梳理:检查环境兼容性,比如数据类型、字符集、函数语法的差异;环境搭建、网络配置和权限分配。
3. 数据清洗与预处理
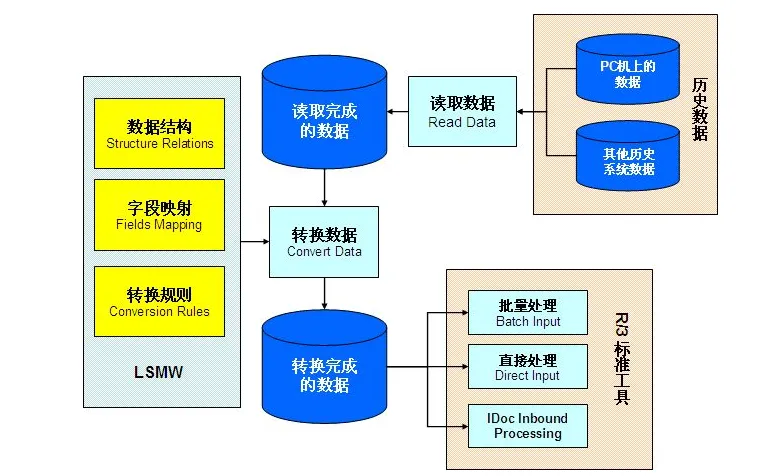
针对源端梳理出的问题数据,要进行去重、补全缺失值、规范字段格式、处理特殊字符等操作。对于需要格式转换的数据,要提前编写转换规则,比如将源端的日期格式统一为目标端的标准格式。不要把脏数据带入目标系统,否则后续的业务操作会出现一系列问题,后期整改的成本会远超迁移本身。
4. 制定方案与回滚计划
方案要明确迁移方法、工具选择、操作步骤、时间节点和责任人,甚至要详细到每一条命令的执行顺序。更重要的是,必须制定回滚计划,迁移前要对源端数据做全量备份,确保一旦迁移失败,能在最短时间内恢复业务。
二、常见的数据迁移方法
数据迁移的方法有很多,不同方法适用于不同的业务场景和数据规模。下面按数据迁移范围和实施方式,给大家详细介绍最常用的几种方法。
1. 按数据迁移范围划分的方法
- 全量迁移:一次性将源端所有数据迁移到目标端。它的优点是实施简单、数据完整性高,适合首次迁移或数据量较小的场景。缺点是耗时长、资源占用大,可能会影响源系统性能,甚至需要业务停机。
- 增量迁移:仅迁移源端在指定时间点后发生变化的数据,这种方法效率高、资源占用少,适合数据量巨大或需要持续同步数据的场景,但是复杂度高,需要实时监控数据变化,还要处理数据冲突问题。比如电商平台的实时交易数据,无法进行长时间停机,就需要用增量迁移持续同步。
- 全量+增量结合迁移:先执行一次全量迁移,完成基础数据的同步,再通过增量迁移同步后续的变动数据。这是企业生产环境中最常用的方法,兼顾了全量迁移的完整性和增量迁移的高效性,适合数据量大、业务连续性要求高的场景,既保证了迁移效率,又避免了业务长时间中断。
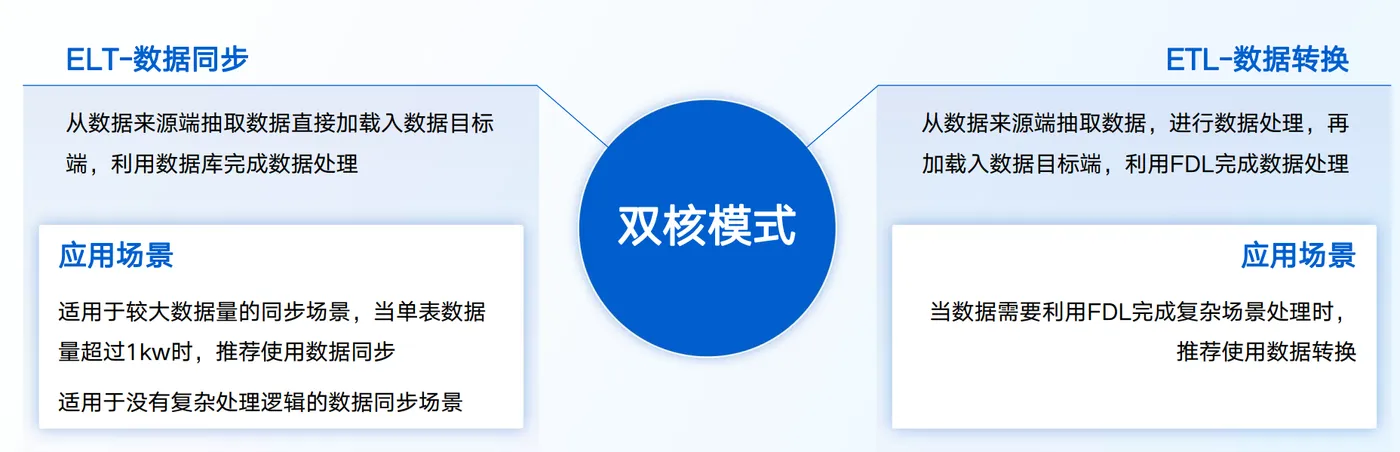
这里给大家推荐一款我们团队正在用的工具FineDataLink,它是集实时数据同步、ELT/ETL 数据处理、数据服务于一体的数据集成工具,能解决迁移过程中很多核心痛点。它支持 40 多种数据源,不管是旧 CRM 系统、本地数据库还是云端平台,基本都能覆盖,拖拉拽就能完成数据同步和处理任务,不用写复杂脚本。而且它内嵌 Spark 计算引擎,支持批量表实时同步、增量更新和断点续传,能很好适配全量 + 增量结合的迁移场景,还能自动处理表结构变更,避免同步过程中出现数据错乱。
2. 按迁移实施方式划分的方法
- 离线迁移:在业务停机窗口内,将源端数据导出为文件,再导入到目标端,这种实施起来简单、成本低,易于监控和调试,但是业务中断,数据量越大,停机时间越长。适合数据量较小或可容忍短暂停机的场景,比如历史数据归档。

- 在线迁移:在业务正常运行的情况下,完成数据的迁移与同步,不影响业务连续性,适合核心业务系统。缺点是实施复杂,需要专门的工具支持,还要处理实时数据的同步冲突。比如银行的核心交易系统,全年无休,只能采用在线迁移。
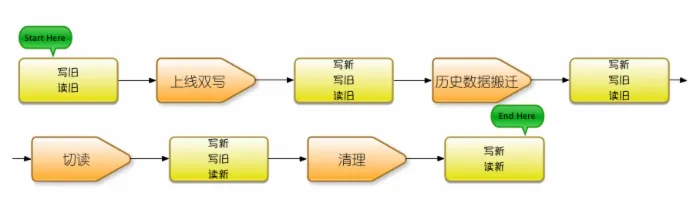
- 物理迁移:直接将存储数据的硬件设备,如硬盘、服务器,从源环境转移到目标环境,迁移速度极快,适合海量数据迁移,但是硬件兼容性要求高,且存在物理运输的风险。
三、数据迁移的后期验证与收尾
不要以为数据导入目标端就完成了迁移,迁移后的验证和收尾,直接决定了数据迁移是否真正成功。
1. 数据一致性验证
数据一致性验证一般从这三个维度展开:
- 总量校验,统计源端和目标端的数据行数、文件数量是否一致;
- 字段级校验,对比核心字段的总和、极值等,比如订单总金额、用户总数;
- 抽样校验,随机抽取1%-5%的数据进行全字段对比,重点核查大字段和特殊字符数据。
可以用SQL查询或专业的对比工具,确保数据无丢失、无错乱。
2. 业务功能验证
数据最终是为业务服务的,必须验证目标系统的业务功能是否正常。比如在目标系统中完成订单创建、支付、查询等关键流程,检查报表生成是否准确,权限控制是否有效。
3. 性能测试与正式割接
要对比迁移前后目标系统的查询响应时间、并发处理能力,确保性能满足业务需求。测试通过后,才能进行正式割接,将业务流量从源系统切换到目标系统。割接后要持续监控24-72小时,及时处理出现的问题。
4. 旧系统下线
确认目标系统运行稳定后,再逐步下线旧系统。不要急于删除源端数据,建议保留3-6个月,以备不时之需。
数据迁移不是一项简单的技术操作,而是一套完整的流程体系。把数据迁移的核心环节搞清楚,掌握正确的方法,再结合实际的业务背景逐步实践,就能顺利完成数据迁移。
常见问答
Q1:数据迁移必须停机吗?
A1: 不一定。数据量小、业务容忍停机的场景,可选择离线迁移;核心业务系统则用在线迁移,无需停机。
Q2:迁移中数据丢失了怎么办? 怎么保证安全?
A2:立即执行回滚计划,恢复源端数据,排查丢失原因后重新迁移。这也是为什么必须提前做全量备份的原因。。
Q3:增量迁移的冲突问题怎么处理?
A3:要提前制定冲突规则,比如以源端数据为准,或按时间戳取最新数据,并用工具实时监控和处理冲突。
Q4:迁移后,新旧系统要并行运行多久?
A4:建议设置一个观察期,比如一到两周。在此期间,可以并行运行或进行影子测试(将生产流量复制一份到新系统处理,但不影响实际结果),持续比对数据和业务处理结果,确保万无一失后,再下掉旧系统。