引言:数据的价值——为什么说“垃圾进,垃圾出”?
在AI的世界里,有一句至理名言: “Garbage In, Garbage Out” (垃圾进,垃圾出)。意思是,如果你给模型“喂”的是质量低劣、杂乱无章的数据,那么无论你的模型架构多先进,训练技巧多高超,最终得到的也只能是一个“智障”模型。
数据集的重要性体现在哪?
- 模型的“知识来源” :模型的所有“智慧”都源于它看到的数据。你想让AI学会写诗,就得给它看唐诗宋词;你想让它识别猫狗,就得给它看成千上万张猫狗图片。
- 决定模型的“能力边界” :一个只学过中文问答的数据集,训练出的模型大概率不会回答英文问题。数据决定了模型擅长的领域和它的“世界观”。
- 影响模型的“道德倾向” :如果训练数据中存在大量偏见(如性别、种族偏见),模型也会“有样学样”,输出带有偏见的内容。
应用场景无处不在:从手机里的智能语音助手、人脸解锁,到电商平台的推荐系统、自动驾驶汽车的感知模块,再到医疗影像分析,背后无一不需要精心准备的数据集作为支撑。
简单说,想要得到一个好用的AI模型,第一步,也是最重要的一步,就是准备一份高质量的数据集。
技术原理:拆解数据集的核心概念
咱们用个比喻来理解:如果把训练一个AI模型比作教一个小朋友认水果。
- 数据集(Dataset) :就是你准备的一整箱“教学工具”,里面可能包括苹果、香蕉、橘子的实物、图片、卡片等等。这就是用于教学的全部材料集合。
- 样本/数据点(Sample/Data Point) :箱子里的每一个具体物品。比如一个具体的苹果、一张香蕉的图片,就是一个样本。
- 特征(Feature) :描述每个样本的各个维度。对于那个苹果样本,它的特征可以包括:颜色(红色)、形状(圆形)、重量(150克)、味道(甜)……这些特征就是模型用来学习区别不同水果的线索。
- 标签(Label) (针对监督学习):你告诉小朋友的正确答案。拿着苹果图片,你告诉他“这是苹果”,这个“苹果”就是标签。特征(图片像素) 和 标签(“苹果”) 的组合,就构成了一条完整的学习材料。
数据集的关键类型(按用途分):
- 训练集(Training Set) :主力教材,占总数据的大部分(如70%)。模型就是反复“研读”这部分数据,来调整内部参数,学会规律的。
- 验证集(Validation Set) :模拟考卷,占一部分(如15%)。在训练过程中,定期用这份模型没学过的数据来测试一下,看看学习效果如何,防止它“死记硬背”训练集(过拟合)。
- 测试集(Test Set) :最终大考,占一部分(如15%)。在模型完全训练好后,才拿出来做最终评估的数据。用于衡量模型面对全新、从未见过数据时的真实能力(泛化能力)。
记住这个核心关系:用训练集教,用验证集调,用测试集评。三者必须严格分开,不能有交集,否则评估结果就会失真。
实践步骤:从零开始准备你的第一份数据集
理论懂了,手痒了吗?我们以一个实际目标为例:创建一个能让AI模型学习识别“正向鼓励”和“负向批评”的文本数据集。
第1步:明确任务与格式
任务:文本二分类(判断一句话是“鼓励”还是“批评”)。
格式:我们选择最通用的
JSONL格式(每行一个JSON对象),因为它结构清晰,且被大多数平台支持。json
{"text": "你这次做得非常棒,继续加油!", "label": "鼓励"}
{"text": "这个方案漏洞百出,需要彻底重做。", "label": "批评"}
第2步:数据获取与收集
- 自产数据:根据场景,自己编写一批典型的鼓励和批评语句。这是最精准但费时的方式。
- 网络爬取:从论坛、评论区的互动中收集(注意版权和隐私,仅学习用途)。
- 利用公开数据集:在
Kaggle、Hugging Face Datasets等网站搜索“sentiment analysis”(情感分析)相关数据集,可能找到相近的,可以筛选或改造。
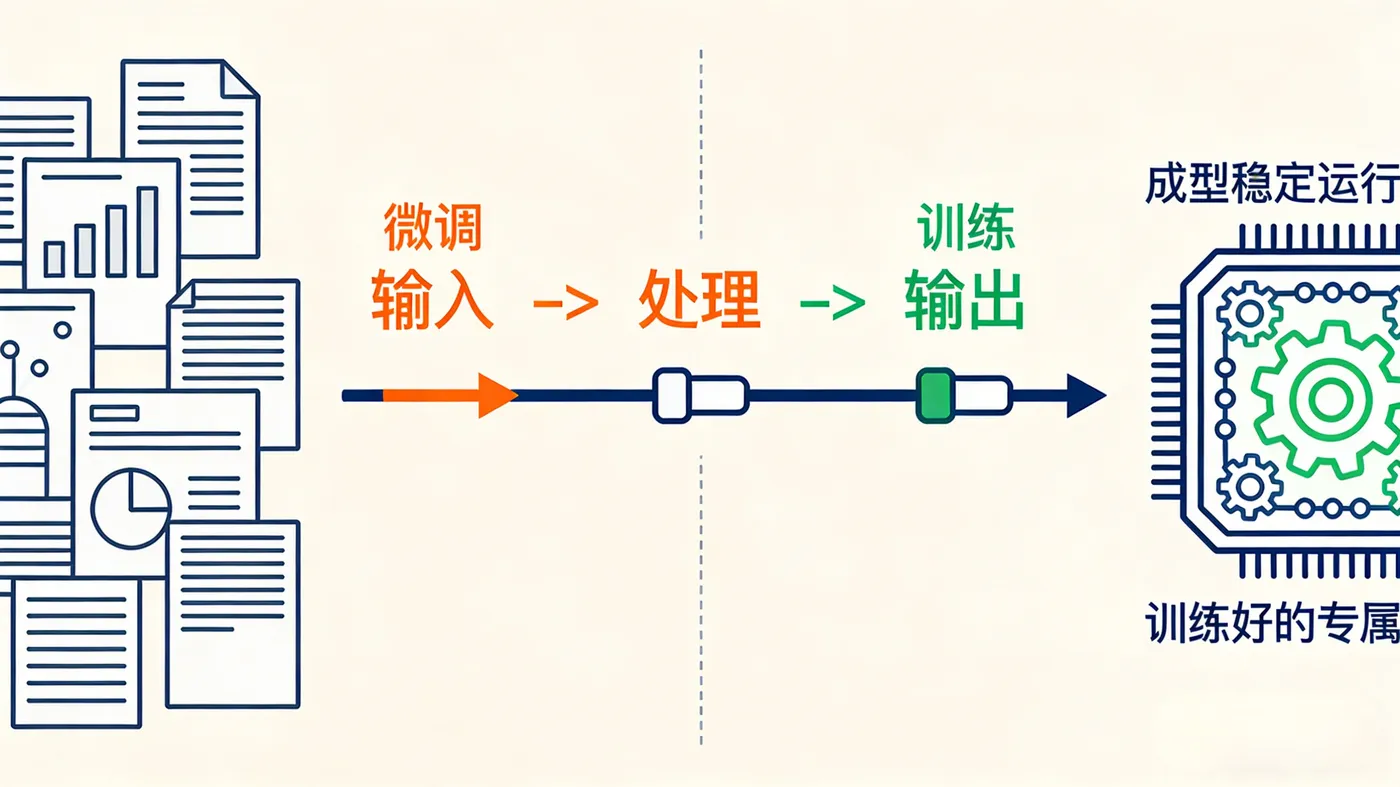
第3步:数据清洗与预处理
这是最枯燥但最关键的一步,直接决定数据质量。
- 去除无关内容:删除URL、特殊符号、乱码。
- 格式统一:全角转半角,英文大小写统一。
- 处理缺失/错误:检查是否有空行或标签错误的样本,进行修正或删除。
- 去重:删除完全重复的样本。
第4步:数据标注
如果收集的是未标注的原始文本,就需要人工或借助规则打上“鼓励”或“批评”的标签。可以邀请朋友帮忙校对,确保标注一致性。
第5步:划分数据集
将清洗标注好的数据,按一定比例(如7:1.5:1.5)随机打乱后,分成训练集、验证集和测试集,并分别保存为三个文件。
第6步:开启模型微调之旅
现在,你拥有了一份结构清晰、质量过关的专属数据集。接下来,就可以用它来“喂养”一个基础大模型(如LLaMA-2、Qwen等),让它学会你的分类任务了。
- 传统微调需要编写代码、配置环境,对新手门槛很高。此时,你可以使用LLaMA-Factory Online这样的低门槛大模型微调平台。你只需将准备好的训练集、验证集文件上传,选择基础模型,配置几个简单参数(如学习率、训练轮次),点击启动,平台就能自动完成整个微调流程。无需代码基础,你就能亲手“生产”出一个能理解“鼓励”和“批评”的专属模型,在实践中深刻体会数据是如何让模型“变成你想要的样子”的。
效果评估:你的数据集“养”出了好模型吗?
模型训练完成后,我们主要从两个层面评估:
1. 看量化指标(在测试集上):
- 准确率:分类正确的样本占总样本的比例。最直观的指标。
- 精确率 & 召回率:尤其适用于样本不均衡时。比如,“鼓励”类样本远多于“批评”类时,模型可能全预测为“鼓励”也能获得高准确率,但这时“批评”类的召回率就会很低。
- F1分数:精确率和召回率的调和平均数,是一个综合指标。
2. 做定性分析(人工抽查):
- 抽取测试集中模型预测的结果,尤其是预测错误的和置信度不高的样本,人工检查。
- 思考:是数据本身有歧义?还是某一类数据量太少模型没学好?或者是标注有误?
- 这个过程至关重要,它能直接反馈你的数据集存在哪些问题,指导你迭代改进数据集(如补充某类样本、修正错误标注)。
总结与展望
朋友们,今天我们一起深入浅出地聊了聊数据集的方方面面。记住:
- 数据集是AI的命根子,质量重于数量。
- 一个标准的流程:明确任务 -> 获取数据 -> 清洗 -> 标注 -> 划分 -> 应用。
- 评估要量化与定性结合,从错误中学习,迭代优化数据。
随着技术的发展,数据集的构建也在演进:
- 未来,更强调数据的安全、合规与伦理,消除偏见将是重要课题。
- 合成数据技术可能会兴起,在保护隐私的同时生成高质量训练数据。
- 自动化数据管道和智能化数据标注工具会越来越普及,降低数据准备的成本。
希望这篇长文能帮你拨开“数据集”的神秘面纱。别再只盯着模型和算法了,低下头,好好准备你的“AI食粮”吧。当你亲手用一份高质量的数据集,“喂”出一个表现优异的专属模型时,那种成就感是无与伦比的。动手试试,从今天开始,成为一名合格的“AI饲养员”!