摘要:数据源是每条 Structured Streaming 查询的起点,也决定了这条流能拿到什么容错语义。本文把 Spark 内置源与输出端一次讲全:File 源的原子写入与 maxFileAge 坑、Kafka 源的 offset 语义与限流、Socket/Rate 测试源的边界;再给输出端一张支持矩阵(File 只支持 append、Kafka 三种模式、foreachBatch 是至少一次);最后给出生产选型决策路径——什么场景选什么源,exactly-once 到底卡在哪一环。读完你能对任何一条流快速判断:它可重放吗?它幂等吗?它敢上生产吗?
关键词:Structured Streaming, Spark, 数据源, Kafka Source, File Source, Rate Source, Sink, foreachBatch, Exactly-Once, 容错语义
一、先立一个判断框架:可重放 + 幂等 = 端到端 Exactly-Once
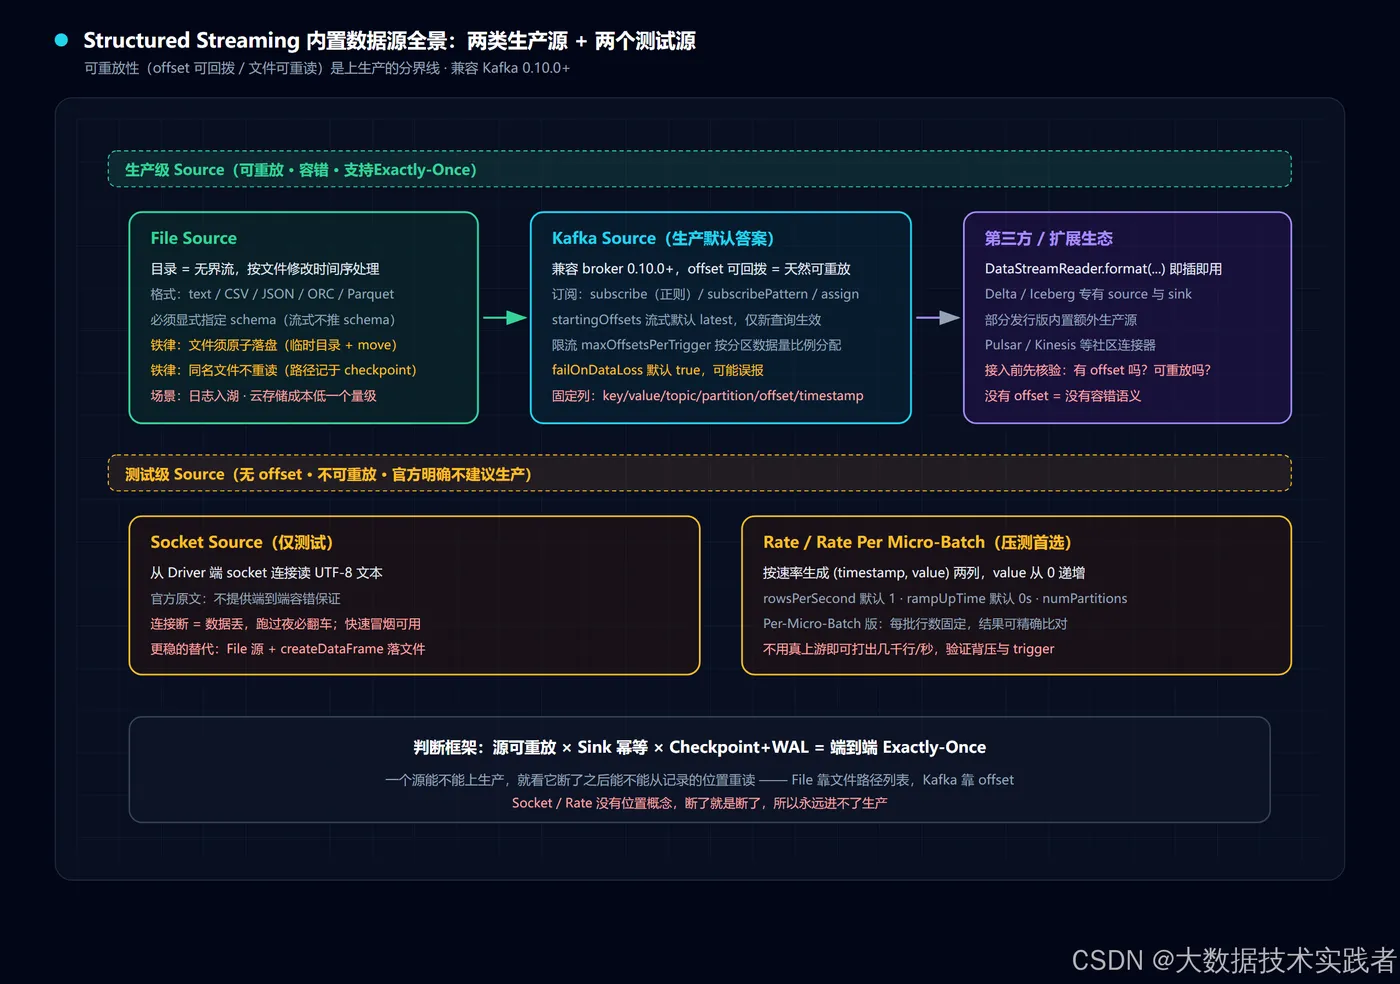
聊数据源种类之前,先把判断标准立起来。Structured Streaming 的容错设计基于三件事:
- 源有 offset(类似 Kafka offset 或文件路径列表),能记录"读到了哪";
- 引擎有 checkpoint + WAL,把每个 trigger 处理的 offset 范围持久化;
- Sink 幂等,同一批数据写两次结果不变。
三者齐了才是端到端 exactly-once。这个框架直接决定了每个源的价值:一个源能不能"重放",就是它能不能上生产的分界线。
| Source | 可重放 | 容错 | 官方定位 |
|---|---|---|---|
| File | ✅(文件还在就能重读) | ✅ | 生产 |
| Kafka | ✅(offset 可回拨) | ✅ | 生产 |
| Rate / Rate Per Micro-Batch | ❌(无 offset) | ❌ | 测试 |
| Socket | ❌(连接断数据丢) | ❌ | 仅测试 |
下面逐个拆。
二、File Source:文件目录当成流来读
File 源把一个目录里陆续落盘的文件当作无界流,支持 text/CSV/JSON/ORC/Parquet。它是最容易被低估的生产源——云存储比 Kafka 便宜一个量级,日志入湖场景经常是它。
2.1 三条铁律
铁律一:必须显式指定 schema。 流式读没有"先扫一遍全量数据推 schema"的机会(数据是无限来的),spark.readStream 默认不推 Parquet 以外的格式,不指定直接报错。这也是流处理与批处理最大的思维差异之一。
铁律二:文件必须原子落盘。 引擎靠"文件出现在目录里"判断新数据,写了一半的文件会被当成完整文件读走。大多数文件系统里,正确姿势是先写到临时目录再 move 进目标目录。
铁律三:同名文件不重读。 已处理的文件路径记在 checkpoint 里,同名再出现会被忽略。想重新处理?换目录,或者换 checkpoint。
2.2 关键选项速查
path               # 输入目录,支持 glob,不支持逗号分隔多 glob
maxFilesPerTrigger # 每个 trigger 最多考虑多少新文件,默认无上限
maxBytesPerTrigger # 每个 trigger 最多考虑多少字节,默认无上限
latestFirst        # 积压大时优先处理最新文件,默认 false
fileNameOnly       # 只按文件名判重,默认 false
maxFileAge         # 超龄文件忽略;首批例外(全量有效),默认 7 天
cleanSource        # 处理后清理:off / archive / delete
sourceArchiveDir   # archive 目录,不能是 path 的子目录(否则死循环重读)
2.3 一个高频坑:maxFileAge 与"新任务首跑"
maxFileAge 默认 7 天,语义是相对最新文件的时间戳而不是当前系统时间。高频坑:老目录切换到新流任务,第一批会把目录里所有文件(包括超龄的)都当有效数据处理——这是官方设计(首批全量有效),但如果你以为"设了 7 天就只读 7 天内的",第一批的结果会让你以为代码有 bug。
三、Kafka Source:生产环境的默认答案
Kafka 是事实上的标准生产源,兼容 0.10.0+ 的 broker。它的核心优势就是那个判断框架里的第一条:offset 可回拨,天然可重放。
3.1 订阅方式与起始位点
// 三种订阅:subscribe(正则)/ subscribePattern / assign(指定分区)
spark.readStream
  .format("kafka")
  .option("kafka.bootstrap.servers", "broker1:9092,broker2:9092")
  .option("subscribe", "order_events")              // 或 subscribePattern / assign
  .option("startingOffsets", "latest")              // 仅新查询生效
  .option("minPartitions", "12")                    // 提示值,切小分片提并行度
  .option("maxOffsetsPerTrigger", "80000")          // 限流
  .option("failOnDataLoss", "true")                 // 默认 true
  .load()
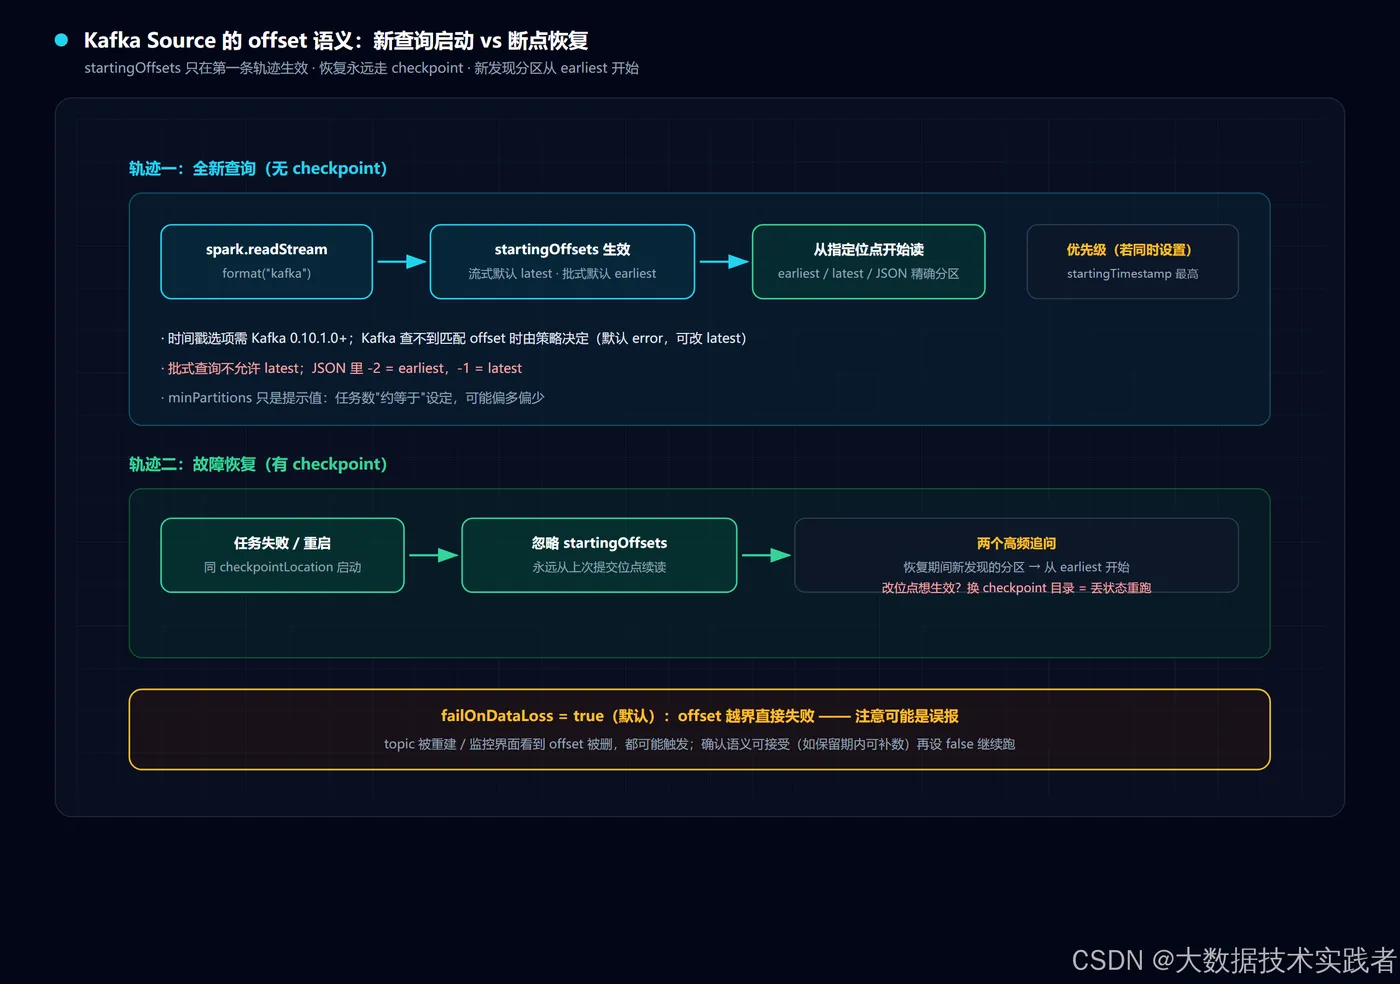
startingOffsets 只在新查询启动时生效;从 checkpoint 恢复时永远从断点续读,新发现的分区从 earliest 开始。批式读的默认值不同(earliest),且批式不允许 latest。
3.2 四个必懂选项
- minPartitions:默认 topicPartition:sparkPartition = 1:1。设大于 topic 分区数会把大分区切小片提高并行度,但只是提示值,实际任务数可能偏多偏少。
- maxOffsetsPerTrigger:限流。总量按各分区数据量按比例分配,不是平均分。
- failOnDataLoss:默认 true,offset 越界直接失败。注意可能是误报(比如你在监控界面上看到了 offset 被删),确认语义可接受后设 false 继续跑。
- kafka.* 前缀透传:producer/consumer 参数直接透传,安全配置用
spark.kafka.clusters.<id>.*前缀。
3.3 读到的数据结构
读出来的 DataFrame 固定列:key/value(binary)、topic、partition、offset、timestamp、headers(includeHeaders 默认 false)。业务解析第一步永远是 CAST(value AS STRING) 再 from_json。
四、测试源:Socket 与 Rate 的正确用法
Socket 源:从驱动端 socket 连接读 UTF-8 文本。官方明确"不提供端到端容错保证,仅用于测试"——连接断了数据就没了,没有 offset 可回拨。快速冒烟可以,跑过夜就会教你做人。
Rate 源:按 rowsPerSecond 生成 (timestamp, value) 两列数据,value 从 0 递增。三个选项:rowsPerSecond(默认 1)、rampUpTime(默认 0 秒,渐进入速)、numPartitions(默认 Spark 默认并行度)。它是压测首选:不用真上游就能打出几千行/秒的流量,验证背压、trigger、state 配置。
Rate Per Micro-Batch 源:与 Rate 的区别是"每微批生成固定行数",批与批之间结果一致(batch 0 生成 0–999,batch 1 生成 1000–1999),不随查询执行情况漂移。适合做结果可比对的测试。
一个实用建议:测试其实也可以用 File 源替代 Socket——先 createDataFrame 写文件到目录,再流式读,比 Socket 稳得多。
五、输出端矩阵:三分之一的坑都在这
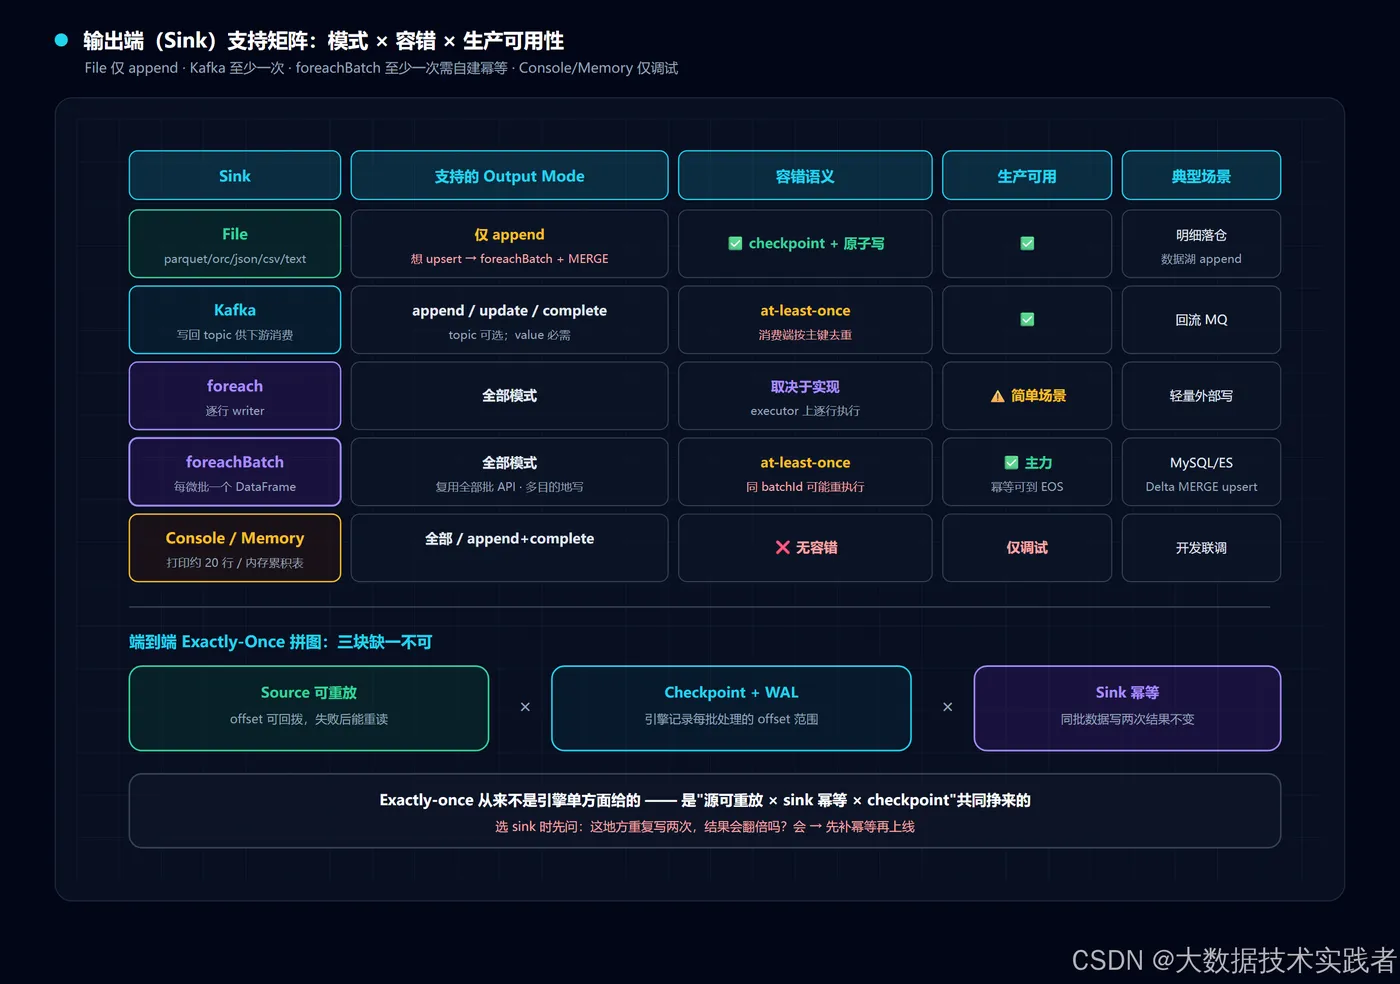
源解决"读什么",sink 决定"怎么写"。一张矩阵看全:
| Sink | 支持模式 | 容错 | 生产可用 |
|---|---|---|---|
| File | 仅 append | ✅ checkpoint + 原子写 | ✅ |
| Kafka | append / update / complete | ✅(at-least-once) | ✅ |
| foreach | 全部 | 取决于实现 | ⚠️ 逐行 |
| foreachBatch | 全部 | at-least-once,需自建幂等 | ✅ 主力 |
| Console | 全部 | ❌ | 仅调试 |
| Memory | append / complete | ❌ | 仅调试 |
三个高频误区:
- File sink 只支持 append。想 upsert?走 foreachBatch + Delta MERGE,或者直接用 Delta/iceberg 专有 sink。
- Kafka sink 本身是 at-least-once。broker 收到但 ack 丢了会重试导致重复。官方给的解法是消费端按主键去重,而不是指望 sink 变聪明。
- foreachBatch 是"至少一次"。同一 batchId 失败恢复时可能重执行。它的正确打开方式:幂等写入(upsert / INSERT OVERWRITE),或用 batchId 做事务性去重表。好处是能复用全部批 API——jdbc、join 静态表、dropDuplicates、一次写多个目的地。
六、 Continuous Processing 模式的源与 sink 限制
连续处理模式(毫秒级延迟,at-least-once)下源与 sink 白名单明显收窄:
- Source:Kafka 全选项支持;Rate 仅 numPartitions 和 rowsPerSecond。
- Sink:Kafka 全选项;Memory、Console 仅调试。
- 不支持:foreachBatch(foreach 可用)、聚合操作(仅 map 类投影/过滤)。
换句话说:连续模式 = Kafka 进 Kafka 出 + 无聚合的简单变换。这是很多团队评估完后又回到微批的原因——功能面差太多。
七、生产选型决策路径
把上面的信息压成一条决策路径:
- 上游是消息队列吗? 是 → Kafka 源(90% 的场景);开启 maxOffsetsPerTrigger 限流,评估 failOnDataLoss 语义。
- 上游是文件/对象存储吗? 是 → File 源;确认原子写入管道(临时目录 + move),设 maxFilesPerTrigger 防首批打爆,规划 cleanSource 策略控制存储成本。
- 需要写回流? 结果给下游实时消费 → Kafka sink;结果落仓 → File sink(append)或 foreachBatch + Delta MERGE(upsert)。
- 外部系统没有原生 sink? foreachBatch + 幂等写入是唯一正解,逐行 foreach 只留给简单场景。
- 想上连续模式? 先对照第六节白名单自查:不是 Kafka→Kafka 无聚合,就老实用微批。
最后一条经验:选源的顺序就是排坑的顺序。先用 Kafka 把链路跑通(最全语义),再评估能不能降级到 File 源省成本;反过来先 File 后 Kafka 的迁移,往往要重做 checkpoint 与幂等设计。
八、总结
- 判断一个源能不能上生产,就看一件事:它可重放吗?File 与 Kafka 可以,Socket/Rate 不行;
- File 源三铁律:显式 schema、原子落盘、同名不重读;maxFileAge 按"相对最新文件"计算,首批全量有效是官方行为不是 bug;
- Kafka 源四件套:startingOffsets 仅新查询生效、minPartitions 是提示值、maxOffsetsPerTrigger 按比例分配限流、failOnDataLoss 默认 true 可能误报;
- 测试源里 Rate 比 Socket 靠谱,压测用它不用真上游;结果可比对的测试用 Rate Per Micro-Batch;
- 输出端矩阵记牢:File 仅 append、Kafka 至少一次、foreachBatch 默认至少一次要自建幂等——exactly-once 从来不是引擎单方面给的,是源可重放 × sink 幂等共同挣来的;
- 连续处理模式的源/sink 白名单极窄(Kafka→Kafka 无聚合),评估时先自查再上车。