RAG分块应用中普遍存在的问题

简介: RAG系统面临准确性、召回率与复杂文档解析三大挑战:模型易产生幻觉、检索噪声干扰、细粒度理解不足;语义匹配局限导致漏检,长尾知识覆盖差,多跳推理困难;表格、公式、图片等非结构化数据处理难,上下文割裂、逻辑结构丢失。合理分块策略是破局关键。

准确性:答案可信度不足

幻觉问题

即使检索到相关文档,大模型仍可能脱离文档内容编造答案(尤其在文档信息模糊或矛盾时)。例如如:用户问“某基金近3年收益率”,模型可能捏造数据而非引用检索到的报告。

检索噪声干扰

相似度搜索返回的文档片段可能包含无关信息,导致模型生成答案时被误导。例如:检索到10篇文档,其中3篇主题相关但含错误数据,模型可能融合错误信息。

细粒度理解缺失

模型难以精准理解数字、日期、专业术语的上下文含义,导致关键信息误用。例如:将“预计2025年增长10%”误解为历史数据。

召回率:关键信息漏检

语义匹配局限

传统向量搜索依赖语义相似度,但用户问题与文档表述差异大时漏检(如术语vs口语)。例如:用户问“钱放货币基金安全吗?”可能漏检标题为“货币市场基金信用风险分析”的文档。

长尾知识覆盖不足

低频、冷门知识因嵌入表示不充分,在向量空间中难以被检索到。例如:某小众金融衍生品的风险说明文档未被召回。

多跳推理失效

需组合多个文档片段才能回答的问题(如因果链),单次检索难以关联分散的知识点。例如:“美联储加息如何影响A股消费板块?”需先检索加息机制,再关联A股消费板块。

复杂文档解析:信息提取瓶颈

非结构化数据处理

  • 表格/图表:文本分块会破坏表格结构,导致行列关系丢失(如财报中的利润表)。
  • 公式/代码:数学公式或程序代码被错误分段,语义完整性受损。
  • 扫描件/图片:OCR识别错误率高,尤其对手写体或模糊文档。

上下文割裂问题

固定长度分块(如512字符)可能切断关键上下文:

分块1结尾:“...风险因素包括:”

分块2开头:“利率波动、信用违约...” → 模型无法关联分块1的提示语。

文档逻辑结构丢失

标准分块策略忽略章节、段落、标题的层级关系,影响知识图谱构建。例如:将“附录”中的备注误认为正文结论。

RAG的分块策略与选择

选择合适的分块策略,是解决RAG实际应用中准确性、召回率与复杂文档解析等痛点最直接有效的方式,也是我们建设RAG系统最关键的一个环节。最常见的RAG分块策略包括:固定大小分块、语义分块、递归分块、基于文档结构的分块、基于LLM的分块。
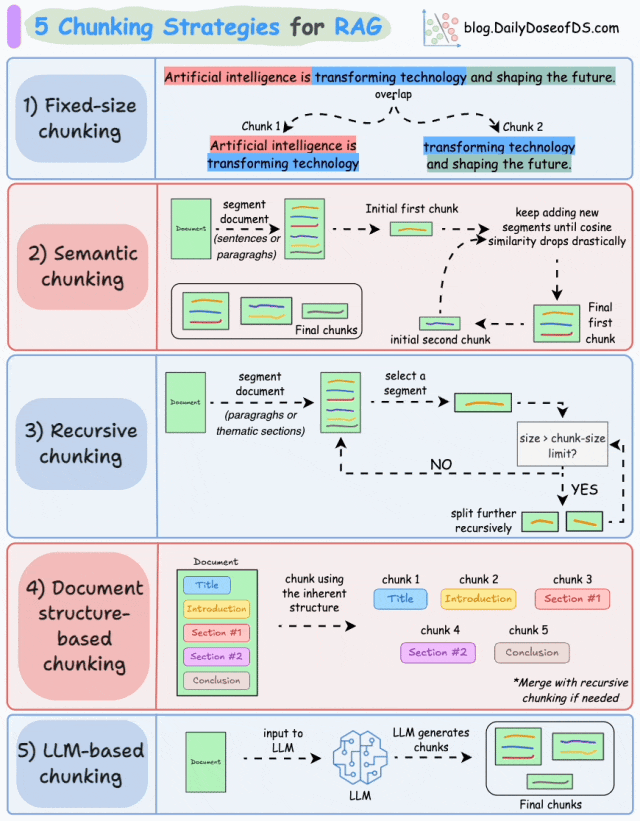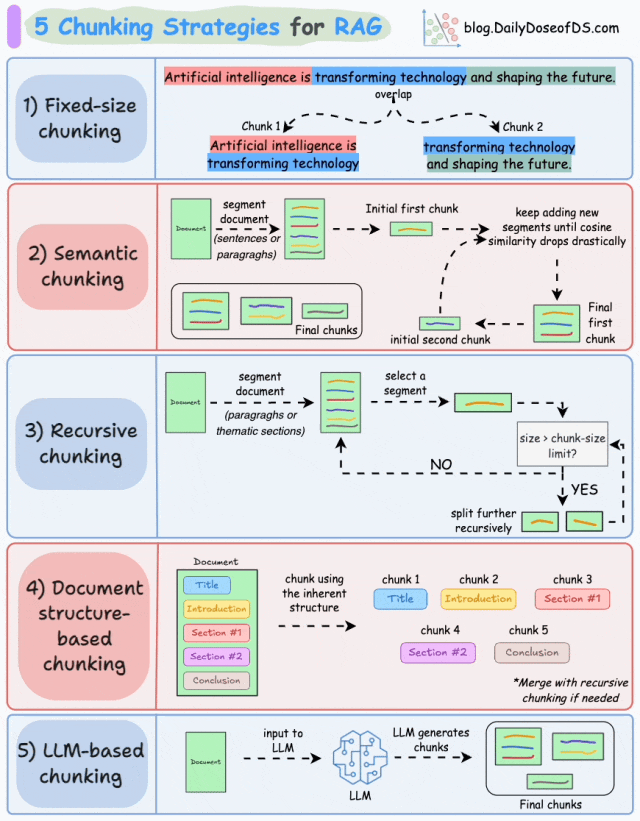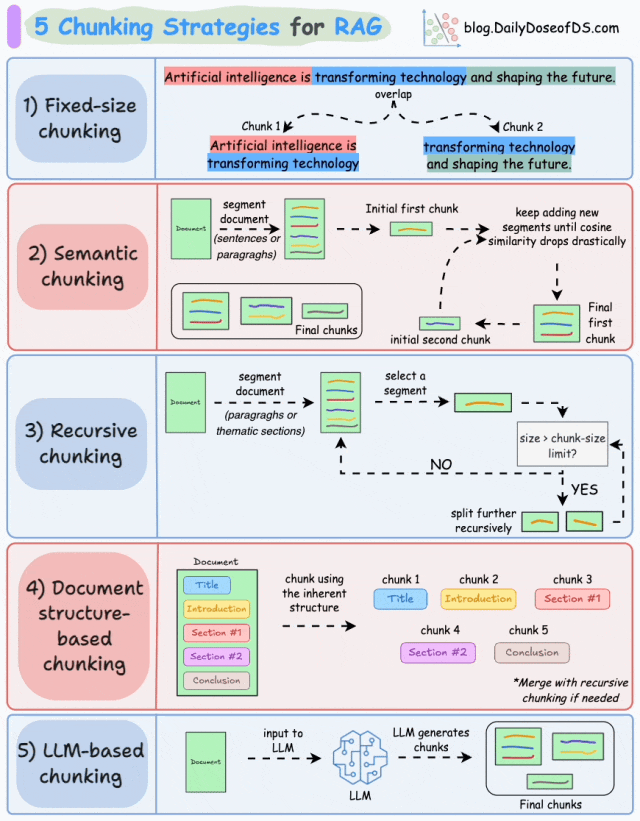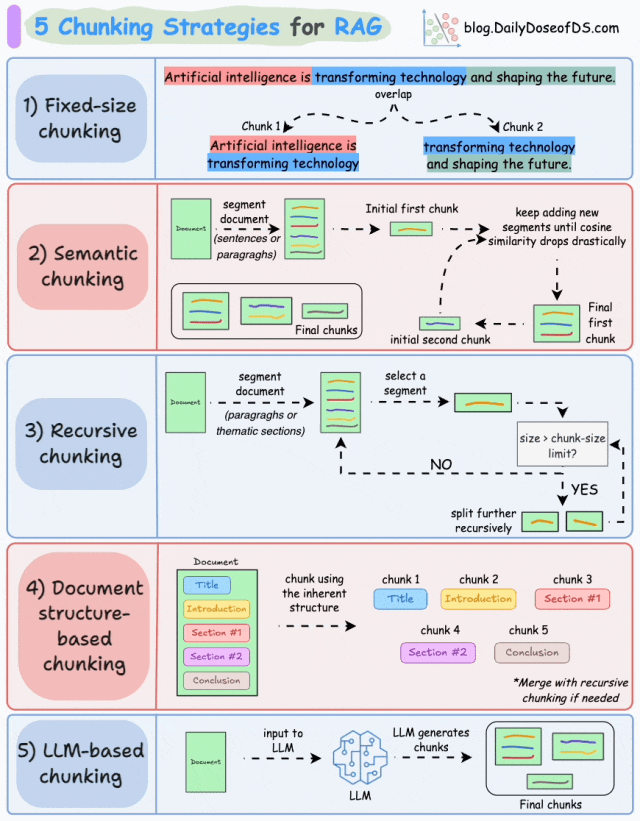
RAG五种分块策略(图片来源:DailyDoseofDS)

相关文章
|
9月前
|
XML 安全 数据格式
RAG面临的挑战与前沿探索
当前RAG面临知识关联缺失、推理与检索割裂、多模态理解弱、可信度难量化及长上下文建模难等深层问题。前沿探索聚焦检索增强、生成控制与优化分块,通过混合检索、查询扩展、递归推理、强制引用、语义分块等技术,推动RAG向动态交互、可解释、高可信方向演进。(238字)
|
3月前
|
人工智能 缓存 安全
【AI 尝鲜实验室】5.22 号上新 | DeepSeek-TUI:终端里 DeepSeek 版的 Claude Code
DeepSeek-TUI是专为DeepSeek V4大模型打造的终端AI编程助手,支持100万Token超长上下文、实时推理可视化、文件/Shell/Git/网页等全栈操作,提供Plan/Agent/YOLO三种安全模式,无需图形界面,开箱即用。(239字)
|
6月前
|
人工智能 Linux API
OpenClaw是什么?OpenClaw能做什么?2026年OpenClaw介绍及部署保姆级图文教程
在AI智能体快速普及的2026年,OpenClaw(曾用名Clawdbot、Moltbot)作为一款开源AI Agent框架,凭借“本地优先、模块化技能、多通道接入”的核心优势,成为连接大模型与本地系统的核心工具,无需专业开发能力,新手也能快速上手,实现自动化办公、数据抓取、系统运维等多种场景需求。本文将全面解析OpenClaw的核心定位与功能,详细拆解2026年新手零基础下阿里云部署、MacOS/Linux/Windows11本地部署的完整流程,同步讲解阿里云百炼API配置方法,并汇总高频常见问题及解决方案,全程附带可直接复制的代码命令,确保零基础用户也能顺利完成部署与使用。
3717 15
|
7月前
|
机器学习/深度学习 编解码 自然语言处理
智能体如何“看懂”界面,精准找到“人想要”的对应地方
本文详解智能体如何像人类一样“看懂”GUI界面,突破传统自动化局限。通过视觉感知、语义对齐、GUI定位与记忆适配四大能力,实现从指令理解到精准操作的全链路意图驱动交互,赋能企业级复杂系统自动化。
505 8
|
7月前
|
存储 缓存 并行计算
大模型应用:LlamaIndex 与 LangChain 深度集成构建本地化RAG系统.25
本文详解LlamaIndex与LangChain协同构建本地化RAG系统:以Qwen1.5-1.8B-Chat为基座,通过轻量化验证与工程化落地两阶段示例,实现文档索引、语义检索、提示编排与问答生成全链路本地化,兼顾准确性、可控性与可扩展性。
914 11
|
9月前
|
Ubuntu Linux 测试技术
Linux系统离线安装Docker完整指南
本文详细介绍在Ubuntu 24等Linux系统中离线安装Docker的完整流程,适用于内网隔离环境。涵盖安装包下载、`docker.service`配置、安装与卸载脚本编写、权限设置、镜像测试及用户组配置,并包含docker-compose的离线部署方法,助力高效完成生产环境搭建。
10890 4
Linux系统离线安装Docker完整指南
|
存储 缓存 自然语言处理
浏览量超 10w 的热图,描述 RAG 的主流架构
大模型性能的持续提升,进一步挖掘了 RAG 的潜力,RAG 将检索系统与生成模型相结合,带来诸多优势,如实时更新知识、降低成本等。点击本文,为您梳理 RAG 的基本信息,并介绍提升大模型生成结果的方法,快一起看看吧~
2143 128
|
自然语言处理 测试技术 决策智能
让RAG更聪明,ViDoRAG开启视觉文档检索增强生成新范式,上阿里云百炼可直接体验
视觉丰富文档的高效检索与生成是自然语言处理领域的重大挑战。ViDoRAG(Visual Document Retrieval-Augmented Generation via Dynamic Iterative Reasoning Agents)由阿里巴巴通义实验室、中国科学技术大学和上海交通大学联合提出,通过多智能体框架和动态迭代推理机制解决此问题。其核心包括多模态混合检索策略和多智能体生成流程,同时发布的ViDoSeek数据集,专为大规模文档集合设计,提供复杂推理与精准问答的评估基准。实验表明,ViDoRAG在准确率和效率上优于传统方法,未来将优化系统性能并降低计算成本。
1336 63
|
存储 缓存 API
从零构建企业知识库问答系统(基于通义灵码+RAG+阿里云OSS的落地实践)
本系统基于RAG技术,结合语义检索与大语言模型,解决企业知识管理中的信息孤岛、检索低效和知识流失问题。采用通义灵码、Milvus与阿里云OSS,实现知识查询效率提升、新员工培训周期缩短及专家咨询减少。支持多模态文档处理,具备高可用架构与成本优化方案,助力企业智能化升级。
2329 3

热门文章

最新文章