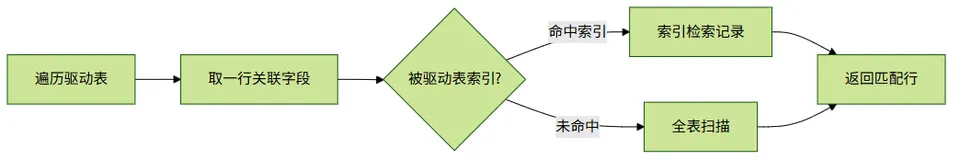
JOIN顺序优化:小表驱动大表的执行原则

简介: 在数据库查询优化中,“小表驱动大表”是一种提升SQL查询效率的常用策略。其核心思想是优先处理数据量较小的表,再与大表进行连接操作,从而减少数据扫描量、降低I/O开销并提高内存使用效率。通过显式指定JOIN顺序、使用EXISTS替代IN以及合理创建索引等方式,可以有效实现该原则。例如,在连接部门表(小表)和员工表(大表)时,先处理小表可显著提升查询性能。掌握这一原则有助于编写高效SQL语句,优化数据库整体表现。

在数据库查询优化中,特别是在使用 SQL 语句进行数据查询时,遵循“小表驱动大表”的原则是一种常见且有效的策略。这个原则的核心思想是首先处理小表,然后再与大表进行连接操作,这样可以显著提高查询的效率。下面详细解释这一原则及其背后的原因:

为什么“小表驱动大表”有效?
减少数据扫描量:

当数据库系统执行 JOIN 操作时,如果先处理小表,那么只需要扫描小表中的每一行与大表中的行进行匹配。这样可以大幅度减少需要扫描的数据量,特别是在大表与小表进行连接时。

优化内存使用:

数据库系统通常会尝试将较小的数据集放入内存中,以加速处理速度。先处理小表意味着这部分数据更容易被缓存和快速处理。

减少I/O操作:

磁盘I/O是数据库性能的一个重要瓶颈。先处理小表可以减少磁盘I/O的次数,因为每次只需要读取小表的一部分数据。

如何实现“小表驱动大表”?
显式指定JOIN顺序:

在 SQL 查询中,你可以通过显式指定 JOIN 的顺序来控制哪张表作为“小表”。例如,在 MySQL 中可以使用 STRAIGHT_JOIN 或者在 Oracle 中使用 /+ ORDERED / 来指定 JOIN 的顺序。

-- MySQL 示例
SELECT * FROM small_table
STRAIGHT_JOIN large_table ON small_table.id = large_table.id;

使用 EXISTS 替代 IN:

当一个大表需要与多个小表进行连接时,可以考虑使用 EXISTS 而不是 IN。EXISTS 可以更有效地处理这种情况,因为它通常只需要扫描小表一次。

SELECT * FROM large_table lt
WHERE EXISTS (SELECT 1 FROM small_table st WHERE st.id = lt.id);

索引优化:

确保参与 JOIN 的列在表中都有适当的索引。对于大表,可以考虑使用覆盖索引(Covering Index),这样查询可以只访问索引而不需要访问数据行本身。

示例优化
假设有两个表:employees(员工表,有100万条记录)和 departments(部门表,有1万条记录)。如果要找出所有员工及其所在部门的信息,应该先处理 departments 表(小表),然后与 employees 表进行连接。

SELECT e.*, d.department_name
FROM departments d
JOIN employees e ON d.id = e.department_id;
这种顺序确保了数据库系统首先处理较小的 departments 表,然后再与较大的 employees 表进行连接,从而优化了查询性能。

总之,“小表驱动大表”是一个在数据库查询优化中非常有用的原则,通过合理应用这一原则,可以显著提高查询的效率和性能。
相关文章
|
Shell 容器 Perl
Back-off restarting failed container 问题解决
4339 0
|
数据采集 数据挖掘
kettle开发-数据清洗之字符串替换
kettle开发-数据清洗之字符串替换
1188 2
|
SQL 算法 关系型数据库
什么是 ‘小表驱动大表’ 原则?如何实现 JOIN顺序优化?(图解+秒懂+史上最全)
|
10月前
|
缓存 Java 开发工具
QLExpress使用及源码分析
QLExpress是阿里巴巴开源的轻量级规则引擎,支持通过YAML配置规则脚本,结合注解实现Java方法与表达式映射。通过别名机制、AST解析和上下文赋值,实现灵活的动态逻辑执行,适用于复杂业务规则场景。
366 0
|
SQL 关系型数据库 MySQL
深入解析MySQL的EXPLAIN:指标详解与索引优化
MySQL 中的 `EXPLAIN` 语句用于分析和优化 SQL 查询,帮助你了解查询优化器的执行计划。本文详细介绍了 `EXPLAIN` 输出的各项指标,如 `id`、`select_type`、`table`、`type`、`key` 等,并提供了如何利用这些指标优化索引结构和 SQL 语句的具体方法。通过实战案例,展示了如何通过创建合适索引和调整查询语句来提升查询性能。
3725 10
|
消息中间件 监控 Java
RocketMQ 同步发送、异步发送和单向发送,如何选择?
本文详细分析了 RocketMQ 中同步发送、异步发送和单向发送三种消息发送方式的原理、优缺点及适用场景。同步发送可靠性高但延迟较大,适合订单系统等场景;异步发送非阻塞且延迟低,适用于实时数据处理等场景;单向发送高效但可靠性低,适用于日志收集等场景。文章还提供了示例代码和核心源码分析,帮助读者更好地理解每种发送方式的特点。
2810 4
|
关系型数据库 MySQL 索引
MySQL in 太多的解决方案
MySQL in 太多的解决方案
1824 0
|
JSON Java 数据库连接
IDEA的插件大总汇 (让你的工作效率大大提高!)
我是小假 期待与你的下一次相遇 ~
4063 5
|
存储 数据管理 Apache
Doris建表分桶选择与优化建议
Apache Doris 中的分桶(Bucketing)是提升查询性能的重要优化手段。通过合理选择分桶列和分桶数,可提高数据并行处理能力与局部性。建议选用高基数、高频查询列作为分桶列,结合数据量与集群规模设置分桶数,推荐使用自动分桶(BUCKETS AUTO)。分桶策略包括哈希分桶与范围分桶,适用于不同场景。合理分桶可优化查询性能、导入效率与资源利用率,建议结合业务特征测试验证最佳方案。
1215 0
|
关系型数据库 MySQL 数据库
图解MySQL【日志】——两阶段提交
两阶段提交是为了解决Redo Log和Binlog日志在事务提交时可能出现的半成功状态,确保两者的一致性。它分为准备阶段和提交阶段,通过协调者和参与者协作完成。准备阶段中,协调者向所有参与者发送准备请求,参与者执行事务并回复是否同意提交;提交阶段中,若所有参与者同意,则协调者发送提交请求,否则发送回滚请求。MySQL通过这种方式保证了分布式事务的一致性,并引入组提交机制减少磁盘I/O次数,提升性能。
1806 5
图解MySQL【日志】——两阶段提交