一、本文介绍
本文记录的是利用带有注意力机制的激活函数ARelu改进YOLOv11的方法研究。v11默认的激活函数是Silu,通过引入了非线性因素,使网络能够学习和拟合更复杂的函数关系,但在处理梯度消失问题上能力相对较弱,且稳定性会受到输入值和网络参数的较大影响。而ARelu激活函数,通过注意力模块学习元素级别的残差,对于激活的输入能够有效放大从下游传播的梯度,从而缓解梯度消失问题。在面对复杂多样的数据时,能够灵活地调整激活效果。
专栏目录:YOLOv11改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进
专栏地址:YOLOv11改进专栏——以发表论文的角度,快速准确的找到有效涨点的创新点!
二、AReLU设计原理
2.1 AReLU模块设计的出发点
- 对激活函数学习方式的新探索:现有的可学习激活函数主要通过对不可学习的激活函数进行参数化或松弛,或者寻求预定义激活函数池的数据驱动组合来实现数据自适应。作者希望从新的角度,即利用逐元素注意力机制来构建可学习的激活函数。
- 结合激活函数与注意力机制的直观联系:激活函数和逐元素注意力函数都以逐元素乘法的网络模块形式应用,在神经网络中学习逐元素激活函数可被视为面向任务的注意力机制,即根据要完成的最终任务学习关注(激活)输入特征图中的哪些元素,从而促使一种更具可解释性的注意力激活函数公式的产生。
2.2 AReLU模块的原理
2.2.1 基于注意力机制的通用公式
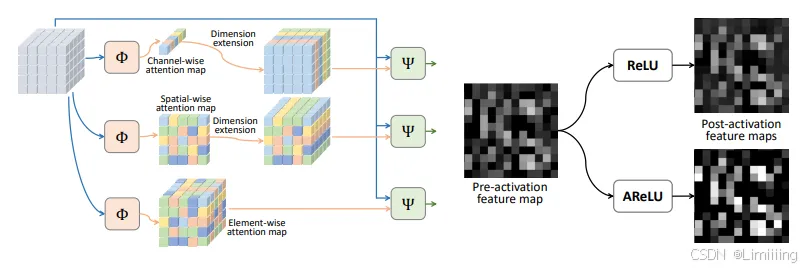
设$V = {v{i}} \in \mathbb{R}^{D{v}^{1}×D{v}^{2}×\cdots}$为表示输入数据或特征量的张量,函数$\Phi$由参数$\Theta = {\theta{i}}$参数化,用于计算注意力图$S = {s{i}} \in \mathbb{R}^{D{v}^{\theta(1)}×D{v}^{\theta(2)}×\cdots}$,即$s{i}=\Phi(v{i}, \Theta)$。$\Phi$可由神经网络实现,其参数$\Theta$是可学习的。通过函数$\Psi$用注意力图$S$调制输入$V$得到输出$U = {u{i}} \in \mathbb{R}^{D{v}^{1}×D{v}^{2}×\cdots}$,其中$\Psi$是逐元素乘法,即$u{i}=\Psi(v{i}, s_{i})$。
2.2.2 ARelu的具体构建
- 逐元素基于符号的注意力机制(ELSA):对于特征量$V = {v{i}} \in \mathbb{R}^{W×H×C}$,计算逐元素注意力图$S = {s{i}} \in \mathbb{R}^{W×H×C}$,其中$s{i}=\Phi(v{i}, \Theta)= \begin{cases}C(\alpha), & v{i}<0 \ \sigma(\beta), & v{i} \geq 0\end{cases}$,$\Theta = {\alpha, \beta} \in \mathbb{R}^{2}$是可学习参数,$C(\cdot)$将输入变量限制在$[0.01, 0.99]$,$\sigma$是sigmoid函数,调制函数$\Psi$定义为$u{i}=\Psi(v{i}, s{i})=s{i}v_{i}$。
2.2.3 ARelu的定义
将ELSA中的函数$\Phi$用具有可学习参数$\alpha$和$\beta$的网络层表示为$\mathcal{L}(x{i}, \alpha, \beta)= \begin{cases}C(\alpha)x{i}, & x{i}<0 \ \sigma(\beta)x{i}, & x{i} \geq 0\end{cases}$,结合标准的Rectified Linear Units $\mathcal{R}(x{i})=\begin{cases}0, & x{i}<0 \ x{i}, & x{i} \geq 0\end{cases}$,得到可学习激活函数$\mathcal{F}(x{i}, \alpha, \beta)=\mathcal{R}(x{i})+\mathcal{L}(x{i}, \alpha, \beta)=\begin{cases}C(\alpha)x{i}, & x{i}<0 \ (1+\sigma(\beta))x{i}, & x{i} \geq 0\end{cases}$。
2.3 AReLU模块的结构
- 注意力模块:在每一层网络中,有一个注意力模块,它为预激活特征图学习一个逐元素、基于符号的注意力图。该注意力图根据元素的符号对元素进行缩放。
- 与ReLU的结合:注意力模块与ReLU模块相结合,共同构成ARelu。对于输入的每个元素,当元素小于0时,通过$C(\alpha)$进行缩放;当元素大于等于0时,通过$(1 + \sigma(\beta))$进行缩放。
2.4 AReLU模块的优势
- 缓解梯度消失问题:注意力模块本质上学习了相对于ReLU激活部分的逐元素残差(因为ReLU可视为恒等变换),这有助于有效缓解梯度消失问题。具体来说,当输入被激活时,ARelu会放大从下游传播的梯度(因为$1+\sigma(\beta)>1$),而在其他情况下则抑制梯度,而标准的ReLU及其变体(如PReLU)只有抑制作用。
- 数据自适应和稳定性:ARelu的放大因子是通过学习动态适应输入的,并由sigmoid函数限制,这使得激活更具数据自适应性和稳定性。例如,通过对后激活特征图的可视化比较,可以看出ARelu在这方面的优势。
- 轻量级且易于学习:只有两个可学习参数$\alpha$和$\beta$,因此ARelu是轻量级的且易于学习。
- 计算复杂度低:对于一个$L$层网络,ARelu引入的额外参数非常少,只有$2L$个,并且在正向和反向传播中,由于ARelu导致的计算复杂度可以忽略不计。
论文:https://arxiv.org/pdf/2006.13858
源码:https://link.zhihu.com/?target=https%3A//github.com/densechen/AReLU
三、实现代码及YOLOv11修改步骤
模块完整介绍、个人总结、实现代码、模块改进、二次创新以及各模型添加步骤参考如下地址: