大数据-158 Apache Kylin 安装配置详解 集群模式启动(二)

简介: 大数据-158 Apache Kylin 安装配置详解 集群模式启动(二)

接上篇:https://developer.aliyun.com/article/1623245?spm=a2c6h.13148508.setting.20.66e24f0etlssu8

配置环境

我们需要修改 kylin.sh

cd $KYLIN_HOME/bin
vim kylin.sh

# 需要写入这些依赖 防止后续报错
export HADOOP_HOME=/opt/servers/hadoop-2.9.2
export HIVE_HOME=/opt/servers/apache-hive-2.3.9-bin
export HBASE_HOME=/opt/servers/hbase-1.3.1
export SPARK_HOME=/opt/servers/spark-2.4.5-bin-without-hadoop-scala-2.12

配置结果如下图所示:

检查依赖

$KYLIN_HOME/bin/check-env.sh
• 1

我这里报错了,可能是之前的环境变量有问题:

我找了一圈,看到 Flink YARN 这里HADOOP_CONF_DIR可能配置错了:

# Flink YRAN
# export HADOOP_CONF_DIR=$HADOOP_HOME
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export YARN_CONF_DIR=$HADOOP_HOME/etc/hadoop
export HADOOP_CLASSPATH=`hadoop classpath`

修改完的结果为如下:(这里我暂时注释了,防止我的FlinkYRAN以后不能用了)

重新进行测试环境,检查顺利通过,看里边还有一些和Flink、Kafka的配置等,你需要的话可以加入:

启动集群

ZooKeeper

启动 h121 h122 h123集群模式

需要每个节点都运行

zkServer.sh start
• 1

HDFS

启动 h121 h122 h123

h121运行即可,但是要检查确认

start-dfs.sh

YRAN

启动 h121 h122 h123

h121运行即可,但是要检查确认

start-yarn.sh

HBase

启动 h121 h122 h123

h121运行即可,但是要检查确认

start-hbase.sh

Metastore

启动 h121 即可

nohup hive --service metastore > /tmp/metastore.log 2>&1 &

运行结果如下图:

history server

启动 h121 即可

mr-jobhistory-daemon.sh start historyserver
• 1

Kylin

启动 h122

kylin.sh start

运行过程如下图所示:

节点详情

h121

与上图对应一下:

  • Metastore
  • Zookeeper
  • HBase
  • HDFS
  • JPS跳过
  • YARN
  • Hadoop

h122

  • JPS跳过
  • YRAN
  • ZooKeeper
  • HBase
  • 好像是Kylin
  • HDFS

h123

  • YARN
  • JPS跳过
  • HBase
  • ZooKeeper
  • Hadoop
  • HDFS

启动结果

http://h122.wzk.icu:7070/kylin/login
• 1

我们访问之后可以看到如下的内容:

登录进入

默认都是大写
账号 ADMIN
密码 KYLIN

b0f24d381d9796d55d13333ae652f704_7f54dd12b01c4ea4b4ad1a011eb6bed3.png

相关实践学习
基于MaxCompute的热门话题分析
Apsara Clouder大数据专项技能认证配套课程:基于MaxCompute的热门话题分析
目录
相关文章
|
消息中间件 存储 监控
构建高可用性Apache Kafka集群:从理论到实践
【10月更文挑战第24天】随着大数据时代的到来,数据传输与处理的需求日益增长。Apache Kafka作为一个高性能的消息队列服务,因其出色的吞吐量、可扩展性和容错能力而受到广泛欢迎。然而,在构建大规模生产环境下的Kafka集群时,保证其高可用性是至关重要的。本文将从个人实践经验出发,详细介绍如何构建一个高可用性的Kafka集群,包括集群规划、节点配置以及故障恢复机制等方面。
730 4
|
消息中间件 分布式计算 大数据
大数据-166 Apache Kylin Cube 流式构建 整体流程详细记录
421 5
|
SQL 分布式计算 NoSQL
大数据-164 Apache Kylin Cube优化 案例1 定义衍生维度与对比 超详细
428 1
大数据-164 Apache Kylin Cube优化 案例1 定义衍生维度与对比 超详细
|
分布式计算 大数据 Apache
利用.NET进行大数据处理:Apache Spark与.NET for Apache Spark
【10月更文挑战第15天】随着大数据成为企业决策和技术创新的关键驱动力,Apache Spark作为高效的大数据处理引擎,广受青睐。然而,.NET开发者面临使用Spark的门槛。本文介绍.NET for Apache Spark,展示如何通过C#和F#等.NET语言,结合Spark的强大功能进行大数据处理,简化开发流程并提升效率。示例代码演示了读取CSV文件及统计分析的基本操作,突显了.NET for Apache Spark的易用性和强大功能。
645 1
|
存储 大数据 分布式数据库
大数据-165 Apache Kylin Cube优化 案例 2 定义衍生维度及对比 & 聚合组 & RowKeys
437 1
|
人工智能 数据处理 API
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
Apache Flink Agents 是由阿里云、Ververica、Confluent 与 LinkedIn 联合推出的开源子项目,旨在基于 Flink 构建可扩展、事件驱动的生产级 AI 智能体框架,实现数据与智能的实时融合。
1765 6
阿里云、Ververica、Confluent 与 LinkedIn 携手推进流式创新,共筑基于 Apache Flink Agents 的智能体 AI 未来
|
存储 Cloud Native 数据处理
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
本文整理自阿里云资深技术专家、Apache Flink PMC 成员梅源在 Flink Forward Asia 新加坡 2025上的分享,深入解析 Flink 状态管理系统的发展历程,从核心设计到 Flink 2.0 存算分离架构,并展望未来基于流批一体的通用增量计算方向。
872 0
从嵌入式状态管理到云原生架构:Apache Flink 的演进与下一代增量计算范式
|
SQL 人工智能 数据挖掘
Apache Flink:从实时数据分析到实时AI
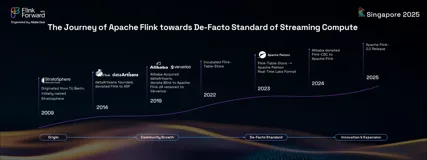
Apache Flink 是实时数据处理领域的核心技术,历经十年发展,已从学术项目成长为实时计算的事实标准。它在现代数据架构中发挥着关键作用,支持实时数据分析、湖仓集成及实时 AI 应用。随着 Flink 2.0 的发布,其在流式湖仓、AI 驱动决策等方面展现出强大潜力,正推动企业迈向智能化、实时化的新阶段。
1458 9
Apache Flink:从实时数据分析到实时AI
|
SQL 人工智能 API
Apache Flink 2.1.0: 面向实时 Data + AI 全面升级,开启智能流处理新纪元
Apache Flink 2.1.0 正式发布,标志着实时数据处理引擎向统一 Data + AI 平台迈进。新版本强化了实时 AI 能力,支持通过 Flink SQL 和 Table API 创建及调用 AI 模型,新增 Model DDL、ML_PREDICT 表值函数等功能,实现端到端的实时 AI 工作流。同时增强了 Flink SQL 的流处理能力,引入 Process Table Functions(PTFs)、Variant 数据类型,优化流式 Join 及状态管理,显著提升作业稳定性与资源利用率。
1122 0

热门文章

最新文章

推荐镜像

更多