生成全局唯一ID的雪花算法原理
雪花算法是一种用于生成全局唯一ID的算法,最初由Twitter开发,用于解决分布式系统中生成ID的问题。其核心思想是将一个64位的长整型ID划分成多个部分,每个部分用于表示不同的信息,确保了生成的ID在分布式环境下的唯一性。
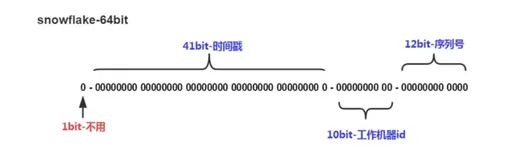
ID结构
- 符号位(1位):始终为0,用于保证ID为正数。
- 时间戳(41位):表示生成ID的时间戳,精确到毫秒级。
- 工作节点ID(10位):表示生成ID的机器的唯一标识。
- 序列号(12位):表示在同一毫秒内生成的多个ID的序列号。
生成步骤
- 获取当前时间戳,精确到毫秒级。
- 如果当前时间小于上次生成ID的时间,或者在同一毫秒内生成的ID数量超过最大值,等待下一毫秒再继续生成。
- 如果当前时间等于上次生成ID的时间,序列号自增1。
- 如果当前时间大于上次生成ID的时间,序列号重新从0开始。
- 将各个部分的值组合,得到最终的64位ID。
Go实现雪花算法的高并发ID生成器
package main
import (
 "fmt"
 "sync"
 "time"
)
const (
 workerBits     = 10
 sequenceBits   = 12
 workerMax      = -1 ^ (-1 << workerBits)
 sequenceMask   = -1 ^ (-1 << sequenceBits)
 timeShift      = workerBits + sequenceBits
 workerShift    = sequenceBits
 epoch          = 1609459200000
)
type Snowflake struct {
 mu          sync.Mutex
 lastTime    int64
 workerID    int64
 sequence    int64
}
func NewSnowflake(workerID int64) *Snowflake {
 if workerID < 0 || workerID > workerMax {
  panic(fmt.Sprintf("worker ID must be between 0 and %d", workerMax))
 }
 return &Snowflake{
  lastTime: time.Now().UnixNano() / 1e6,
  workerID: workerID,
  sequence: 0,
 }
}
func (sf *Snowflake) NextID() int64 {
 sf.mu.Lock()
 defer sf.mu.Unlock()
 currentTime := time.Now().UnixNano() / 1e6
 if currentTime < sf.lastTime {
  panic(fmt.Sprintf("clock moved backwards, refusing to generate ID for %d milliseconds", sf.lastTime-currentTime))
 }
 if currentTime == sf.lastTime {
  sf.sequence = (sf.sequence + 1) & sequenceMask
  if sf.sequence == 0 {
   for currentTime <= sf.lastTime {
    currentTime = time.Now().UnixNano() / 1e6
   }
  }
 } else {
  sf.sequence = 0
 }
 sf.lastTime = currentTime
 id := (currentTime-epoch)<<timeShift | (sf.workerID << workerShift) | sf.sequence
 return id
}
func main() {
 sf := NewSnowflake(1) // 假设工作节点ID为1
 for i := 0; i < 10; i++ {
  id := sf.NextID()
  fmt.Println(id)
  time.Sleep(time.Millisecond)
 }
}
高并发下的唯一性和递增性保障
在高并发场景下,保障雪花算法生成的ID唯一性和递增性的关键在于:
- 唯一性: 工作节点ID的设置保证了不同节点生成的ID不会冲突。序列号的自增和位运算保证了同一毫秒内生成的ID唯一。
- 递增性: 在同一毫秒内生成的多个ID按序列号的递增顺序排列。即使在极端情况下,同一毫秒内生成的ID数量超过了最大值,会等待下一毫秒重新开始,也保证了递增性。
总体来说,雪花算法在高并发下是一个可靠的ID生成方案。它的高性能和低碰撞概率使得它在分布式系统中被广泛应用。