【简历优化平台-06】为什么很多简历必须写项目经验?有的简历没有项目经验?

简介: 【简历优化平台-06】为什么很多简历必须写项目经验?有的简历没有项目经验?

 平台目前的进度如下:

   淡黄色是完成的模块...

   目前来到简历本身最后一个大栏目的优化:项目经验

   其实这个也是目前最难处理的,为什么呢?因为很多简历就没有项目经验这一块....

   其实在我从业之初的那两年,一直不明白为什么简历上要既有工作经历,又要有项目经验。因为在我的印象里,在一个公司经历那就是负责一个项目的测试,所以工作经历和项目经‍验是完全重叠的,不明白为什么要写两次。

   后来随着多年面试官经验,加上优化了那么多简历之后我明白了。

   原因有以下几点:    

   1. 面试官角度,工作经历主要看的是你的职位,公司,时间,工作内容也是比较大而广的方向概念。而项目经验则是更加细节的能力观察,包括细节深度和你的职责等,从项目经验的描写可以看出你这段经历是真是假,有多少水份等。

   2. 工作类型角度,一般的新手新人简历你会发现工作经历就是项目经验,那就是我上面说的一家公司只负责一个项目测试。但是一些老手的过程中,在一家公司要负责两个三个甚至多个项目的测试;也有的外包经历的话,也是要经受了好几家甲方的项目;也有的是负责一个测试平台的开发,这个测试平台不断迭代了好多年是跟着你一直以来的独立项目,不管换了哪家公司,你都在研究这个。所以 公司 - 项目 便不再是一对一的关系,而是基本拆开的关系。

   3. 培训班种下的先入为主思维定势,我不知道最早的简历中有没有项目经验独立出来写,但我确实是被培训班老师教的要拆出来写的,当时问过原因,说是因为大多培训出来的会进入外包,工作经历就写乙方公司的,项目经验就写甲方公司的,所以要分开来写,为了统一方便,干脆都这么写。后来发现其实真正的好处是项目经验可以更加突出细节和数据量化支撑。

   不管怎么说,项目经验都要写,而且要细致,有些新手的简历就那么可怜的一页,想凑字数,项目经验随便凑啊。


那接下来就说说项目经验的优化点吧:

   1. 项目数量:这个要根据你的工作年限和公司数量来取一个适当范围,而不是越少越好或者越多越好。

   2. 项目内容长短:很多粉丝的简历我看过发现了这个问题,就是恨不得把一切干过的活事无巨细的写上,结果写出去三四页的简历,这样在hr或者面试官阅读的时候就会产生腻了心理,并且也缺少层次感和神秘感。当然,太短也不行。

   3. 项目描述:这个其实很重要,首先字数不能太多,但要清晰的概括出项目的种类,量级,技术栈等必须内容。这part能精炼出来的大神并不多。很多同学的项目介绍长篇大论,好好的一个简历变成了推销广告了...

   4. 项目职责:项目职责这块,相比较前面的工作经历中的工作内容来说,要更具体更有层次感。并且主要阐述的是你为这个项目带来了什么,怎么理解这个项目,能不能分析透彻这个项目的情况。而并非罗列自己在这公司里干过的所有活,而且,千万不要多个项目的项目职责复制粘贴,千篇一律,通篇废话,全是假大空,那简历乍一看工整漂亮,但禁不起细看,会扣分。

   5. 业绩量化:业绩这栏,大部分同学简历中都未写过,其实就是主要阐述你做的工作到底效果如何,是混日子还是努力工作都能从这看出来,比如某个项目中你写用xx技术做自动化。那业绩里怎么招也要有这个自动化的落地效果,多少用例,覆盖了多少功能,提高了多少多少效率等等。

   6. 项目职责中你的技术点,举个例子,你前面的专业技能中写着很多xx技术,什么django,什么vue,什么pytest的,结果项目经历中却全都是用例设计,保障质量,测试流程,需求审核这些,半点你专业技能的技术名词都没看到,你猜面试官会怎么想?要么就是培训班填鸭式出来的,要么就是水份太多,哪怕你技术面过去了,面试官也会觉得你只是一个面霸,学过会背,但就是没有用过。

   7. 项目的时间起止,这个是很重要的一环,大部分项目的时间其实我猜你都记不清了对吧?记住一点,记不清就参考工作时间来写,千万别凭记忆瞎写,一旦工作经历的时间和项目经验时间对不上,那就出假了...比如你工作经历是2015.9-2016.4 , 下一家是2016.6-2018.2 。这期中,你在2016.5月是完全空白窗口期,结果你的某个项目经验却写着 2015.9-2016.9 。那请问你这个项目是一直做到了下一家公司了???如果是技术项目比如某测试平台还说得过去(但换了公司也要重搭建重起名才行),但可惜大部分同学的项目经验就是普通的业务项目,所以时间上一定别弄错,但是这个检查起来太麻烦了,所以才有了咱们这个自动优化平台,我会计算各个工作经历的时间段,然后分析项目经验的时间中不合理的地方给你提出。

   好!以上,就是目前的进度和即将开工的部分,欢迎小伙伴持续关注该平台。该平台的算法量已经达到了惊人的440行!在AI大模型只会说假大空的官方废话的背景下,这种精密的符合我们测试圈的细节优化才是王道。

   好,长篇大论结束,开码!

   提前进群哦!平台完成后,会先开启内测,用各种各样的简历来丰富算法矩阵,群里小伙伴才可以随便内测哦。

相关文章
|
XML 存储 JSON
从零开始学习 RPC 与 Protobuf
在数据密集型应用领域,Google 开发的 Protobuf 作为一种高效数据编码方式而广受欢迎。它胜任于 JSON 及 XML 对比,不仅在体积和速度上表现出色,而且其结构化方式优化了网络传输中的性能。简而言之,Protobuf 是将复杂数据结构编码成二进制流的手段,并能够轻松将这些流再还原回原始数据格式。
|
数据采集 机器学习/深度学习 人工智能
AI时代的流量博弈:代理IP如何赋能智能应用突围
在AI时代,流量获取成为互联网发展的关键挑战。本文探讨代理IP技术如何助力AI应用突破流量困境。从身份伪装、地域突破到并发采集,代理IP为数据收集与智能应用提供支持。同时,文章分析不同类型代理IP的特点及应用场景,并强调合规使用的重要性。未来,边缘计算和AI将与代理IP深度融合,推动更高效的数据流通模式,助力AI应用实现增长突破。
421 7
AI时代的流量博弈:代理IP如何赋能智能应用突围
|
7月前
|
存储 运维 安全
实测分享|洛杉矶物理服务器怎么选?优势+避坑全攻略
各位做跨境业务、海外部署的朋友,今天来分享一波洛杉矶物理服务器的实测体验和选购心得!接触海外服务器也有两三年了,试过不少地区的节点,最终还是把主力部署在洛杉矶,总结了一些干货,不管是新手还是老鸟,应该都能用上,全程无多余废话,纯实用分享~
|
人工智能 自然语言处理 运维
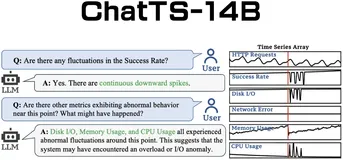
让AI读懂K线图!ChatTS-14B:字节开源的时间序列理解和推理大模型,自然语言提问秒解趋势密码!
ChatTS-14B是字节跳动开源的时间序列专用大模型,基于Qwen2.5-14B微调优化,通过合成数据对齐技术显著提升分析能力,支持自然语言交互完成预测推理等复杂任务。
3581 1
让AI读懂K线图!ChatTS-14B:字节开源的时间序列理解和推理大模型,自然语言提问秒解趋势密码!
|
存储 人工智能 自然语言处理
方案介绍|基于百炼生成向量数据并使用阿里云Milvus存储和检索
阿⾥云Milvus是⼀款云上全托管服务,提供⼤规模向量数据的相似性检索服务。100%兼容开源Milvus,在开源版本的基础上增强了可扩展性,具备易⽤性、可⽤性、安全性、低成本与⽣态优势。阿⾥云Milvus可以⽀持⼏乎所有涉及到向量搜索的场景。例如检索增强⽣成RAG,以及经典的搜索推荐、多模态检索等。阿里云Milvus可存储百炼产生的向量数据,并进行大规模向量数据的检索。本文将重点介绍这一过程的方案。
1672 2
|
机器学习/深度学习 人工智能 算法
|
存储 安全 网络安全
|
机器学习/深度学习 前端开发 API
python3如何使用QT编写基础的对话框程序
Qt与Python结合形成了PyQt/PySide,为桌面应用开发提供强大支持。通过简单安装PyQt5或PySide6,开发者可快速搭建跨平台GUI应用。本文从创建基础对话框入手,介绍布局管理、信号与槽机制、对话框模式及样式表美化等核心功能,并探讨模态窗口、事件驱动编程和资源打包等内容。最后,引导读者探索模型视图架构、多线程处理等进阶技术,逐步掌握用Python+Qt开发高效桌面应用的技能。
515 0
|
文字识别 Serverless 开发工具
【全自动改PDF名】批量OCR识别提取PDF自定义指定区域内容保存到 Excel 以及根据PDF文件内容的标题来批量重命名
学校和教育机构常需处理成绩单、报名表等PDF文件。通过OCR技术,可自动提取学生信息并录入Excel,便于统计分析和存档管理。本文介绍使用阿里云服务实现批量OCR识别、内容提取、重命名及导出表格的完整步骤,包括开通相关服务、编写代码、部署函数计算和设置自动化触发器等。提供Python示例代码和详细操作指南,帮助用户高效处理PDF文件。 链接: - 百度网盘:[链接](https://pan.baidu.com/s/1mWsg7mDZq2pZ8xdKzdn5Hg?pwd=8866) - 腾讯网盘:[链接](https://share.weiyun.com/a77jklXK)
3171 5
|
SQL 安全 数据库
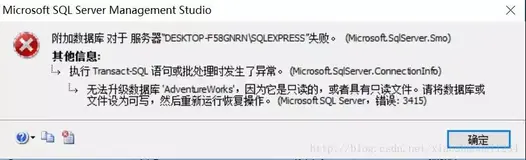
故障解决:SQL Server数据库附加失败,错误3415、错误5120
本文为大家分享了SQL Server数据库附加失败的具体解决方法,供大家参考,具体内容如下
故障解决:SQL Server数据库附加失败,错误3415、错误5120