部署Stable Diffusion玩转AI绘画(GPU云服务器)
1. 实验资源方式简介及开始实验
云起实验室实验资源方式介绍
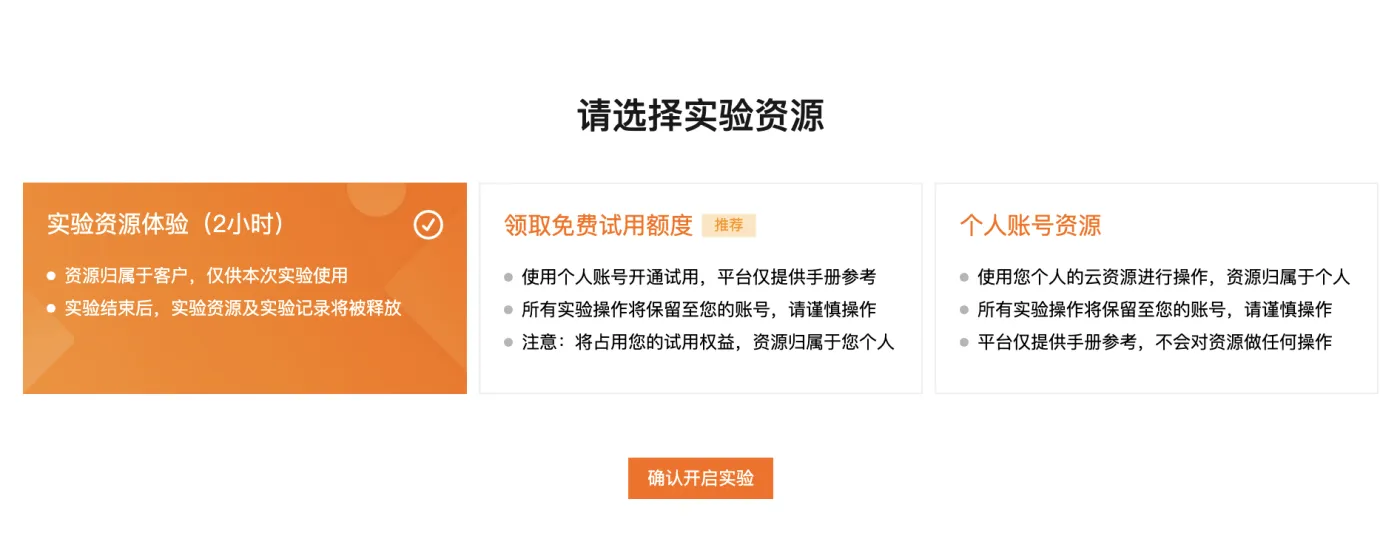
云起实验室支持实验资源体验、领取免费试用额度、个人账户资源三种实验资源方式。
- 实验资源体验
- 资源归属于客户,仅供本次实验使用
- 实验结束后,实验资源及实验记录将被释放。
- 资源创建过程需要3~5分钟(视资源不同开通时间有所差异,ACK等资源开通时间较长)。完成实验资源的创建后,在实验室页面左侧导航栏中,单击云产品资源列表,可查看本次实验资源相关信息(例如子用户名称、子用户密码、AK ID、AK Secret、资源中的项目名称等)。
- 说明:实验环境一旦开始创建则进入计时阶段,建议学员先基本了解实验具体的步骤、目的,真正开始做实验时再进行创建。

- 领取免费试用额度
- 使用个人账号开通试用,平台仅提供手册参考。
- 所有实验操作将保留至您的账号,请谨慎操作。
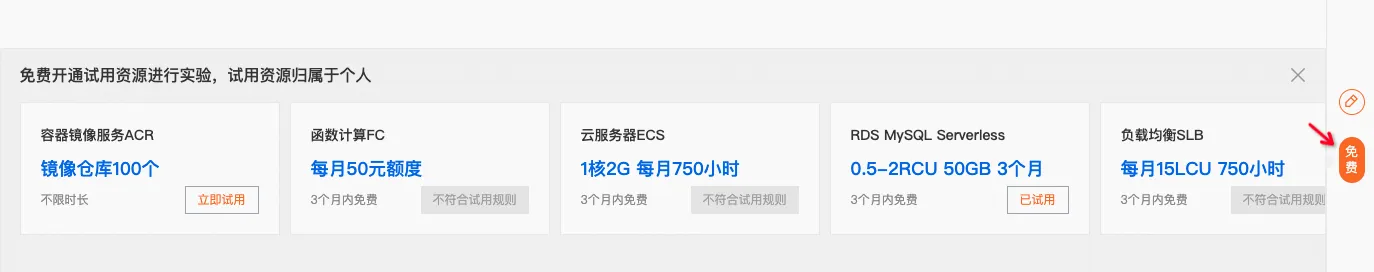
- 在实验页面下方卡片会展示本实验支持的试用规格,可以选择你要试用的云产品资源进行开通。您在实验过程中,可以随时用右下角icon唤起试用卡片。阿里云支持试用的产品列表、权益及具体规则说明请参考开发者试用中心。
- 说明:试用云产品开通在您的个人账号下,并占用您的试用权益。如试用超出免费试用额度,可能会产生一定费用。
- 个人账户资源
- 使用您个人的云资源进行操作,资源归属于个人。
- 所有实验操作将保留至您的账号,请谨慎操作。
- 平台仅提供手册参考,不会对资源做任何操作。
- 说明:使用个人账户资源,在创建资源时,可能会产生一定的费用,请您及时关注相关云产品资源的计费概述。
准备开始实验
在实验开始前,请您选择其中一种实验资源,单击确认开启实验。
说明:每个实验所支持的实验资源方式都不相同,实验不一定能满足有三种实验资源方式,请根据实验的实际情况,进行选择。
2. 安装 Stable Diffusion WebUI
Stable Diffusion 是一个 Python 命令行程序,我们直接使用需要对它的命令和参数有详尽的了解,有一定学习成本。好在,有一个 Stable Diffusion WebUI 的开源项目,可以直接将 Stable Diffusion 的操作通过网页透出,让我们轻松通过 Web 页面就能使用 Stable Diffusion 生成图片。所以,我们选择安装和使用 Stable Diffusion WebUI 来完成实验。
- 安装基础工具。
Stable Diffusion WebUI 的安装与运行需要使用到一些工具软件,我们需要先通过 Yum 安装它们。
sudo yum install -y git conda mesa-libGL zlib-devel libjpeg-turbo-devel
初始化Conda:
conda init bash
. ~/.bashrc
- 利用Conda创建Python虚拟环境。
这里我们采用官方推荐的Python版本3.10.6:
conda create -y --name py310 python=3.10.6
激活Python3.10.6(重要):
conda activate py310
- 拉取 Stable Diffusion WebUI 代码。
接着,我们从 Github 上获取最新的 Stable Diffusion WebUI 代码。
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui.git
说明:由于 Github 访问存在不稳定性,可能需要多试几次。
项目下载完成后,我们将 Web Terminal 的操作目录设置为项目所在目录。
cd stable-diffusion-webui
- 安装项目依赖。
Stable Diffusion 的运行还依赖于需要 Python 包,我们可以通过 PIP 将它们全部准备就绪。
提醒:优于torch体积比较大,以及其他依赖库较多,这里可能需要3~5分钟,具体时长视使用时候的网络连接情况。
pip install torch torchvision torchaudio --extra-index-url https://download.pytorch.org/whl/cu117
pip install cython opencv-python-headless gfpgan open-clip-torch xformers pyngrok clip-anytorch
pip install -r requirements_versions.txt
- 启动 Stable Diffusion WebUI。
当一切准备就绪,我们可以使用以下命令启动 Stable Diffusion WebUI。
python launch.py --listen
在启动时,Stable Diffusion WebUI 会根据需要下载一些必要模型数据,另外,加载模型也需要花费一些时间,所以我们现在要做的就是耐心等待。当 Terminal 中显示出 Running on local URL: http://0.0.0.0:7860字样,就表示程序已经启动并对外提供服务了。
3. 使用 Stable Diffusion WebUI 生成图片
- 获得Stable Diffusion WebUI 访问地址。
当Stable Diffusion WebUI启动后,会对外监听7860端口。我们需要使用http://(ECS公网地址):7860来访问程序。这里的ECS公网地址需要替换成实验室为大家分配的可以访问 ECS 的公网 IP 地址。我们可以在实验室页面左侧导航栏中,点击云产品资源列表查看本次实验资源所分配的 ECS 公网地址。

另外,你还可以使用 Web Terminal 右上角的 + 号新建一个 Terminal 标签页,并在其中执行以下命令直接获得 Stable Diffusion WebUI 的访问地址。

echo "http://"$(curl -s ifconfig.me)":7860/"

- 访问Stable Diffusion WebUI。
接着,让我们打开浏览器,输出刚刚获得的访问地址,就可以进入 Stable Diffusion WebUI 的操作界面了。

- 使用文字生成图片。
生成图片的操作方式非常简单,只需要在左侧的 Prompt 输出框中填入提示词,之后点击右侧的 Generate 按钮即可。提示词就是生成图片的依据,既可以是描述需要生成内容的词,如:girl, sunset, forest 等;也可以是用于是描述图像属性的词,如:best quality, beautiful, masterpiece 等。我们甚至可以通过提示词选择图片生成的视角、光线、画风;人物的姿势、着装、表情;背景的内容等。

图片生成的速度根据机器配置的不同有所差异。在图片生成的过程中,我们可以在页面上看到生成过程的中间图片逐渐变得清晰。同时,也可以通过进度条直观的了解图片生成的进度和预估剩余时间。

4. 学习使用 LoRA 模型
除了使用基础模型生成图片外,我们还可以使用 LoRA 模型(Low-Rank Adaptation of Large Language Models)进行图片的生成。LoRA 直译为大语言模型的低阶适应,这是微软的研究人员为了解决大语言模型微调而开发的一项技术。LoRA 能够冻结预训练好的模型权重参数,然后在每个 Transformer 块里注入可训练的层,由于不需要对模型的权重参数重新计算梯度,从而大大减少了需要训练的计算量。从实际效果来说,LoRA 模型可以帮助我们生成指定风格、面孔、动作等要求的图片。
- 使用LoRA模型。
打开WebUI界面,单击Generate下方的扩展配置图标,之后选择Lora标签,就能看到我们可以使用的LoRA模型了。

在实验场景中,已经准备了数个比较热门的 LoRA 模型,你可以尝试使用它们生成不同风格的图片。

当我们点击某个LoRA模型后,Prompt中会加入<lora:模型名的格式:数字>这些内容。最后的数字代表着LoRA模型的权重,默认为1。接着,我们输入提示词,再单击Generate按钮,就可以使用LoRA模型将文字转化为图片了。

- 获得更多的LoRA模型。
如果觉得现有的 LoRA 模型还不符合自己的审美,我们可以从Civitai https://civitai.com/tag/lora等网站里找到许多其他爱好者预先训练好的LoRA 模型,我们只需要将这些模型下载到stable-diffusion-webui/models/Lora目录内(在本实验中,需要放置在/root/models/Lora目录内),接着我们就可以在Stable Diffusion WebUI 中使用它们。如果是新下载的模型没有出现在页面上,可以单击Refresh重新载入它们。
实验链接:https://developer.aliyun.com/adc/scenario/f4c01f9be9224611b35197d545923fda