一、前言
现在我们越来越明显的感受到,当下的大模型技术已经彻底改变了AI应用的开发模式,从最初简单的单轮问答、文本生成,逐步走向多步骤、多模型联动、带状态流转的复杂智能业务场景。我们日常用到的AI智能体、知识库问答、自动化办公、智能客服、代码生成流水线等应用,背后都离不开工作流编排这项核心技术。
随着大模型业务接触的越深,越是了解到:单一大模型API调用只能完成简单任务,面对多步骤推理、条件分支判断、任务依赖约束、异常重试、状态持久化的复杂场景,完全无法支撑。比如智能体需要先检索知识库、再归纳信息、最后生成答案,失败后还要重试,不同结果触发不同后续任务,这种链式、分支式的任务调度,单纯靠代码硬写会极度冗余、难以维护,且无法快速迭代。而工作流编排就是解决这一问题的核心方案,目前行业主流分为两大核心范式:DAG有向无环图编排和State Machine状态机编排。二者各有适配场景,也是大模型智能体、AI流水线、业务自动化系统的底层核心骨架。
二、工作流编排概述
1. 工作流编排核心定义
工作流编排,简单来说就是将多个独立任务,按照预设的规则、依赖关系、条件逻辑,自动调度、有序执行、全程管控的任务管理体系。在大模型工程化场景中,单个任务可以是大模型推理、向量库检索、接口调用、数据清洗、文件解析、结果校验等任意单一原子操作。
在实际生活中,制作一杯定制奶茶,需要经过点单、备料、煮茶、加配料、封口、出杯多个步骤,部分步骤有先后顺序,必须先煮茶再加料,部分步骤可并行,备料和煮茶可同时进行,部分步骤有条件分支,用户要冰饮则加冰,热饮则跳过。这一整套标准化、可复用、可管控的流程,就是工作流,而规划这套流程的过程就是编排。
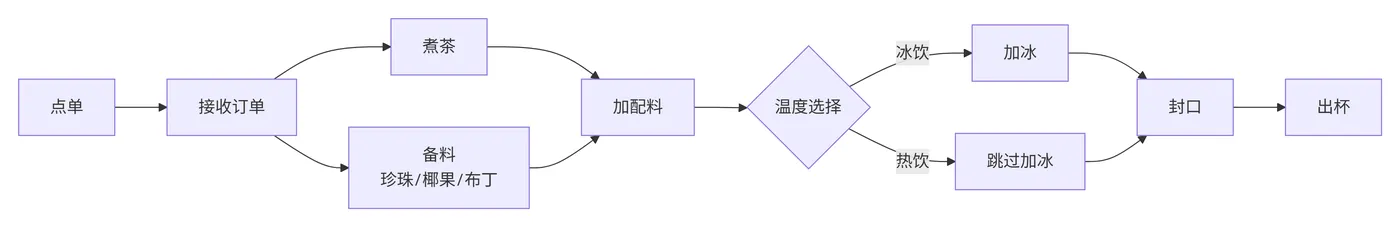
流程步骤说明:
| 步骤 | 节点类型 | 说明 |
| 点单 → 接收订单 | 顺序 | 用户点单,前台接收订单 |
| 备料 + 煮茶 | 并行 | 两者互不依赖,可同时进行,节省时间 |
| 加配料 | 顺序 | 必须先等煮茶完成和备料完成,才能加料 |
| 温度判断 | 条件分支 | 冰饮→加冰;热饮→跳过加冰 |
| 封口 → 出杯 | 顺序 | 所有步骤完成后封口出杯 |
工作流三要素体现:
- 顺序依赖:煮茶→加配料(先煮茶,再加料)
- 并行能力:备料∥煮茶(可同时进行)
- 条件分支:冰饮→加冰;热饮→跳过加冰
业务流程与工作流映射:
| 对比维度 | 描述 |
| 组成单元 | 每个步骤(点单、煮茶、加料)对应工作流中的节点 |
| 规则管控 | 步骤间的依赖关系(先后顺序)和条件规则(温度选择) |
| 复用价值 | 标准化流程可复制到任何奶茶店使用 |
| 编排价值 | 并行节点可提升整体效率,体现编排的核心价值 |
大模型场景映射:搭建一个智能写作助手
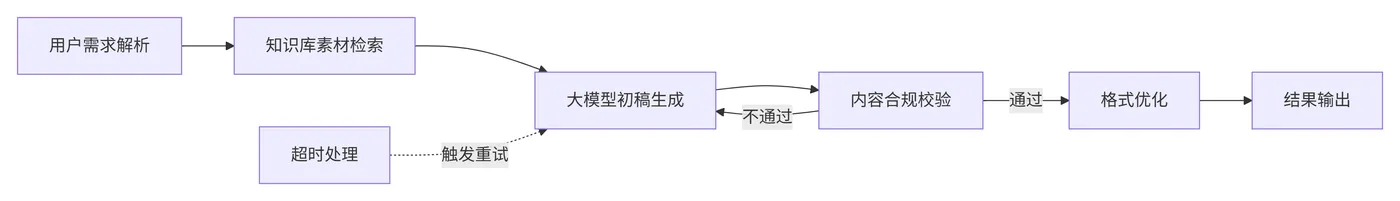
需要完成”用户需求解析→知识库素材检索→大模型初稿生成→内容合规校验→格式优化→结果输出“,同时合规校验不通过则返回重写,超时则触发重试,这整套AI任务的调度管控,就是大模型工作流编排。
2. 大模型引入编排的价值
在没有工作流编排的阶段,大模型应用开发大多是"硬编码串联",所有任务顺序、分支逻辑、重试规则全部写死在代码中,这种模式仅适用于简单应用项目,落地生产会暴露大量问题。而引入DAG、状态机工作流编排后,能从根本上解决大模型工程化的核心痛点,核心价值:
- 解耦业务与逻辑:将零散的AI原子任务从硬代码中抽离,流程规则可视化、配置化,修改业务流程无需改动核心代码,大幅提升迭代效率。
- 支撑复杂任务:完美适配多分支、多依赖、并行执行、循环重试、异常降级的复杂大模型场景,突破单轮API调用的能力局限。
- 全程可观测可管控:工作流会记录每一步任务的执行状态、耗时、报错信息,解决大模型任务黑盒问题,便于排查线上故障、优化流程效率。
- 高复用可拓展:编排好的流程模板可重复复用,新增AI任务、调整流程逻辑只需微调配置,适配智能体、流水线、自动化业务等多类场景。
3. 两大核心编排范式
两大范式概述:
- 目前大模型生态中,所有工作流编排框架都基于两种基础模型衍生:DAG有向无环图和State Machine状态机。
- 二者的核心逻辑、执行机制、适配场景截然不同,也是本文的核心讲解重点。
核心差异概括:
- DAG侧重任务依赖与执行顺序,适合流程固定、无循环、步骤清晰的流水线式任务;
- 状态机侧重状态流转与条件驱动,适合动态分支、可回滚、可循环、逻辑复杂的智能交互任务。
三、DAG工作流编排
1. DAG核心基础概念
DAG的全称是Directed Acyclic Graph,即有向无环图,是一种经典的图数据结构,也是流水线式工作流的核心底层。我们可以拆分关键词通俗理解:有向代表任务有明确的执行方向,无环代表整个流程不存在闭环、不会出现无限循环执行的情况,图代表由多个节点和连线组成的整体结构。
在DAG工作流编排体系中,有两个核心元素:节点和边
- 节点就是我们的原子任务,比如大模型文本生成、向量检索、数据过滤、接口请求等;
- 边就是任务之间的依赖关系和执行顺序,定义了A任务执行完成后,才能执行B任务,或是A、B任务可并行执行。
DAG最核心的特性是依赖驱动、顺序固定、无循环、一次性执行:
- 整个流程的拓扑结构是提前固定的,执行前就明确所有任务的先后、并行关系;
- 运行过程中不会动态新增流程、不会回滚历史步骤、不会循环执行;
- 流程从起始节点开始,逐级执行所有节点,最终抵达结束节点,流程终止。
举一个极简的大模型DAG流程示例:
AI文章生成流水线,整个流程固定为4个节点,依次单向执行,无分支、无循环,四个节点通过单向边连接,构成完整DAG工作流:

- 节点1:接收用户写作需求;
- 节点2:检索行业知识库获取素材;
- 节点3:调用大模型生成完整文章;
- 节点4:输出并保存文章结果。
2. DAG核心执行原理
DAG工作流的执行核心是拓扑排序,这是DAG能够有序执行的核心算法。拓扑排序的核心逻辑非常简单:在所有任务节点中,始终优先执行”无前置依赖、前置任务全部执行完成“的节点,直到所有节点执行完毕。
结合大模型场景拆解执行步骤,以”AI图文内容生成DAG流程“为例,流程包含5个原子任务,依赖关系清晰:
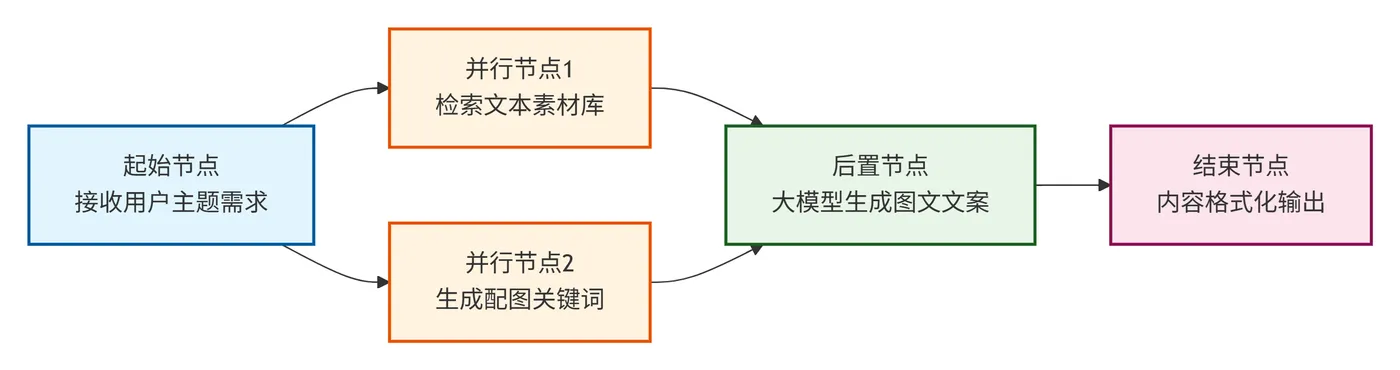
- 1. 起始节点:接收用户主题需求(无前置依赖,优先执行);
- 2. 并行节点1:检索文本素材库;
- 3. 并行节点2:生成配图关键词(以上两个节点均依赖起始节点,可同时并行执行,提升效率);
- 4. 后置节点:大模型生成图文文案(依赖两个并行素材节点,全部完成后才可执行);
- 5. 结束节点:内容格式化输出(依赖文案生成节点)。
整个执行过程完全遵循拓扑排序规则,不会出现任务乱序、漏执行的情况。同时DAG支持多级并行、串行混合编排,能够最大化利用算力资源,缩短大模型批量任务的执行耗时。
除此之外,DAG具备天然的断点续执行能力。在大模型批量处理场景中,若某一个节点(如大模型生成文案)因接口超时、资源不足执行失败,只需重新执行该失败节点及后续依赖节点,无需从头执行整个流程,大幅节省资源、提升任务容错性。
3. DAG大模型应用实践
我们搭建一个可直接落地的”大模型知识库问答DAG工作流“,完整流程包含6个节点,覆盖检索增强生成(RAG)核心全流程,适配企业知识库问答、智能答疑场景。

- 节点1:输入清洗:用户输入问题,接收并清洗文本,去除无效符号、冗余字符,标准化输入内容;
- 节点2:文本向量化:调用嵌入模型将用户问题转为向量,为检索做准备;
- 节点3:向量库检索:根据问题向量,从企业知识库中匹配相似度最高的TOP5文档片段;
- 节点4:上下文拼接:将用户问题与检索到的知识库素材拼接为完整Prompt;
- 节点5:大模型推理:调用LLM根据Prompt生成精准回答;
- 节点6:结果输出:整理回答格式,返回给用户,流程结束。
该DAG流程为纯串行+固定依赖结构,无分支、无循环,完全适配DAG的执行特性。所有任务步骤提前固定,执行逻辑清晰、可维护性极高,是目前RAG系统、AI批量生成任务最常用的编排方式。
Python极简DAG代码示例:
RAG知识库问答流水线,纯原生Python,无需额外安装依赖,演示拓扑依赖调度核心思想,主要实现拓扑驱动DAG调度。节点之间声明依赖关系,调度器自动寻找就绪节点执行。适合RAG、批量文本处理这类流程固定、无循环场景。生产环境Airflow、Prefect本质就是这套逻辑的增强版本,增加持久化、分布式调度、监控能力。
from typing import Dict, Any, List
# 简易DAG调度器,基于拓扑排序实现
class SimpleDAG:
    def __init__(self):
        self.nodes = {}  # 节点名称:执行函数
        self.deps = {}   # 节点依赖关系 {node: [前置节点]}
    def add_node(self, name: str, func, depends: List[str] = None):
        self.nodes[name] = func
        self.deps[name] = depends or []
    def run(self, input_data: Any) -> Dict[str, Any]:
        result_cache = {}
        remaining = set(self.nodes.keys())
        while remaining:
            ready_nodes = [
                n for n in remaining
                if all(p in result_cache for p in self.deps[n])
            ]
            if not ready_nodes:
                raise RuntimeError("DAG存在环,无法执行")
            for node in ready_nodes:
                func = self.nodes[node]
                dep_args = [result_cache[p] for p in self.deps[node]]
                if len(dep_args) == 0:
                    res = func(input_data)
                else:
                    res = func(*dep_args)
                result_cache[node] = res
                remaining.remove(node)
        return result_cache
# ========== 定义RAG各个原子节点 ==========
def clean_input(raw_text: str) -> str:
    """节点1:清洗用户输入"""
    return raw_text.strip().replace("\n", " ")
def mock_embedding(text: str) -> List[float]:
    """节点2:模拟Embedding向量化"""
    return [hash(text) % 100 / 100.0 for _ in range(4)]
def mock_vector_search(vec: List[float]) -> List[str]:
    """节点3:模拟向量库检索,返回参考文档片段"""
    return [
        "文档片段1:大模型RAG通过向量检索获取外部知识",
        "文档片段2:DAG适合固定流水线任务,无循环分支"
    ]
def build_prompt(question: str, docs: List[str]) -> str:
    """节点4:拼接Prompt上下文"""
    context = "\n".join(docs)
    prompt = f"""参考下面文档回答用户问题:
{context}
用户提问:{question}
回答:"""
    return prompt
def mock_llm_infer(prompt: str) -> str:
    """节点5:模拟大模型推理"""
    return "RAG系统会先将问题向量化,检索知识库文档,再交给大模型生成答案,整个流程适合DAG编排。"
def format_output(ans: str) -> str:
    """节点6:格式化最终输出"""
    return f"【AI回答】\n{ans}"
# ========== 组装DAG并运行 ==========
if __name__ == "__main__":
    dag = SimpleDAG()
    dag.add_node("clean", clean_input)
    dag.add_node("embed", mock_embedding, depends=["clean"])
    dag.add_node("search", mock_vector_search, depends=["embed"])
    dag.add_node("prompt_build", build_prompt, depends=["clean", "search"])
    dag.add_node("llm", mock_llm_infer, depends=["prompt_build"])
    dag.add_node("output", format_output, depends=["llm"])
    result = dag.run("DAG适合哪些大模型场景?")
    print(result["output"])

运行输出:
【AI回答】
RAG系统会先将问题向量化,检索知识库文档,再交给大模型生成答案,整个流程适合DAG编排。
4. DAG适配场景说明
结合原理与实战,总结DAG工作流的核心优势:
- 结构简单清晰:拓扑逻辑可视化,新手极易上手,无需复杂状态管理;
- 执行效率高:支持任务并行调度,最大化利用大模型算力;
- 可追溯、可重试:单节点故障不影响整体流程架构,容错成本低;
- 配置化程度高:流程模板可快速复用,适配批量标准化AI任务。
DAG的核心局限性也十分明显:不支持循环、不支持动态分支、无法根据实时执行结果调整流程,流程拓扑结构固化,灵活性不足。
因此DAG专属适配流程固定、步骤标准化、无动态逻辑、无循环交互的大模型场景,典型场景包括:RAG检索增强流水线、AI批量文本处理、内容生成流水线、数据清洗+模型推理自动化、离线AI任务调度等。
四、状态机工作流编排
1. 状态机核心基础概念
状态机,State Machine,全称有限状态机,是一种状态驱动、事件触发、动态流转的编排模型,和DAG的固定流程逻辑完全相反。状态机的核心不是"任务顺序",而是"状态变化",整个工作流的运行过程,本质就是状态不断切换、流转的过程。
状态机包含四大核心要素,也是理解其原理的关键:有限状态、触发事件、流转规则、初始/终止状态:
- 有限状态指整个流程只会存在预设的几种固定状态,不会无限新增;
- 触发事件是驱动状态变化的诱因,比如大模型返回结果、用户输入、接口回调、超时异常等;
- 流转规则是定义”当前状态+触发事件=下一状态“的核心逻辑。
通俗举例理解大模型场景的状态机:
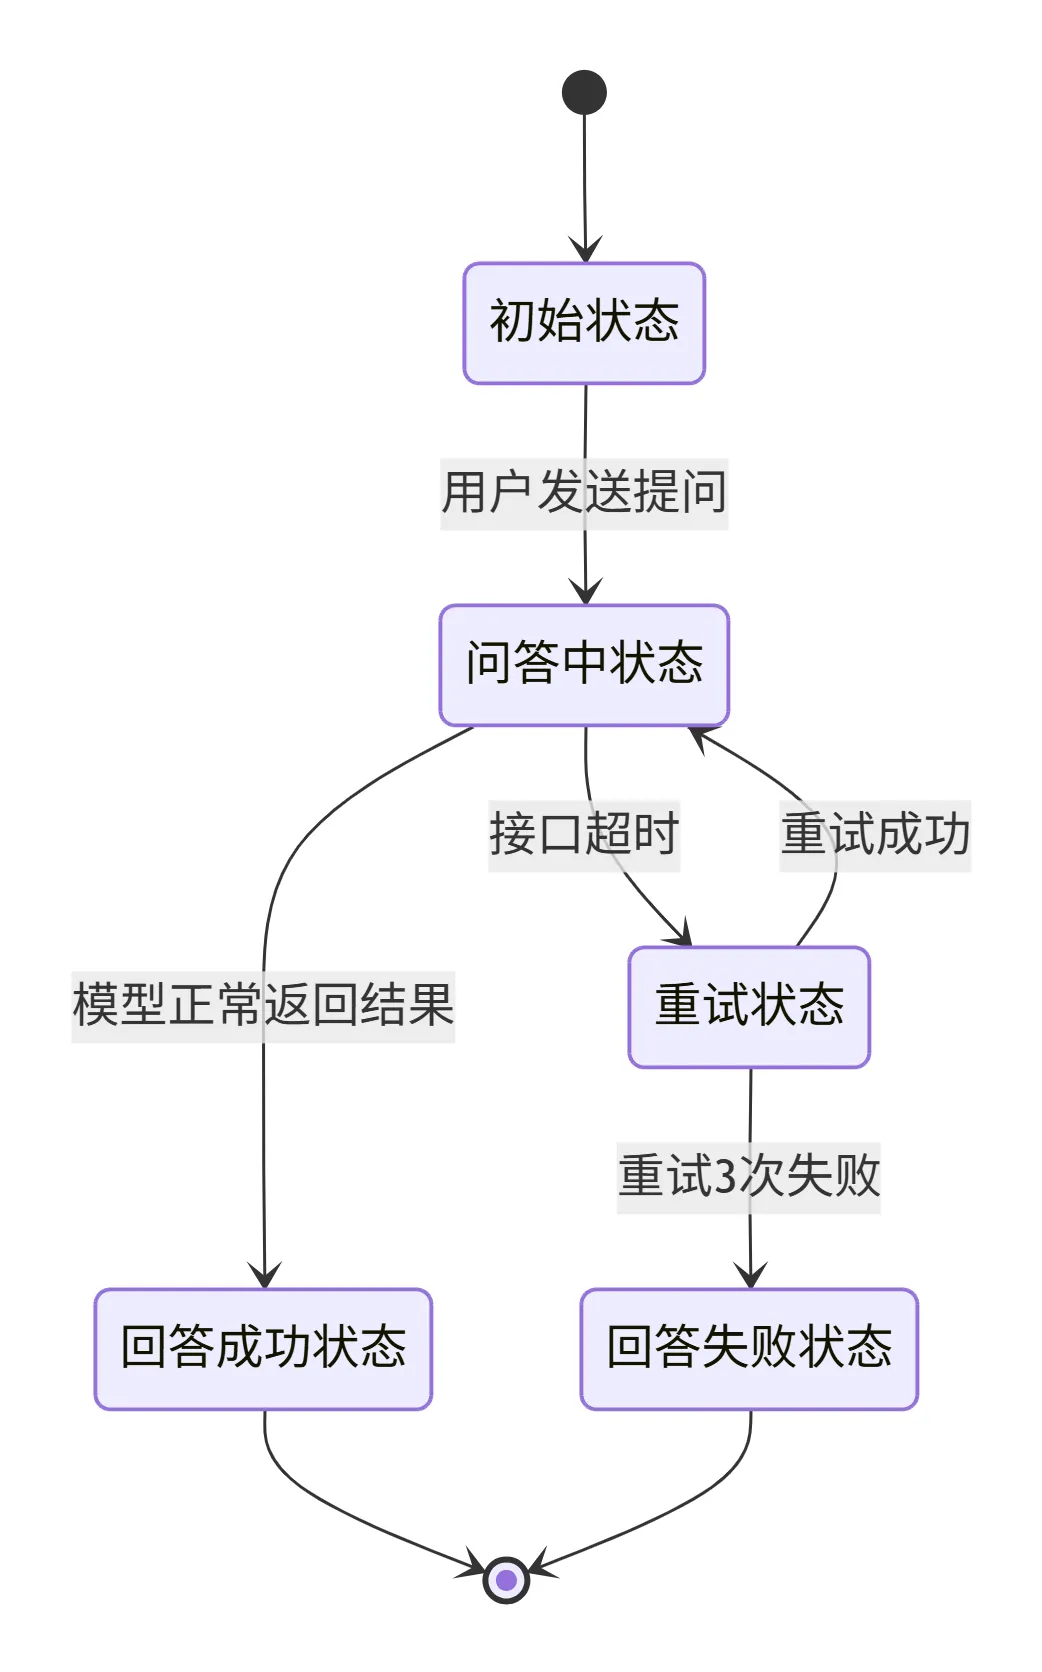
AI智能对话机器人,流程存在初始状态、问答中状态、回答成功状态、回答失败状态、重试状态、对话结束状态:
- 当用户发送提问(触发事件),初始状态流转为问答中状态;
- 若大模型正常返回结果,流转为成功状态并结束;
- 若接口超时,触发重试事件,流转为重试状态;
- 重试3次失败,流转为失败状态并终止流程。
和DAG无环、固定流程不同,状态机支持循环、支持动态分支、支持回滚、支持中断恢复,流程走向完全由实时执行结果和外部事件决定,灵活性拉满,专门适配复杂、动态、有交互的大模型智能体场景。
2. 状态机核心执行原理
状态机的核心执行逻辑是”状态常驻、事件驱动、按需流转“。DAG是任务驱动,执行完所有任务流程就结束;而状态机是状态常驻,流程启动后会持续等待触发事件,根据事件动态切换状态,直到抵达预设的终止状态。
我们以大模型智能体任务执行为例,拆解完整流转逻辑:
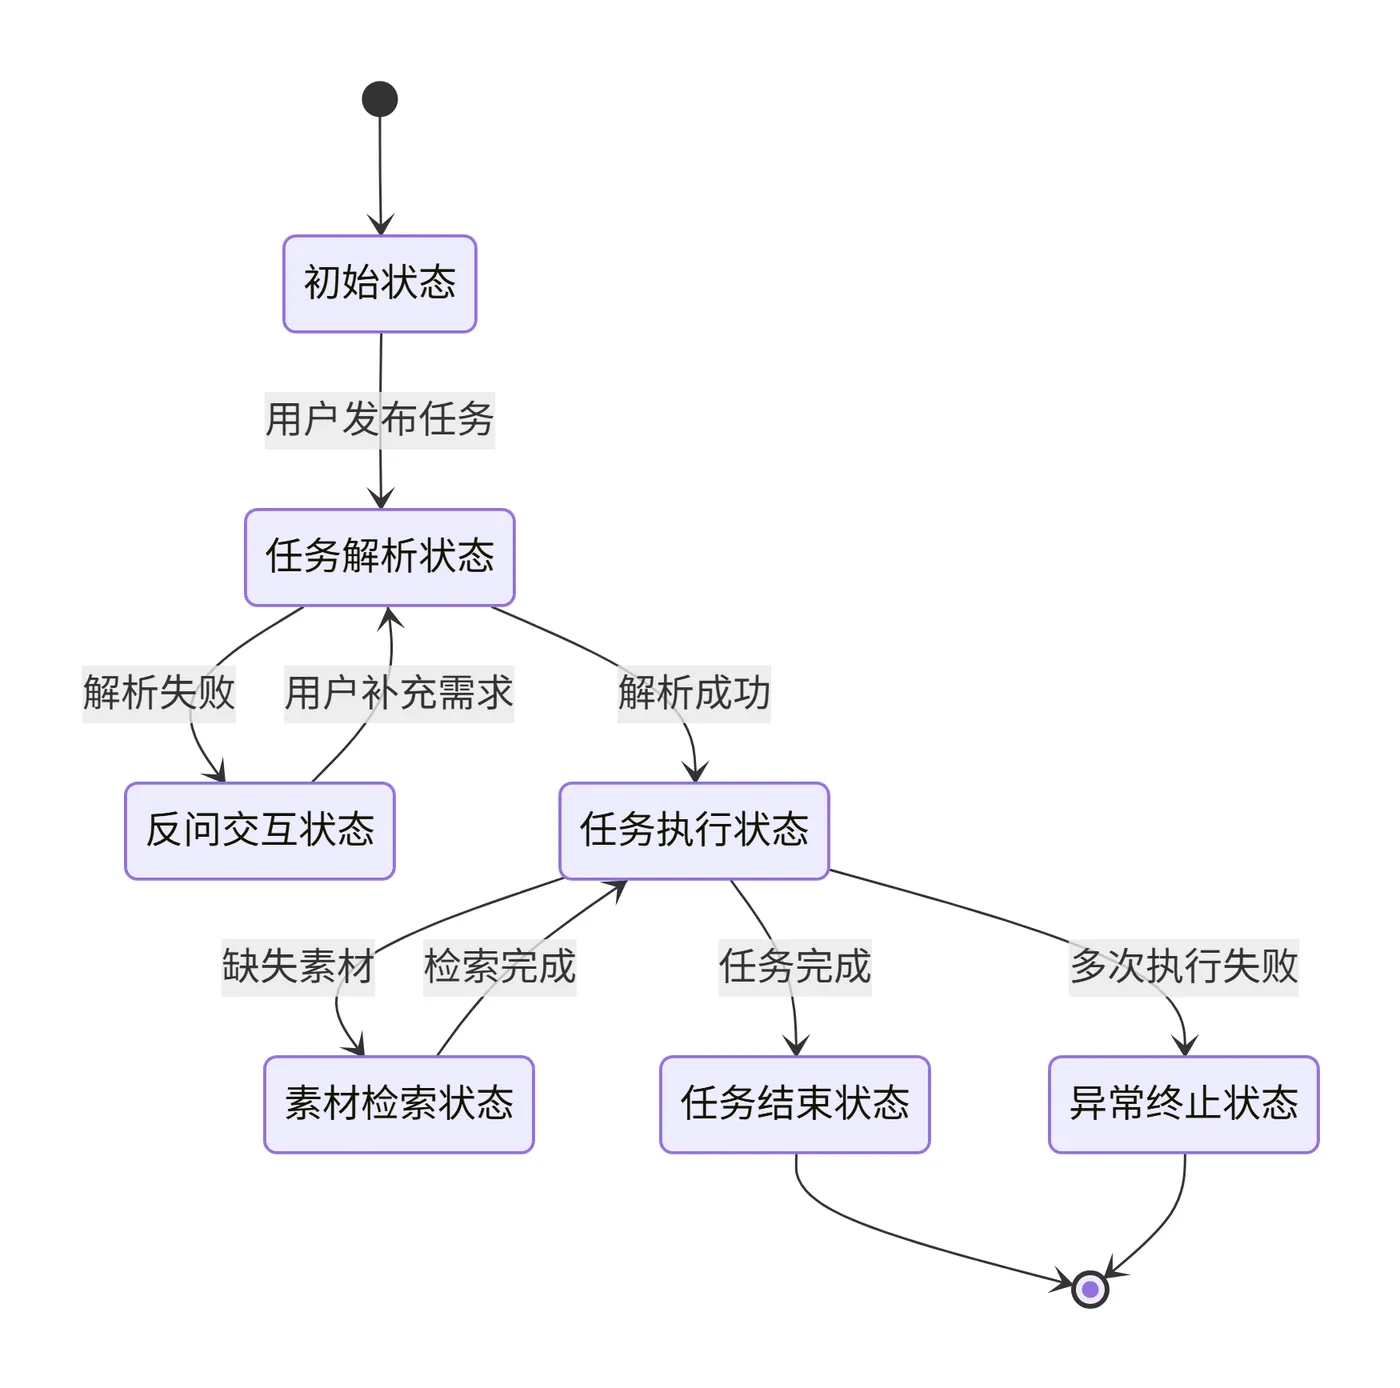
- 初始状态:智能体就绪,等待用户下达任务指令,无任何任务执行;
- 触发事件:用户发布"整理文档并生成总结"任务,触发任务启动事件;
- 状态流转:从就绪状态切换为“任务解析状态”,调用大模型解析任务需求;
- 分支判断:若任务解析不清晰(事件:解析失败),流转为“反问交互状态”,向用户确认需求;若解析成功(事件:解析成功),流转为“任务执行状态”;
- 循环逻辑:任务执行中若缺失素材,流转为“素材检索状态”,检索完成后重新回到执行状态,形成闭环循环;
- 终止逻辑:任务完成后,流转为“任务结束状态”,流程终止;若多次执行失败,流转为“异常终止状态”。
整个过程没有固定的执行步骤,每一步的走向都由实时事件和当前状态决定,支持无限循环、多层分支、人机交互、异常回滚,这也是智能体能够自主思考、迭代执行复杂任务的核心原因。
同时状态机具备极强的状态持久化能力,流程中断后可精准恢复断点状态。比如智能体执行任务中途服务重启,重启后可直接回到中断前的状态,继续执行任务,无需重新开始,这是DAG无法实现的核心能力。
3. 状态机大模型应用实践
我们搭建一个可落地的“大模型智能问答状态机工作流”,适配在线智能客服、人机交互问答场景,包含完整状态、事件、流转分支,覆盖重试、反问、成功、失败全场景。
预设核心状态:
- 初始就绪状态、问题解析状态、答案生成状态、结果校验状态、用户反问状态、任务重试状态、成功结束状态、异常终止状态。
完整流转流程:
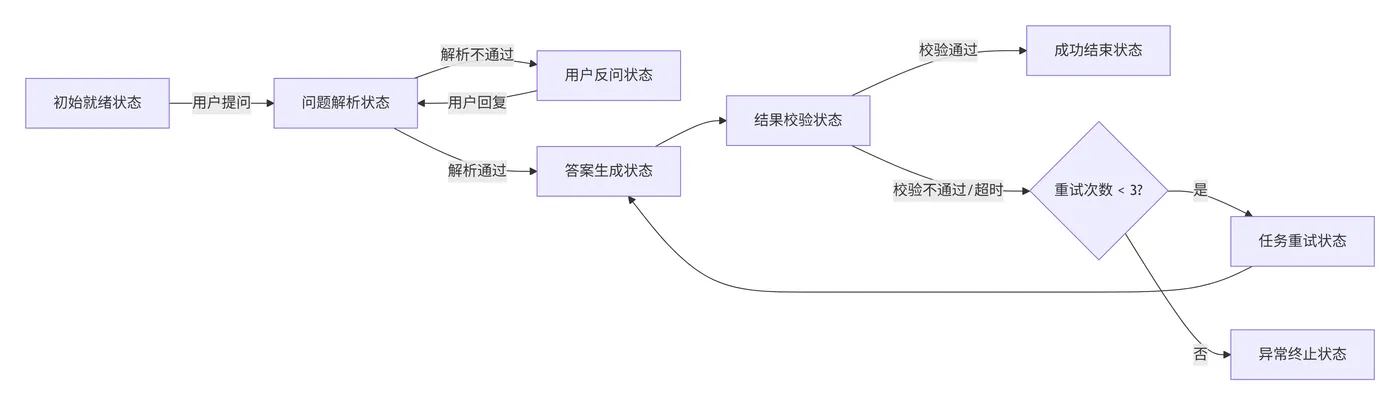
- 1. 初始就绪状态:系统等待用户提问,常驻等待外部事件;
- 2. 触发用户提问事件:流转至问题解析状态,大模型解析用户问题合法性;
- 3. 分支1:问题模糊:信息不全,触发解析不通过事件,流转至用户反问状态,向用户确认需求,等待用户回复后,重新回到问题解析状态(循环流转);
- 4. 分支2:问题合法清晰:触发解析通过事件,流转至答案生成状态,调用大模型生成回答;
- 5. 答案生成后:流转至结果校验状态,校验回答合规性、准确性;
- 6. 分支1:校验通过:流转至成功结束状态,输出答案,流程终止;
- 7. 分支2:校验不通过/接口超时:触发异常事件,判断重试次数,小于3次则流转至任务重试状态,重新生成答案;大于3次则流转至异常终止状态,反馈用户任务失败。
完整体现了状态机的核心优势:动态分支、循环重试、人机交互、异常容错,能够适配所有动态变化的大模型交互场景,也是目前LangGraph等主流框架的底层编排逻辑。
Python极简状态机代码示例:智能问答有限状态机
原生Python,无第三方依赖,演示事件驱动、状态跳转、重试分支逻辑,是极简有限状态机实现,核心就是当前状态+事件驱动状态跳转。支持循环、人机反问、重试分支。LangGraph、Amazon State Machine底层都是这套思想的扩展,增加持久化、断点恢复、复杂流转规则,专门用于智能体多轮动态任务。
from typing import Dict, Optional
# 定义状态枚举
class State:
    INIT = "初始就绪"
    PARSE_QUESTION = "问题解析"
    GEN_ANSWER = "答案生成"
    CHECK_RESULT = "结果校验"
    ASK_USER = "用户反问"
    RETRY = "任务重试"
    SUCCESS = "成功结束"
    FAILED = "异常终止"
class QuestionStateMachine:
    def __init__(self, max_retry: int = 3):
        self.current_state = State.INIT
        self.max_retry = max_retry
        self.retry_count = 0
        self.context: Dict[str, Optional[str]] = {
            "user_question": None,
            "answer": None
        }
    def transition(self, event: str):
        """状态流转核心函数:当前状态 + 事件 => 新状态"""
        print(f"\n【流转】当前状态:{self.current_state},触发事件:{event}")
        if self.current_state == State.INIT:
            if event == "user_input":
                self.current_state = State.PARSE_QUESTION
        elif self.current_state == State.PARSE_QUESTION:
            if event == "question_valid":
                self.current_state = State.GEN_ANSWER
            elif event == "question_vague":
                self.current_state = State.ASK_USER
        elif self.current_state == State.ASK_USER:
            if event == "user_reply":
                self.current_state = State.PARSE_QUESTION
        elif self.current_state == State.GEN_ANSWER:
            if event == "gen_ok":
                self.current_state = State.CHECK_RESULT
            elif event == "gen_error":
                self.current_state = State.RETRY
        elif self.current_state == State.RETRY:
            self.retry_count +=1
            if self.retry_count < self.max_retry:
                self.current_state = State.GEN_ANSWER
            else:
                self.current_state = State.FAILED
        elif self.current_state == State.CHECK_RESULT:
            if event == "check_pass":
                self.current_state = State.SUCCESS
            elif event == "check_reject":
                self.current_state = State.RETRY
        # 终止状态不再流转
        elif self.current_state in [State.SUCCESS, State.FAILED]:
            pass
    def run_logic(self):
        """根据当前状态执行业务逻辑"""
        match self.current_state:
            case State.PARSE_QUESTION:
                q = self.context["user_question"]
                if q and len(q) > 6:
                    return "question_valid"
                else:
                    return "question_vague"
            case State.ASK_USER:
                print("AI:你的问题信息不够,请补充描述。")
                return "user_reply"
            case State.GEN_ANSWER:
                self.context["answer"] = "状态机支持动态分支、循环交互,适合AI智能体"
                return "gen_ok"
            case State.CHECK_RESULT:
                return "check_pass"
            case State.RETRY:
                print(f"任务重试,当前次数:{self.retry_count}")
                return "gen_error"
            case State.SUCCESS:
                print(f"任务成功,输出答案:{self.context['answer']}")
            case State.FAILED:
                print("多次重试失败,任务终止。")
        return ""
# ========== 运行状态机示例 ==========
if __name__ == "__main__":
    sm = QuestionStateMachine(max_retry=3)
    sm.context["user_question"] = "状态机可以做什么?"
    # 驱动状态机循环流转,直到进入终止状态
    while sm.current_state not in [State.SUCCESS, State.FAILED]:
        event = sm.run_logic()
        if event:
            sm.transition(event)

示例输出:
【流转】当前状态:初始就绪,触发事件:user_input
【流转】当前状态:问题解析,触发事件:question_valid
【流转】当前状态:答案生成,触发事件:gen_ok
【流转】当前状态:结果校验,触发事件:check_pass
任务成功,输出答案:状态机支持动态分支、循环交互,适合AI智能体
4. 状态机适配场景说明
通过原理与实战,总结状态机的核心特性:
- 灵活性极强:支持动态分支、循环执行、人机交互、状态回滚,适配复杂智能任务;
- 状态可持久化:支持断点续跑、异常恢复,线上稳定性更高;
- 容错逻辑完善:可自定义重试、降级、兜底规则,适配不确定性高的大模型场景;
- 流程动态可调整:可根据实时执行结果自适应调整后续任务。
状态机的短板也较为突出:结构复杂、状态与规则配置成本高、执行开销大于DAG、流程可视化难度大,不适合简单标准化任务。
状态机专属适配动态交互、多分支、可循环、高不确定性、需要人机协同的大模型场景,典型场景包括:AI智能体自主任务执行、智能客服对话流转、大模型多轮推理、复杂任务拆解与迭代、人机协同创作、异常重试容错系统等。
五、核心差异对比分析
1. 核心逻辑差异
DAG工作流的核心逻辑是任务驱动、拓扑固定。整个流程在启动前就已经确定所有任务的执行顺序、依赖关系、并行规则,运行过程中不会发生任何动态变化,只会严格按照预设拓扑结构执行,任务执行完毕即流程结束,无状态常驻。
状态机工作流的核心逻辑是事件驱动、状态流转。流程无固定执行步骤,仅预设状态集合和流转规则,运行过程中根据实时事件、执行结果动态决定下一步走向,支持循环、分支、回滚,状态会持续常驻,直到触发终止事件。
简单一句话总结:DAG是"按部就班走完固定流程",状态机是"随机应变适配动态场景"。这是二者最本质的区别,也是场景选型的核心依据。
2. 关键特性全面对比
结合大模型工程化落地需求,从8个核心维度做精准对比:
| 对比维度 | DAG工作流 | 状态机工作流 |
| 流程结构 | 静态固定拓扑,无循环 | 动态可变流程,支持闭环循环 |
| 驱动方式 | 依赖任务前置完成 | 依赖外部事件+内部执行结果 |
| 状态管理 | 无常驻状态,仅记录结果 | 全程维护常驻状态,支持持久化 |
| 交互能力 | 不支持人机交互 | 支持人机协同,实时调整 |
| 容错恢复 | 仅单节点重试 | 支持任意状态回滚、断点续跑 |
| 执行效率 | 结构简单、开销低、并行高 | 逻辑复杂、监听开销更高 |
| 开发成本 | 配置简单、上手快、维护低 | 规则复杂、配置繁琐、调试难 |
| 适用场景 | 简单/标准化/离线任务 | 复杂/动态/在线交互任务 |
3. 大模型场景选型准则
优先选DAG的场景:
- 只要AI任务是步骤固定、无交互、无循环、批量标准化,一律使用DAG编排。
- 比如RAG流水线、文本批量翻译、内容审核、数据清洗、模型离线推理、报表自动生成等场景,DAG足够高效、简洁、易维护。
优先选状态机的场景:
- 只要AI任务存在多轮交互、动态分支、循环执行、需要容错回滚、人机协同,一律使用状态机编排。
- 比如自主智能体、多轮对话客服、复杂需求拆解执行、AI自动化办公(多步骤迭代)、故障重试自愈系统等。
二者结合的主流方案:
- 同时行业主流方案大多为二者结合:用DAG承载固定的基础流水线,用状态机处理流程中的动态分支和异常场景,兼顾效率与灵活性,这也是企业级大模型应用的最优落地方式。
六、应用实践方案总结
1. DAG落地优化方案
在大模型DAG工作流落地过程中,容易出现任务阻塞、算力浪费、重试混乱等问题,这里分享几个核心实战优化技巧,提升线上稳定性:
- 合理拆分原子任务:DAG节点必须遵循单一职责原则,每个节点只做一件事,避免大而杂的任务节点。比如将"素材获取+文案生成"拆分为两个独立节点,便于单独重试、排查问题,提升流程灵活性。
- 最大化并行调度:梳理任务依赖关系,将无依赖的节点全部配置并行执行。比如RAG流程中,文本清洗和向量初始化可并行,大幅缩短整体执行耗时。
- 精细化重试策略:为不同节点配置差异化重试规则,大模型推理、接口调用节点容易超时,配置3次重试+间隔退避;数据处理节点稳定性高,无需重试,避免无效资源消耗。
- 增加节点熔断机制:当某一节点连续多次失败,触发熔断,直接终止当前流程并反馈异常,避免无限重试占用算力,保障系统稳定性。
2. 状态机落地优化方案
状态机最大的落地问题是状态冗余、规则混乱、调试困难,实战中可通过优化,降低维护成本:
- 精简状态数量:遵循最小状态原则,只保留业务必需的有限状态,避免状态过多导致流转规则混乱,一般单套工作流状态数量控制在10个以内最佳。
- 统一事件规范:标准化所有触发事件的命名、参数、返回值,避免事件混乱导致的流转异常,便于统一管理和问题排查。
- 状态持久化落地:采用Redis、数据库实时记录当前状态与上下文数据,服务重启、崩溃后可快速恢复现场,避免任务丢失。
- 增加流转日志:记录每一次状态切换的时间、触发事件、上下文信息,形成完整链路日志,快速定位动态流转中的异常问题。
3. 主流框架选型参考
目前大模型生态有大量成熟的编排框架,无需从零开发,可直接复用落地:
- DAG编排框架:Airflow、Prefect、ByteFlow,适合离线AI流水线、批量任务调度;
- 状态机编排框架:LangGraph、StateFlow、阿里云智能体编排引擎,适合在线智能体、交互类AI任务;
- 全能型框架:Dify、Flowise,支持DAG+状态机混合编排,低代码快速搭建大模型工作流,适合快速落地原型和中小型项目。
七、总结
到这里我们已经厘清了DAG与状态机两大工作流编排的核心逻辑与落地价值。在大模型快速迭代的当下,单纯的模型调用已经不再是AI应用的核心竞争力,工作流编排能力,才是生产级AI项目的关键。
总的来说,DAG以固定拓扑、任务驱动为核心,凭借高效、简洁、易维护的优势,成为标准化大模型流水线的基础骨架,完美适配RAG、批量数据处理等离线固定任务;状态机以状态流转、事件驱动为核心,凭借高灵活、可交互、可循环的特性,支撑起AI智能体、多轮交互、复杂自适应任务的落地,解决了大模型动态场景的编排难题。
二者不存在绝对的优劣,只有场景的适配。简单标准化任务用DAG,追求高效稳定;复杂动态交互任务用状态机,追求灵活适配;未来大模型应用的发展,一定是“模型轻量化、流程工程化”。随着智能体、AI自动化、多模型协同技术的普及,工作流编排会成为每一位AI开发者的必备技能。