



MicroPython+ESP32 C3开发上云
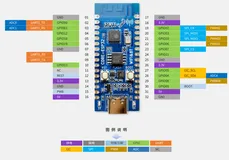
本文介绍了基于MicroPython的ESP32 C3开发,涵盖GPIO控制、PWM调光、定时器、DS18B20温度采集、WiFi连接及Socket通信等内容,并详细演示了如何通过WIFI模块连接新大陆云平台,实现设备登录与心跳包维持连接。
从误检到精准:手把手教你构建高可用RAG系统的黄金法则
本文系统拆解RAG系统开发中的十大关键误区,涵盖数据治理、检索优化、生成控制与系统运维四大维度,结合企业级实践提出四维优化框架,助力开发者构建高精度、高可用的RAG系统,提升检索与生成匹配效率,保障知识准确性与系统稳定性。
豆蔻妇科大模型宣布在妇产科正高考试中成绩超越GPT-5,同时正式开放试用
在钉钉10周年发布会上,壹生检康CEO王强宇宣布其自主研发的豆蔻妇科大模型(doukou.ai)在国家妇产科卫生高级职称笔试考试中以64.94分超越GPT-5的52.59分,并开放网页版试用。这一成绩展现了国产医疗AI在专业化赛道的快速进步和垂直行业大模型的高应用价值,为AI赋能医疗临床提供了新样本。
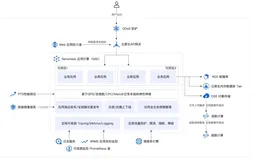
【云故事探索】NO.17:国诚投顾的云原生 Serverless 实践
国诚投顾携手阿里云,依托Serverless架构实现技术全面升级,构建高弹性、智能化技术底座,提升业务稳定性与运行效率。通过云原生API网关、微服务治理与智能监控,实现流量精细化管理与系统可观测性增强,打造安全、敏捷的智能投顾平台,助力行业数字化变革。
《生成式引擎优化(GEO)服务商选择指南》:让AI大模型主动推荐你
GEO(生成式引擎优化)是针对AI生成式搜索引擎的优化策略,旨在让企业信息在AI回答中优先呈现,实现“无点击曝光”。与传统SEO不同,GEO强调语义理解、权威内容和结构化数据,提升品牌在AI推荐中的可见性与可信度。企业需关注GEO服务商的技术实力、行业匹配度、服务流程完整性等维度,确保优化效果。

FastRead——AI驱动的智能读写生产力引擎,重构信息处理与内容创作新范式
FastRead是一款智能内容处理工具,基于大模型技术,自动解析网页、文档、音频等多源内容,提取关键信息并生成多模态知识卡片。它重构信息处理流程,提升内容创作效率,适用于新闻、金融、教育、营销等多个场景,助力用户高效获取与输出知识。
通义大模型千问3助力B站,在618期间,商单成交效率提升5倍+
B站接入通义千问Qwen3等模型打造智能体InsightAgent,提升商业平台“花火”和“必达”的效率。花火实现商单成交效率提升5倍以上,必达数据洞察效率提升3倍以上,推动分钟级投放决策。
通义大模型与现有企业系统集成实战《CRM案例分析与安全最佳实践》
本文档详细介绍了基于通义大模型的CRM系统集成架构设计与优化实践。涵盖混合部署架构演进(新增向量缓存、双通道同步)、性能基准测试对比、客户意图分析模块、商机预测系统等核心功能实现。同时,深入探讨了安全防护体系、三级缓存架构、请求批处理优化及故障处理机制,并展示了实时客户画像生成和动态提示词工程。通过实施,显著提升客服响应速度(425%)、商机识别准确率(37%)及客户满意度(15%)。最后,规划了技术演进路线图,从单点集成迈向自主优化阶段,推动业务效率与价值持续增长。
利用通义大模型构建个性化推荐系统——从数据预处理到实时API部署
本文详细介绍了基于通义大模型构建个性化推荐系统的全流程,涵盖数据预处理、模型微调、实时部署及效果优化。通过采用Qwen-72B结合LoRA技术,实现电商场景下CTR提升58%,GMV增长12.7%。文章分析了特征工程、多任务学习和性能调优的关键步骤,并探讨内存优化与蒸馏实践。最后总结了大模型在推荐系统中的适用场景与局限性,提出未来向MoE架构和因果推断方向演进的建议。
网信办整治 AI 技术滥用,AI 企业如何合规运营
中央网信办开展为期3个月的“清朗・整治AI技术滥用”专项行动,旨在规范AI服务与应用,保障公民权益,促进行业健康发展。文章从算法备案、数据合规管理、内容审核、标识要求、重点领域风险防控、防止侵权、杜绝网络水军及保护未成年人权益八个方面,详细解析了AI企业在运营中需遵循的具体要求与措施,强调企业应主动落实合规,推动AI行业健康有序发展。
Arthas redefine(加载外部的.class文件,redefine到JVM里 )
Arthas redefine(加载外部的.class文件,redefine到JVM里 )

境内深度合成服务算法备案通过名单分析报告
本报告基于《境内深度合成服务算法备案通过名单》,分析了2023年6月至2025年3月公布的10批备案数据,涵盖属地分布、行业应用及产品形式等多个维度。报告显示,深度合成算法主要集中于经济发达地区,如北京、广东、上海等地,涉及教育、医疗、金融、娱乐等多行业。未来趋势显示技术将向多模态融合、行业定制化和安全合规方向发展。建议企业加强技术研发、拓展应用场景、关注政策动态,以在深度合成领域抢占先机。此分析旨在为企业提供参考,助力把握技术发展机遇。

DogAPI-人工智能接口商城
DogAPI 是一家自 2023 年成立以来快速崛起的全球领先人工智能接口和服务提供商,已服务超 10 万用户与 5000 家企业。平台提供丰富多样的 AI 接口(如 OpenAI、Claude、Azure 等)、高级账号套餐、LLM 训练数据及算力租用服务,覆盖自然语言处理、图像生成等多领域。DogAPI 致力于以优惠价格和一站式解决方案助力开发者与企业,同时提供强大的技术支持与灵活交付方式,推动 AI 技术的实际应用与发展。

Google 发布其开源模型系列最新模型 Gemma 3
Google 发布了其开源模型系列的最新成员 Gemma 3,这是一款轻量级、高性能的 AI 模型,支持多语言和复杂任务。它具备 140+ 语言支持、128K-token 上下文窗口、增强的多模态分析能力以及函数调用功能,适用于聊天 AI、代码生成等多种场景。Gemma 3 在性能上超越 Llama 3-8B 和 Mistral 7B,且仅需单 GPU 即可运行,大幅降低计算成本。提供 1B 至 27B 不同参数规模版本,满足多样化需求,并优化了量化模型以适应边缘计算和移动设备。其多模态设计整合了 SigLIP 图像编码器,扩展上下文窗口至 128k token,显著提升了视觉和文本理解能力。

使用 Qwen 进行Self-instruct数据生成
使用Qwen进行自指令数据生成,通过Self-instruct技术自动化为大型语言模型生成指令。用户可安装CAMEL包并设置Qwen API密钥,配置ChatAgent和SelfInstructPipeline,基于种子指令迭代生成大量新指令。支持多种过滤器(如长度、关键词、标点符号等)确保生成指令的质量和多样性。欢迎加入Discord获取支持与交流。
Qwen-coder实现本地 RAG 框架能力Bootstrap
本文介绍了如何利用Qwen-coder在本地实现RAG框架能力提升,解决了企业知识库管理中的数据安全和半结构化文档处理问题。通过Qwen2.5-72b模型和多轮对话推理,成功实现了对包含图表内容的文档的高效预处理,提升了知识库检索的准确性和安全性。
通义千问 Qwen 系列的 Agent 方向探索
通义千问Qwen系列在AI领域展现了强大的Agent方向探索能力,包括灵活的Tool调用、单/多Agent场景实践等,通过丰富的代码示例展示了其在文本生成、信息检索、任务自动化及专业领域应用等方面的优势,为复杂应用场景提供了多元且实用的解决方案。
基于阿里云通义千问开发智能客服与问答系统
在企业的数字化转型过程中,智能客服系统已成为提高客户满意度和降低运营成本的重要手段。阿里云的通义千问作为一款强大的大语言模型,具有自然语言理解、对话生成、知识检索等能力,非常适合用来开发智能客服与问答系统。 通过本博客,我们将演示如何基于阿里云的通义千问模型,结合阿里云相关产品如函数计算(FC)、API网关、RDS等,搭建一个功能齐全的智能客服系统。

基于qwen2和qwenvl的自动批改作业应用!
针对作业批改中常见的问题,如低质量作业、大量简单作业耗时、需初筛异常作业等,开发了一款自动批改作业的应用。该应用通过备份作业文件、获取文档内容、利用AI生成评语,并保存关键信息与日志,简化了教师的工作流程,提高了效率。应用设计简洁,易于扩展,支持图片转文字处理,适合教育场景使用。
人工智能与模型知识库在移动医疗产品中的落地应用
在现代医疗体系中,通义千问大模型与MaxKB知识库的结合,为医生和患者提供了前所未有的支持与便利。该系统通过实时问答、临床决策辅助、个性化学习和患者教育等功能,显著提升了诊疗效率和患者满意度。实际应用如乐问医学APP展示了其强大优势,但数据隐私和安全问题仍需关注。
大模型进阶微调篇(一):以定制化3B模型为例,各种微调方法对比-选LoRA还是PPO,所需显存内存资源为多少?
本文介绍了两种大模型微调方法——LoRA(低秩适应)和PPO(近端策略优化)。LoRA通过引入低秩矩阵微调部分权重,适合资源受限环境,具有资源节省和训练速度快的优势,适用于监督学习和简单交互场景。PPO基于策略优化,适合需要用户交互反馈的场景,能够适应复杂反馈并动态调整策略,适用于强化学习和复杂用户交互。文章还对比了两者的资源消耗和适用数据规模,帮助读者根据具体需求选择最合适的微调策略。
HTML5 拖放详解
HTML5 的拖放功能增强了网页的互动性和用户友好性,允许用户通过拖动操作移动网页元素。其核心包括拖动源和放置目标,并提供了 `draggable` 属性及多个事件(如 `dragstart`、`dragover` 和 `drop`)来实现这一功能。示例代码展示了如何使用这些 API 创建一个简单的拖放组件,通过设置样式和监听事件来提升用户体验。在实际应用中,需注意样式提示和浏览器兼容性测试。

【Prompt Engineering 提示词工程指南】文本概括、信息提取、问答、文本分类、对话、代码生成、推理
本文介绍了使用提示词与大语言模型(LLM)交互的基础知识。通过调整参数如温度(Temperature)、最高概率词元(Top_p)、最大长度(Max Length)及停止序列(Stop Sequences),可以优化模型输出。温度参数影响结果的随机性;Top_p 控制结果的多样性;最大长度限制输出长度;停止序列确保输出符合预期结构。此外,频率惩罚(Frequency Penalty)和存在惩罚(Presence Penalty)可减少重复词汇,提升输出质量。提示词需包含明确指令、上下文信息、输入数据及输出指示,以引导模型生成理想的文本。设计提示词时应注重具体性、避免歧义,并关注模型的具体行为
Github 2024-07-15 开源项目周报 Top15
根据 Github Trendings 的统计,2024年7月15日当周共有15个项目上榜。以下是按开发语言分类的项目数量汇总:Python项目5个,非开发语言项目4个,JavaScript项目3个,TypeScript项目2个,Go、Solidity和Java项目各1个,Rust项目1个。此外,介绍了多个值得关注的项目,包括免费编程学习平台 freeCodeCamp.org、免费编程书籍和学习资源清单、免费 API 集合等,涵盖了不同编程语言和技术领域。
Github 2024-06-17 开源项目周报 Top15
根据Github Trendings的统计,本周(2024年6月17日)共有15个项目上榜。按开发语言分类,Python项目最多,达6项;TypeScript和JavaScript各有3项;PHP、Blade、Lua、Dart及非开发语言项目各1项。这些项目涵盖从零构建技术、智能家居、高性能数据库到情感语音模型等多个领域,体现了开源社区的多样性和创新力。

LLM应用实战:当KBQA集成LLM(二)
本文主要是针对KBQA方案基于LLM实现存在的问题进行优化,主要涉及到图谱存储至Es,且支持Es的向量检索,还有解决了一部分基于属性值倒查实体的场景,且效果相对提升。

AI 提示词模板相关的架构设计
现在很多企业纷纷研发大语言模型以解决业务问题。提示词在与模型交互中起到关键作用。为优化提示词模板的修改、提高渲染效率及确保安全性,架构设计注重可修改性、安全性、可靠性和性能。设计包括:将提示词存储在OSS以方便修改和版本控制;使用本地缓存提升读取性能;模板引擎增强灵活性;秘钥安全存储在加密系统中;并通过配置中心动态调整。此设计旨在提供高效、安全且可靠的AI交互体验等。
通义大模型合作计划升级|欢迎伙伴加入
阿里云面向生态伙伴开放“阿里云百炼“大模型服务平台和“通义”系列为代表的各类大模型产品能力,与产品生态伙伴展开基于大模型应用方向的Maas(模型即服务)产品集成与被集成合作,旨在为用户提供AI领域研究成果在行业中的最新技术应用与解决方案,而共同开展的一项关于大模型应用合作的产品合作计划。


几个好玩又实用的智能工具网站非常nice[搜嗖工具箱]
纪妖网汇集了2200多个妖怪,包括妖、怪、神、魔等,可以让人了解古今中外不同的文化知识。诗三百是一个人工智能写诗平台,支持AI作诗、藏头诗生成等功能。Mikutools是一个工具集合网站,支持夜间模式,兼容全平台。知微事见是互联网社会热点聚合平台,可以帮助用户捕捉网络热点。哄哄模拟器是一款娱乐类AI应用,旨在帮助用户练习和提高与伴侣沟通的技巧。
大语言模型在假新闻的检测
大语言模型在假新闻检测应用中发挥重要作用。通过学习大量语言数据和模式,模型可以理解文本的语义和上下文信息,判断其真实性。模型通过监督学习训练,提取特征并预测新闻真实性。结合其他技术手段和人工审核,可以提高准确性和可信度。假新闻检测的过程包括数据准备、特征提取、模型训练和实际应用。模型在谣言检测中也有类似应用。
通义千问开源第二波!多模态来啦!(内含魔搭最佳实践)
近期,通义千问大规模视觉语言模型Qwen-VL上线魔搭社区,Qwen-VL以通义千问70亿参数模型Qwen-7B为基座语言模型研发,支持图文输入,具备多模态信息理解能力。

如何向大模型注入知识?达摩院通义对话模型SPACE系列探索
如何将人类先验知识低成本融入到预训练模型中一直是个难题。达摩院对话智能团队提出了一种基于半监督预训练的新训练方式,将对话领域的少量有标数据和海量无标数据一起进行预训练,从而把标注数据中蕴含的知识注入到预训练模型中去,打造了SPACE 1/2/3 系列模型,在11个国际公开对话数据集取得SOTA。
GEO优化软件工具落地为何不是写稿问题:从用户、内容、信任、组织与风险五层拆解生成式引擎优化的工程实践与可验证价值
本文探讨生成式引擎优化(GEO)如何应对AI时代新传播挑战:用户不再直接浏览链接,而是依赖模型生成的答案。文章从用户、内容、信任、组织、风险五大日常维度切入,揭示GEO如何重塑信息可见性、内容生产逻辑与组织协同机制,强调“说清楚、说一致、经得起核验”才是核心——GEO不是替代人,而是放大真实可信的声音。
可编辑 PPT:调研、设计与实施方案
本文为内部设计文档,规划全新「内容→PPTX」产品线:输入主题或文档,AI生成整套幻灯片,支持网页自由编辑(拖拽/换版式/调样式),导出真正可编辑的 `.pptx`(文字、框、图均可改)和保真 `.pdf`。区别于现有「PPTX→MP4」路线,本版聚焦编辑与导出,不支持配音、视频、双向同步。调研排除闭源/许可受限方案,全栈自研,确保可控与合规。(239字)
AI 开始积累工作经验了,怎样避免“越学越错”?
AI整理报价时,一次成功不等于经验正确。若将同事补救误记为规则,错误会固化。真正可靠的经验需明确依据、适用条件与失效边界,并支持动态纠错——让AI少走弯路,而非熟练犯错。
AI 开始有自己的邮箱了,企业准备好给它一个“岗位”了吗?
本文探讨AI Agent作为“数字同事”融入企业组织的深层变革:当AI拥有独立邮箱、日历与身份,它不再仅是工具,而成为可委托职责、可交接工作、需明确权责的协作节点。核心在于——企业需以岗位思维设计AI角色:界定职责边界、管理委托关系、沉淀可交接经验、保障权限与审计,并将价值落于团队整体效率提升。

我会用冷缓存和热缓存做两次测试
本文分享个人缓存测试方法:通过冷/热缓存对照,量化分析长上下文场景中缓存对Token消耗、首字延迟及费用的影响。强调不盲信“缓存折扣”,需控制变量(模型、提示词、上下文等)并记录完整指标,确保结论可复现、可验证。(239字)
图纸存阿里云,建筑企业如何挑选适配的专业加密软件
建筑企业将DWG、BIM等图纸上云至阿里云OSS,面临外泄、批量下载等风险。本文聚焦专业加密选型:强调加密应用库对CAD/Revit等进程级兼容;加密网关实现OSS密文存储;配套外发管控与全链路审计,兼顾协同效率与资产安全。(239字)