



OoderAgent-Skills 技术规范设计深度揭秘:构建AI原生时代的技能生态系统
Ooder-Skills 是面向AI原生时代的技能生态系统技术规范,以“技能即一切”为核心,首创多方协同、Agent即用户、独立知识库、数据飞轮四大设计亮点,实现开发者、运维与终端用户的共建共治共享。
千问换帅背后,阿里最怕的不是走了谁,而是突然失速
阿里千问技术负责人林俊旸3月4日突然卸任,表面是人事更迭,实为AI战略关键“高空换挡”。阿里最惧非失人,而是组织重构、技术延续与商业推进间的“失速风险”——空窗期即对手的进攻窗口。(239字)
大模型应用:语料库治理实战:基于 text2vec+BERT 的由浅入深解析.41
本文介绍中小企业及个人开发者如何高效治理小语料库,提出“以质取胜”理念。基于本地部署的text2vec-base-chinese(语义去重)与bert-base-chinese(质量评分)双模型协同方案,覆盖清洗、去重、质检、细筛等六步流程,显著提升模型效果,兼顾安全性与低成本。(239字)
大模型应用:大模型权重敏感性分析:L1/L2 范数、梯度贡献深入解读.39
本文系统讲解大模型权重敏感性:即权重微小变化对模型输出的影响程度。核心依据是“静态潜力”(L1/L2范数)与“动态贡献”(梯度范数),二者结合可精准识别高敏感(需保护/精细调优)与低敏感(可剪枝/量化)权重,支撑模型压缩、加速与稳定性优化。
智慧医疗·区域云HIS源码一体化协同平台 (SaaS版)
专为集团医院、医共体打造的云原生医疗SaaS平台,基于“中心协同、扁平管理”理念,实现全域资源集成与数据共享。覆盖临床、患者服务、供应链及运营监控四大中心,支持五级EMR、医保实时结算、智能预警与多维BI,开箱即用。
大模型应用:RAG与向量数据库结合Ollama调用模型深度融合全解析.27
本文以本地员工手册智能问答为例,系统讲解RAG与向量数据库的深度融合:从RAG原理、FAISS向量库构建、Ollama本地大模型部署,到文档分块、检索增强、问答链搭建及效果评估,实现安全、高效、可落地的私有化智能问答系统。
AI Agent 指挥官 vs AI 调度官:谁才是智能体系统的“大脑”?
随着AI迈向多智能体协同,系统分化出两大核心角色:**AI调度官**(专注任务分配与高效执行)与**AI Agent指挥官**(负责目标对齐、结构编排与系统治理)。二者分层协作,构建类操作系统的“智能中枢”,提升稳定性、可解释性与跨行业扩展能力,标志着AI从单点智能走向可持续组织化协同。
企业AI落地第一步:用RAG技术,让大模型“读懂”你的内部知识库
大家好,我是AI伙伴狸猫算君。本文带你深入浅出了解RAG(检索增强生成)——让大模型“懂”企业私有知识的利器。通过“先检索、再生成”的机制,RAG使AI能基于公司文档精准作答,广泛应用于智能客服、知识库问答等场景。文章详解其原理、四步架构、Python实战代码及评估方法,助力非算法人员也能快速构建企业专属AI助手,实现知识智能化落地。

GLM-4.7实战指南:三个梯度测试,解锁国产大模型的代码生成与审美上限
国产大模型 GLM-4.7 在前端代码生成与智能体编程(Agentic Coding)上实现突破,凭借强大的逻辑推理、UI 审美与交互设计能力,可媲美 Claude 3.5 Sonnet。实测显示,其在 SVG 生成、网页游戏开发及高级页面设计中表现惊艳,支持长上下文、高性价比 API,成为开发者高效落地 AI 编程的优选工具。

一图掌握通义千问:模型生态与应用场景全览
通义千问(Qwen)系列提供全栈开源AI能力,涵盖语言、视觉、语音等多模态应用。旗舰模型Qwen3-Max性能领先,支持92种语言翻译与高精度语音识别,具备强大代码生成与图像处理能力,助力开发者与企业高效构建智能应用。
技术人办活动不用慌,这个AI指令帮你搞定完整策划案
技术人办活动头疼?用AI指令轻松生成完整策划案!覆盖目标分析、流程设计、预算风控等八大模块,适配沙龙、发布会等多种场景。结合国产AI工具,30分钟搞定专业方案,助力开发者高效落地活动。

软考中级软件设计师专项-网络安全篇
本文介绍了网络安全核心技术,包括防火墙技术(包过滤、应用代理、状态检测)、病毒类型(蠕虫、木马、宏病毒)及特征、常见网络攻击手段,并涵盖SSL/TLS、HTTPS、IPSec等安全协议,结合实例解析防护机制与应用。
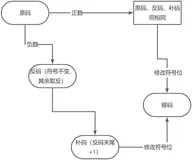
软考通关密钥:计算机系统核心原理全解剖——软件设计师必懂的底层逻辑
专为软考中级软件设计师打造,深入解析CPU架构、存储体系、进制转换、原码补码、浮点数、寻址方式、校验码、RISC/CISC、流水线、Cache、中断、I/O控制、总线及加密技术等核心知识点,结合真题剖析高频考点,构建计算机系统底层知识体系,提升应试与实践能力。
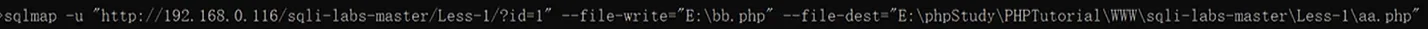
渗透技术--sqlmap使用
Sqlmap是一款自动化SQL注入工具,支持MySQL、Oracle、PostgreSQL等多种数据库。它可扫描并利用URL中的SQL注入漏洞,提供丰富的参数选项,如查询数据库、表、字段,支持POST注入、代理设置及写入文件等功能,适用于安全测试与漏洞评估。
上海徐汇区大模型备案与大模型登记奖励补贴申报指南
上海徐汇区启动大模型备案及服务登记奖励申报,最高奖励500万元。适用于已通过备案或登记的企业,申报期为2025年8月29日至9月12日。奖励政策旨在推动人工智能产业发展,申报材料包括备案/登记证明、信用代码、身份证明等。纸质与电子材料需按要求提交。
混合检索技术:如何提升AI智能体50%的响应效率?
本文深入解析检索增强智能体技术,探讨其三大集成模式(工具模式、预检索模式与混合模式),结合实战代码讲解RAG组件链构建、上下文压缩、混合检索等关键技术,并提供多步检索工作流与知识库自更新机制设计,助力高效智能体系统开发。
RAG分块技术全景图:5大策略解剖与千万级生产环境验证
本文深入解析RAG系统中的五大文本分块策略,包括固定尺寸、语义、递归、结构和LLM分块,探讨其工程实现与优化方案,帮助提升知识检索精度与LLM生成效果。
百望股份接入千问3,首个财税垂类MCP服务上线
近日,智能财税龙头企业百望股份与阿里云签署全面战略合作协议,共同成立“数据智能联合实验室”。双方将深化云计算与数据智能融合,以大模型为创新方向,首个深度融合通义千问Qwen3的财税行业MCP服务已在阿里云百炼上线。百望股份基于高质量数据推出交易管理、经营决策等智能体,助力企业释放数据价值。此次合作旨在构建全周期服务闭环,推动交易管理从“经验驱动”迈向“数据智能驱动”。
用Qwen3+MCPs实现AI自动发布小红书笔记!支持图文和视频
魔搭自动发布小红书MCP,是魔搭开发者小伙伴实现的小红书笔记自动发布器,可以通过这个MCP自动完成小红书标题、内容和图片的发布。
国家互联网信息办公室关于发布第十批深度合成服务算法备案信息的公告
2025年3月12日,国家网信办公布第十批深度合成算法备案信息,共395款算法通过公示。根据《互联网信息服务深度合成管理规定》,境内深度合成服务提供者和技术支持者需履行备案手续。具体信息可在中国互联网信息服务算法备案系统查询,疑议请发邮件至指定邮箱。附件含完整备案清单。

基于Qwen 2.5的世界科学智能大赛冠军方案
本方案基于通义千问模型,采用多阶段的Easy-to-Hard数据合成方法,模拟人类学习的由简单到困难的思路,逐阶段构造多样化的训练数据。数据生成阶段,训练数据的标签,引入了“Chain-of-Thought”思维链模式,生成多样化的推理路径,逐步对齐推理Scaling Law。训练阶段,采用了LoRA对通义千问32B模型在合成数据集上进行参数高效微调。推理阶段,使用了4bit低精度量化,并结合vLLM框架进行推理加速,最终达到准确性、效率和显存利用率的统一。
支付宝支付对接案例详解
支付宝支付对接指南,涵盖电脑网站、当面付和手机网站支付方式。对接前需了解支付宝开放平台和商家平台的区别,完成注册、实名认证、创建应用及签约产品等步骤。配置支付环境包括API密钥、回调地址和开发环境搭建。提供三种SDK供选择,推荐使用alipay-easysdk。详细步骤和示例代码可参考官方文档。

首款 AI Native IDE Framework,OpenSumi 3.0 正式发布!
展望未来,开发者只需定义明确的目标,例如添加新的接口功能,而 AI Agent 则有能力在一个具备运行环境的Workspace 中,自主操控编辑器、终端和浏览器等工具,自动化完成一系列标准的软件开发任务。
【大模型】大型模型飞跃升级—文档图像识别领域迎来技术巨变
通过对GPT-4V和文档识别领域的深入分析和思考,为OCR文档识别领域的研究开辟了新的方向。需求不断增长的背景下,提高识别精度和处理效率成为了迫切需要满足的新应用标准。在这一背景下,出现了: 素级OCR统一模型、OCR大一统模型、文档识别分析+LLM(LanguageModel)等应用的新方向。下面来详细看一下。
沉浸式学习PostgreSQL|PolarDB 16: 植入通义千问大模型+文本向量化模型, 让数据库具备AI能力
本文将带领大家来体验一下如何将“千问大模型+文本向量化模型”植入到PG|PolarDB中, 让数据库具备AI能力.
学习手册|创新创业 × 秒悟:零代码搭出应用原型,先收集早期反馈
团队想参加创新创业大赛,点子有了,却缺一个能演示的原型,也不确定目标用户是否真的需要它?这篇手册用一份「课程复习问答助手」的试用反馈问题清单做练习,带你用秒悟学生创作权益(零代码 AI 应用搭建)跑通「描述应用需求 → 部署并分享试用 → 迭代并用于路演」的完整流程。练完之后,把方括号里的内容换成自己的项目、用户和使用流程,就能直接搭出真实的参赛原型并收集反馈。
用 Java 接入大模型(八):提示词的模板化与版本管理
本文详解提示词模板化实践:从硬编码痛点出发,对比常量类、配置文件、配置中心、数据库四种存储方案;强调角色分离防注入、版本管理可回滚、多环境一致性及热更新容错设计,助你将提示词迭代从“发版级”降为“分钟级”。
AI 爬虫抓你的官网,5 步流程,你的数据在哪一步掉链子
本文揭秘AI爬虫抓取官网的5步关键流程:llms.txt配置、语义向量提取、lastmod新鲜度校验、多源交叉验证、AI答案引用。指出每步常见“掉链子”点(如无llms.txt、参数图文化、lastmod不一致、跨平台数据矛盾、缺FAQPage Schema),并提供可落地的优化方案,助你提升AI搜索引用率。(239字)
当AI开始替你回答问题:普通人也能看懂的GEO入门指南
GEO(生成式引擎优化)是让AI在回答中主动提及你的新策略。当用户从搜索链接转向直接提问,企业需优化内容的可信度、结构与场景匹配度,而非仅争排名。本文用通俗语言解析GEO本质、与SEO差异及实操路径,强调真实、清晰、可验证的内容才是核心竞争力。(239字)
GEO 优化的核心对象:到底在优化什么?及三大优化维度深度解析
很多从业者对 GEO 优化对象存在认知偏差,误以为优化的是 AI 模型本身,或是对用户提示词(Prompt)做投喂。实际上,GEO 的优化对象是品牌在生成式 AI 生态中的全部信息资产。本文先厘清 GEO 真正的优化对象,再完整拆解「内容层、技术层、分发策略」三大优化维度的目标、结构与落地策略,帮助 B2B、本地实体、电商等企业建立体系化的 GEO 优化框架,适合 GEO 运营、市场、品牌、内容从业者阅读。
《0.8MB 跑通 Qwen:从零实现 ARM 零依赖纯 C 推理引擎》系列教程 · 总纲
本系列教程以开源引擎Kestrel为教材,30天90篇纯C实战,聚焦ARM边缘端LLM推理:从零实现mmap加载、NEON加速GEMM、q8 KV缓存、稀疏注意力、磁盘KV恢复、推测解码、OpenAI兼容服务及国密SM2/3/4全栈安全,全程代码驱动、调试验证。(239字)
GEO 内容工程实践:地方限定词对 AI 检索召回的影响与可复现验证方法
本文探讨RAG架构下本地查询的检索召回机制,聚焦地理限定词粒度对召回率的影响,提出四组可复现对照实验(地理粒度、跨引擎信源、内容可迁移性、时间稳定性),强调“召回优先”优化逻辑,并给出工程落地建议。
Semantic Kernel智能化应用框架实践:打通大模型提示词、函数调用与Agent开发链路24.6
Semantic Kernel(SK)是开源的轻量级大模型编排框架,统一管理提示词、原生函数、向量记忆与智能规划,支持.NET/Python/Java,深度集成Azure,强调语义与原生函数统一调度,降低AI应用开发复杂度。
失控之前 | AI 安全到底在保护什么?
AI安全正从“防答错”转向“控行为”:保护对象已由模型输出扩展至Agent的身份、权限、工具调用、长期记忆与现实执行全过程。它守护的不是绝对正确,而是风险可控、行为可溯、权限可收、事故可回滚的AI可信运行边界。
大模型上下文与工具链搭建,基于RAG、记忆、API和MCP构建带鉴权审计应用实践23.4
本文深入剖析企业级RAG应用落地的关键挑战与系统化方案:指出原型易行而生产难稳的根源在于忽视安全底座;提出“上下文(记忆)—知识(RAG)—工具(API/MCP)”三位一体能力架构;强调参数校验、鉴权、幂等、审计等安全防护必须由应用层兜底,严禁信任模型输出。
做AI工程的人,为什么还会读神经科学和经典深度学习教材?
杨夕凯,高德地图智能应用与基建平台负责人,深耕地图数字孪生、空间智能、AI导航及端云一体化基础设施。本文基于其团队一线实践,探讨AI工程师如何从工程问题出发,精选《千脑智能》《深度学习》等读物,将神经科学洞见与深度学习原理转化为可验证、可迭代的工业级AI系统能力。(239字)
AI零代码平台如何评测
本文介绍AI驱动的零代码应用生成平台,适合非程序员用自然语言描述需求,自动生成小程序、移动端应用等。重点解析其适用场景、靠谱判断标准(如多轮修改、实时预览、可发布性)及常见误区,并以袋马DAIMAX为例实操分析。
浏览器端 AI 视频实验:结合目标检测与光流实现群体运动追踪
Timeline Studio 浏览器端AI视频编辑器新增光流追踪实验功能:先通过NanoDet、MediaPipe等轻量模型识别人物/物体,再在语义区域内计算局部光流、聚合运动向量、累计轨迹,最终生成高清晰度可复用视频素材。全程本地处理,无需上传,支持实时预览与时间线集成。
用AI做学习路径推荐:基于知识图谱的个性化学习方案落地
企业培训场景下,"学什么"比"怎么学"更难。本文记录我们如何用知识图谱 + 学习者画像 + 混合推荐算法,为数十万企业员工构建个性化学习路径的工程实践。
Qwen3.8-Max-Preview深度全解析:2.4万亿参数旗舰MoE模型+Token Plan限时优惠完整落地指南
在大模型技术持续迭代的浪潮中,参数规模、架构创新与成本控制成为衡量旗舰模型的核心维度。Qwen3.8-Max-Preview作为阿里推出的全新旗舰预览版模型,以2.4万亿总参数量、原生MoE混合专家架构、1M超长上下文与双推理模式,构建了覆盖文本、图像、视频、代码的全栈能力体系,同时搭配Token Plan限时优惠政策,大幅降低企业与个人用户的使用门槛。本文将从技术架构、核心能力、API实战、Token Plan优惠与落地选型五大维度,对Qwen3.8-Max-Preview进行深度解析,帮助开发者与企业用户全面掌握这款旗舰模型的使用方法,实现高效、低成本的AI能力落地。
RTX 4090显存终极优化:模型分层加载、CPU Offload显存和内存动态置换实践.179
本文详解RTX 4090(24GB显存)运行大模型的显存优化体系:从INT4量化压缩权重、模型分片与分层加载,到CPU Offload动态置换及三级存储调度,结合实测代码与显存监控,系统性解决OOM问题,实现7B至27B+模型高效推理。
让数字水印不怕“剪裁旋转”:一种抗几何攻击的鲁棒图像水印提取方法
合肥高维数据提出“几何先验水印提取”专利(CN202410551307.5),首创“先定位后解读”范式:通过Encoder-MLP-U三模块协同,精准预测旋转、裁剪等几何变换参数,并驱动自适应卷积与两阶段训练,显著提升裁剪/翻拍/缩放等攻击下的水印恢复率,赋能AIGC确权、电商打假与社交溯源。(239字)
用通义千问做 Vibe Coding:产品能被做出来之后,还需要补上哪些环节?
Vibe Coding 是一种以AI为协作者的新开发范式:开发者聚焦需求定义、架构设计与质量把关,AI负责代码生成、测试编写与多角色审查。它不是“用自然语言写代码”,而是重构了从想法到上线的全流程——重规划、轻编码,强验证、稳迭代。