1. History
Doug Cutting is inspired by the the paper, MapReduce: Simplified Data Processing on Large Clusters by Jeffrey Dean and Sanjay Ghemawat from Google Lab, to develop an open-source implementation of the Map-Reduce framework. He named itHadoop, after his son's toy elephant.
2. What is MapReduce?
Apache Tutorial: http://hadoop.apache.org/common/docs/current/mapred_tutorial.html
不错的中文入门:http://www.cnblogs.com/forfuture1978/archive/2010/11/14/1877086.html
Mapper:
Mapper maps input key/value pairs to a set of intermediate key/value pairs.
map的输出并不是直接写入硬盘,而是将其写入缓存memory buffer。
当buffer中数据的到达一定的大小,一个背景线程将数据开始写入硬盘。
在写入硬盘之前,内存中的数据通过partitioner分成多个partition。The total number of partitions is the same as the number of reduce tasks for the job
在同一个partition中,背景线程会将数据按照key在内存中排序。
每次从内存向硬盘flush数据,都生成一个新的spill文件。
当此task结束之前,所有的spill文件被合并为一个整的被partition的而且排好序的文件。
reducer可以通过http协议请求map的输出文件,tracker.http.threads可以设置http服务线程数。
Reducer:
Reducer reduces a set of intermediate values which share a key to a smaller set of values.
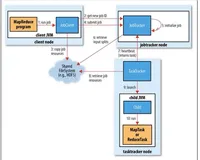
当map task结束后,其通知TaskTracker,TaskTracker通知JobTracker。
对于一个job,JobTracker知道TaskTracer和map输出的对应关系。
reducer中一个线程周期性的向JobTracker请求map输出的位置,直到其取得了所有的map输出。
reduce task需要其对应的partition的所有的map输出。
reduce task中的copy过程即当每个map task结束的时候就开始拷贝输出,因为不同的map task完成时间不同。
reduce task中有多个copy线程,可以并行拷贝map输出。
这个copy的过程也叫Shuffle(In this phase the framework fetches the relevant partition of the output of all the mappers, via HTTP.)然后是sort (The framework groups Reducer inputs by keys (since different mappers may have output the same key) in this stage.)
然而Shuffle和Sort可以同时进行的(The shuffle and sort phases occur simultaneously; while map-outputs are being fetched they are merged.)
3. Install hadoop
http://ebiquity.umbc.edu/Tutorials/Hadoop/00%20-%20Intro.html
4. Problem shooting
4.1 如何解决java.lang.NoClassDefFoundError: org/apache/hadoop/util/PlatformName 问题 :
http://www.blogjava.net/snoics/archive/2011/03/10/333408.html