hadoop的调试

简介: 折腾hadoop的调试很久了,一直都没折腾对,查过很多资料,但是都没试出来,最终在不断地尝试当中调试出来了,所以想把这个过程记录下来,和大家分享一下。 调试分为两部分,MapReduce的调试和源码的调试。MapReduce的调试很简单,首先要部署好hadoop,这个我就不说了,自己去百度。部

折腾hadoop的调试很久了,一直都没折腾对,查过很多资料,但是都没试出来,最终在不断地尝试当中调试出来了,所以想把这个过程记录下来,和大家分享一下。

调试分为两部分,MapReduce的调试和源码的调试。MapReduce的调试很简单,首先要部署好hadoop,这个我就不说了,自己去百度。部署好之后,下载Hadoop对应的eclipse插件,有了这个插件之后,变得异常简单。这是我在网上下的hadoop1.1.2的eclipse插件的地址:http://download.csdn.net/detail/cenyuhaiwork/5716051。下载完毕之后,把它放入eclipse目录的dropins文件夹中即可,然后重启eclipse。
f72c7c044b42b007133c561f0a9e0b0a2f22f621

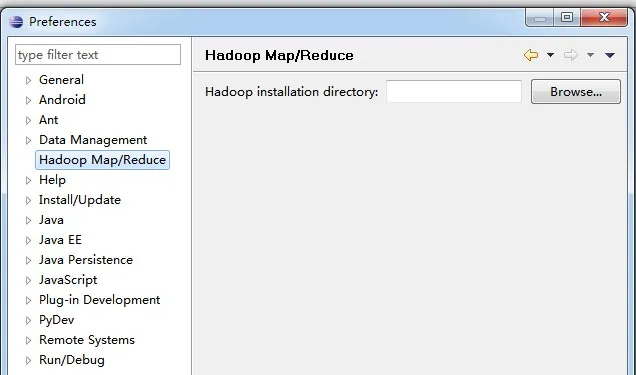
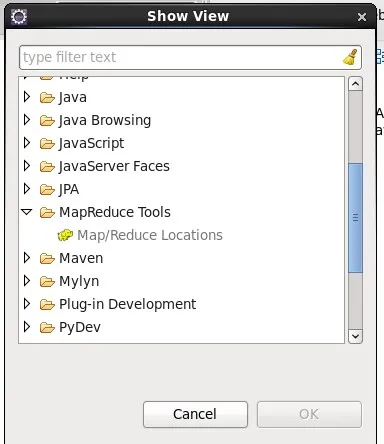
打开windows preferences 中,发现有Hadoop Map/Reduce就说明已经成功了。打开window show View ,选择Map/Reduce Locations。
cc8c4b99131ddf90ab36b0d1146cab6e00dc7881

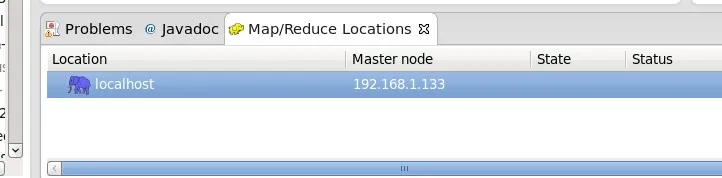
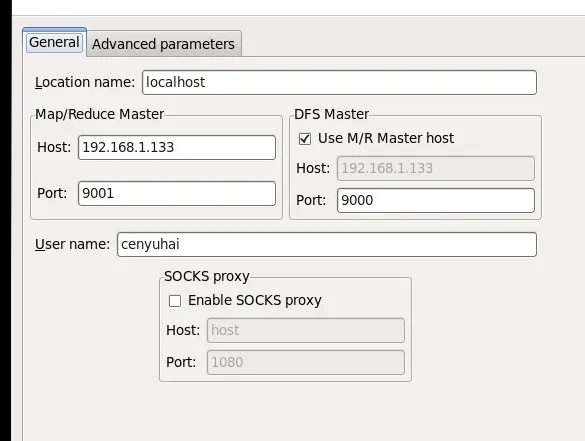
编辑Map/Reduce Locations

61ffdeacf33b6c77b52cf65dd5b8af90eef49f3b

修改成实际的Ip地址和端口即可。

ab06e170c779a026704ec6a45580157dd0b73aba

设置完毕,开始新建工程。

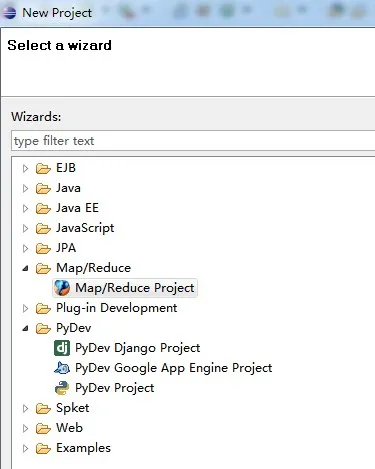
点击File,新建工程,选择Map/Reduce Project.
b3d5de27234fbb0485471a0580ab29dd3a12010f

新建工程之后,然后新建一个类,我们可以把工程里面的examples里面的WorkCount拿出来试验一下,直接点调试即可开始,就像我们正常调试程序一样。examples里面还提供了其他很多的例子,大家可以去看看挺好的。

好了,现在我们开始进入hadoop源码的调试当中,在调试之前我们首先要把源码处理成不报错的状态。

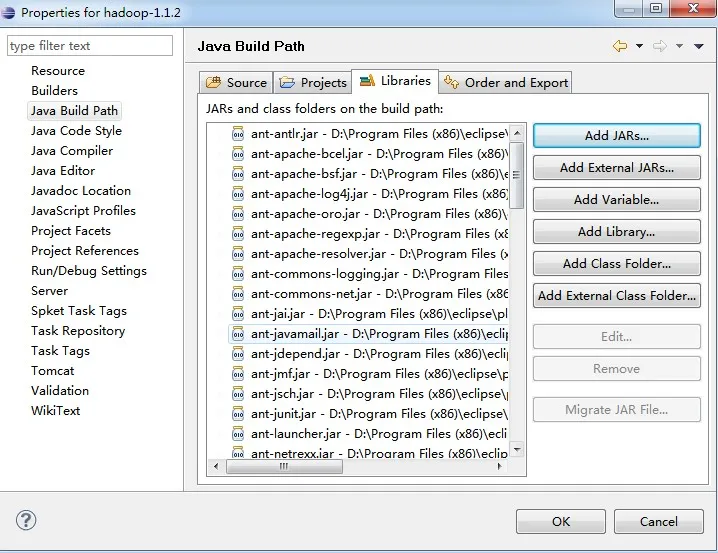
把源码导入eclipse当中,源码可以在发布版的hadoop的src文件夹中找,然后我们导入jar,右键点击属性,选择java Build path,点击add jars,把发布版的lib文件夹中所有的jar包都导入。
6ee95b081e7c88208b75c9f321df805bb09a0c1d

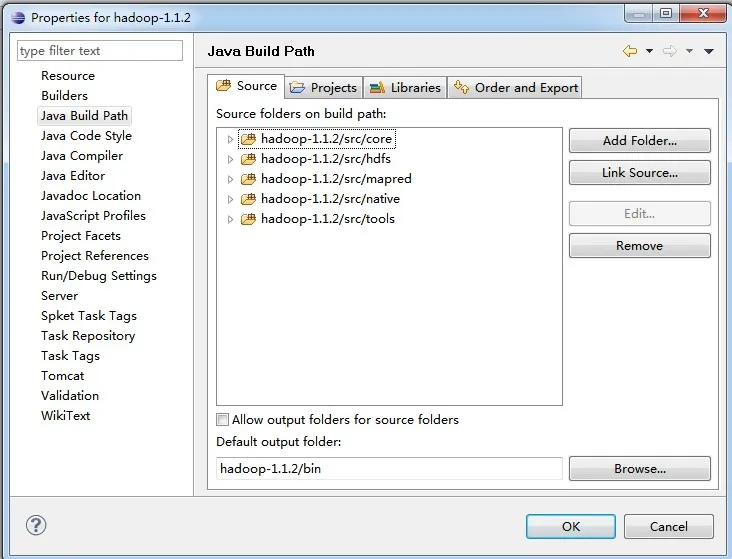
然后我们再点击Source标签页,去掉多余的内容,我们只需要编译核心的几个目录即可,多编译因为缺少一些别的jar包报错,比如ant的。

先删掉原来的src目录,然后重新添加,我点Add Folder添加了一下目录,别的我就没有编译了。
3f5e08691c464da232197d5afdb67ffd289d3d10

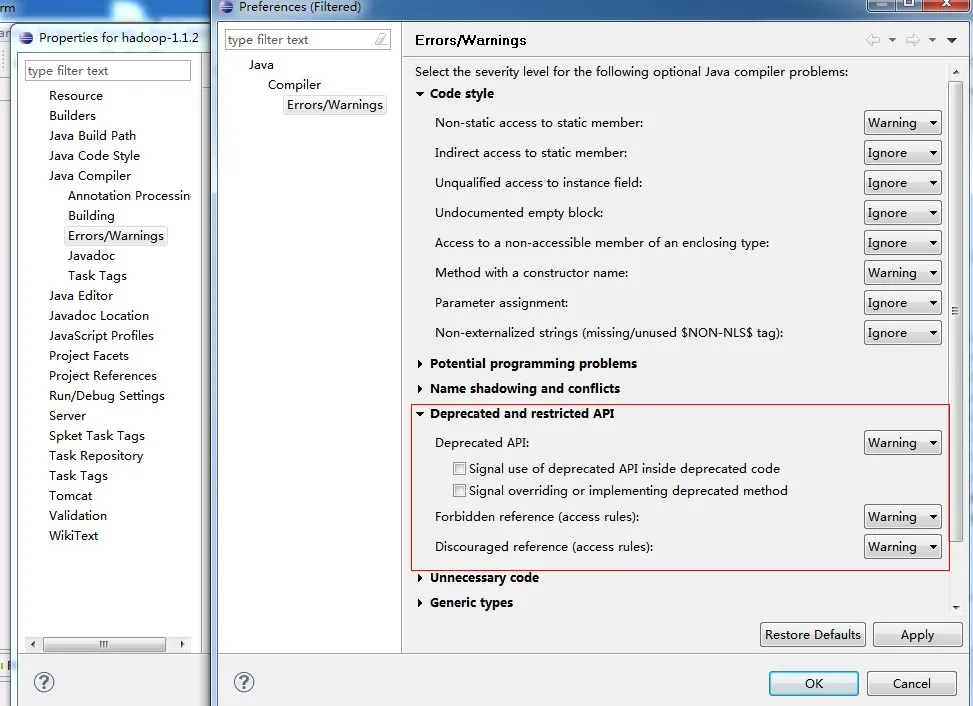
然后再点击左侧的Java Compiler,选择子项Error/Warnning ,如下图所示,把Error改成Warning.
0975d263b678c64f852c42be0d043a77bea219a1

点击Ok,设置完毕,可以开始Build啦。

好,我们打开hadoop生产环境下的bin目录下的hadoop,我们以调试NameNode为例子,找到elif ["COMMAND" = "namenode"]这一段,在HADOOP_OPTS

的字符串后面,添加-agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=8000。

8abe71c063c7a4d08dd732b2dc67edf46648570e

其中suspend表示是否挂起等待调试连接,这里我没有让它挂起,有需要的朋友可以改成y,让它挂起,那样效果很明显,一直等着你连接。

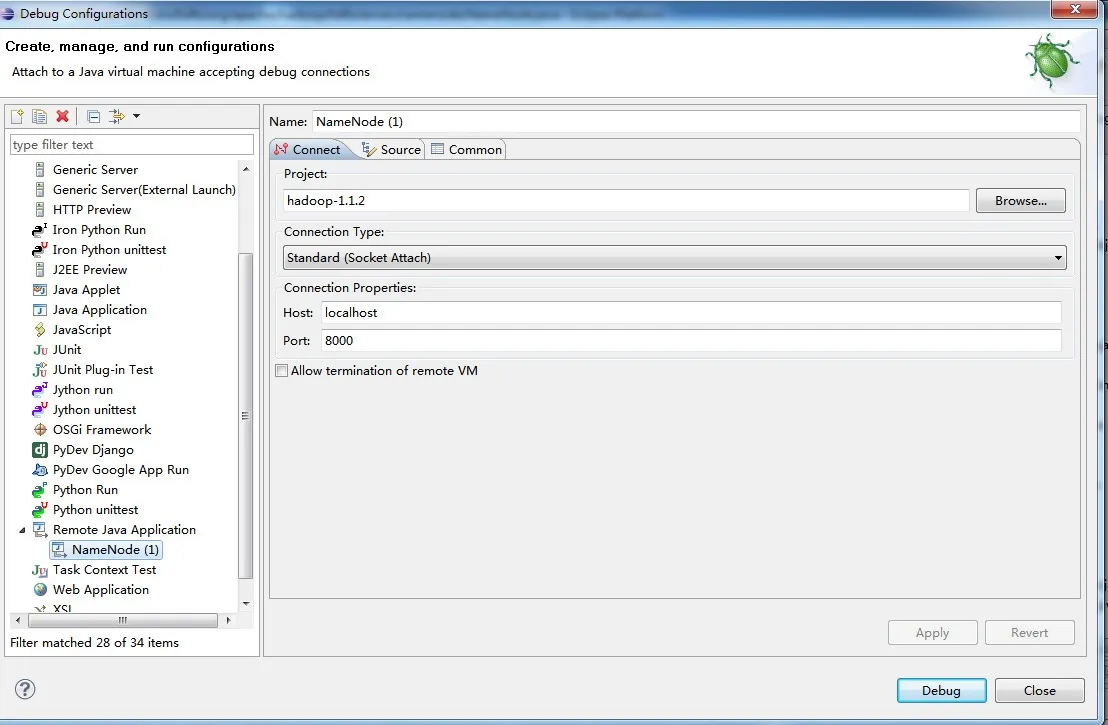
这边就算设置完毕了。可以启动hadoop,命令行会出现,8000端口已经被监听的提示,然后在Eclipse这边打开NameNode的代码,打上断点,然后打开Debug Configurations 面板,在左侧选择Remote Java Application,如下图:
bbd26b2e96dae9ee71214ff57397e10f9b31ac59

点击Debug,然后进入熟悉的debug页面就是成功啦!

分享结束,有什么不明白可以留言。

目录
相关文章
|
分布式计算 Java Hadoop
|
分布式计算 Java Hadoop
[Hadoop]Hadoop本地调试
版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/SunnyYoona/article/details/72912058 1.
1411 0
|
分布式计算 Hadoop
Hadoop开启、关闭调试信息方法
<div class="multicntwrap" style="font-family:'lucida Grande',Verdana,'Microsoft YaHei'; font-size:14px; line-height:23.8px"> <div class="multicnt"> <h3 class="title pre fs1" style="font-size:16p
3679 0
|
分布式计算 Java Hadoop
Hadoop 调试第一个mapreduce程序过程详细记录总结
     开发环境搭建参考     :http://blog.itpub.net/26230597/viewspace-1370205/ 1,程序代码如下: package wc; import java.
1429 0
|
分布式计算 Kubernetes Hadoop
大数据-82 Spark 集群模式启动、集群架构、集群管理器 Spark的HelloWorld + Hadoop + HDFS
1366 6
|
分布式计算 资源调度 Hadoop
大数据-80 Spark 简要概述 系统架构 部署模式 与Hadoop MapReduce对比
679 2
|
存储 分布式计算 Hadoop
从“笨重大象”到“敏捷火花”:Hadoop与Spark的大数据技术进化之路
939 79
|
存储 分布式计算 大数据
Flume+Hadoop:打造你的大数据处理流水线
本文介绍了如何使用Apache Flume采集日志数据并上传至Hadoop分布式文件系统(HDFS)。Flume是一个高可用、可靠的分布式系统,适用于大规模日志数据的采集和传输。文章详细描述了Flume的安装、配置及启动过程,并通过具体示例展示了如何将本地日志数据实时传输到HDFS中。同时,还提供了验证步骤,确保数据成功上传。最后,补充说明了使用文件模式作为channel以避免数据丢失的方法。
1164 4

相关实验场景

更多