重叠计算和数据传输:
cudaMemcpyAsync(a_d, a_h, size, cudaMemcpyHostToDevice, 0);
kernel<<<grid, block>>>(a_d);
cpuFunction();
cudaMemcpyAsync()函数的最后一个参数是流ID,在这种情况下,它使用默认流stream 0。内核也使用默认流,直到内存复制完成时才会开始执行; 因此,不需要明确的同步。 由于内存拷贝和内核都立即将控制权交还给主机,因此主机函数cpuFunction()与其执行重叠。
在重叠计算和数据传输中,内存复制和内核执行将按顺序进行。 在能够并发复制和计算的设备上,可以将设备上的内核执行与主机和设备之间的数据传输重叠。 设备是否具有此功能由cudaDeviceProp结构的asyncEngineCount字段指示(或deviceQuery CUDA示例的输出中列出)。 在具有此功能的设备上,重叠再次需要固定主机内存,此外,数据传输和内核必须使用不同的非默认流(具有非零流ID的流)。 此重叠需要非默认流,因为使用默认流的内存副本,内存集函数和内核调用仅在设备上的所有前面的调用(在任何流中)完成之后才开始,并且设备上没有操作(在 任何流)开始直到它们完成。
并发复制并执行:
cudaStreamCreate(&stream1);
cudaStreamCreate(&stream2);
cudaMemcpyAsync(a_d, a_h, size, cudaMemcpyHostToDevice, stream1);
kernel<<<grid, block, 0, stream2>>>(otherData_d);
在此代码中,将创建两个数据流,并将其用于数据传输和内核执行,如cudaMemcpyAsync调用的最后一个参数和内核的执行配置中所指定的。
并发复制和执行演示了如何使用异步数据传输重叠内核执行。 当数据依赖性可以将数据分解为块并以多个阶段进行传输时,可以使用此技术,启动多个内核以在每个块到达时对其进行操作。 顺序复制和执行以及分步并行复制和执行都证明了这一点。 他们产生相同的结果。 第一部分显示了参考顺序实现,它在N个浮点数组(其中N假定可以被nThreads均匀整除)上进行传输和操作。
顺序复制并执行:
cudaMemcpy(a_d, a_h, N*sizeof(float), dir);
kernel<<<N/nThreads, nThreads>>>(a_d);
分步并发复制和执行显示如何将传输和内核执行分解为nStream阶段。 这种方法允许一些数据传输和执行的重叠。
分阶段并发复制和执行:
size = N * sizeof(float) / nStreams;
for (i = 0; i<nStreams; i++) {
    offset = i*N / nStreams;
    cudaMemcpyAsync(a_d + offset, a_h + offset, size, dir, stream[i]);
    kernel << <N / (nThreads*nStreams), nThreads, 0,
        stream[i] >> >(a_d + offset);
}
(在分步并发复制和执行中,假设N可以被nThreads * nStreams均匀整除。)由于流内的执行是按顺序进行的,所以内核将不会启动,直到数据在各自流中传输完成。目前的GPU可以同时处理异步数据传输和执行内核。具有单个副本引擎的GPU可以执行一次异步数据传输并执行内核,而具有两个副本引擎的GPU可以同时执行从主机到设备的一次异步数据传输,从设备到主机的一次异步数据传输以及执行内核。 GPU上的拷贝引擎数量由cudaDeviceProp结构的asyncEngineCount字段给出,该字段也在deviceQuery CUDA Sample的输出中列出。 (应该指出的是,不能将阻塞传输与异步传输重叠,因为阻塞传输发生在默认流中,所以直到所有先前的CUDA调用完成才会开始阻塞传输,它不允许任何其他CUDA调用直到它完成。)描述两个代码段的执行时间线的图如图1所示,而nStreams等于4,用于分步并发复制并在图的下半部分执行。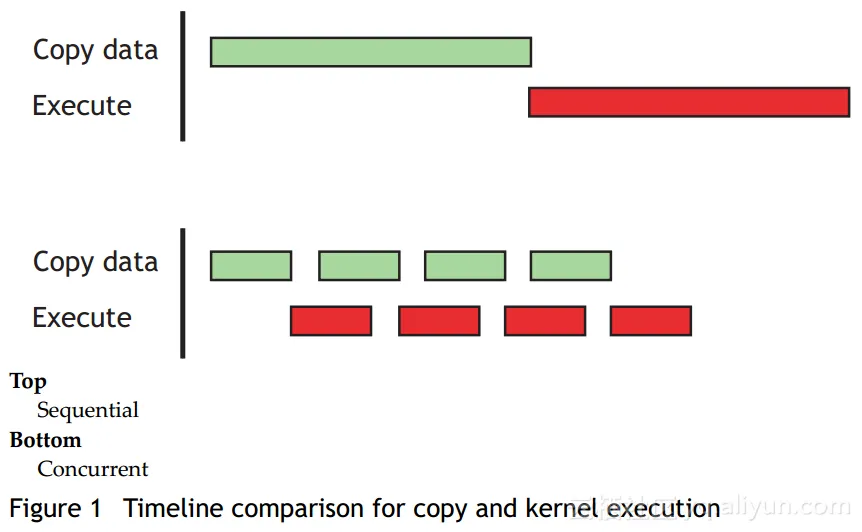
对于这个例子,假设数据传输和内核执行时间是可比的。 在这种情况下,当执行时间($t_{E}$)超过传输时间($t_{T}$)时,对于顺序版本,整体时间的粗略估计是分阶段版本的$t_{E}+t_{T}/nStreams$与$t_{E}+t_{T}$。 如果传输时间超过执行时间,则整体时间的粗略估计为$t_{E}+t_{T}/nStreams$